

Zaradi izčrpavanja naslovov IPv4 se mnogi operaterji soočajo z nujnostjo organizacije dostopa svojih strank v omrežje z uporabo prevajanja naslovov. V tem članku bom opisal, kako lahko dosežete zmogljivost nivoja Carrier Grade NAT na običajnih strežnikih.
Nekaj zgodovine
Tema izčrpavanja naslovnega prostora IPv4 ni več nova. V nekem trenutku so se pri RIPE pojavile čakalne vrste, nato so se pojavile borze, na katerih so trgovali z bloki naslovov in sklepali pogodbe za njihovo najem. Postopoma so operaterji začeli ponujati storitve dostopa do interneta z uporabo prevajanja naslovov in vrat. Nekateri niso uspeli pridobiti dovolj naslovov, da bi vsakemu naročniku dodelili 'beli' naslov, nekateri pa so začeli varčevati in se odrekli nakupu naslovov na sekundarnem trgu. Proizvajalci omrežne opreme so podprli to idejo, saj ta funkcionalnost običajno zahteva dodatne razširitve ali licence. Na primer, pri Juniperju v seriji usmerjevalnikov MX (razen zadnjih MX104 in MX204) je izvedba NAPT mogoča na ločeni storitveni kartici MS-MIC, pri Cisco ASR1k je potrebna licenca CGN license, pri Cisco ASR9k pa ločen modul A9K-ISM-100 in licenca A9K-CGN-LIC zanj. Na splošno, ta užitek stane kar nekaj denarja.
IPTables
Naloga izvajanja NAT ne zahteva posebnih računalniških virov, to nalogo lahko opravljajo procesorji splošne rabe, ki jih najdemo na primer v kateremkoli domačem usmerjevalniku. Na ravni operaterja to nalogo lahko rešimo s pomočjo običajnih strežnikov z operacijskim sistemom FreeBSD (ipfw/pf) ali GNU/Linux (iptables). FreeBSD ne bomo obravnavali, saj sem se že dolgo oddaljil od uporabe tega OS, zato se bomo osredotočili na GNU/Linux.
Vklop prevajanja naslovov ni težko. Najprej je treba v iptables zapisati pravilo v tabelo nat:
iptables -t nat -A POSTROUTING -s 100.64.0.0/10 -j SNAT --to - --persistent
Operacijski sistem bo naložil modul nf_conntrack, ki bo spremljal vse aktivne povezave in izvajal potrebne pretvorbe. Tu je nekaj posebnosti. Prvič, ker gre za NAT v obsegu telekomunikacijskega operaterja, je potrebno prilagoditi časovne omejitve (timeouts), saj se ob privzetih nastavitvah velikost tabele prevodov dokaj hitro poveča do katastrofalnih vrednosti. Spodaj je primer nastavitev, ki sem jih uporabljal na svojih strežnikih:
net.ipv4.ip_forward = 1
net.ipv4.ip_local_port_range = 8192 65535

net.netfilter.nf_conntrack_generic_timeout = 300
net.netfilter.nf_conntrack_tcp_timeout_syn_sent = 60
net.netfilter.nf_conntrack_tcp_timeout_syn_recv = 60
net.netfilter.nf_conntrack_tcp_timeout_established = 600
net.netfilter.nf_conntrack_tcp_timeout_fin_wait = 60
net.netfilter.nf_conntrack_tcp_timeout_close_wait = 45
net.netfilter.nf_conntrack_tcp_timeout_last_ack = 30
net.netfilter.nf_conntrack_tcp_timeout_time_wait = 120
net.netfilter.nf_conntrack_tcp_timeout_close = 10
net.netfilter.nf_conntrack_tcp_timeout_max_retrans = 300
net.netfilter.nf_conntrack_tcp_timeout_unacknowledged = 300
net.netfilter.nf_conntrack_udp_timeout = 30
net.netfilter.nf_conntrack_udp_timeout_stream = 60
net.netfilter.nf_conntrack_icmpv6_timeout = 30
net.netfilter.nf_conntrack_icmp_timeout = 30
net.netfilter.nf_conntrack_events_retry_timeout = 15
net.netfilter.nf_conntrack_checksum=0
In drugič, ker velikost tabele prevodov ob privzeto ni zasnovana za delovanje v razmerah telekomunikacijskega operaterja, jo je potrebno povečati:
net.netfilter.nf_conntrack_max = 3145728
Prav tako je treba povečati število buckets za hashtable, ki hrani vse prevede (to je opcija modula nf_conntrack):
options nf_conntrack hashsize=1572864
Po teh enostavnih manipulacijah dobimo povsem delujočo konstrukcijo, ki lahko prevaja veliko število odjemalskih naslovov v zunanji bazen. Vendar pa zmogljivost te rešitve pušča željo. V svojih prvih poskusih uporabe GNU/Linux za NAT (približno 2013) sem uspel doseči zmogljivost okoli 7 Gbit/s pri 0.8 Mpps na en strežnik (Xeon E5-1650v2). Od takrat je bilo v omrežnem kupu jedra GNU/Linux narejenih veliko različnih optimizacij, zmogljivost enega strežnika na istem hardveru je zrasla skoraj do 18-19 Gbit/s pri 1.8-1.9 Mpps (to so bili mejni podatki), toda potreba po obsegu prometa, obdelanega z enim strežnikom, je rasla precej hitreje. Na koncu so bile razvite sheme za obvladovanje obremenitve na različne strežnike, kar pa je povečalo kompleksnost nastavitve, vzdrževanja in zagotavljanja kakovosti ponujenih storitev.
NFTables
Trenutno je popularno korišćenje DPDK-a i XDP-a u programskom „premeštanju paketa“. O ovoj temi je napisana mnoštvo članaka, održano je mnogo različitih prezentacija, a pojavili su se i komercijalni proizvodi (na primer, SKAT od VasExperts). Međutim, u uslovima ograničenih resursa programera kod telekomunikacionih operatera, teško je samostalno razvijati neka „rešenja“ na bazi ovih okvira. Dalja upotreba takvih rešenja će biti znatno složenija, posebno će biti neophodno razvijati alate za dijagnostiku. Na primer, standardni tcpdump sa DPDK-om jednostavno neće raditi, a ni paketi poslati nazad putem XDP-a neće biti „viđeni“. I dok se svi razgovori vrte oko novih tehnologija preusmeravanja paketa u korisničkom režimu, ostalo je neprimećeno in Pablo Neira Ayuso, održavač iptables-a, o razvoju flow offloading-a u nftables-u. Hajde da ovo razmotrimo detaljnije.
Osnovna ideja je da, ako usmerivač propušta pakete jedne sesije u oba pravca toka (TCP sesija je prešla u stanje ESTABLISHED), nema potrebe da se naredni paketi te sesije propuštaju kroz sve firewall pravila, jer će sve ove provere ionako završiti prosledjivanjem paketa dalje u rutiranje. Ni izbor rute više nije potreban – već znamo na koji interfejs i kojem hostu treba proslediti pakete unutar te sesije. Ostaje samo da se sačuva ta informacija i iskoristi je za rutiranje u ranoj fazi obrade paketa. Tokom NAT-a, takođe je potrebno sačuvati informacije o promenama adresa i portova koje je izmenio modul nf_conntrack. Da, naravno, u ovom slučaju prestaju da rade različiti policeri i druga informativno-statistička pravila u iptables-u, ali u okviru zadatka zasebnog NAT-a ili, na primer, bordera – to nije tako važno, jer su usluge raspoređene po uređajima.
Конфигурация
Da bismo iskoristili ovu funkciju, potrebno je:
- Koristiti svežu verziju jezgra. Iako je sama funkcija prvobitno uvedena u jezgru 4.16, dugo vremena je bila izrazito „sirova“ i redovno je izazivala kernel panic. Stabilizovana je otprilike u decembru 2019. godine, kada su objavljena LTS jezgra 4.19.90 i 5.4.5.
- Preurediti pravila iptables u nftables format, koristeći dovoljno svježu verziju nftables. Radi sigurno u verziji 0.9.0
Ako je prvi deo u suštini jasan, najvažnije je ne zaboraviti uključiti modul u konfiguraciju pri kompilaciji (CONFIG_NFT_FLOW_OFFLOAD=m), drugi deo zahteva objašnjenje. Pravila nftables opisuju se potpuno drugačije nego u iptables. pokreće gotovo sve aspekte, takođe postoje posebni pravila iz iptables u nftables. Stoga ću dati samo primer podešavanja NAT-a i flow offload-a. Kratak okvir za primer: , — to su mrežni interfejsi preko kojih prolazi saobraćaj, stvarno ih može biti više od dva. , — početna i krajnja adresa opsega "belih" adresa.
Konfiguracija NAT-a je vrlo jednostavna:
#! /usr/sbin/nft -f

table nat {
        chain postrouting {
                type nat hook postrouting priority 100;
                oif <o_if> snat to <pool_addr_start>-<pool_addr_end> persistent
        }
}
Sa flow offload-om je malo složenije, ali potpuno razumljivo:
#! /usr/sbin/nft -f

table inet filter {
        flowtable fastnat {
                hook ingress priority 0
                devices = { <i_if>, <o_if> }
        }

        chain forward {
                type filter hook forward priority 0; policy accept;
                ip protocol { tcp , udp } flow offload @fastnat;
        }
}
Eto, to je cela konfiguracija. Sada će sav TCP/UDP saobraćaj ulaziti u tabelu fastnat i biti obrađen mnogo brže.
Rezultati
Da bi postalo jasno koliko je ovo "mnogo brže", priložiću screenshot opterećenja dva stvarna servera, sa istom opremom (Xeon E5-1650v2), isto podešenih, koristeći istu Linux jezgru, ali obavljajući NAT u iptables (NAT4) i u nftables (NAT5).
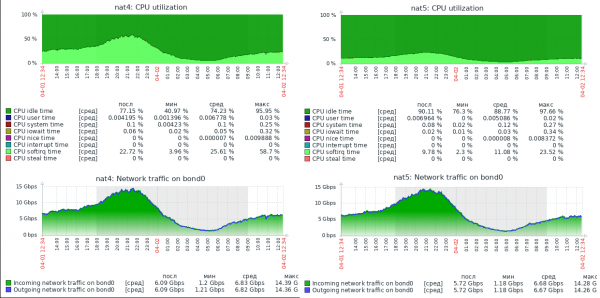
Na screenshot-u nema grafika paketa u sekundi, ali u profilu opterećenja ovih servera prosečna veličina paketa je oko 800 bajtova, tako da se vrednosti penju do 1.5Mpps. Kao što se može videti, kapacitet servera sa nftables je ogroman. Trenutno ovaj server obrađuje do 30Gbit/s pri 3Mpps i očigledno je sposoban da dostigne fizičko ograničenje mreže od 40Gbps, pri čemu su CPU resursi još uvek slobodni.
Nadam se da će ovaj materijal biti koristan mrežnim inženjerima koji pokušavaju poboljšati performanse svojih servera.
Izvor: habr.com
