

Danes obstaja 100500 tečajev o Data Science in že dolgo je znano, da je možno zaslužiti največ prav s tečaji o Data Science (zakaj kopati, ko lahko prodajaš lopate?). Glavna slabost teh tečajev je, da nimajo nobene povezave z dejanskim delom: nihče vam ne bo dal čistih, obdelanih podatkov v želenem formatu. In ko končate tečaj in začnete reševati pravo nalogo — se pojavijo številne težave.
Zato začnemo serijo zapiskov „Kaj se lahko zgodi narobe z Data Science“, ki temeljijo na resničnih dogodkih, ki so se zgodili men, mojim prijateljem in kolegom. Razpravljali bomo o resničnih primerih tipičnih nalog v Data Science: kako se to v resnici dogaja. Danes bomo začeli z nalogo zbiranja podatkov.
In prvo, ob čemer se ljudje spotikajo, ko začnejo delati s pravimi podatki — je prav zbiranje teh relevantnih podatkov. Ključna sporočila tega članka:
Sistematično podcenjujemo čas, vire in trud potreben za zbiranje, čiščenje in pripravo podatkov.
In najpomembneje, razpravljali bomo o tem, kaj storiti, da do tega ne pride.
Po različnih ocenah, čiščenje, transformacija, obdelava podatkov, inženiring značilnosti itd. predstavlja 80-90% časa, analiza pa 10-20%, medtem ko se praktično ves učni material osredotoča izključno na analizo.
Poglejmo tipičen primer preproste analitične naloge v treh različicah in videli bomo, kakšne so lahko „olepšave okoliščin“.
In za primer bomo spet obravnavali podobne različice naloge zbiranja podatkov in primerjave skupnosti za:
- Dva subreddita Reddit
- Dva razdelka Habr
- Dve skupini Odnoklassniki
Hipotetični pristop v teoriji
Odpri spletno stran in preberi primere; če je jasno, si zabeleži nekaj ur za branje, nekaj ur za kodo po primerih in odpravljanje napak. Dodaj nekaj ur za zbiranje. Dodaj še nekaj ur za rezervo (pomnoži z dvema in dodaj N ur).
Ključna točka: ocena časa temelji na predpostavkah in domnevah, koliko časa bo to vzelo.
Analiza časa se mora začeti z oceno naslednjih parametrov za hypotetično nalogo, opisano zgoraj:
- Kakšna je velikost podatkov in koliko jih je treba fizično zbrati (*glej spodaj*).
- Kakšno je čas zbiranja enega zapisa in koliko časa je treba čakati, preden lahko zberemo drugega.
- Vključiti kodo za ohranjanje stanja in zagon ponovnega zagona, ko (ne če) vse odpove.
- Razjasniti, ali potrebujemo avtentikacijo in vključiti čas za dostop prek API.
- Vključiti število napak kot funkcijo zapletenosti podatkov — oceniti glede na posebno nalogo: struktura, koliko preobrazb, kaj in kako ekstraktiramo.
- Vključiti napake omrežja in probleme z nenavadnim vedenjem projekta.
- Oceniti, ali so potrebne funkcije v dokumentaciji in če niso, koliko časa in kako naj se pripravi workaround.
Najpomembnejše je, da za oceno časa dejansko potrebujete vložiti čas in trud za 'bojne izvidnice' — le tako bo vaše načrtovanje ustrezno. Zato, ne glede na to, kako vas pritiskajo, da poveste 'koliko časa potrebujemo za zbiranje podatkov' — si vzemite čas za predhodno analizo in argumentirajte, koliko časa bo variiralo glede na dejanske parametre naloge.
In zdaj bomo prikazali konkretne primere, kjer se ti parametri bodo spreminjali.
Ključna točka: ocena temelji na analizi ključnih dejavnikov, ki vplivajo na obseg in kompleksnost dela.
Ocena, ki temelji na ugibanjih — je dober pristop, ko so funkcionalni elementi dovolj majhni in ni veliko dejavnikov, ki bi lahko bistveno vplivali na strukturo naloge. Vendar pa v primeru nekaterih nalog Data Science postane teh dejavnikov izjemno veliko in tak pristop postane neustrezen.
Primerjava skupnosti Reddit
Začnimo z najpreprostejšim primerom (kar se bo pozneje izkazalo). Na splošno, če povemo povsem pošteno, je pred nami praktično idealen primer, preverili bomo naš kontrolni seznam kompleksnosti:
- Obstaja urejen, razumljiv in dokumentiran API.
- Zelo preprosto in kar je najpomembnejše, token se samodejno generira.
- Je — s kupom primerov.
- Skupnost, ki se ukvarja z analizo in zbiranjem podatkov na redditu (do YouTube videov, ki razlagajo, kako uporabiti python wrapper) .
- Potrebne metode verjetno obstajajo v API-ju. Poleg tega, koda izgleda kompaktno in čisto, spodaj je primer funkcije, ki zbira komentarje k objavi.
def get_comments(submission_id):
    reddit = Reddit(check_for_updates=False, user_agent=AGENT)
    submission = reddit.submission(id=submission_id)
    more_comments = submission.comments.replace_more()
    if more_comments:
        skipped_comments = sum(x.count for x in more_comments)
        logger.debug('Skipped %d MoreComments (%d comments)',
                     len(more_comments), skipped_comments)
    return submission.comments.list()
Prevzeto iz seznam pohodlných utilit pro obalování.
I když máme před sebou nejlepší scénář, přesto je třeba vzít v úvahu řadu důležitých faktorů z reálného života:
- API limity — jsme nuceni získávat data po dávkách (pauzy mezi požadavky atd.).
- Čas sběru — pro kompletní analýzu a porovnání je potřeba vyčlenit značný čas pouze na to, aby pavouk prošel subredditem.
- Bota je třeba provozovat na serveru — nemůžete ho jen tak spustit na notebooku, vložit do batohu a odjet. Proto jsem vše spustil na VPS. S promo kódem habrahabr10 můžete ušetřit dalších 10 % nákladů.
- Fyzická nedostupnost některých dat (vidí je administrátoři nebo jsou příliš obtížně sbíratelná) — je třeba to vzít v úvahu, ne všechna data lze v rozumném čase shromáždit.
- Chyby při práci sítě: práce se sítí je bolest.
- Jsou to živá skutečná data — těžko jsou zcela čistá.
Samozřejmě, je nutné vzít v úvahu uvedené nuance ve vývoji. Konkrétní hodiny/dny závisí na zkušenostech s vývojem nebo zkušenostech s podobnými úkoly, nicméně vidíme, že zde je úkol čistě inženýrský a nevyžaduje další kroky k řešení — vše lze velmi dobře odhadnout, naplánovat a realizovat.
Porovnání sekcí Habra
Přejdeme k zajímavějšímu a netradičnímu případu porovnání proudů a/nebo sekcí Habra.
Zkontrolujme náš checklist složitosti — zde, abychom pochopili každý bod, budeme muset trochu zabrouzdat do úkolu a experimentovat.
- Nejprve si myslíte, že existuje API, ale není. Ano, má Habr API, ale je nedostupné pro uživatele (nebo možná vůbec nefunguje).
- Pak začnete jednoduše parsovat HTML — 'import requests', co by se mohlo pokazit?
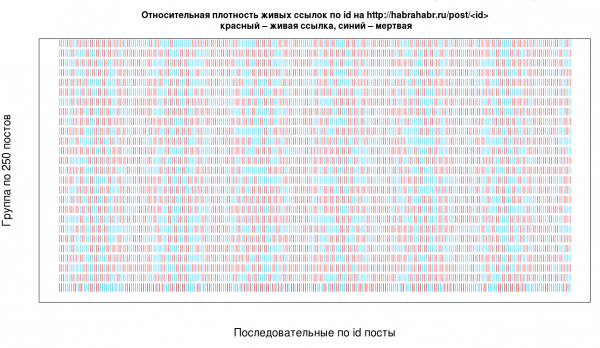
- A jak vlastně parsovat? Nejjednodušší a často používaný přístup je iterovat podle ID, poznamenejme, že není nejefektivnější a bude potřeba zpracovávat různé případy — zde je příklad hustoty skutečných ID mezi všemi existujícími.

Prevzeto iz člankov. - Surove podatke, ovite v HTML nad omrežjem, so prava bolečina. Na primer, želite zbrati in shraniti oceno članka: izvlečete score iz HTML in se odločite, da ga shranite kot številko za nadaljnjo obdelavo:
1) int(score) vrže napako: ker na Habrju znak minus, kot je v nizu "–5" — to je kratka misica, ne znak minus (nepričakovano, da?), zato je bilo v nekem trenutku potrebno oživiti parser s to grozno začetno rešitvijo.
poskusi:
      score_txt = post.find(class_="score").text.replace(u"–","-").replace(u"+","+")
      score = int(score_txt)
      if check_date(date):
        post_score += score
Datumov, plusov in minusov morda sploh ni (kot vidimo zgoraj pri funkciji check_date in je bilo tudi tako).
2) Neekranirani posebni znaki — ti bodo prišli, potrebno se je pripraviti.
3) Struktura se spreminja glede na vrsto objave.
4) Stare objave lahko imajo **čudno strukturo**.
- V bistvu bo potrebno obravnavati obdelavo napak in to, kar se lahko ali ne more zgoditi, in ne moremo zagotovo napovedati, kaj bo šlo narobe in kakšna bo še lahko struktura in kje se bo kaj zrušilo — preprosto bo potrebno poskusiti in upoštevati napake, ki jih vrže parser.
- Kasneje razumete, da morate parsati v več niti, sicer bo enotin pars trajal 30+ ur (to je čisto čas izvedbe že delujočega enotnega parserja, ki spi in ne naleti na nobene prepovedi). V članku je to na neki točki pripeljalo do takšne sheme:
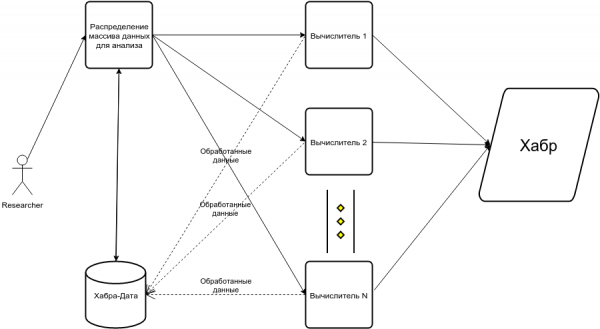
Skupaj kontrolni seznam glede zahtevnosti:
- Delo z omrežjem in parsanjem HTML z iteracijo in ponavljanjem po ID-ju.
- Dokumenti so neenotne strukture.
- Obstaja veliko mest, kjer lahko koda zlahka pade.
- Potrebno je pisati || kodo.
- Manjka potrebna dokumentacija, primeri kode in/ali skupnost.
Pogožna ocena časa za to nalogo bo 3-5 krat višja, kot za zbiranje podatkov z Reddita.
Primerjava skupin Odnoklassnikov
Preidimo k tehnično najzanimivejšemu primeru iz opisanih. Zame je bil zanimiv prav zato, ker se na prvi pogled zdi dovolj trivialen, a ni povsem tak — takoj ko ga s palčko dotaknemo.
Začnimo z našim kontrolnim seznamom zahtevnosti in opazimo, da se bo izkazalo, da so mnogi izmed njih precej težji, kot se sprva zdijo:
- API obstaja, vendar skoraj v celoti nima potrebnih funkcij.
- Za določene funkcije je potrebno zaprositi za dostop po e-pošti, torej dodelitev dostopa ni takojšnja.
- Dokumentacija je izuzetno loša (za početak, mešaju se ruski i engleski termini, i to apsolutno nekonsistentno — ponekad jednostavno morate da pogodite šta se od vas traži negde) i, što je još gore, dizajn nije prilagođen za prikupljanje podataka, na primer, .
- Traži sesiju u dokumentaciji, a u stvarnosti je ne koristi — a nema načina da se razjasne sve nijanse API režima, osim da se pogađa i nada da će nešto raditi.
- Nedostaju primeri i zajednica, jedina tačka oslanjanja u prikupljanju informacija je mali na Pythonu (bez mnogo primera korišćenja).
- Najradnije rešenje izgleda kao Selenium, jer su mnogi potrebni podaci zaključani.
1) To znači da se vrši autorizacija preko fikcionalnog korisnika (i ručna registracija).2) Međutim, sa Seleniumom nema garancija za pravilno i ponovljivo funkcionisanje (barem u slučaju sa ok.ru sigurno).
3) Ok.ru sajt sadrži JavaScript greške i ponekad se čudno i nekonsistentno ponaša.
4) Potrebno je baviti se paginacijom, učitavanjem elemenata itd…
5) Greške API-ja koje proslijedi wrapper moraćete da obradite na sledeći način (deo eksperimentalnog koda):
def get_comments(args, context, discussions):
    pause = 1
    if args.extract_comments:
        all_comments = set()
#ima smisla pratiti već obrađene diskusije
        for discussion in tqdm(discussions):
            try:
                comments = get_comments_from_discussion_via_api(context, discussion)
            except odnoklassniki.api.OdnoklassnikiError as e:
                if "NOT_FOUND" in str(e):
                    comments = set()
                else:
                    print(e)
                    bp()
                    pass
            all_comments |= comments
            time.sleep(pause)
        return all_comments
Moja omiljena greška je bila:
OdnoklassnikiError("Error(code: 'None', description: 'HTTP error', method: 'discussions.getComments', params: …)”)6) Na kraju, kombinacija Selenium + API izgleda kao najracionalnije rešenje.
- Potrebno je sačuvati stanje i restartovati sistem, obraditi mnoštvo grešaka, uključujući nekonsistentno ponašanje sajta — s obzirom na to da su te greške teško zamislive (ako naravno, ne pišete profesionalno parsere).
Procena vremena za ovaj zadatak biće 3-5 puta veća nego za prikupljanje podataka sa Habr-a. Iako u slučaju Habr-a koristimo površinski pristup sa parsiranjem HTML-a, u slučaju OK možemo na kritičnim mestima raditi sa API-jem.
Zaključki
Ne glede na to, kako zelo od vas zahtevajo oceno rokov "na kraju samem" (danes načrtujemo!), je skoraj nemogoče oceniti čas izvedbe obsežnega modula podatkovnega cevovoda brez analize parametrov naloge.
Če se nekoliko filozofsko pogovarjava, strategije ocenjevanja v agilnem okolju dobro ustrezajo inženirskim nalogam, vendar pri bolj eksperimentalnih in v nekem smislu "ustvarjalnih" raziskovalnih nalogah, torej tistih, ki so manj predvidljive, nastajajo težave, kot v primerih, obravnavanih tukaj.
Seveda je zbiranje podatkov jasen ilustrativen primer — običajno se ta naloga zdi izjemno preprosta in tehnično nezapletena, toda prav v podrobnostih se pogosto skriva hudič. In prav na tej nalogi lahko pokažemo ves spekter mogočih variacij, kar se lahko zgodi narobe in kako dolgo se lahko delo raztegne.
Če na hitro pogledamo značilnosti naloge brez dodatnih eksperimentov, sta Reddit in OK videti podobno: imata API, python wrapper, toda v bistvu je razlika ogromna. Glede na te parametre se zdi, da je parsiranje Habr bolj zapleteno kot OK — v praksi pa je ravno obratno, in to lahko ugotovimo z enostavnimi eksperimenti analize parametrov naloge.
Po mojem mnenju je najučinkovitejši pristop približna ocena časa, ki ga boste potrebovali za začetno analizo in enostavne prve eksperimente, branje dokumentacije — to vam omogoča, da podate natančno oceno za celotno delo. V terminih priljubljene agilne metodologije — prosim, da mi odprete nalogo za "oceno parametrov naloge", na podlagi katere lahko podam oceno tega, kar je mogoče izvesti v okviru "sprinta" in dam natančnejšo oceno za vsako nalogo.
Zato se zdi najučinkovitejši argument, ki bi "netehničnemu" strokovnjaku pokazal, kako zelo se bo časi in viri spreminjali glede na parametre, ki jih treba še oceniti.
Izvor: habr.com
