

V temle zapisku bi radi delili zanimiv način upravljanja konfiguracijo porazdeljenega sistema.
Konfiguracija je neposredno predstavljena v jeziku Scala na tipno varen način. Primer izvedbe je podroben. Obravnavamo različne vidike predloga, vključno z vplivom na celoten razvojni proces.
()
Uvod
Izgradnja robustnih porazdeljenih sistemov zahteva uporabo pravilne in koherentne konfiguracije na vseh vozliščih. Tipična rešitev je uporaba besedilnega opisa namestitve (terraform, ansible ali podobno) ter avtomatsko ustvarjenih konfiguracijskih datotek (pogosto – namenjenih vsakemu vozlišču/rolu). Prav tako želimo uporabiti iste protokole istih različic na vseh komunikacijskih vozliščih (sicer bomo naleteli na težave z združljivostjo). V svetu JVM to pomeni, da bi morala biti vsaj knjižnica za sporočanje iste različice na vseh komunikacijskih vozliščih.
Kaj pa testiranje sistema? Seveda moramo imeti enotne teste za vse komponente, preden preidemo na integracijske teste. Da bi lahko ekstrapolirali rezultate testov na runtime, se moramo prepričati, da so različice vseh knjižnic enake tako v runtime kot v testnem okolju.
Pri izvajanju integracijskih testov je pogosto veliko lažje imeti isti classpath na vseh vozliščih. Samo prepričati se moramo, da se pri namestitvi uporablja isti classpath. (Možno je uporabiti različne classpathe na različnih vozliščih, vendar je težje predstaviti to konfiguracijo in jo pravilno namestiti.) Zato bomo zaradi enostavnosti obravnavali samo identične classpathe na vseh vozliščih.
Konfiguracija se običajno razvija skupaj z programsko opremo. Običajno uporabljamo različice za identifikacijo različnih
stopenj razvoja programske opreme. Razumno se zdi, da pokrijemo konfiguracijo z upravljanjem različic in identificiramo različne konfiguracije s pomočjo nekaterih oznak. Če je v produkciji le ena konfiguracija, lahko uporabimo eno samo različico kot identifikator. Včasih imamo lahko več produkcijskih okolij. In za vsako okolje potrebujemo ločeno vejo konfiguracije. Tako bi lahko bile konfiguracije označene z vejo in različico, da bi edinstveno identificirali različne konfiguracije. Vsaka oznaka veje in različica ustreza eni sami kombinaciji porazdeljenih vozlišč, vrat, zunanjih virov, različic knjižnic classpath na vsakem vozlišču. Tukaj bomo obravnavali samo eno vejo in identificirali konfiguracije z decimalno različico s tremi komponentami (1.2.3), na enak način kot druge artefakte.
V sodobnih okoljih se konfiguracijske datoteke ne spreminjajo več ročno. Običajno generiramo
konfiguracijske datoteke ob času namestitve in kasneje. Tako bi se lahko vprašali, zakaj še vedno uporabljamo besedilni format za konfiguracijske datoteke? Urejenost je lahko umestiti konfiguracijo znotraj enote prevajanja in izkoristiti validacijo konfiguracije v času prevajanja.
V tem zapisu bomo preučili idejo o ohranjanju konfiguracije v prevedenem artefaktu.
Prevedljiva konfiguracija
V tem razdelku bomo obravnavali primer statične konfiguracije. Dve preprosti storitvi – storitev eha in odjemalec storitve eha se konfigurirata in izvajata. Nato sta instancirani dve različni porazdeljeni sistemi z obema storitvama. Ena je za konfiguracijo na enem vozlišču, druga pa za konfiguracijo na dveh vozliščih.
Tipičen porazdeljen sistem je sestavljen iz več vozlišč. Vozlišča bi lahko identificirali z nekim tipom:
sealed trait NodeId
case object Backend extends NodeId
case object Frontend extends NodeId
ali preprosto
case class NodeId(hostName: String)ali celo
object Singleton
type NodeId = Singleton.type
Ta vozlišča opravljajo različne vloge, izvajajo nekatere storitve in bi morala biti sposobna komunicirati z drugimi vozlišči preko TCP/HTTP povezav.
Za TCP povezavo je potrebna vsaj številka vrat. Prav tako želimo zagotoviti, da klient in strežnik komunicirata z istim protokolom. Da modeliramo povezavo med vozlišči, deklarirajmo naslednjo klaso:
case class TcpEndPoint[Protocol](node: NodeId, port: Port[Protocol])kjer Priključek je le Int znotraj dovoljene obsega:
type PortNumber = Refined[Int, Closed[_0, W.`65535`.T]]Refined tipi
Poglej knjiga. Na kratko, omogoča dodajanje omejitev časa prevajanja drugim tipom. V tem primeru Int je dovoljeno imeti le 16-bitne vrednosti, ki lahko predstavljajo število vrat. Za ta pristop konfiguracije ni obvezno uporabljati te knjižnice. Zdi se, da se zelo dobro poda.
Za HTTP (REST) bomo morda potrebovali tudi pot servisa:
type UrlPathPrefix = Refined[String, MatchesRegex[W.`"[a-zA-Z_0-9\/]*"`.T]]
case class PortWithPrefix[Protocol](portNumber: PortNumber, pathPrefix: UrlPathPrefix)
Fantomski tip
Za identifikacijo protokola med prevajanjem uporabljamo funkcijo Scalice za deklaracijo tipa argumenta Protokol ki se ne uporablja v klasi. To je tako imenovani fantomski tip. V času izvajanja redkokdaj potrebujemo instanco identifikatorja protokola, zato je ne shranjujemo. Med prevajanjem ta fantomski tip zagotavlja dodatno varnost tipa. Ne moremo predati vrat z napačnim protokolom.
Eden najbolj pogosto uporabljenih protokolov je REST API z Json serijalizacijo:
sealed trait JsonHttpRestProtocol[RequestMessage, ResponseMessage]kjer RequestMessage je osnovni tip sporočil, ki jih lahko klient pošlje strežniku, medtem ko je ResponseMessage odgovorno sporočilo s strani strežnika. Seveda lahko ustvarimo tudi druge opise protokola, ki natančneje določajo komunikacijski protokol.
Za potrebe tega zapisa bomo uporabili preprostejšo različico protokola:
sealed trait SimpleHttpGetRest[RequestMessage, ResponseMessage]V tem protokolu je sporočilo zahteve dodano na url, odgovor pa je vrnjen kot navaden niz.
Konfiguracijo storitve bi lahko opisali z imenom storitve, zbirko vrat in nekaterimi odvisnostmi. Obstaja več možnih načinov, kako te elemente predstaviti v Scali (na primer, HList, algebrski podatkovni tipi). Za potrebe tega zapisa bomo uporabili Cake Pattern in predstavili kombinirane dele (module) kot vmesnike. (Cake Pattern ni zahtevan za ta sestavljiv pristop k konfiguraciji. To je le ena možna implementacija ideje.)
Odvisnosti je mogoče predstaviti z uporabo Cake Pattern kot končne točke drugih vozlišč:
  type EchoProtocol[A] = SimpleHttpGetRest[A, A]

  trait EchoConfig[A] extends ServiceConfig {
    def portNumber: PortNumber = 8081
    def echoPort: PortWithPrefix[EchoProtocol[A]] = PortWithPrefix[EchoProtocol[A]](portNumber, "echo")
    def echoService: HttpSimpleGetEndPoint[NodeId, EchoProtocol[A]] = providedSimpleService(echoPort)
  }
Echo storitev potrebuje le konfigurirano vrata. In deklariramo, da ta vrata podpirajo echo protokol. Upoštevajte, da v tem trenutku ne potrebujemo določiti posebnega vrata, ker vmesnik omogoča deklaracije abstraktnih metod. Če uporabimo abstraktne metode, bo prevajalnik zahteval implementacijo v instanci konfiguracije. Tukaj smo zagotovili implementacijo (8081) in to bo uporabljeno kot privzeta vrednost, če jo preskočimo v konkretni konfiguraciji.
Odvisnost lahko deklariramo v konfiguraciji klienta echo storitve:
  trait EchoClientConfig[A] {
    def testMessage: String = "test"
    def pollInterval: FiniteDuration
    def echoServiceDependency: HttpSimpleGetEndPoint[_, EchoProtocol[A]]
  }
Odvisnost ima enak tip kot echoService. Zlasti zahteva isti protokol. Tako lahko smo prepričani, da če povežemo ti dve odvisnosti, bosta delovali pravilno.
Implementacija storitev
Storitvi je potrebna funkcija za zagon in nežno ustavljanje. (Zmožnost ustavljanja storitve je ključna za testiranje.) Spet imamo več možnosti za določitev takšne funkcije za dano konfiguracijo (na primer, lahko bi uporabili tipne razrede). V tem prispevku bomo spet uporabili Cake Pattern. Storitve lahko predstavimo z cats.Resource , ki že omogoča obvladovanje in sprostitev virov. Da pridobimo vir, moramo zagotoviti konfiguracijo in nek kontekst obratovanja. Tako bi funkcija za zagon storitve lahko izgledala tako:
  type ResourceReader[F[_], Config, A] = Reader[Config, Resource[F, A]]

  trait ServiceImpl[F[_]] {
    type Config
    def resource(
      implicit
      resolver: AddressResolver[F],
      timer: Timer[F],
      contextShift: ContextShift[F],
      ec: ExecutionContext,
      applicative: Applicative[F]
    ): ResourceReader[F, Config, Unit]
  }
kjer
Konfiguracija— tip konfiguracije, ki jo zahteva ta zagon storitveAddressResolver— objekt v teku, ki ima zmožnost pridobitve pravih naslovov drugih vozlišč (preberite naprej za podrobnosti).
drugi tipi prihajajo iz cats:
F[_]— tip učinka (v najpreprostejšem primeruF[A]je lahko preprosto() => A. V tem prispevku bomo uporabilicats.IO.)Reader[A,B]— je več ali manj sinonim za funkcijoA => Bcats.Resource— ima načine za pridobitev in sprostitevTimer— omogoča spanje/merjenje časaContextShift— analogExecutionContextApplicative— ovojnica funkcij v učinku (skoraj monad) (morda ga bomo na koncu zamenjali z nečim drugim)
Z uporabo tega vmesnika lahko implementiramo nekatere storitve. Na primer, storitev, ki ne počne nič:
  trait ZeroServiceImpl[F[_]] extends ServiceImpl[F] {
    type Config  Resource.pure[F, Unit](()))
  }
(Glej za druge implementacije storitev — ,
in .)
Vozlišče je posamezen objekt, ki izvaja nekaj storitev (zaganje verige virov omogoča Cake Pattern):
object SingleNodeImpl extends ZeroServiceImpl[IO]
  with EchoServiceService
  with EchoClientService
  with FiniteDurationLifecycleServiceImpl
{
  type Config = EchoConfig[String] with EchoClientConfig[String] with FiniteDurationLifecycleConfig
}
Upoštevajte, da v vozlišču navedemo natančno vrsto konfiguracije, ki jo to vozlišče potrebuje. Prevajalnik nam ne bo omogočil gradnje objekta (Cake) z nezadostno vrsto, ker vsaka storitvena lastnost deklarira omejitev glede Konfiguracija tipa. Prav tako ne bomo mogli zagnati vozlišča, ne da bi zagotovili popolno konfiguracijo.
Reševanje naslovov vozlišč
Za vzpostavitev povezave potrebujemo pravi naslov gostitelja za vsako vozlišče. Ta se morda izve šele pozneje kot druge komponente konfiguracije. Zato potrebujemo način za dobavo preslikave med id-jem vozlišča in njegovim dejanskim naslovom. Ta preslikava je funkcija:
case class NodeAddress[NodeId](host: Uri.Host)
trait AddressResolver[F[_]] {
  def resolve[NodeId](nodeId: NodeId): F[NodeAddress[NodeId]]
}
Obstaja nekaj možnih načinov za implementacijo take funkcije.
- Če poznamo dejanske naslove pred namestitvijo, med inicializacijo gostiteljev vozlišča, lahko generiramo Scala kodo z dejanskimi naslovi in nato izvajamo gradnjo (kar izvaja preverjanje med prevajanjem in nato izvajamo nabor integracijskih testov). V tem primeru je naša preslikavna funkcija znana statično in jo lahko poenostavimo v nekaj, kot je
Map[NodeId, NodeAddress]. - Včasih pridobimo dejanske naslove šele kasneje, ko je vozlišče dejansko zagnano, ali pa nimamo naslovov vozlišč, ki še niso bila zagnana. V tem primeru morda imamo storitev odkrivanja, ki se zažene pred vsemi drugimi vozlišči in vsako vozlišče lahko oglašuje svoj naslov v tej storitvi in se naroči na odvisnosti.
- Če lahko spremenimo
/etc/hosts, lahko uporabimo vnaprej določena imenska gostitelja (kotmy-project-main-nodeinecho-backend) in preprosto povezujemo to ime z naslovom ip ob času izvajanja.
V tej objavi ne pokrivamo teh primerov podrobneje. V našem igračem primeru bodo vsi vozli imeli isto IP številko — 127.0.0.1.
V tej objavi bomo obravnavali dva razporeda porazdeljenega sistema:
- Razporeditev z enim vozlom, kjer so vse storitve nameščene na enem samem vozlu.
- Razporeditev z dvema vozloma, kjer sta storitev in odjemalec na različnih vozlih.
Konfiguracija za je naslednja:
Konfiguracija enega vozla
objekt SingleNodeConfig extends EchoConfig[String]
  with EchoClientConfig[String] with FiniteDurationLifecycleConfig
{
  case object Singleton \/\/ identifikator enega vozla
  \/\/ konfiguracija strežnika
  tip NodeId = Singleton.type
  def nodeId = Singleton

  \/** Specifikacija varne storitvene luknje. *\/
  override def portNumber: PortNumber = 8088

  \/\/ konfiguracija odjemalca

  \/** Uporabili bomo storitev, ki jo nudi isti gostitelj. *\/
  def echoServiceDependency = echoService

  override def testMessage: UrlPathElement = "hello"

  def pollInterval: FiniteDuration = 1.second

  \/\/ konfiguracija kontrolerja življenjskega cikla
  def lifetime: FiniteDuration = 10500.milliseconds \/\/ dodatna 0.5 sekunde, tako da so 10 zahtevkov, ne 9.
}
Tukaj ustvarimo eno samo konfiguracijo, ki razširja tako konfiguracijo strežnika kot odjemalca. Prav tako konfiguriramo kontroler življenjskega cikla, ki bo običajno končal odjemalca in strežnik po življenjski dobi preteče interval.
Enaka zbirka implementacij storitev in konfiguracij se lahko uporabi za ustvarjanje razporeda sistema z dvema ločenima vozloma. Preprosto moramo ustvariti z ustreznimi storitvami:
Konfiguracija dveh vozlov
  objekt NodeServerConfig extends EchoConfig[String] with SigTermLifecycleConfig
  {
    tip NodeId = NodeIdImpl

    def nodeId = NodeServer

    override def portNumber: PortNumber = 8080
  }

  objekt NodeClientConfig extends EchoClientConfig[String] with FiniteDurationLifecycleConfig
  {
    \/\/ UPOZORILO! specifikacija odvisnosti
    def echoServiceDependency = NodeServerConfig.echoService

    def pollInterval: FiniteDuration = 1.second

    def lifetime: FiniteDuration = 10500.milliseconds \/\/ dodatna 0.5 sekunde, tako da so 10 zahtevkov, ne 9.

    def testMessage: String = "dolly"
  }
Poglejte, kako določamo odvisnost. Omenimo storitev, ki jo zagotavlja drugo vozlo, kot odvisnost trenutno vozla. Vrsta odvisnosti se preveri, ker vsebuje fantomsko vrsto, ki opisuje protokol. In v času izvajanja bomo imeli pravilno ID vozla. To je eden pomembnih vidikov predlaganega pristopa k konfiguraciji. Omogoča nam, da določimo vrata samo enkrat in se prepričamo, da se sklicujemo na pravilna vrata.
Implementacija dveh vozlov
Za to konfiguracijo uporabljamo natančno iste implementacije storitev. Nobenih sprememb. Vendar pa ustvarimo dve različni implementaciji vozlov, ki vsebujeta različne sklope storitev:
  objekt TwoJvmNodeServerImpl extends ZeroServiceImpl[IO] with EchoServiceService with SigIntLifecycleServiceImpl {
    tip Config = EchoConfig[String] with SigTermLifecycleConfig
  }

  objekt TwoJvmNodeClientImpl extends ZeroServiceImpl[IO] with EchoClientService with FiniteDurationLifecycleServiceImpl {
    tip Config = EchoClientConfig[String] with FiniteDurationLifecycleConfig
  }
Prvo vozlo implementira strežnik in potrebuje le strežniško konfiguracijo. Drugo vozlo implementira odjemalca in potrebuje drugo del konfiguracije. Obe vozli zahtevata določeno specifikacijo življenjskega cikla. Za namene te objave bo imel storitveni vozel neskončno življenjsko dobo, ki jo je mogoče končati z uporabo SIGTERM, medtem ko bo echo odjemalec končal po konfigurirani končni dobi. Poglejte za podrobnosti.
Celoten razvojni proces
Poglejmo, kako ta pristop spremeni način dela z konfiguracijo.
Konfiguracija kot koda bo skompilirana in bo ustvarila artefakt. Zdi se smiselno ločiti artefakt konfiguracije od drugih artefaktov kode. Pogosto imamo lahko množico konfiguracij na istem temelju kode. In seveda lahko imamo več različic različnih vej konfiguracije. V konfiguraciji lahko izberemo določene različice knjižnic in to bo ostalo nespremenjeno, kadar koli to konfiguracijo uporabimo.
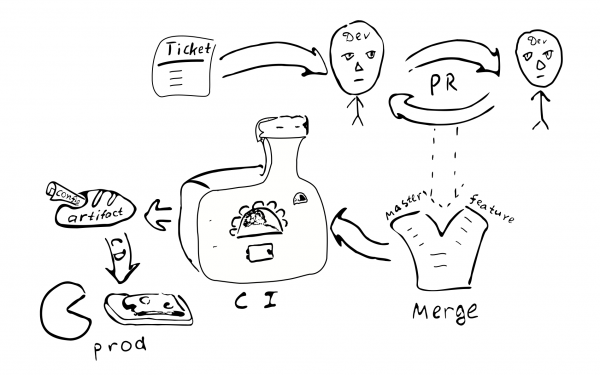
Sprememba konfiguracije postane sprememba kode. Zato bi morala biti pokrita s istim procesom zagotavljanja kakovosti:
Ticket -> PR -> pregled -> združitev -> stalna integracija -> stalno uvajanje
Obstajajo naslednje posledice pristopa:
- Konfiguracija je dosledna za določeno instanco sistema. Zdi se, da ni mogoče imeti napačne povezave med vozli.
- Nisi lahko spremeniti konfiguracijo zgolj na enem vozli. Zdi se nerazumljivo se prijaviti in spremeniti nekatere besedilne datoteke. Tako postane drift konfiguracije manj mogoč.
- Majhne spremembe konfiguracije niso enostavne za izvedbo.
- Večina sprememb konfiguracije bo sledila istemu razvojnemu procesu in bo prestala določen pregled.
Ali potrebujemo ločeno skladišče za konfiguracijo v produkciji? Konfiguracija v produkciji lahko vsebuje občutljive informacije, katerih ne želimo dati na voljo mnogim ljudem. Zato bi bilo smiselno, da imamo ločeno skladišče z omejenim dostopom, ki bo vsebovalo konfiguracijo za produkcijo. Konfiguracijo lahko razdelimo na dva dela - enega, ki vsebuje večino odprtih parametrov produkcije, in enega, ki vsebuje tajni del konfiguracije. To bi omogočilo dostop večine razvijalcev do večine parametrov, medtem ko bi omejili dostop do resnično občutljivih stvari. Enostavno lahko dosežemo to s srednjimi lastnostmi z privzetimi vrednostmi parametrov.
Variacije
Poglejmo prednosti in slabosti predlaganega pristopa v primerjavi z drugimi tehnikami upravljanja konfiguracij.
Najprej bomo našli nekaj alternativ različnim vidikom predlaganega načina reševanja konfiguracije:
- Besedilna datoteka na ciljnem računalniku.
- Centralizirano shranjevanje ključ-vrednost (kot je
etcd/zookeeper). - Podprocesne komponente, ki jih je mogoče ponovno konfigurirati/zagnati brez ponovnega zagon procesa.
- Konfiguracija zunaj artefakta in nadzora različic.
Besedilna datoteka daje določeno fleksibilnost v smislu ad-hoc popravkov. Sistem administrator se lahko prijavi na ciljnode, izvede spremembo in enostavno ponovno zažene storitev. To morda ni tako dobro za večje sisteme. Za spremembo ne ostane nobenih sledi. Sprememba ni pregledana s strani drugega para oči. Lahko je težko ugotoviti, kaj je povzročilo spremembo. Niti ni bila testirana. Z vidika porazdeljenega sistema se lahko administrator preprosto pozabi posodobiti konfiguracijo v enem od drugih vozlov.
(Mimogrede, če se bo na koncu pojavila potreba po uporabi besedilnih konfiguracijskih datotek, bomo morali le dodati parser + validator, ki bi lahko ustvaril enak Konfiguracija tip in to bi bilo dovolj za začetek uporabe besedilnih konfiguracij. To prav tako kaže, da je kompleksnost konfiguracije pri prevajanju nekoliko manjša od kompleksnosti besedilnih konfiguracij, saj potrebujemo v besedilni različici še nekaj dodatne kode.)
Centralizirano shranjevanje ključ-vrednost je dober mehanizem za distribucijo aplikacijskih metaparametrov. Tukaj moramo razmisliti o tem, kaj smatramo za konfiguracijske vrednosti in kaj je preprosto podatki. Glede na funkcijo C => A => B običajno imenujemo redko spreminjajoče se vrednosti C «konfiguracija», medtem ko pogosto spreminjani podatki A — preprosto vhodni podatki. Konfiguracija bi morala biti zagotovljena funkciji prej kot podatki. ANa podlagi te ideje lahko rečemo, da je pričakovana frekvenca sprememb tisto, kar bi se lahko uporabilo za razlikovanje konfiguracijskih podatkov od zgolj podatkov. Tudi podatki običajno prihajajo iz enega vira (uporabnik), medtem ko konfiguracija prihaja iz drugega vira (administrator). Ukvarjanje s parametri, ki se lahko spremenijo po začetni konfiguraciji, povečuje zapletenost aplikacije. Za takšne parametre bomo morali obravnavati njihov mehanizem dostave, razčlenjevanje in potrjevanje ter upravljanje napačnih vrednosti. Da bi zmanjšali kompleksnost programa, bi bilo bolje zmanjšati število parametrov, ki se lahko spreminjajo med izvajanjem (ali jih celo popolnoma odpraviti).
Iz perspektive te objave moramo narediti razliko med statičnimi in dinamičnimi parametri. Če logika storitve zahteva redke spremembe nekaterih parametrov med izvajanjem, jih lahko imenujemo dinamični parametri. V nasprotnem primeru so statični in jih je mogoče konfigurirati z uporabo predlaganega pristopa. Za dinamično reconfiguracijo bi lahko bile potrebne druge metode. Na primer, deli sistema bi se lahko ponovno zagnali z novimi konfiguracijskimi parametri na podoben način, kot se ponovno zažgejo posamezni procesi porazdeljenega sistema.
(Moje skromno mnenje je, da se je bolje izogibati reconfiguraciji med izvajanjem, ker povečuje zapletenost sistema.
Morda bi bilo bolj neposredno zaupati podpori operacijskega sistema za ponovno zagon procesov. Vendar pa to morda ni vedno mogoče.)
Eden pomembnih vidikov uporabe statične konfiguracije, ki včasih ljudem daje misliti o dinamični konfiguraciji (brez drugih razlogov), je izpad storitve med posodobitvijo konfiguracije. Res je, da če moramo izvesti spremembe v statični konfiguraciji, moramo znova zagnati sistem, da postanejo nove vrednosti učinkovite. Zahteve glede izpada se razlikujejo med različnimi sistemi, zato morda niso tako kritične. Če je kritično, moramo vnaprej načrtovati morebitne ponovne zagon sisteme. Na primer, lahko bi izvedli . V tem scenariju, ko moramo ponovno zagnati sistem, najprej začnemo novo instanco sistema vzporedno, nato preklopimo ELB nanjo, medtem ko prejšnjemu sistemu omogočimo dokončanje obdelave obstoječih povezav.
Kaj pa ohranjanje konfiguracije znotraj različice artefakta ali zunaj? Ohranjanje konfiguracije znotraj artefakta pomeni, da je v večini primerov ta konfiguracija prešla skozi enake procese zagotavljanja kakovosti kot drugi artefakti. Tako si lahko zagotovite, da je konfiguracija dobre kakovosti in zaupanja vredna. Nasprotno pa konfiguracija v ločeni datoteki pomeni, da ni sledi o tem, kdo in zakaj je spremenil to datoteko. Je to pomembno? Verjamemo, da je za večino proizvodnih sistemov bolje imeti stabilno in visoko kakovostno konfiguracijo.
Različica artefakta omogoča ugotovitev, kdaj je bil ustvarjen, katere vrednosti vsebuje, katere funkcionalnosti so omogočene/onkrajane, kdo je bil odgovoren za vsakokratno spremembo v konfiguraciji. Morda bo potrebnega nekaj truda, da ohranimo konfiguracijo znotraj artefakta, vendar je to oblikovalska izbira.
Prednosti & slabosti
Tu bi radi izpostavili nekatere prednosti in razpravljali o nekaterih slabostih predlaganega pristopa.
Prednosti
Značilnosti kompaktne konfiguracije celotnega porazdeljenega sistema:
- Statična preveritev konfiguracije. To daje visok nivo prepričanja, da je konfiguracija pravilna glede na tipe omejitve.
- Bogat jezik konfiguracije. Običajno so drugi pristopi konfiguracije omejeni na največ zamenjavo spremenljivk.
Z uporabo Scala lahko izkoristimo široko paleto jezikovnih funkcij, ki izboljšujejo konfiguracijo. Na primer, lahko uporabimo atribute za zagotavljanje privzetih vrednosti, objekte za določitev različnih obsegov, lahko se sklicujemo navalustvarjen le enkrat v zunanjih obsegu (DRY). Uporabiti je mogoče dobesedne zaporedja ali instance določenih razredov (Seq,Map, itd.). - DSL. Scala ima dobro podporo za pisce DSL. Te lastnosti lahko uporabimo za vzpostavitev jezika konfiguracije, ki je bolj priročen in prijazen za končne uporabnike, tako da je končna konfiguracija vsaj berljiva za uporabnike domene.
- Integriteta in koherenca med vozlišči. Ena izmed prednosti imeti konfiguracijo celotnega porazdeljenega sistema na enem mestu je, da so vse vrednosti definirane strogo enkrat in nato ponovno uporabljene na vseh mestih, kjer jih potrebujemo. Tudi varne deklaracije vrat zagotavljajo, da v vseh možnih pravilnih konfiguracijah bodo vozlišča sistema govorila isti jezik. Obstajajo izrecne odvisnosti med vozlišči, kar otežuje pozabiti zagotoviti nekatere storitve.
- Visoka kakovost sprememb. Splošni pristop k prenosu sprememb konfiguracije preko običajnega postopka PR postavlja visoke standarde kakovosti tudi v konfiguraciji.
- Sočasne spremembe konfiguracije. Kadar koli naredimo kakršne koli spremembe v konfiguraciji, avtomatsko uvajanje zagotavlja, da se vsa vozlišča posodobijo.
- Poenostavitev aplikacije. Aplikacija ne potrebuje razčlenjevanja in potrjevanja konfiguracije ter obvladovanja nepravilnih vrednosti konfiguracije. To poenostavi celotno aplikacijo. (Nekaj zapletenosti se poveča v sami konfiguraciji, vendar je to zavestna odločitev za varnost.) Vrnitev na običajno konfiguracijo je razmeroma enostavna — preprosto dodajte manjkajoče dele. Z začetkom s prevedeno konfiguracijo je lažje odložiti izvajanje dodatnih del na kasnejše obdobje.
- Različicna konfiguracija. Zaradi dejstva, da spremembe konfiguracije sledijo istemu razvojnemu procesu, dobimo artefakt z edinstveno različico. To nam omogoča, da se po potrebi vrnemo k prejšnji konfiguraciji. Lahko celo uvedemo konfiguracijo, ki je bila uporabljena pred letom dni, in delovala bo natanko enako. Stabilna konfiguracija izboljša predvidljivost in zanesljivost porazdeljenega sistema. Konfiguracija je določena ob prevodu in je ne moremo enostavno spremeniti v produkcijskem sistemu.
- Modularnost. Predlagani okvir je modularen in moduli se lahko kombinirajo na različne načine za
podpiranje različnih konfiguracij (nastavitev/postavitev). Zlasti je mogoče imeti majhno postavitev z enim vozliščem in veliko postavitev z več vozlišči. Smiselno je imeti več proizvodnih postavitev. - Testiranje. Za testne namene lahko oseba implementira lažno storitev in jo uporablja kot odvisnost na varno tipiziran način. Hkrati je mogoče obdržati več različnih testnih postavitev z različnimi deli, zamenjanimi z lažnimi.
- Integracijsko testiranje. Včasih je v porazdeljenih sistemih težko izvesti integracijske teste. Z uporabo opisanega pristopa k varnemu tipiziranju konfiguracije celotnega porazdeljenega sistema lahko vse porazdeljene dele izvajamo na enem strežniku na nadzorovan način. Enostavno je posnemati situacijo
ko ena od storitev postane nedostopna.
Slabosti
Pristop k prevedeni konfiguraciji se razlikuje od „normalne“ konfiguracije in morda ne ustreza vsem potrebam. Tukaj je nekaj slabosti prevedene konfiguracije:
- Statistična konfiguracija. Morda ni primerna za vse aplikacije. V nekaterih primerih je treba hitro popraviti konfiguracijo v produkciji, obhoditi vse varnostne ukrepe. Ta pristop oteži. Po vsaki spremembi konfiguracije so potrebni prevod in ponovna uvedba. To je hkrati lastnost in breme.
- Generacija konfiguracije. Ko je konfiguracija ustvarjena z nekim orodjem za avtomatizacijo, ta pristop zahteva nadaljnji prevod (kar se lahko nato tudi neuspešno izvrši). Morda je potrebno dodatno delo za integracijo tega dodatnega koraka v sistem gradnje.
- Orodja. Danes je na voljo veliko orodij, ki temeljijo na besedilnih konfiguracijah. Nekatera od njih
ne bodo uporabna, ko je konfiguracija prevedena. - Potrebna je sprememba v načinu razmišljanja. Razvijalci in DevOps so seznanjeni z datotekami za besedilne konfiguracije. Ideja o prevajanju konfiguracije se jim lahko zdi nenavadna.
- Preden uvedemo prevodljivo konfiguracijo, je potreben visokokvaliteten proces razvoja programske opreme.
Obstajajo nekatere omejitve implementiranega primera:
- Če zagotovimo dodatno konfiguracijo, ki je ne zahteva implementacija vozlišča, nam prevajalnik ne bo pomagal odkriti odsotne implementacije. To bi lahko rešili z uporabo
HListali ADT-jev (primerne razrede) za konfiguracijo vozlišča namesto lastnosti in vzorca torte. - V datoteki konfiguracije moramo zagotoviti nekaj predloge: (
package,uvoz,objektizjav;
prekliči def‘s za parametre, ki imajo privzete vrednosti). To se lahko delno reši z uporabo DSL. - V tem prispevku ne pokrivamo dinamičnega reconfiguriranja grozdov podobnih vozlišč.
Zaključek
V tem prispevku smo razpravljali o ideji neposrednega predstavitve konfiguracije v izvorni kodi na tipno varnem načinu. Ta pristop bi se lahko uporabil v mnogih aplikacijah kot zamenjava za xml- in druge besedilne konfiguracije. Kljub temu, da je naš primer implementiran v Scali, ga je mogoče tudi prevesti v druge prevajljive jezike (kot so Kotlin, C#, Swift itd.). Ta pristop bi lahko preizkusili v novem projektu in, če se ne obnese dobro, prešli na staromoden način.
Seveda, prevodljiva konfiguracija zahteva visokokvaliteten razvojni proces. V zameno obljublja, da bo ponudila enako visokokvalitetno robustno konfiguracijo.
Ta pristop bi se lahko razširil na različne načine:
- Učinkovite makre bi lahko uporabili za preverjanje konfiguracije in odpoved ob prevajanju v primeru kršitev poslovne logike.
- DSL bi se lahko implementiral za predstavitev konfiguracije na način, prijazen do uporabnika z domeno.
- Dinamično upravljanje virov z avtomatskimi prilagoditvami konfiguracije. Na primer, ko prilagodimo število vozlišč grozda, bi želeli (1) da vozlišča pridobijo malenkost spremenjeno konfiguracijo; (2) da upravitelj grozda prejme informacije o novih vozliščih.
Hvala
Rad bi se zahvalil Andreyju Saksonovu, Pavlu Popovu, Antonu Nehaevu za navdihujoče povratne informacije o osnutku tega prispevka, ki so mi pomagale, da je bolj jasen.
Izvor: habr.com
