

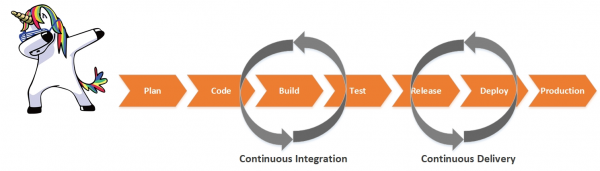
Trenutno je popularna tema DevOps. Cjevovod kontinuirane integracije i dostave primjenjuju svi koji to žele. No, većina ne posvećuje uvijek dovoljno pozornosti osiguravanju pouzdanosti rada informacijskih sustava u različitim fazama CI/CD cjevovoda. U ovom članku želim podijeliti svoja iskustva s automatizacijom provjera kvalitete softvera i implementacijom mogućih scenarija za njegovo 'samoobnavljanje'.
Radim kao inženjer u odjelu za upravljanje IT uslugama u tvrtki . Moj stručni fokus je na implementaciji različitih sustava za praćenje performansi i dostupnosti aplikacija. Često komuniciram s IT naručiteljima iz različitih tržišnih segmenata o aktualnim pitanjima praćenja kvalitete njihovih IT usluga. Glavni cilj je minimizirati vrijeme ciklusa izdanja i povećati učestalost njihovog objavljivanja. To, naravno, zvuči dobro: više izdanja – više novih značajki – više zadovoljnih korisnika – više profita. No, u praksi to ne ide uvijek tako dobro. Pri vrlo visokim tempovima implementacije odmah se postavlja pitanje kvalitete naših izdanja. Čak i uz potpuno automatizirani cjevovod, jedan od najvećih problema je prijenos usluga iz testiranja u proizvodnju, a da to ne utječe na vrijeme neprekidnog rada i interakciju korisnika s aplikacijom.
Na temelju brojnih razgovora s naručiteljima mogu reći da su kontrola kvalitete izdanja, problem pouzdanosti aplikacije i mogućnost njezinog 'samoobnavljanja' (na primjer, povratak na stabilnu verziju) u različitim fazama CI/CD cjevovoda - među najuzbudljivijim i najaktualnijim temama.
Nedavno sam i sam radio s naručiteljem - u službi podrške aplikativnog softvera online banke. U arhitekturi naše aplikacije korišteno je mnogo vlastitih mikrousluga. Najtužnije je to što se ne svi programeri snalaze s visokim tempovima razvoja, kvaliteta nekih mikrousluga pati, što je dovelo do smiješnih nadimaka za njih i njihove stvaratelje. Pojavljivale su se priče o tome od kojih se materijala stvaraju ti proizvodi.
Postavljanje zadatka
Visoka frekvencija izdanja i veliki broj mikroservisa otežavaju razumevanje funkcionisanja aplikacije u celini, kako u fazi testiranja, tako i u fazi eksploatacije. Promene se dešavaju neprekidno i teško je kontrolisati ih bez kvalitetnih alata za nadgledanje. Često nakon noćnog izdanja, programeri ujutro sede kao na barutu i čekaju da se ništa ne pokvari, iako su sve provere tokom testiranja bile uspešne.
Postoji još jedna stvar. U fazi testiranja proverava se funkcionalnost softvera: izvršavanje osnovnih funkcija aplikacije i odsustvo grešaka. Kvalitativne ocene performansi su ili odsutne ili ne uzimaju u obzir sve aspekte rada aplikacije i integracioni sloj. Neke metrike se čak i ne proveravaju. Kao rezultat, kada dođe do kvara u produkcionom okruženju, tim za tehničku podršku saznaje za to tek kada se stvarni korisnici počnu žaliti. Želimo da minimiziramo uticaj nekvalitetnog softvera na krajnje korisnike.
Jedan od načina rešenja je uvođenje procesa provere kvaliteta softvera na različitim fazama CI/CD Pipeline-a, dodavanje raznih scenarija za oporavak sistema u slučaju nesreće. Takođe, ne zaboravimo da imamo DevOps. Biznis očekuje što brže dobijanje novog proizvoda. Zato svi naši testovi i scenariji moraju biti automatizovani.
Zadatak se deli na dva dela:
- kontrola kvaliteta izdanja u fazi testiranja (automatizovati proces hvatanja nekvalitetnih izdanja);
- kontrola kvaliteta softvera u produkcionom okruženju (mehanizmi automatskog otkrivanja problema i mogući scenariji za njihovo samoopravljenje).
Alat za nadgledanje i prikupljanje metrika
Da bismo realizovali postavljene zadatke, potreban nam je sistem nadgledanja sposoban da otkriva probleme i prenosi ih u automatizacione sisteme na različitim fazama CI/CD konvaja. Takođe, pozitivna stvar bi bila ako bi taj sistem pružio korisne metrike za različite timove: razvoj, testiranje, eksploataciju. I bilo bi divno ako bi i za biznis.
Za zbiranje metrik lahko uporabite kombinacijo različnih sistemov (Prometheus, ELK Stack, Zabbix itd.), vendar se mi zdi, da so za te naloge najbolje primerna APM rešitve (), ki vam znatno poenostavijo življenje.
V sklopu svojega dela v podporni službi sem začel razvijati podoben projekt, ki temelji na APM rešitvi podjetja Dynatrace. Zdaj, ko delam v integratorju, dobro poznam trg sistemov za spremljanje. Moje subjektivno mnenje: Dynatrace je najbolj primeren za reševanje takšnih nalog.
Rešitev Dynatrace ponuja horizontalno prikazovanje vsake uporabniške operacije z globoko stopnjo podrobnosti do ravni izvajanja kode. Vse povezave med različnimi informacijskimi storitvami lahko spremljamo: od nivojev front-end spletnih in mobilnih aplikacij, back-end strežnikov aplikacij, integracijske hrbtenice do konkretnega klica v BDP.
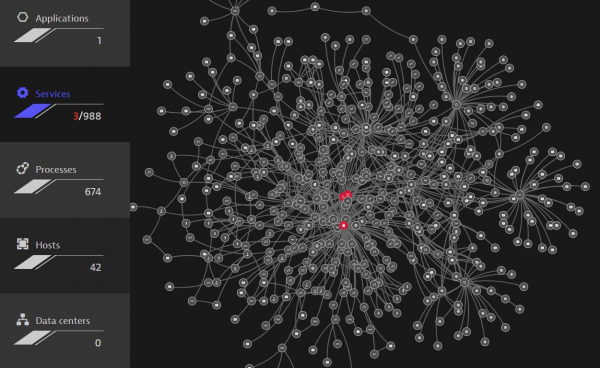 . Samodejno grajenje vseh odvisnosti med komponentami sistema
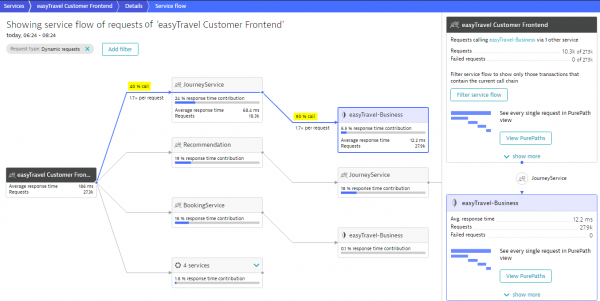 . Samodejno določanje in grajenje poti izvajanja storitve
Prav tako ne pozabite, da se moramo integrirati z različnimi orodji za avtomatizacijo. Tu rešitev ponuja priročen API, ki omogoča pošiljanje in prejemanje različnih metrik in dogodkov.
Nato preidimo k podrobnejšemu pregledu, kako rešiti zastavljene naloge s pomočjo sistema Dynatrace.
Naloga 1. Avtomatizacija nadzora kakovosti gradnje v fazi testiranja
Prva naloga je najti težave čim prej v fazah dostavnega konvejerja aplikacije. Na produkcijske okolje morajo prispeti le „dobre“ gradnje kode. Zato morajo biti v vašem pipeline-u v fazi testiranja vključeni dodatni monitorji za preverjanje kakovosti vaših storitev.
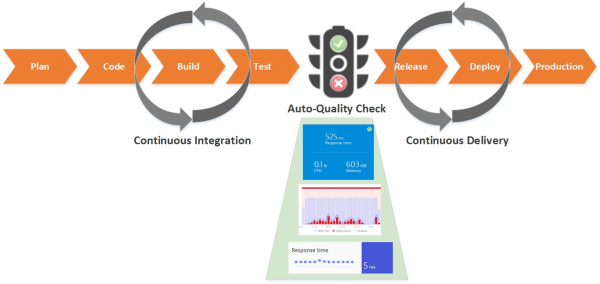
Poglejmo po korakih, kako to realizirati in avtomatizirati ta postopek:
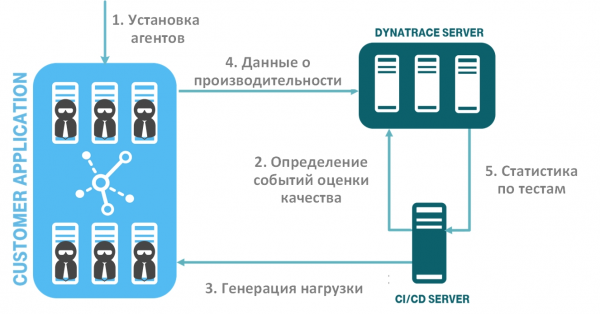
Na sliki je prikazan tok avtomatiziranih korakov preverjanja kakovosti programske opreme:
- namestitev sistema za spremljanje (namestitev agentov);
- določitev dogodkov ocenjevanja kakovosti vaše programske opreme (metrike in pragovne vrednosti) in prenos v sistem spremljanja;
- generacija obremenitve in testov zmogljivosti;
- zbiranje podatkov o zmogljivosti in razpoložljivosti v sistemu spremljanja;
- prenos podatkov o testih, ki temeljijo na dogodkih ocene kakovosti programske opreme, iz sistema za spremljanje v sistem CI/CD. Samodejna analiza graditev.
Korak 1. Namestitev sistema za spremljanje
Najprej je treba namestiti agente v vaše testno okolje. Pri tem ima rešitev Dynatrace privlačno lastnost – uporablja univerzalnega agenta OneAgent, ki se namesti na OS instanco (Windows, Linux, AIX), samodejno odkrije vaše storitve in začne zbirati podatke o monitoring. Ni vam treba posebej nastaviti agenta za vsak proces. Podobna situacija bo tudi za oblačne in kontejnerske platforme. Postopek namestitve agentov lahko tudi avtomatizirate. Dynatrace se odlično prilega konceptu "infrastruktura kot koda" (): na voljo so že pripravljeni skripti in navodila za vse priljubljene platforme. Vključite agenta v konfiguracijo vaše storitve, in ob njeni namestitvi takoj dobite novo storitev z delujočim agentom.
Korak 2. Določitev dogodkov ocene kakovosti vaše programske opreme
Zdaj je treba določiti seznam storitev in poslovnih operacij. Pomembno je upoštevati prav tiste uporabniške operacije, ki so poslovno kritične za vašo storitev. Priporočam, da se posvetujete z poslovnimi in sistemskimi analitiki.
Nato je treba določiti, katere metrike želite vključiti v preverjanje za vsako raven. Na primer, to so lahko čas izvajanja (z razlikovanjem na povprečje, mediano, percentile itd.), napake (logične, storitvene, infrastrukturne itd.) in različne infrastrukturne metrike (memory heap, garbage collector, thread count itd.).
Zaradi avtomatizacije in udobja uporabe ekip DevOps se uvaja koncept "Monitoring kot koda". Pod tem razumem – razvijalec/tester lahko napiše preprost JSON datoteko, ki določa kazalnike za preverjanje kakovosti programske opreme.
Poglejmo primer take JSON datoteke. Kot par ključ/vrednost se uporabljajo objekti iz Dynatrace API (opis API je na voljo tukaj ).
{
   "timeseries": [
   {
     "timeseriesId": "service.ResponseTime",
     "aggregation": "avg",
     "tags": "Frontend",
     "severe": 250000,
     "warning": 1000000
   },
   {
     "timeseriesId": "service.ResponseTime ",
     "aggregation": "avg",
     "tags": "Backend",
     "severe": 4000000,
     "warning": 8000000
   },
   {
     "timeseriesId": "docker.Container.Cpu",
     "aggregation": "avg",
     "severe": 50,
     "warning": 70
   }
  ]
}
Datoteka predstavlja niz definicij vremenskih serija (timeseries):
- timeseriesId – metrika koju provjeravamo, na primjer, Response Time, Error count, Memory used itd.;
- aggregation — nivo agregacije metrika, u našem slučaju avg, ali možete koristiti bilo koji nivo koji vam je potreban (avg, min, max, sum, count, percentile);
- tags – oznaka objekta u sistemu monitoringa, ili možete navesti konkretni identifikator objekta;
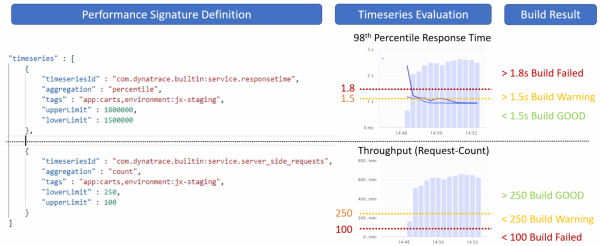
- severe i warning – ovi pokazatelji regulišu pragove naših metrika, ako vrednost testova premaši prag severe, naša zbirka se označava kao neuspješna.
Na sljedećem dijagramu prikazan je primjer korištenja takvih pragova.
Korak 3. Generacija opterećenja
Nakon što odredimo nivoe kvaliteta naše usluge, potrebno je generisati testno opterećenje. Možete koristiti bilo koji od alata za testiranje koji vam odgovaraju, na primjer, Jmeter, Selenium, Neotys, Gatling itd.
Sistem monitoringa Dynatrace omogućava prikupljanje različitih metapodataka iz vaših testova i prepoznaje koji testovi pripadaju kojem ciklusu izdanja i kojoj usluzi. Preporučuje se dodavanje dodatnih zaglavlja u HTTP zahtjeve testa.
Na sljedećem dijagramu prikazan je primjer gdje dodatnim zaglavljem X-Dynatrace-Test označavamo da se ovaj test odnosi na testiranje operacije dodavanja proizvoda u korpu.
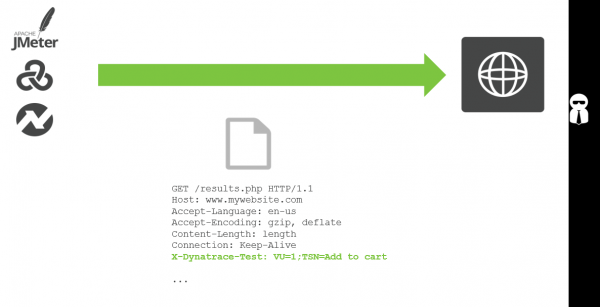
Prilikom pokretanja svakog test opterećenja, šaljete dodatne kontekstualne informacije u Dynatrace putem API događaja sa CI/CD servera. Na taj način sistem može razlikovati različite testove.
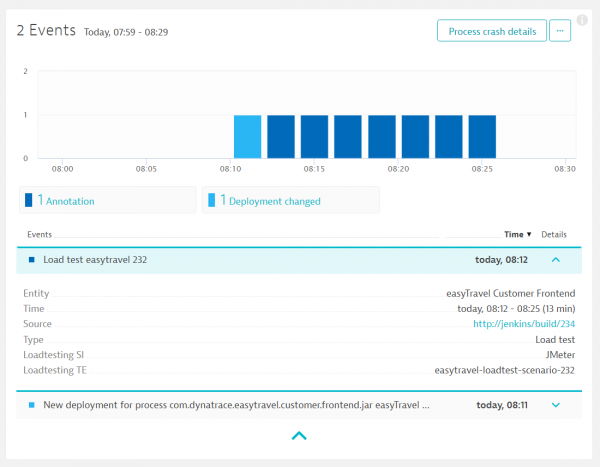 . Događaj u sistemu monitoringa o pokretanju testiranja opterećenja
Korak 4-5. Prikupljanje podataka o performansama i prenos podataka u CI/CD sistem
Zajedno sa generisanim testom u sistem monitoringa šalje se događaj o potrebi prikupljanja podataka o proveri pokazatelja kvaliteta usluge. Takođe se navodi naš JSON fajl u kojem su definisane ključne metrike.
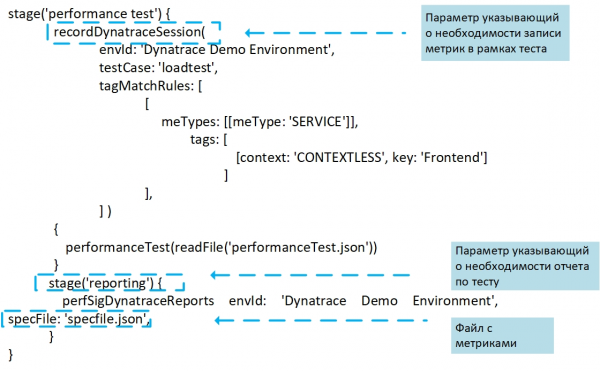 Dogodek, ki zahteva preverjanje kakovosti programske opreme, se ustvari na CI/CD strežniku za pošiljanje v sistem za spremljanje.
V našem primeru se dogodek o preverjanju kakovosti imenuje perfSigDynatraceReport (Performance_Signature) – to je pripravljen za integracijo z Jenkinsom, ki so ga razvili fantje iz T-Systems Multimedia Solutions. V vsakem dogodku zagona preverjanja je vključena informacija o storitvi, številu različice, času testiranja. Vtičnik zbira vrednosti učinkovitosti med gradnjo, jih ocenjuje in primerja rezultate s prejšnjimi različicami ter nefunkcionalnimi zahtevami.
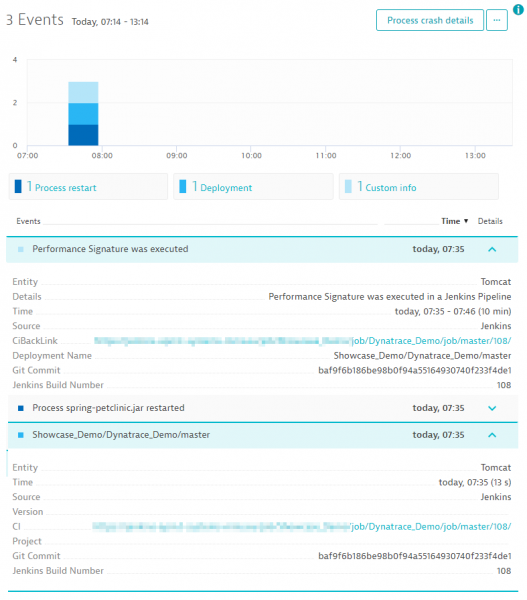 Dogodek v sistemu spremljanja o začetku preverjanja kakovosti gradnje.
Po zaključku testa se vse meritve za oceno kakovosti programske opreme vrnejo nazaj v sistem neprekinjene integracije, na primer Jenkins, ki oblikuje poročilo o rezultatih.
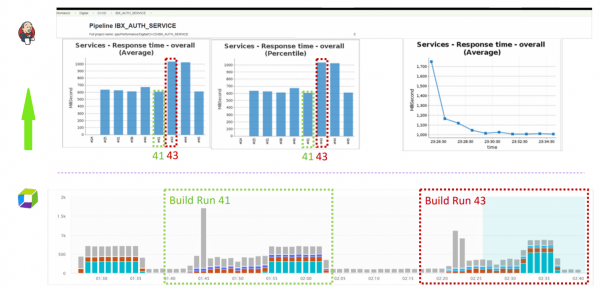 Rezultati statistike gradnje na CI/CD strežniku.
Za vsako posamezno različico vidimo statistiko za vsako meritev, ki smo jo določili, med izvajanjem celotnega testa. Prav tako vidimo, ali so bili kršeni določeni pragovi (warning in severe-thresholds). Na podlagi skupnih pokazateljev se celotna gradnja označi kot stabilna, nestabilna ali neuspešna. Prav tako lahko za udobje dodate v poročilo primerjalne podatke trenutne različice s prejšnjo.
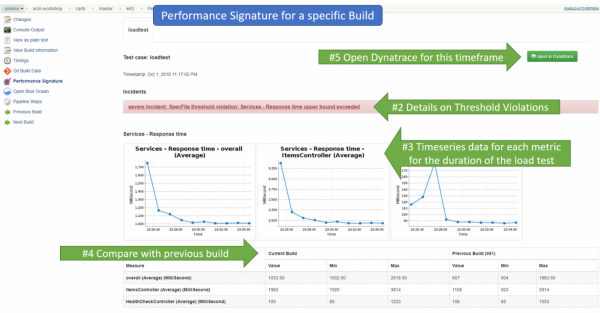 Pregled podrobne statistike gradnje na CI/CD strežniku.
Podrobno primerjanje dveh različic
Po potrebi se lahko preklopi v vmesnik Dynatrace in tam podrobneje pregleda statistiko za vsako vašo različico ter jih med seboj primerja.
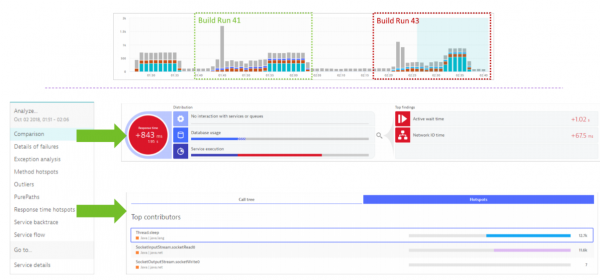 Primerjava statistike gradnje v Dynatrace.
Zaključki
Na koncu dobimo storitev «spletno spremljanje kot storitev», avtomatizirano v kontejnerju neprekinjene integracije. Razvijalcu ali testerju je potrebno le določiti seznam meritev v JSON datoteki, vse ostalo pa se zgodi samodejno. Dobimo pregledno kontrolo kakovosti izdaj: vse obvestila o učinkovitosti, porabi virov ali arhitekturnih regresijah.
Naloga 2. Avtomatizacija nadzora kakovosti programske opreme v produkcijskem okolju.
Tako smo rešili vprašanje avtomatizacije procesa spremljanja v fazi testiranja v Pipeline. Na ta način minimiziramo odstotek nekakovostnih gradb, ki pridejo v produkcijsko okolje.
A что делать, когда плохое ПО все же попадает в продакшн, или когда что-то просто начинает ломаться? Нам хотелось бы, чтобы в идеале были механизмы автоматического обнаружения проблем, и система могла бы сама восстанавливать свою работоспособность, хотя бы в ночное время.
Для этого нам нужно, аналогично предыдущему разделу, предусмотреть автоматические проверки качества ПО в продакшн-среде и закладывать сценарии для самовосстановления системы.
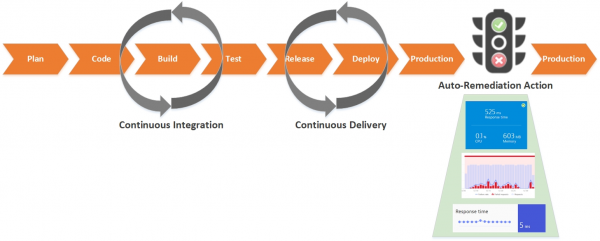
Автоисправление как код
В большинстве компаний уже имеется накопленная база знаний по различным типам распространенных проблем и список действий по их устранению, таких как перезапуск процессов, очистка ресурсов, откат версий, восстановление неверных изменений конфигурации, увеличение или уменьшение количества компонентов в кластере, переключение с синего на зеленый контур и так далее.
Хотя эти варианты использования известны многим командам на протяжении многих лет, лишь немногие задумывались и инвестировали в их автоматизацию.
Если вдуматься, в реализации процессов самовосстановления приложения нет ничего сложного. Нужно лишь представить известные сценарии работы ваших администраторов в виде кода (концепция «автоисправление как код»), который вы заранее написали для каждой конкретной ситуации. Сценарии автоматического исправления должны быть направлены на устранение первопричины проблемы. Вы сами устанавливаете правильные действия реагирования на инцидент.
В качестве триггера для запуска сценария может выступать любая метрика из вашей системы мониторинга. Главное, чтобы эти метрики точно определяли критические ситуации, так как не хотелось бы получать ложные срабатывания в продуктивной среде.
Вы можете использовать любую систему или комбинацию систем: Prometheus, ELK Stack, Zabbix и т.д. Я приведу несколько примеров на основе решения APM (в качестве примера будет Dynatrace), которое также облегчит вашу жизнь.
Во-первых, здесь есть все, что касается производительности с точки зрения приложения. Решение предоставляет сотни метрик на различных уровнях, которые вы можете использовать в качестве триггеров:
- ravni uporabnikov (brskanje, mobilne aplikacije, IoT naprave, vedenje uporabnikov, konverzija itd.);
- ravni storitev in operacij (zmogljivost, razpoložljivost, napake itd.);
- ravni infrastrukture aplikacije (metrike OS gostitelja, JMX, MQ, spletni strežnik itd.);
- ravni platform (virtualizacija, oblak, kontejner itd.).
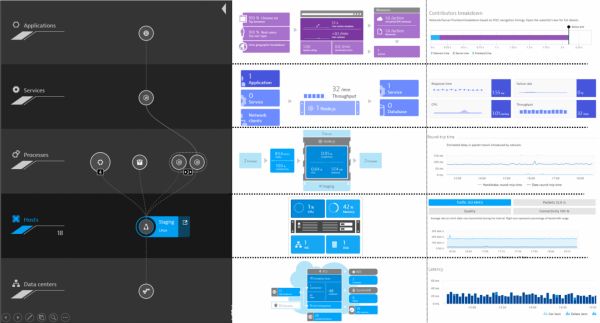 Ravni spremljanja v Dynatrace.
Kot sem že omenil, ima Dynatrace odprt API, ki omogoča zelo enostavno integracijo z različnimi zunanjimi sistemi. Na primer, pošiljanje obvestil v sistem avtomatizacije ob prekoračitvi kontrolnih parametrov.
Spodaj je primer za interakcijo z Ansible.
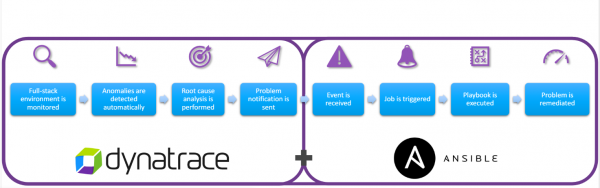
Natančneje, prinašam nekaj primerov, katera avtomatizacijo lahko izvajamo. To je le del primerov, njihov seznam v vašem okolju pa je lahko omejen le na vašo domišljijo in možnosti vaših spremljevalnih orodij.
1. Slaba razporeditev – povratna različica
Tudi če vse zelo dobro preverimo v testnem okolju, še vedno obstaja možnost, da nova različica lahko uniči vašo aplikacijo v produkcijskem okolju. Človeški faktor še vedno ostaja.
Na naslednji sliki vidimo, da pride do nenadnega skoka v času izvajanja operacij na storitvi. Začetek tega skoka sovpada s časom razporeditve na aplikacijo. Vse te informacije kot dogodke prenašamo v sistem avtomatizacije. Če delovanje storitve ne normalizira v predpisanem času, se samodejno izvede skript, ki vrne različico na prejšnjo.
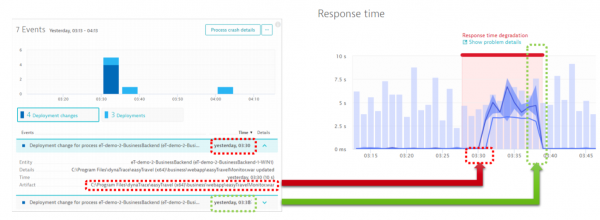 Degradacija zmogljivosti operacij po razporeditvi.
2. Obremenitev virov 100% – dodajanje vozlišča v usmerjanje
Na naslednjem primeru sistem spremljanja ugotovi, da na eni od komponent opazimo obremenitev CPU na 100%.
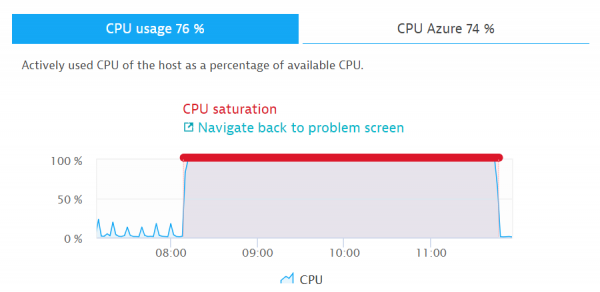 Obremenitev CPU 100%
Ob tem dogodku je mogoče izvesti več različnih scenarijev. Na primer, sistem spremljanja dodatno preveri, ali je pomanjkanje virov povezano s povečanjem obremenitve storitve. Če je to res, se izvede skript, ki samodejno doda vozlišče v usmerjanje, s čimer se obnovi delovanje sistema kot celote.
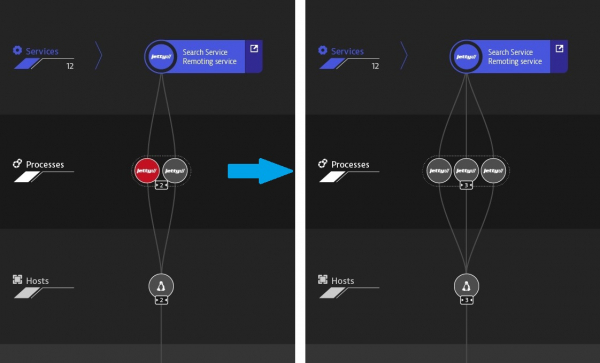 Širitev po incidentu
3. Pomanjkanje prostora na trdem disku – čiščenje diska
Menim view, da so ti procesi pri mnogih že avtonomizirani. S pomočjo APM lahko prav tako spremljamo prosti prostor na diskovnem sistemu. V primeru pomanjkanja prostora ali počasnega delovanja diska pokličemo skript za čiščenje ali dodamo prostor.
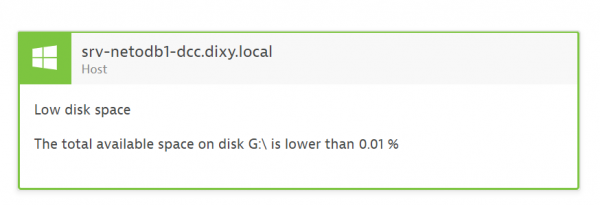
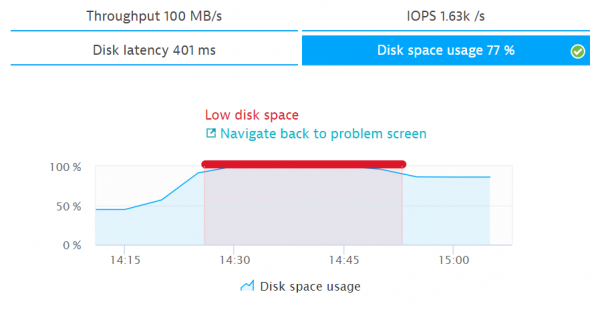 Zasedenost diska 100%
4. Nizka aktivnost uporabnikov ali nizka konverzija – preklop med modrim in zelenim okoljem
Pogosto srečujem naročnike, ki uporabljajo dve okolji (blue-green deploy) za aplikacije v produkcijskem okolju. To omogoča hitro preklapljanje med vejami pri dostavi novih izdaj. Pogosto se po uvedbi lahko zgodijo pomembne spremembe, ki jih ni mogoče takoj opaziti. Pri tem degradacija zmogljivosti in dostopnosti morda ni opazna. Za hitro odzivanje na take spremembe je bolje uporabiti različne metrike, ki odražajo obnašanje uporabnikov (število sej in dejanj uporabnikov, konverzija, bounce rate). Na naslednji sliki je prikazan primer, kjer ob padcu konverzije pride do preklopa med vejami programske opreme.
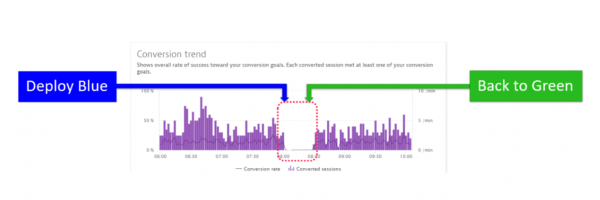 Padanje konverzije po preklopu med vejami programske opreme.
Mehanizmi za samodejno odkrivanje težav
Na koncu bom navedel še en primer, zakaj imam najraje Dynatrace.
V delu moje zgodbe o avtomatizaciji preverjanja kakovosti gradiv v testnem okolju smo vse mejne vrednosti določili ročno. Za testno okolje je to normalno, saj tester sam določa kazalnike pred vsakim preverjanjem, odvisno od obremenitve. V produkcijskem okolju pa je zaželeno, da se težave odkrijejo samodejno ob upoštevanju različnih mehanizmov baseline.
Dynatrace ima zanimiva vgrajena orodja umetne inteligence, ki na podlagi mehanizmov za odkrivanje anomalij (baselining) in gradnje zemljevida interakcij med vsemi komponentami, pri čemer primerja in korelira dogodke med seboj, določajo anomalije v delovanju vaše storitve in zagotavljajo podrobne informacije o vsaki težavi in njeni osnovni vzrok.
Skozi avtomatsko analizo odvisnosti med komponentami Dynatrace ugotovi ne le to, ali je problematična storitev glavna vzrok, temveč tudi njeno odvisnost od drugih storitev. V spodnjem primeru Dynatrace samodejno sledi in ocenjuje delovanje vsake storitve v okviru izvrševanja transakcij ter identificira storitev Golang kot glavni vzrok.
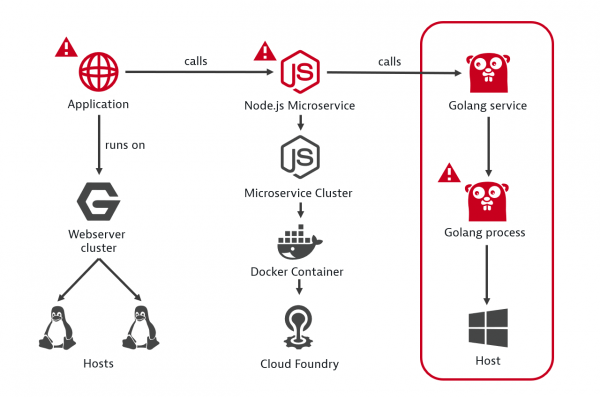 Primer določanja korenskega vzroka napake.
Na naslednji sliki je prikazan postopek spremljanja težav vašega aplikacije od začetka incidenta.
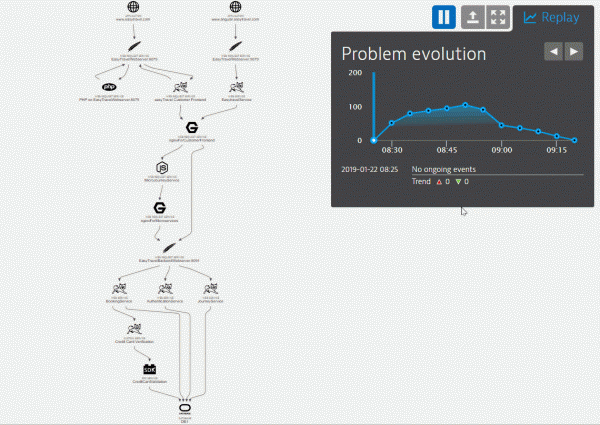 Vizualizacija nastale težave z upoštevanjem vseh komponent in dogodkov na njih.
Sistem monitoringa je zbral celotno kronologijo dogodkov povezane z nastalo težavo. V oknu pod časovnim grafom vidimo vse ključne dogodke na vsaki od komponent. Na podlagi teh dogodkov lahko določite postopke za samodejno odpravljanje težav v obliki kodnih skript.
Priporočam tudi integracijo sistema monitoringa s Service Desk ali bug trackerjem. Ko nastane težava, razvijalci hitro prejmejo vse potrebne informacije za analizo na ravni kode v produkcijskem okolju.
Zaključek
Na koncu smo dobili CI/CD cevovod z vključenimi avtomatiziranimi pregledi kakovosti programske opreme v Pipeline. Minimimiziramo število nekvalitetnih graditev, povečujemo zanesljivost sistema kot celote in, če pride do okvare sistema, sprožimo mehanizme za njegovo obnovitev.
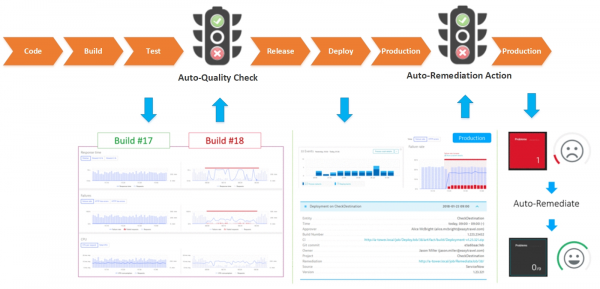
V avtomatizacijo monitoringa kakovosti programske opreme je vsekakor vredno vložiti trud, ni vedno hiter proces, a sčasoma bo obrodilo sadove. Priporočam, da takoj po rešitvi novega incidenta v produkciji razmislite o dodajanju monitorjev za preverjanje v testnem okolju, da se izognete vnosu slabe gradnje v produkcijo, ter sestavite skript za samodejno odpravljanje teh težav.
Upam, da vam moji primeri pomagajo pri vaših prizadevanjih. Prav tako me zanima, katere metrike uporabljate za izvajanje samovzdrževanja delovanja sistemov.
Izvor: habr.com
