

Op. prev.: Ta zgodba Omio – evropskega agregatorja potovanj – vodi bralce od osnovne teorije do zanimivih praktičnih podrobnosti pri konfiguraciji Kubernetes. Seznanitev s takšnimi primeri ne le širi obzorja, temveč tudi preprečuje netrivijalne težave.
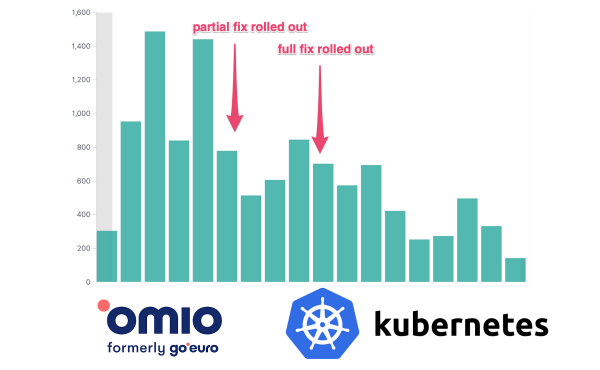
Ali ste se kdaj soočili s situacijo, ko se je aplikacija »zatrla«, prenehala odgovarjati na zdravstvene preglede (health check) in niste mogli razumeti vzroka takega vedenja? Ena od možnih razlag je povezana z omejitvijo kvot za CPU. O tem bo tekla beseda v tem članku.
TL;DR:
Močno priporočamo, da se izogibate omejitvam CPU v Kubernetes (ali onemogočite CFS kvote v Kubelet-u), če uporabljate različico jedra Linux z napako CFS kvot. V jedru je resna in napaka, ki vodi v pretirano omejevanje in zakasnitve..
V Omio vsa infrastruktura deluje na Kubernetes.Vse naše stateful in stateless obremenitve delujejo izključno na Kubernetes (uporabljamo Google Kubernetes Engine). V zadnjih šestih mesecih smo začeli opažati naključne zamude. Aplikacije se zataknejo ali prenehajo odgovarjati na zdravstvene preglede, izgubijo povezavo z omrežjem itd. Takšno vedenje nas je dolgo spravljalo v obup, in končno smo se odločili, da se težavi posvetimo na polno.
Povzetek članka:
- Nekaj besed o vsebniki in Kubernetes;
- Kako so implementirane zahteve in omejitve CPU;
- Kako omejitev CPU deluje v večjedrnih okoljih;
- Kako spremljati omejevanje CPU;
- Reševanje težave in podrobnosti.
Nekaj besed o vsebniki in Kubernetes
Kubernetes je v bistvu sodoben standard v svetu infrastrukture. Njegova glavna naloga je orkestracija vsebnikov.
Kontejnerji
V preteklosti smo morali ustvarjati artefakte, kot so Java JAR/WAR datoteke, Python Eggi ali izvršljive datoteke za nadaljnje izvajanje na strežnikih. Vendar pa smo da bi jih uspeli funkcionalno zagnati, morali opraviti še dodatno delo: namestiti izvajalno okolje (Java/Python), postaviti potrebne datoteke na prava mesta, zagotoviti združljivost s specifično različico operacijskega sistema itd. Z drugimi besedami, morali smo nameniti veliko pozornosti upravljanju konfiguracijam, kar je pogosto povzročalo spore med razvijalci in sistemskimi skrbniki.
Vse posodobe so to spremenile. Zdaj je artefakt kontejnerska slika. Lahko si jo predstavljamo kot razširjeno izvršno datoteko, ki ne vsebuje le programa, temveč tudi celovito okolje za izvajanje (Java/Python/…) ter potrebne datoteke/pakete, prednameščene in pripravljene za zagon. Kontejnerje lahko uvajamo in zaženemo na različnih strežnikih brez dodatnih korakov.
Poleg tega kontejnerji delujejo v svojem lastnem okolju peskovnika. Imajo svoj lasten virtualni omrežni adapter, lasten datotečni sistem z omejenim dostopom, svojo hierarhijo procesov, svoje omejitve glede CPU in pomnilnika itd. Vse to je omogočeno zaradi posebne podsklade jedra Linux — namespaces (imeninska prostora).
Kubernetes
Kot smo že omenili, je Kubernetes orkestrator kontejnerjev. Deluje na naslednji način: zagotovite mu skupino računalnikov in nato rečete: "Hej, Kubernetes, zaženi deset primerkov mojega kontejnerja z 2 procesorjema in 3 GB pomnilnika za vsakogar ter jih ohrani v delovnem stanju!" Kubernetes se bo poskrbel za vse ostalo. Poiskal bo razpoložljive zmogljivosti, zagnal kontejnerje in jih po potrebi ponovno zagnal, izdal posodobitve ob spremembi različic itd. V bistvu Kubernetes omogoča, da se abstrahiramo od strojne opreme in naredi vse raznolikosti sistemov primerne za uvajanje in delovanje aplikacij.
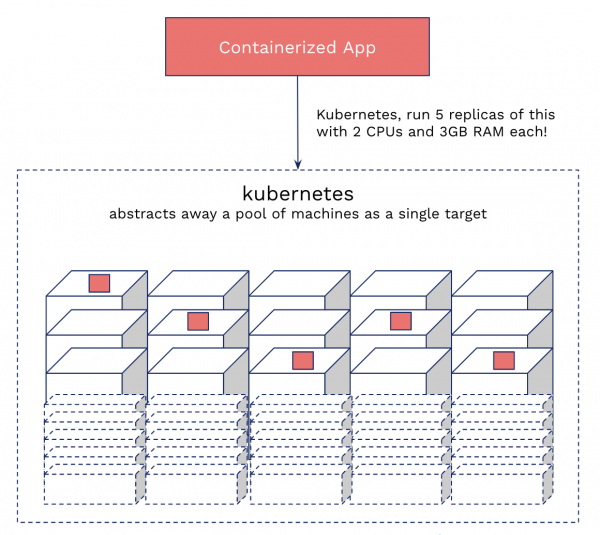
Kubernetes z vidika navadnega uporabnika
Kaj so requesti in limiti v Kubernetesu
V redu, spoznali smo kontejnerje in Kubernetes. Prav tako vemo, da lahko več kontejnerjev deluje na istem računalniku.
Lahko naredimo analogijo s skupnim stanovanjem. Vzame se prostoren prostor (računalniki/vozli) in odda več najemnikom (kontejnerjem). Kubernetes deluje kot nepremičninski agent. Pojavi se vprašanje, kako zadržati najemnike, da ne pride do konfliktov med seboj? Kaj, če eden od njih, recimo, sklene zasedeti kopalnico za pol dneva?
Tukaj na sceno vstopijo requesti in limiti. CPU Request je namenjen izključno za načrtovanje. To je nekaj, kar lahko primerjamo z "seznamom želja" kontejnerja in uporablja se za iskanje najprimernejšega vozla. Hkrati se CPU Limit lahko primerjamo s pogodbo o najemu — takoj ko izberemo vozel za kontejner, ne bo mogel выходить за установленные пределы. И вот здесь возникает проблема…
Как реализованы request’ы и limit’ы в Kubernetes
Kubernetes использует встроенный в ядро механизм троттлинга (ограничения по времени) для реализации CPU limit’ов. Если приложение превышает лимит, активируется троттлинг (т.е. оно получает меньше временных квот CPU). Request’ы и limit’ы для памяти организованы иначе, и их легче обнаружить. Для этого достаточно проверить последний статус перезапуска pod’а: не был ли он «OOMKilled». С троттлингом CPU все не так просто, так как K8s предоставляет только метрики по использованию, а не по cgroups.
CPU Request
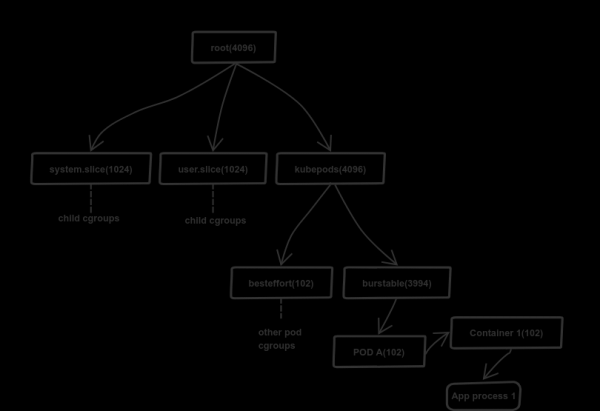
Как реализован CPU request
Для простоты давайте рассмотрим процесс на примере машины с 4-ядерным CPU.
K8s использует механизм контрольных групп (cgroups) для распределения ресурсов (памяти и процессора). Для него доступна иерархическая модель: потомок наследует лимиты родительской группы. Подробности распределения хранятся в виртуальной файловой системе (/sys/fs/cgroup). В случае процессора это /sys/fs/cgroup/cpu,cpuacct/*.
K8s использует файл cpu.share для распределения ресурсов процессора. В нашем случае корневая контрольная группа получает 4096 долей ресурсов CPU — 100% доступной мощности процессора (1 ядро = 1024; это фиксированное значение). Корневая группа распределяет ресурсы пропорционально в зависимости от долей потомков, прописанных в cpu.share, а те, в свою очередь, аналогично распоряжаются со своими потомками, и т.д. В типичном узле Kubernetes корневая контрольная группа имеет три потомка: system.slice, user.slice in kubepods. Две первых подгруппы используются для распределения ресурсов между критически важными системными нагрузками и пользовательскими программами вне K8s. Последняя — kubepods — создается Kubernetes’ом для распределения ресурсов между pod’ами.
На схеме выше видно, что первая и вторая подгруппы получили по 1024 доли, при этом подгруппе kubepod выделено 4096 долей. Как такое возможно: ведь корневой группе доступны всего 4096 долей, а сумма долей ее потомков значительно превышает это число (6144)? Дело в том, что значение имеет логический смысл, поэтому планировщик Linux (CFS) использует его для пропорционального распределения ресурсов CPU. В нашем случае первые две группы получают по 680 реальных долей (16,6% от 4096), а kubepod получает оставшиеся 2736 delite. V primeru nedelovanja prvi dve skupini ne bosta uporabljali dodeljenih virov.
Na srečo ima načrtovalnik mehanizem, ki preprečuje izgubo neizkoriščenih virov CPU. Prenese "neaktivne" zmogljivosti v globalni sklad, iz katerega so razporejene skupinam, ki potrebujejo dodatne zmogljivosti procesorja (prenosi se izvajajo po paketih, da se izognejo izgubam zaradi zaokroževanja). Podoben način se uporablja tudi za vse potomce.
Ta mehanizem zagotavlja pošteno porazdelitev zmogljivosti procesorja in skrbi, da noben proces ne "krade" virov od drugih.
Omejitev CPU
Čeprav se konfiguracije omejitev in zahtev v K8s zdijo podobne, je njihova izvedba popolnoma drugačna: to je najbolj zavajajoč in najmanj dokumentiran del.
K8s uporablja za izvajanje omejitev. Njihove nastavitve so določene v datotekah cfs_period_us in cfs_quota_us v direktoriju cgroup (tukaj se nahaja tudi datoteka cpu.share).
V nasprotju z cpu.share, kvota temelji na časovnem obdobju, ne pa na razpoložljivih zmogljivostih procesorja. cfs_period_us določa trajanje obdobja (epoh) — to je vedno 100000 μs (100 ms). V K8s je možno spremeniti to vrednost, vendar je trenutno na voljo le v alfa različici. Načrtovalnik uporablja epohe za ponovni zagon uporabljenih kvot. Druga datoteka, cfs_quota_us, določa razpoložljiv čas (kvoto) v vsaki epohi. Upoštevajte, da je ta prav tako izražena v mikroseundah. Kvota lahko presega trajanje epoh; z drugimi besedami, lahko je večja od 100 ms.
Oglejmo si dva scenarija na 16-jedrnih strojih (najpogostejša vrsta računalnikov pri nas v Omio):
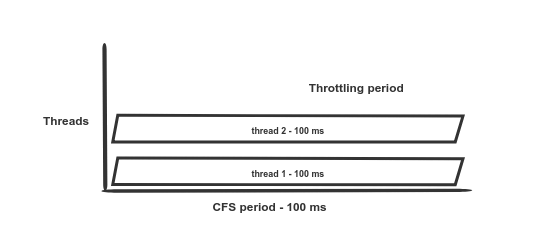
Scenarij 1: 2 niti in omejitev 200 ms. Brez omejevanja.
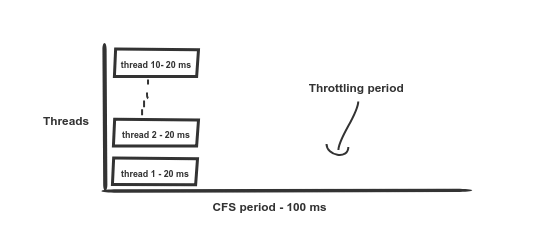
Scenarij 2: 10 niti in omejitev 200 ms. Omejevanje se začne po 20 ms, dostop do virov procesorja se obnovi še po 80 ms.
Recimo, da ste nastavili omejitev CPU na 2 jedra; Kubernetes to vrednost pretvori v 200 ms. To pomeni, da lahko kontejner uporabi največ 200 ms procesorskega časa brez omejevanja.
In tukaj se začne najbolj zanimivo. Kot je bilo že omenjeno, razpoložljiva kvota znaša 200 ms. Če delate vzporedno deset tokovi na 12-jedreni mašini (vidi ilustraciju za scenarij 2), dok su svi ostali podovi neaktivni, kvota će biti iscrpljena za samo 20 ms (jer 10 * 20 ms = 200 ms), i svi tokovi ovog poda će "zavrzlati" (throttle) u narednih 80 ms. Situacija se dodatno pogoršava već pomenutim , zbog kojeg dolazi do prekomernog throttlinga i kontejner ne može da iskoristi ni dostupnu kvotu.
Kako oceniti throttling u podovima?
Jednostavno se povežite sa podom i izvršite cat /sys/fs/cgroup/cpu/cpu.stat.
-
nr_periods— ukupni broj perioda planera; -
nr_throttled— broj throttled perioda u sklopunr_periods; -
throttled_time— ukupno throttled vreme u nanosekundama.
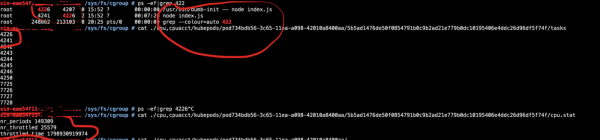
Šta se zapravo dešava?
Na kraju, dobijamo visok throttling u svim aplikacijama. Ponekad je u pola više od očekivanog!
To dovodi do raznih grešaka — greške u proverama spremnosti (readiness), zaglavljivanja kontejnera, prekida mrežnih veza, vremenskih ograničenja unutar servisnih poziva. Na kraju, to se manifestuje kao povećano kašnjenje i povećanje broja grešaka.
Rešenje i posledice
Sve je jednostavno. Odrekli smo se CPU limita i fokusirali smo se na ažuriranje jezgra OS-a u klasterima na najnoviju verziju, u kojoj je bag ispravljen. Broj grešaka (HTTP 5xx) u našim servisima odmah je značajno opao:
Greške HTTP 5xx
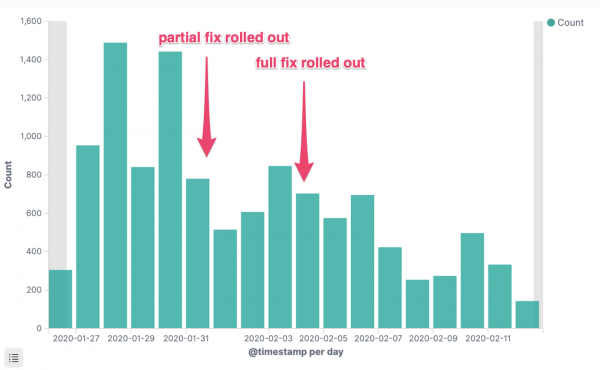
Greške HTTP 5xx jednog kritičnog servisa
Vreme odziva p95
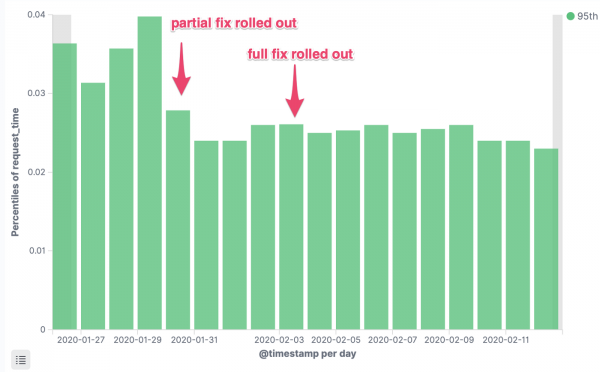
Kašnjenje zahteva kritičnog servisa, 95. percentil
Troškovi eksploatacije
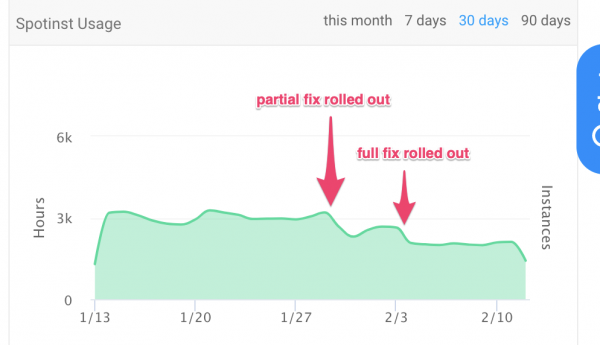
Broj potrošenih primeru-sati
U čemu je zamka?
Kao što je rečeno na početku članka:
Može se napraviti paralela sa stambenom zgradom… Kubernetes igra ulogu agenta za nekretnine. Ali kako zadržati stanare da ne upadaju u međusobne sukobe? Šta ako jedan od njih, recimo, odluči da zauzme kupatilo na pola dana?
To je zamka. Jedan nemaran kontejner može da upije sve dostupne resurse procesora na mašini. Ako imate dobar skup aplikacija (na primer, pravilno podešene JVM, Go, Node VM), to nije problem: može se raditi u takvim uslovima duže vreme. Ali ako su aplikacije slabo optimizovane ili potpuno neoptimizovane (FROM java:latest), situacija može izmaći kontroli. U Omio imamo automatizovane osnovne Dockerfile-ove sa odgovarajućim podrazumevanim podešavanjima za staklenu glavnih jezika, tako da ovaj problem nije postojao.
Preporučujemo da pratite metrike (korišćenje, saturacija i greške), kašnjenja API-ja i učestalost grešaka. Pazite da rezultati budu u skladu sa očekivanjima.
Povezave
To je naša priča. Sledeći materijali su u velikoj meri pomogli da se razjasni šta se dešava:
- ;
- ;
- ;
- ;
- — tražite „cpu throttling“.
Izveštaji o greškama Kubernetes-a:
- ;
- ;
- .
Da li ste se susretali sa sličnim problemima u vašoj praksi ili imate iskustva vezana za throttling u kontejnerizovanim produkcionim okruženjima? Podelite svoju priču u komentarima!
P.S. od prevajalca
Preberite tudi na našem blogu:
- «»;
- «»;
- «».
Izvor: habr.com
