

Poklici Data Scientist in Data Engineer se pogosto zamenjujeta. Vsaka podjetje ima svoje specifične načine dela s podatki, različne cilje njihove analize in različno predstavo o tem, kdo izmed strokovnjakov naj se ukvarja s katerim delom, zato so tudi zahteve različne.
Razjasnimo razliko med temi strokovnjaki, katere poslovne naloge rešujejo, kakšne spretnosti imajo in koliko zaslužijo. Material je obsežen, zato ga delimo na dve objavi.
V prvem članku Elena Gerasimova, vodja fakultete „“ v Netologiji, pojasnjuje razlike med Data Scientist in Data Engineer ter s katerimi orodji delujejo.
Kako se razlikujeta vlogi inženirjev in znanstvenikov podatkov
Inženir podatkov je strokovnjak, ki na eni strani razvija, testira in vzdržuje infrastrukturo za delo s podatki: podatkovne baze, skladišča in sisteme za obsežno obdelovanje. Po drugi strani pa je tisti, ki čisti in „ureja“ podatke za uporabo analitikov in data scientistov, kar pomeni, da ustvarja konveje obdelave podatkov.
Data Scientist ustvarja in usposablja prediktivne (in ne samo) modele z algoritmi strojnega učenja in nevronskimi mrežami, s čimer podjetju pomaga odkrivati skrite zakonitosti, napovedovati razvoj dogodkov in optimizirati ključne poslovne procese.
Glavna razlika med Data Scientist in Data Engineer je v tem, da običajno imata različne cilje. Oba delujeta za to, da so podatki dostopni in kakovostni. Vendar Data Scientist išče odgovore na svoja vprašanja in preverja hipoteze v podatkovnem ekosistemu (na primer na osnovi Hadoop), medtem ko Data Engineer ustvarja pipelines za vzdrževanje algoritma strojnega učenja, ki ga je napisal data scientist, v klasterju Spark znotraj istega ekosistema.
Inženir podatkov prinaša vrednost podjetju s sodelovanjem v ekipi. Njegova naloga je, da deluje kot pomembna povezava med različnimi udeleženci: od razvijalcev do poslovnih porabnikov poročil — in povečuje produktivnost analitikov — od marketinških in produktnih do BI.
Data Scientist pa nasprotno aktivno sodeluje pri strategiji podjetja in pridobivanju vpogledov, sprejemanju odločitev, uvajanju algoritmov avtomatizacije, modeliranju in generiranju vrednosti iz podatkov.
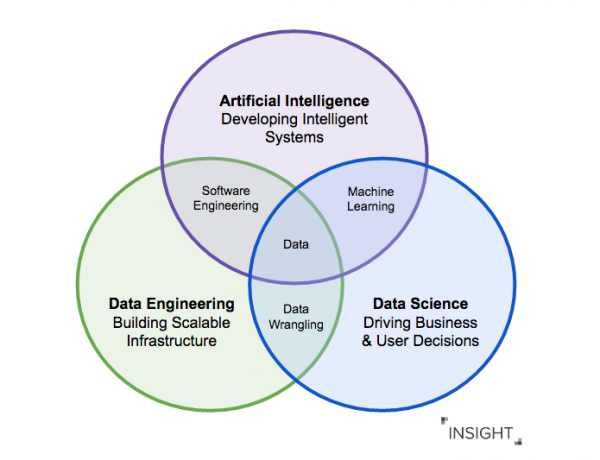
Delo z podatki sledi načelu GIGO (garbage in — garbage out): če analitiki in podatkovni znanstveniki delajo s pripravljenimi in potencialno nepravilnimi podatki, bodo rezultati, tudi z najnaprednejšimi analiznimi algoritmi, napačni.
Podatkovni inženirji rešujejo to težavo z oblikovanjem cevi za obdelavo, čiščenje in transformacijo podatkov, kar omogoča podatkovnim znanstvenikom, da delajo s kakovostnimi podatki.
Na trgu je veliko orodij za delo s podatki, ki pokrivajo vsak korak: od nastanka podatkov do prikaza na nadzorni plošči za upravni odbor. Pomembno je, da odločitev o njihovi uporabi sprejme inženir, ne zato, ker je to modno, temveč zato, ker bo resnično pomagal pri delu ostalim udeležencem v procesu.
Pogojno: če podjetju potrebuje povezati BI in ETL — nalaganje podatkov in posodobitve poročil, to je tipična dedna osnova, s katero se bo moral spoprijeti podatkovni inženir (dobro je, če bo v ekipi poleg njega tudi arhitekt).
Naloge podatkovnega inženirja
- Oblikovanje, gradnja in vzdrževanje infrastrukture za delo s podatki.
- Obdelava napak in ustvarjanje zanesljivih cevovodov za obdelavo podatkov.
- Pretvorba strukturiranih podatkov iz različnih dinamičnih virov v obliko, potrebno za delo analitikov.
- Zagotavljanje priporočil za povečanje doslednosti in kakovosti podatkov.
- Zagotavljanje in vzdrževanje arhitekture podatkov, ki jo uporabljajo podatkovni znanstveniki in analitiki podatkov.
- Obdelava in shranjevanje podatkov dosledno in učinkovito v porazdeljenem klastru na desetine ali stotine strežnikov.
- Ocenjevanje tehničnih kompromisov orodij za ustvarjanje preprostih, a zanesljivih arhitektur, ki bodo preživele okvare.
- Nadzor in podpora tokov podatkov in povezanih sistemov (nastavitev nadzora in opozoril).
Obstaja še ena specializacija znotraj poti podatkovnega inženirja — ML inženir. Na kratko, ti inženirji se specializirajo za pripeljevanje modelov strojnega učenja do industrijske implementacije in uporabe. Pogosto je model, ki ga zagotovi podatkovni znanstvenik, del raziskave in morda ne bo deloval v bojnih razmerah.
Naloge podatkovnega znanstvenika
- Izvlečenje značilnosti iz podatkov za uporabo algoritmov strojnega učenja.
- Uporaba različnih orodij strojnega učenja za napovedovanje in klasifikacijo vzorcev v podatkih.
- Povečanje učinkovitosti in natančnosti algoritmov strojnega učenja z natančnim nastavljanjem in optimizacijo algoritmov.
- Oblikovanje močnih hipotez v skladu s strategijo podjetja, ki jih je treba preveriti.
Tako Data Engineer kot Data Scientist prispevata k razvoju kulture dela s podatki, ki podjetju omogoča povečanje dobička ali znižanje stroškov.
S katerimi jeziki in orodji delajo inženirji in znanstveniki podatkov.
Danes so pričakovanja do strokovnjakov za obdelavo podatkov spremenjena. V preteklosti so inženirji sestavljali obsežne SQL poizvedbe, ročno pisali MapReduce in obdelovali podatke s pomočjo orodij, kot so Informatica ETL, Pentaho ETL, Talend.
V letu 2020 specialistu ne more več manjkati znanje Pythona in sodobnih orodij za računalniške izračune (na primer Airflow), pa tudi razumevanje načel dela z oblačnimi platformami (uporaba le-teh za varčevanje s strojno opremo ob upoštevanju varnostnih načel).
SAP, Oracle, MySQL, Redis so tradicionalna orodja inženirja podatkov v velikih podjetjih. So dobra, vendar so stroški licenc tako visoki, da se učenje dela z njimi splača le v industrijskih projektih. Kljub temu obstaja brezplačna alternativa v obliki Postgres — je brezplačen in primeren ne le za učenje.
Zgodovinsko se pogosto pojavlja povpraševanje po Javi in Scali, čeprav z razvojem tehnologij in pristopov ti jeziki postajajo manj pomembni.
Kljub temu pa je hardcore BigData: Hadoop, Spark in preostala zbirka orodij že dolgo neobvezna zahteva za inženirje podatkov, ampak vrsta orodij za reševanje problemov, ki jih ni mogoče rešiti s tradicionalnim ETL.
V trendu so storitve za uporabo orodij brez poznavanja jezika, v katerem so napisane (na primer, Hadoop brez znanja Jave) ter zagotavljanje pripravljenih storitev za obdelavo podatkovnih tokov (prepoznavanje govora ali podob na videu).
Priljubljene so industrijske rešitve SAS in SPSS, pri tem pa se Tableau, Rapidminer, Stata in Julia prav tako široko uporabljajo med znanstveniki podatkov za lokalne naloge.
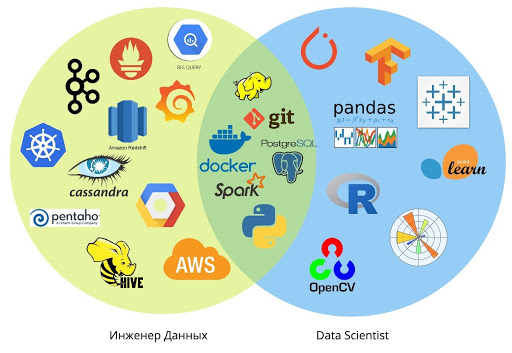
Mogućnost samostalnog izgradnje pipeline-a pojavila se kod analitičara i data scientist-a pre samo nekoliko godina: na primer, relativno jednostavnim skriptama može se usmeravati podaci u skladište zasnovano na PostgreSQL-u.
Obično je korišćenje konvejera i integrisanih struktura podataka u nadležnosti data inženjera. No danas je više nego ikada prisutan trend T-oblikovanih stručnjaka — sa širokim kompetencijama u sličnim oblastima, jer se alati neprestano pojednostavljuju.
Zašto Data Engineer i Data Scientist treba da rade zajedno
Radom u bliskoj saradnji sa inženjerima, Data Scientist može da se fokusira na istraživački deo, kreirajući algoritme mašinskog učenja spremne za rad.
Inženjeri se mogu usredsrediti na skalabilnost, ponovnu upotrebu podataka i garantovati da izlazni i ulazni kanali podataka u svakom pojedinačnom projektu odgovaraju globalnoj arhitekturi.
Ova podela obaveza osigurava doslednost između grupa stručnjaka koji rade na različitim projektima mašinskog učenja.
Saradnja pomaže efikasno stvaranje novih proizvoda. Brzina i kvaliteta se postižu zahvaljujući ravnoteži između stvaranja servisa za sve (globalno skladište ili integracija dashboard-a) i realizacije svake konkretne potrebe ili projekta (specijalizovani pipeline, povezivanje spoljašnjih izvora).
Bliska saradnja sa data scientist-ima i analitičarima pomaže inženjerima da razvijaju analitičke i istraživačke veštine za pisanje kvalitetnijeg koda. Poboljšava se razmena znanja među korisnicima skladišta i jezera podataka, što čini projekte fleksibilnijim i osigurava dugoročne održive rezultate.
U kompanijama koje imaju za cilj razvoj kulture rada sa podacima i uspostavljanje poslovnih procesa na osnovu njih, Data Scientist i Data Engineer dopunjuju jedni druge i stvaraju potpun sistem analize podataka.
U narednom materijalu govorećemo o tome kakvo obrazovanje treba da imaju Data Engineer i Data Scientist, koje veštine treba da razvijaju i kako je organizovano tržište.
Od uredništva Netologije
Če se spogledujete s poklicem Data Engineer ali Data Scientist, vas vabimo, da raziščete naše učne programe:
- Poklic „».
- Poklic „».
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish