

DataHub с открытым исходным кодом: платформа поиска и обнаружения метаданных от LinkedIn
Hiteršnja iskanje potrebnih podatkov je nujno za vsako podjetje, ki se zanaša na obsežne količine podatkov za odločanje. To ne vpliva le na produktivnost uporabnikov podatkov (vključno z analitikumi, razvijalci strojnega učenja, strokovnjaki za obdelavo podatkov in podatkovnimi inženirji), ampak tudi neposredno vpliva na končne izdelke, ki so odvisni od kakovostne verige strojnega učenja (ML). Poleg tega trend uvajanja ali ustvarjanja platform strojnega učenja naravno postavlja vprašanje: kakšna je vaša metoda za interno odkrivanje funkcij, modelov, metrik, podatkovnih nizov itd.
V tem članku bomo razložili, kako smo objavili vir podatkov pod odprto licenco na naši platformi za iskanje in odkrivanje metapodatkov, od prvih dni projekta . LinkedIn podpira svojo različico DataHuba ločeno od različice z odprto kodo. Začeli bomo z razlago, zakaj potrebujemo dve ločeni razvojni okolji, nato pa bomo razpravljali o prvih pristopih k uporabi WhereHows z odprto kodo in primerjali našo interno (proizvodno) različico DataHuba z različico na . Prav tako bomo delili podrobnosti o našem novem avtomatiziranem rešenju za pošiljanje in prejemanje posodobitev z odprto kodo, da bi sinhronizirali oba repozitorija. Na koncu bomo podali navodila, kako začeti uporabljati DataHub z odprto kodo, in kratko razpravljali o njegovi arhitekturi.
WhereHows je zdaj DataHub!
Ekipa metapodatkov LinkedIn je prej predstavila (naslednik WhereHows), platformo za iskanje in odkrivanje metapodatkov LinkedIn in delila načrte za njeno odpiranje. Kmalu po tem obvestilu smo izdali alfa različico DataHuba in jo delili s skupnostjo. Od takrat nenehno prispevamo k repozitoriju in sodelujemo z zainteresiranimi uporabniki pri dodajanju najbolj zaželenih funkcij in reševanju težav. Zdaj smo veseli, da lahko uradno napovemo .
Pristopi z odprto kodo
WhereHows, prvotni portal LinkedIn za iskanje podatkov in njihovega izvora, je bil odprt kot notranji projekt; ekipa metapodatkov ga je odprla . Od takrat naprej je ekipa vedno vzdrževala dve ločeni bazi kode - eno za odprto kodo in drugo za notranjo uporabo LinkedIna, saj niso bile vse funkcije izdelka, razvite za primere uporabe LinkedIna, splošno uporabne za širšo javnost. Poleg tega ima WhereHows nekatere notranje odvisnosti (infrastruktura, knjižnice itd.), katere izvorna koda ni odprta. V naslednjih letih je WhereHows prestal skozi številne iteracije in razvojne cikle, kar je sinhronizacijo obeh baz kode postavilo v velik izziv. Ekipa za metapodatke je skozi leta poskušala uporabiti različne pristope, da bi poskušala sinhronizirati notranji razvoj in razvoj z odprto kodo.
Prvi poskus: „Najprej odprta koda“
Sprva smo sledili modelu razvoja „najprej odprta koda“, kjer poteka osnovni razvoj v repozitoriju z odprto kodo, spremembe pa se vnesejo za notranje uvajanje. Težava s tem pristopom je, da je koda vedno najprej poslana na GitHub, preden je popolnoma preverjena znotraj. Dokler ne bodo izvedene spremembe iz repozitorija z odprto kodo in ne bo izvedeno novo interno uvajanje, ne bomo odkrili nobenih proizvodnih težav. V primeru slabe implementacije je bilo prav tako zelo težko določiti povzročitelja, ker so bile spremembe vnašane po skupinah.
Poleg tega je ta model zmanjšal produktivnost ekipe pri razvoju novih funkcij, ki so zahtevale hitre iteracije, saj je vsako spremembo najprej treba postaviti v repozitorij z odprto kodo, nato pa jo prenesti v notranji repozitorij. Da bi skrajšali obdelovalni čas, bi bilo potrebno popravilo ali spremembo najprej opraviti v notranjem repozitoriju, vendar je to postalo ogromen problem, ko je prišlo do združevanja teh sprememb nazaj v repozitorij z odprto kodo, ker sta se obe repozitoriji iztrgala iz sinhronizacije.
To je model, ki ga je veliko lažje uvesti za skupne platforme, knjižnice ali infrastrukturne projekte, kot pa za popolnoma funkcionalne uporabniške spletne aplikacije. Poleg tega je ta model popolnoma primeren za projekte, ki se že od začetka opirajo na odprto kodo, vendar je bilo WhereHows zasnovano kot popolnoma notranja spletna aplikacija. Res je bilo zapleteno popolnoma se razbiti od vseh notranjih odvisnosti, zato smo morali ohraniti notranji razvod, vendar ohranitev notranjega razveda in razvoj predvsem na odprti kodi nista povsem delovala.
Druga poskus: „Najprej notranji“
**Kot drugi poskus smo prešli na model razvoja „Najprej notranji“, kjer se glavni razvoj odvija znotraj podjetja, spremembe pa se redno vnašajo v odprto kodo. Čeprav je ta model najbolj primeren za naš primer uporabe, ima svoje izzive. Neposredno pošiljanje vseh razlik v repozitorij z odprto kodo, nato pa poskušanje reševanja konfliktov združitev pozneje je ena možnost, vendar vzame veliko časa. Večina razvijalcev se pri vsakem pregledu kode trudi, da tega ne počne. Tako se bo to izvajalo veliko redkeje, v serijah, kar pa oteži nadaljnje reševanje konfliktov združitev.
Tretjič je vse uspelo!
Dva zgoraj omenjena neuspešna poskusa sta privedla do tega, da je repozitorij WhereHows GitHub dolgo ostajal zastarel. Ekipa je nadaljevala z izboljševanjem funkcionalnosti in arhitekture izdelka, zato je notranja različica WhereHows za LinkedIn postajala vse bolj dovršena od različice z odprto kodo. Imela je celo novo ime — DataHub. Na podlagi prejšnjih neuspešnih poskusov se je ekipa odločila razviti skalabilno dolgoročno rešitev.
Za vsak nov projekt z odprto kodo ekipa razvijalcev odprte kode LinkedIn svetuje in podpira model razvoja, v katerem so moduli projekta popolnoma razviti z odprto kodo. Artefakti z podporo verzijam se razporedijo v javni repozitorij, nato se vrnejo v notranji artefakt LinkedIn s pomočjo Sledenje tej razvojni shemi ni samo koristno za tiste, ki uporabljajo odprtokodna orodja, temveč tudi vodi k oblikovanju bolj modularne, razširljive in povezljive arhitekture.
Vendar pa bo za dosego tega stanja zrelega notranjega aplikacije, kot je DataHub, potrebnega bistveno veliko časa. To tudi izključuje možnost odprtokodne popolne implementacije, preden so vse notranje odvisnosti popolnoma abstraktne. Zato smo razvili orodja, ki nam pomagajo prispevati z odprto kodo hitreje in veliko manj boleče. Ta rešitev je koristna tako za ekipo metapodatkov (razvijalca DataHub) kot tudi za skupnost odprte kode. V naslednjih razdelkih bo obravnavan ta nov pristop.
Avtomatizacija objave z odprto kodo
Zadnji pristop skupine metapodatkov k DataHub z odprto kodo je razvoj orodja, ki samodejno sinhronizira notranjo kodo in repozitorij z odprto kodo. Visok nivo funkcij tega orodja vključuje:
- Sinhronizacija kode LinkedIn z / iz odprte kode, podobno .
- Generiranje naslova licence, podobno .
- Samodejna ustvarjanje dnevnikov prenosa odprte kode iz notranjih dnevnikov prenosa.
- Preprečevanje notranjih sprememb, ki kršijo zgradbo z odprto kodo, s .
V naslednjih podpoglavjih bodo podrobno obravnavane zgoraj omenjene funkcije, ki predstavljajo zanimive izzive.
Sinhronizacija izvorne kode
V nasprotju z različico DataHub z odprto kodo, ki je enoten repozitorij GitHub, različica DataHub za LinkedIn predstavlja kombinacijo več repozitorijev (znotraj družbe imenovanih ). Vmesnik DataHub, knjižnica modelov metapodatkov, strežniška storitev za shranjevanje metapodatkov in pretakajoče naloge so v različnih repozitorijih v LinkedIn. Vendar pa imamo za olajšanje dela uporabnikov z odprto kodo enoten repozitorij za različico DataHub z odprto kodo.
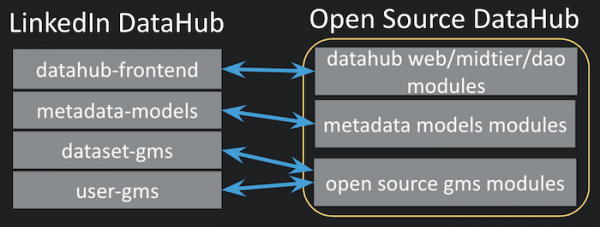
Slika 1: Sinhronizacija med repozitoriji LinkedIn DataHub in enotnim repozitorijem DataHub z odprto kodo
Za podporo avtomatiziranih delovnih tokov sestavljanja, pošiljanja in pridobivanja naš nov pripomoček samodejno ustvarja ujemanje na ravni datoteke, ki ustreza vsakemu izvorni datoteki. Vendar pa za orodje potrebna začetna konfiguracija in uporabniki morajo zagotoviti visoko raven prikaza modulov, kot je prikazano spodaj.
{
  "datahub-dao": [
    "${datahub-frontend}/datahub-dao"
  ],
  "gms/impl": [
    "${dataset-gms}/impl",
    "${user-gms}/impl"
  ],
  "metadata-dao": [
    "${metadata-models}/metadata-dao"
  ],
  "metadata-builders": [
    "${metadata-models}/metadata-builders"
  ]
}
Ujemanje na ravni modula je preprost JSON, kjer so ključi ciljni moduli v repozitoriju z odprto kodo, vrednosti pa seznam izvornih modulov v repozitjih LinkedIn. Kadar koli lahko vsak cilj modula v repozitoriju z odprto kodo črpa iz več izvornih modulov. Za označevanje notranjih imen repozitorijev v izvornih modulih se uporablja v slogu Bash. Z uporabo ujemanja na ravni modula orodja ustvarjajo ujemanje na ravni datotek, tako da preiščejo vse datoteke v povezanih imenikih.
{
  "${metadata-models}/metadata-builders/src/main/java/com/linkedin/Foo.java":
"metadata-builders/src/main/java/com/linkedin/Foo.java",
  "${metadata-models}/metadata-builders/src/main/java/com/linkedin/Bar.java":
"metadata-builders/src/main/java/com/linkedin/Bar.java",
  "${metadata-models}/metadata-builders/build.gradle": null,
}
Ujemanje na ravni datotek se avtomatsko ustvari z orodji; lahko pa ga tudi uporabnik ročno posodobi. To je 1:1 ujemanje izvorne datoteke LinkedIn s datoteko v repozitoriju z odprto kodo. Obstaja več pravil, povezanih s tem samodejnim ustvarjanjem ujemanja datotek:
- V primeru več izvornih modulov za cilj modula v odprtem računalniškem sistemu lahko nastanejo konflikti, na primer, isti , ki obstaja v več kot enem izvoru modula. Kot strategijo za reševanje konfliktov naše orodje privzeto uporablja možnost »zadnji zmagovalec«.
- "null" pomeni, da izvorna datoteka ni del repozitorija z odprto kodo.
- Po vsakem pošiljanju ali izvleku iz odprtega vira se to ujemanje samodejno posodobi in ustvari posnetek. To je potrebno za ugotavljanje dodajanj in brisanj izvorne kode po zadnjem dejanju.
Ustvarjanje zapisov o commitih
Zapiski o commitih za commite z odprtim virom se prav tako samodejno ustvarjajo s povečanjem zapisov o commitih notranjih repozitorijev. Spodaj je primer zapisa o commitih, ki prikazuje strukturo zapisa, ustvarjenega z našim orodjem. Commit jasno navaja, katere različice izvornih repozitorijev so pakirane v ta commit in nudi povzetek zapisa o commitih. Preverite ta na realnem primeru zapisa o commitih, ustvarjenega z našim orodjem.
metadata-models 29.0.0 -> 30.0.0
    Dodan aspekt model foo
    Popravljena težava bar

dataset-gms 2.3.0 -> 2.3.4
    Dodan rest.li API za servis foo aspekta

MP_VERSION=dataset-gms:2.3.4
MP_VERSION=metadata-models:30.0.0
Testiranje odvisnosti
LinkedIn ima , ki pomaga zagotoviti, da spremembe notranjega večproduktnega sistema ne motijo sestave odvisnih večproduktov. Repozitorij DataHub z odprtim virom ni večproduktni in ne more biti neposredna odvisnost od katerega koli večprodukta, a s pomočjo večproduktne lupine, ki izvleče izvorno kodo DataHub z odprtim virom, še vedno lahko uporabimo to sistem testiranja odvisnosti. Tako vsaka sprememba (ki bo morda kasneje odprta) v kateremkoli od večproduktov, ki napajajo repozitorij DataHub z odprtim virom, sproži dogodek sestave v večproduktni lupini. Zato vsaka sprememba, ki ne omogoča grajenja večproduktne lupine, ne opravi preizkusov pred commitom izvornega večprodukta in se vrne.
To je koristen mehanizem, ki pomaga preprečiti vsak notranji commit, ki prekine sestavo z odprtim virom, in ga odkrije med ustvarjanjem commita. Brez tega bi bilo precej težko ugotoviti, kateri notranji commit je povzročil neuspeh sestave repozitorija z odprtim virom, ker v repozitorij DataHub z odprtim virom umeščamo paketne notranje spremembe.
Razlike između DataHub-a s otvorenim izvorom i naše produkcijske verzije
Do sada smo raspravljali o našem rešenju za sinhronizaciju dve verzije repozitorijuma DataHub, ali još nismo jasno definisali razloge zbog kojih nam zapravo trebaju dva različita toka razvoja. U ovom odeljku ćemo navesti razlike između javne verzije DataHub-a i produkcijske verzije na LinkedIn serverima, kao i objasniti razloge za te razlike.
Jedan od izvora razlika proizilazi iz činjenice da naša produkcijska verzija zavisi od koda koji još nije otvorenog izvora, kao što je LinkedIn-ov Offspring (unutrašnja struktura implementacije zavisnosti LinkedIn-a). Offspring se široko koristi u unutrašnjoj kodnoj bazi, jer je to preferirani metod upravljanja dinamičkom konfiguracijom. Međutim, to nije otvorenog izvora; stoga smo morali pronaći alternative s otvorenim izvorom za DataHub s otvorenim izvorom.
Postoje i drugi razlozi. Kako razvijamo proširenja modela metapodataka za potrebe LinkedIn-a, ta proširenja obično su veoma specifična za LinkedIn i možda se ne mogu direktno primeniti na druge okruženja. Na primer, imamo veoma specifične oznake za identifikatore učesnika i druge tipove metapodataka. Stoga smo trenutno isključili ta proširenja iz modela metapodataka DataHub-a s otvorenim izvorom. Kako se budemo povezivali s zajednicom i razumevali njihove potrebe, radit ćemo na zajedničkim verzijama tih proširenja s otvorenim izvorom kad god to bude potrebno.
Jednostavnost korišćenja i lakša prilagodba za zajednicu otvorenog koda takođe su inspiisali neke razlike između dve verzije DataHub-a. Razlike u infrastrukturi obrade podataka su dobar primer toga. Iako naša unutrašnja verzija koristi infrastrukturu upravljane obrade podataka, odlučili smo se za korišćenje ugrađene (standalone) obrade podataka za verziju s otvorenim izvorom, jer to omogućava izbegavanje stvaranja još jedne zavisnosti infrastrukture.
Drugi primer razlike je prisotnost enega GMS (Generična skladišče metapodatkov) v odprtokodni implementaciji, namesto več GMS. GMA (Generična arhitektura metapodatkov) je naziv notranje arhitekture za DataHub, medtem ko je GMS skladišče metapodatkov v kontekstu GMA. GMA je zelo fleksibilna arhitektura, ki vam omogoča razporejanje vsake podatkovne strukture (na primer, nabori podatkov, uporabniki itd.) v lastno skladišče metapodatkov ali pa shranjevanje več podatkovnih struktur v enem skladišču metapodatkov, dokler se register, ki vsebuje zemljevid podatkovne strukture v GMS, posodablja. Za enostavno uporabo smo izbrali en zgled GMS, ki shranjuje vse različne podatkovne strukture v odprtokodnem DataHub-u.
Poln seznam razlik med dvema implementacijama je prikazan v spodnji tabeli.
Značilnosti izdelka
LinkedIn DataHub
Odprtokodni DataHub
Podprte podatkovne strukture
1) Nabori podatkov 2) Uporabniki 3) Metri 4) ML Značilnosti 5) Grafi 6) Nadzorne plošče
1) Nabori podatkov 2) Uporabniki
Podprti viri metapodatkov za nabor podatkov
1) 2) Couchbase 3) 4) 5) HDFS 6) Hive 7) Kafka 8) MongoDB 9) MySQL 10) Oracle 11) 12) Presto 12) 13) Teradata 13) Vector 14)
Hive Kafka RDBMS
Pub-sub
Confluent Kafka
Obdelava toka
Urejeno
Vgrajeno (samostojno)
Injekcija odvisnosti & dinamična konfiguracija
LinkedIn Offspring
Orodja za gradnjo
Ligradle (LinkedInov interni Gradle ovitek)
CI/CD
CRT (LinkedInov interni CI/CD)
in
Skladišča metapodatkov
Porazdeljenih več GMS: 1) Dataset GMS 2) User GMS 3) Metric GMS 4) Feature GMS 5) Chart/Dashboard GMS
En GMS za: 1) Nabori podatkov 2) Uporabniki
Mikrostoritve v kontejnerjih Docker
poenostavlja uvajanje in distribucijo aplikacij s pomočjo . Vsak del storitve v odprtokodnem DataHub-u, vključno s komponentami infrastrukture, kot sta Kafka, , in , ima svojo sliko Docker. Za orkestracijo kontejnerjev Docker smo uporabili .
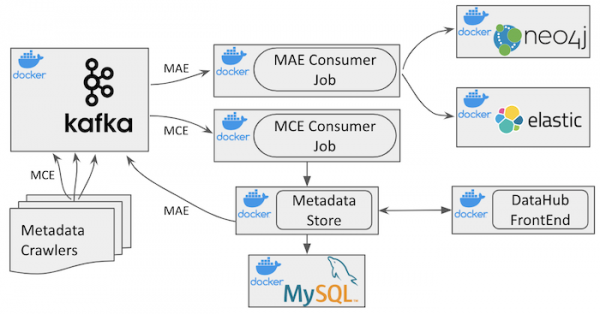
Slika 2: Arhitektura DataHub *odprt kod**
Lahko vidite visoko ravno arhitekturo DataHub na sliki zgoraj. Poleg infrastrukturnih komponent ima štiri različne slike Docker:
datahub-gms: storitev skladišča metapodatkov
datahub-frontend: aplikacija , ki služi vmesniku DataHub.
datahub-mce-consumer: aplikacija , ki uporablja tok dogodkov spremembe metapodatkov (MCE) in posodablja skladišče metapodatkov.
datahub-mae-consumer: aplikacija , ki uporablja tok dogodkov revizije metapodatkov (MAE) in ustvarja indeksno bazo podatkov in graf.
Dokumentacija za repozitorij z odprto kodo in vsebujejo podrobnejše informacije o funkcionalnostih različnih storitev.
CI / CD v DataHub z odprto kodo
Repizitorij DataHub z odprto kodo uporablja za neprekinjeno integracijo in za neprekinjeno uvajanje. Obe imata dobro integracijo z GitHubom in sta enostavni za nastavitev. Večina infrastrukture z odprto kodo, ki jo je razvila skupnost ali zasebna podjetja (na primer, ), je zasnovana tako, da ustvarja Docker slike, ki se uvajajo v Docker Hub, da bi olajšali uporabo skupnosti. Vsako Docker sliko, najdeno v Docker Hub, lahko enostavno uporabimo s preprosto ukazom .
Ob vsakem commit-u v repozitorij z odprto kodo DataHub se vse Docker slike samodejno ustvarijo in uvajajo v Docker Hub z oznako „latest“. Če je v Docker Hub nastavljena neka , vse oznake v repozitoriju z odprto kodo prav tako izidejo s ustreznimi imeni oznak v Docker Hub.
Uporaba DataHub
je zelo enostavna in vključuje tri preproste korake:
- Kloni repozitorij z odprto kodo in zaženi vse Docker kontejnerje s pomočjo docker-compose z uporabo tega predloženega skripta za hitro zagon.
- Naloži vzorce podatkov, predstavljene v repozitoriju, s pomočjo orodja ukazne vrstice, ki je prav tako na voljo.
- Ogled DataHub v brskalniku.
Aktivno spremljamo je prav tako nastavljen za hitra vprašanja. Uporabniki lahko tudi odpirajo težave neposredno v repozitoriju GitHub. Najpomembneje pa je, da pozdravljamo in cenimo vse povratne informacije in predloge!
Načrti za prihodnost
Trenutno je vsaka infrastruktura ali mikroservis za DataHub z odprto kodo zgrajena kot Docker kontejner, celoten sistem pa se orkestrira z . Glede na priljubljenost in široko uporabo , bi želeli v kratkem ponuditi rešitev, ki temelji na Kubernetes.
Prav tako načrtujemo ponuditi pripravljeno rešitev za uvajanje DataHub v javni oblačni storitvi, kot je , ili . Glede na nedavne napovedi o migraciji LinkedIn na Azure, bo to ustrezalo notranjim prednostim skupine za metadata.
In še zadnje, a nič manj pomembno: hvala vsem prvotnim uporabnikom DataHub v skupnosti z odprtokodnim izvorom, ki so cenili alfa različice DataHub in nam pomagali odkriti težave ter izboljšati dokumentacijo.
Izvor: habr.com
