

Pri kompleksni obdelavi velikih naborov podatkov (različne : uvozi, konverzije in sinhronizacije z zunanjim virom) pogosto nastane potreba za začasno "zapomnitev" in hitro obdelavo nekaj obsežnega.
Tipična naloga tovrstne narave se običajno sliši takole: "Tukaj zadnja prejeta plačila, treba jih je hitro prenesti na splet in povezati z računi"
Toda ko obseg tega "nečesa" začne meriti več sto megabajtov, medtem ko mora storitev še naprej delovati s podatkovno bazo v režimu 24×7, se pojavi veliko stranskih učinkov, ki vam bodo oteževali življenje.
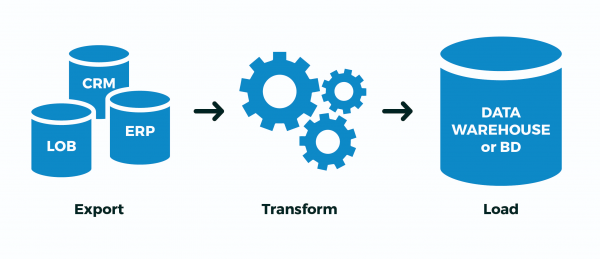
Da bi se z njimi spoprijeli v PostgreSQL (pa tudi ne samo v njem), lahko uporabite nekatere možnosti za optimizacijo, ki bodo omogočile hitrejšo obdelavo z manjšim porabo virov.
1. Kam nalivati?
Najprej ugotovimo, kam lahko naložimo podatke, ki jih želimo "obdelati".
1.1. Začasne tabele (TEMPORARY TABLE)
Na splošno so za PostgreSQL začasne tabele enake kot katere koli druge. Zato so napačna prepričanja, kot so "vse je shranjeno samo v pomnilniku, ki se lahko konča". Vendar pa obstajajo tudi nekatere bistvene razlike.
Lastni "imenski prostor" za vsako povezavo na BDP
Če poskušata dve povezavi hkrati izvesti CREATE TABLE x, bo nekdo nujno naletel na napako o uničenosti BDP objektov.
Če pa bosta oba poskušala izvesti CREATE ZAČASNO TABELA x, bosta oba to normalno naredila, in vsak bo dobil svoj primer tabele. In med njima ne bo nič skupnega.
"Samouničenje" ob odjavi
Ob zapiranju povezave se vse začasne tabele samodejno izbrišejo, zato "ročnega" izvajanja DROP TABLE x ni nobenega smisla, razen ...
Če delate preko pgbouncer v načinu transakcij, baza še vedno misli, da je ta povezava še aktivna, in v njej ta začasna tabela še vedno obstaja.
Zato bo poskus ponovnega ustvarjanja iz druge povezave do pgbouncer pripeljal do napake. Toda to lahko obidete, tako da uporabite USTVARI ZAČASNO TABELO ČE NE OBSTAJA x.
Toda bolje je, da tega ne delate, ker lahko "nenadoma" naletite na podatke, ki so ostali od "prejšnjega lastnika". Namesto tega je veliko bolje prebrati navodila in videti, da ob ustvarjanju tabele obstaja možnost, da dodate NA ZAVEZI DROP — to pomeni, da bo tabela samodejno izbrisana ob koncu transakcije.
Nerepliciranje
Zaradi pripadnosti samo določenemu povezovanju se začasne tabele ne replicirajo. Vendar to odstrani potrebo po dvojni zapisovanju podatkov v heap + WAL, zato je INSERT/UPDATE/DELETE v njih bistveno hitrejši.
Toda ker je začasna tabela vseeno 'skoraj običajna', je tudi na replikaciji ni mogoče ustvariti. Vsaj zaenkrat ne, čeprav ustrezen popravek že dolgo časa kroži.
1.2. Nezapisljive tabele (UNLOGGED TABLE)
Toda kaj storiti, na primer, če imate nek obsežen ETL-proces, ki ga ne morete izvesti v okviru ene transakcije, in imate pgbouncer v načinu transakcij?..
Ali je tok podatkov tako velik, da ni dovolj pasovne širine enega povezovanja z DB (beri, enega procesa na CPU)?..
Ali del operacij poteka asinhrono v različnih povezavah?..
Tu je le ena rešitev — začasno ustvariti ne-zaključeno tabelo. Igra besed, da. To pomeni:
- ustvaril sem 'svoje' tabele z maksimalno naključnimi imeni, da ne bi naletel na koga drugega
- Extract: nalil sem podatke iz zunanjega vira vanje
- Transform: jih pretvoril, izpolnil ključna povezovalna polja
- Učitavanje: prelil pripravljene podatke v ciljna tabela
- sem izbrisal 'svoje' tabele
In zdaj — žlica katrana. V bistvu, vse zajemanje v PostgreSQL poteka dvakrat — , nato pa že v telesa tabel/indeksov. Vse to je narejeno za podporo ACID in pravilni vidljivosti podatkov med COMMIT'notami in ROLLBACK'notami transakcijami.
Toda tega mi ne potrebujemo! Naš celoten proces ali uspešno uspe, ali pa ne. Ni pomembno, koliko bo v njem vmesnih transakcij — ni nam zanimivo 'nadaljevati postopek sredi', še posebej, ko ni jasno, kje je bila.
Zato so razvijalci PostgreSQL v različici 9.1 uvedli takšno stvar kot :
S tem navedkom se tabela ustvari kot nezapisljiva. Podatki, zapisani v nezapisljive tabele, ne prehajajo skozi predizpisni dnevnik (glej Glavo 29), zaradi česar te tabele delujejo precej hitreje od običajnih.Vendar pa niso zaščitene pred napako; pri izpadu ali nenadnem izklopu strežnika se nezapisljiva tabela samodejno izreže.Poleg tega se vsebina nezapisljive tabele ne replicira. na vodene strežnike. Vse indekse, ustvarjene za nebeležene tabele, se samodejno pretvorijo v nebeležene.
Na kratko, bo bistveno hitrejše, a če server baze podatkov 'pade' – bo neprijetno. Ampak, koliko pogosto se to zgodi, in ali vaš ETL postopek to lahko pravilno obdeluje 's sredine' po 'oživitvi' baze podatkov?..
Če ni, in je zgornji primer podoben vašemu – uporabite UNLOGGED, a nikoli ne vključite tega atributa na pravih tabelah, katerih podatki so vam dragi.
1.3. ON COMMIT { DELETE ROWS | DROP }
Ta konstrukcija omogoča, da ob ustvarjanju tabele določite samodejno vedenje ob zaključku transakcije.
O NA ZAVEZI DROP že sem napisal zgoraj, generira DROP TABLE, a tukaj je NA ZAVEZI IZBRIŠI VRSTE situacija zanimivejša – tukaj se generira TRUNCATE TABLE.
Ker je celotna infrastruktura shranjevanja metaopisov začasne tabele enaka kot pri običajni, nenehno ustvarjanje-in-brisanje začasnih tabel povzroča močno 'napihovanje' sistemskih tabel pg_class, pg_attribute, pg_attrdef, pg_depend,…
Zdaj si predstavljajte, da imate delavca na neposredni povezavi z bazo podatkov, ki vsako sekundo odpre novo transakcijo, ustvarja, napolnjuje, obdeluje in briše začasno tabelo… Odpadkov v sistemskih tabelah se bo nakopičilo preveč, kar povzroča dodatne zaostanke pri vsaki operaciji.
Na splošno, tega ne delajte! V tem primeru je mnogo učinkoviteje USTVARI ZAČASNO TABLE x ... ON COMMIT DELETE ROWS premakniti izven transakcijskega cikla – tako bodo ob začetku vsake nove transakcije tabele že obstajale (prihranimo klic CREATE), ampak bo prazna, zahvaljujoč TRUNCATE (tudi ta klic smo prihranili) ob zaključku prejšnje transakcije.
1.4. LIKE… INCLUDING …
Omenil sem na začetku, da je eden od tipičnih primerov uporabe za začasne tabele – različne vrste uvozov – in razvijalec utrujeno kopira seznam polj ciljne tabele v deklaracijo svoje začasne…
Ampak lenoba je motor napredka! Zato lahko ustvarite novo tabelo 'po vzoru' veliko preprosteje:
USTVARI ZAČASNO TABELO import_table(
  LIKE target_table
);
Ker lahko v to tabelo nato vnesete precej veliko podatkov, iskanje v njej ne bo hitro. Vendar pa obstaja tradicionalna rešitev – indeksi! In, da, imajo tudi začasne tabele indekse.
Ker se pogosto potrebni indeksi ujemajo z indeksi ciljne tabele, jih lahko preprosto zapišete PODOBEN target_table VKLJUČNO Z INDEKSI.
Če potrebujete še DEFAULT-vrednosti (na primer, za izpolnitev vrednosti primarnega ključa), lahko uporabite PODOBEN target_table VKLJUČUJOČ BAZNE NASTAVITVE. Ali pa preprosto — PODOBEN target_table VKLJUČUJOČ VSE — kopira privzete vrednosti, indekse, omejitve,…
Ampak tukaj je treba razumeti, da če ste ustvarili uvozno tabelo takoj z indeksi, se bodo podatki nalagali dlje, kot če najprej vse naložite, nato pa dodate indekse — poglejte na primer, kako to počne .
Na splošno, !
2. Kako pisati?
Povem preprosto — uporabite -tok namesto „paketa“ INSERT, . Lahko celo neposredno iz vnaprej oblikovane datoteke.
3. Kako obdelovati?
Torej, naj bo naš vhod približno takšen:
- imate v bazi shranjeno tabelo s podatki strank na 1M zapisov
- vsak dan vam stranka pošlje nov popoln „model“
- po izkušnjah veste, da se od enega do drugega spremeni največ 10K zapisov
Klasičen primer takšne situacije je — vseh naslovov je veliko, a v vsakem tedenskem izvozu sprememb (preimenovanja naselij, združevanje ulic, pojav novih hiš) je zelo malo celo v obsegu celotne države.
3.1. Algoritem popolne sinhronizacije
Za preprostost domnevamo, da vam ni treba niti prestrukturirati podatkov — samo prilagoditi tabelo v želeno obliko, torej:
- izbrisati vse, česar že ni
- posodobiti vse, kar je že bilo, in je treba posodobiti
- vstaviti vse, česar še ni bilo
Zakaj je treba operacije izvesti v tem vrstnem redu? Ker samo tako bo velikost tabele rasla minimalno ().
DELETE FROM dst
Ne, seveda lahko zadošča že samo dve operaciji:
- izbrisati (
DELETE) pravzaprav vse - vstaviti vse iz novega modela
Ampak s tem, zahvaljujoč MVCC, velikost tabele se bo povečala točno dvakrat! Pridobiti +1M modelov zapisov v tabeli zaradi posodobitve 10K — to je slaba odvečnost…
TRUNCATE dst
Bolj izkušen razvijalec ve, da lahko celotno tabelo čistimo razmeroma poceni:
- obriši (
TRUNCATE) celotno tabelo - vstaviti vse iz novega modela
Metoda je učinkovita, , ampak obstaja težava… Nalivanje 1M zapisov bo trajalo dolgo, zato si ne moremo privoščiti, da bi tabela ostala prazna ves ta čas (kot se bo zgodilo brez obvijanja v eno samo transakcijo).
To pomeni:
- začnemo dolgo transakcijo
TRUNCATEvsiljuje AccessExclusive-zaklep- dalj časa izvajamo vstavek, vsi ostali pa v tem času ne morejo niti
SELECT
Nekaj ni v redu…
ALTER TABLE… RENAME… / DROP TABLE …
Alternativa — carregar tudo em uma nova tabela separada e depois apenas renomear para o lugar da antiga. Algumas pequenas complicações:
- também isso AccessExclusive, embora significativamente menos demorado
- todos os planos de consultas/estatísticas dessa tabela são redefinidos,
- todas as chaves estrangeiras quebram (FK) para a tabela
Houve um patch WIP de Simon Riggs, que sugeria fazer ALTER-uma operação para substituir o corpo da tabela no nível de arquivo, sem alterar as estatísticas e FK, mas não conseguiu reunir quórum.
DELETE, UPDATE, INSERT
Assim, ficamos com a opção não bloqueante das três operações. Quase três... Como fazer isso da maneira mais eficiente?
-- fazemos tudo dentro de uma transação, para que ninguém veja "estados intermediários"
BEGIN;

-- criamos uma tabela temporária com os dados importados
CREATE TEMPORARY TABLE tmp(
  LIKE dst INCLUDING INDEXES -- à semelhança, junto com índices
) ON COMMIT DROP; -- fora da transação, não precisamos dela

-- injetamos rapidamente a nova imagem através do COPY
COPY tmp FROM STDIN;
-- ...
-- .

-- deletamos os ausentes
DELETE FROM
  dst D
USING
  dst X
LEFT JOIN
  tmp Y
    USING(pk1, pk2) -- campos da chave primária
WHERE
  (D.pk1, D.pk2) = (X.pk1, X.pk2) AND
  Y IS NOT DISTINCT FROM NULL; -- "anti-junção"

-- atualizamos o que restou
UPDATE
  dst D
SET
  (f1, f2, f3) = (T.f1, T.f2, T.f3)
FROM
  tmp T
WHERE
  (D.pk1, D.pk2) = (T.pk1, T.pk2) AND
  (D.f1, D.f2, D.f3) IS DISTINCT FROM (T.f1, T.f2, T.f3); -- não precisamos atualizar os que coincidem

-- inserimos os ausentes
INSERT INTO
  dst
SELECT
  T.*
FROM
  tmp T
LEFT JOIN
  dst D
    USING(pk1, pk2)
WHERE
  D IS NOT DISTINCT FROM NULL;

COMMIT;
3.2. Pós-processamento da importação
Na mesma KLRD, todos os registros alterados precisam ser executados por um pós-processamento — normalizar, destacar palavras-chave, trazer para as estruturas necessárias. Mas como saber — o que exatamente foi alterado, sem complicar o código de sincronização, idealmente, sem até mesmo tocá-lo?
Se o acesso de gravação no momento da sincronização é apenas para o seu processo, você pode usar um gatilho que coletará todas as alterações para nós:
-- ciljne tabele
CREATE TABLE kladr(...);
CREATE TABLE kladr_house(...);

-- tabele sa istorijom promena
CREATE TABLE kladr$log(
  ro kladr, -- ovde se čuvaju ceo zapisi starih/novih
  rn kladr
);

CREATE TABLE kladr_house$log(
  ro kladr_house,
  rn kladr_house
);

-- opšta funkcija logovanja promena
CREATE OR REPLACE FUNCTION diff$log() RETURNS trigger AS $$
DECLARE
  dst varchar = TG_TABLE_NAME || '$log';
  stmt text = '';
BEGIN
  -- proveravamo potrebu za logovanjem prilikom ažuriranja zapisa
  IF TG_OP = 'UPDATE' THEN
    IF NEW IS NOT DISTINCT FROM OLD THEN
      RETURN NEW;
    END IF;
  END IF;
  -- kreiramo zapis loga
  stmt = 'INSERT INTO ' || dst::text || '(ro,rn)VALUES(';
  CASE TG_OP
    WHEN 'INSERT' THEN
      EXECUTE stmt || 'NULL,$1)' USING NEW;
    WHEN 'UPDATE' THEN
      EXECUTE stmt || '$1,$2)' USING OLD, NEW;
    WHEN 'DELETE' THEN
      EXECUTE stmt || '$1,NULL)' USING OLD;
  END CASE;
  RETURN NEW;
END;
$$ LANGUAGE plpgsql;
Sada možemo da prije početka sinhronizacije postavimo (ili uključimo preko ALTER TABLE ... ENABLE TRIGGER ...):
CREATE TRIGGER log
  AFTER INSERT OR UPDATE OR DELETE
  ON kladr
    FOR EACH ROW
      EXECUTE PROCEDURE diff$log();

CREATE TRIGGER log
  AFTER INSERT OR UPDATE OR DELETE
  ON kladr_house
    FOR EACH ROW
      EXECUTE PROCEDURE diff$log();
Zatim mirno izvlačimo sve potrebne promene iz log-tabela i propuštamo ih kroz dodatne obradnike.
3.3. Uvoz povezanih skupa
Gore smo razmatrali slučajeve kada se strukture podataka izvora i odredišta poklapaju. Ali šta raditi ako se izvoz iz spoljnog sistema razlikuje od strukture koju imamo u svojoj bazi?
Uzmimo za primer čuvanje klijenata i njihovih računa, klasičan slučaj "mnogi-na-jedan":
CREATE TABLE client(
  client_id
    serial
      PRIMARY KEY
, inn
    varchar
      UNIQUE
, name
    varchar
);

CREATE TABLE invoice(
  invoice_id
    serial
      PRIMARY KEY
, client_id
    integer
      REFERENCES client(client_id)
, number
    varchar
, dt
    date
, sum
    numeric(32,2)
);
A izlaz iz spoljnog izvora dolazi nam u formatu "sve u jednom":
CREATE TEMPORARY TABLE invoice_import(
  client_inn
    varchar
, client_name
    varchar
, invoice_number
    varchar
, invoice_dt
    date
, invoice_sum
    numeric(32,2)
);
Očigledno je da podaci o klijentima mogu biti duplicirani u ovom obliku, a osnovna zapis je "račun":
0123456789;Vasa;A-01;2020-03-16;1000.00
9876543210;Petar;A-02;2020-03-16;666.00
0123456789;Vasa;B-03;2020-03-16;9999.00
Za model jednostavno ubacimo naše test podatke, ali pamtimo — COPY efikasnije!
INSERT INTO invoice_import
VALUES
  ('0123456789', 'Vasa', 'A-01', '2020-03-16', 1000.00)
, ('9876543210', 'Petar', 'A-02', '2020-03-16', 666.00)
, ('0123456789', 'Vasa', 'B-03', '2020-03-16', 9999.00);
Prvo ćemo izolovati one "sečeve" na koje se naši "fakti" pozivaju. U našem slučaju računi se pozivaju na klijente:
USTVARITE ZAČASNO TABELO client_import AS
IZBERITE DISTINCT ON(client_inn)
-- lahko preprosto izberete DISTINCT, če so podatki vnaprej neproblematični
  client_inn inn
, client_name "name"
IZ
  invoice_import;
Da bi pravilno povezali račune z ID-ji strank, moramo te identifikatorje najprej poznati ali jih generirati. Dodali bomo polja zanje:
SPREMENITE TABELO invoice_import DODAJ KOLONO client_id integer;
SPREMENITE TABELO client_import DODAJ KOLONO client_id integer;
Uporabili bomo zgoraj opisani način sinhronizacije tabel z majhno prilagoditvijo — ne bomo niti posodabljali niti brisali v ciljni tabeli, saj imamo uvoz strank "append-only":
-- v tabeli uvoza nastavimo ID že obstoječih zapisov
POSODABAJANJE
  client_import T
NASTAVI
  client_id = D.client_id
IZ
  client D
KJER
  T.inn = D.inn; -- edinstven ključ

-- dodamo manjkajoče zapise in nastavimo njihove ID-je
S WITH ins AS (
  VSTAVI V client(
    inn
  , name
  )
  IZBERITE
    inn
  , name
  IZ
    client_import
  KJER
    client_id JE NULL -- če ID ni bil nastavljen
  VRAČAJUČI *
)
POSODABAJANJE
  client_import T
NASTAVI
  client_id = D.client_id
IZ
  ins D
KJER
  T.inn = D.inn; -- edinstven ključ

-- nastavimo ID strank pri zapisih računov
POSODABAJANJE
  invoice_import T
NASTAVI
  client_id = D.client_id
IZ
  client_import D
KJER
  T.client_inn = D.inn; -- aplikativni ključ
Pravzaprav je to vse — v invoice_import zdaj imamo izpolnjen povezovalni polje client_id, s katerim bomo dodali račun.
Izvor: habr.com
