

Razširitev poročila iz leta 2015 Alekseja Lesovskega "Poglobinski vpogled v notranjo statistiko PostgreSQL"
Izjava avtorja poročila: Opazil bom, da je bilo to poročilo datirano novembra 2015 — minilo je več kot 4 leta in veliko časa. Različica 9.4, obravnavana v poročilu, se že ne podpira. V preteklih 4 letih je izšlo 5 novih različic, v katerih je bilo uvedenih veliko novosti, izboljšav in sprememb, kar pomeni, da je del materiala zastarel in ni več relevanten. Med pregledom sem se trudil označiti ta mesta, da te ne bi, bralec, zavodil. Nisem pa prepisoval teh mest, saj jih je zelo veliko in bi tako nastalo povsem drugo poročilo.
DBMS PostgreSQL je ogromen mehanizem, ki je sestavljen iz številnih podsistemov, katerih usklajeno delovanje neposredno vpliva na zmogljivost DBMS. V procesu delovanja se zbirajo statistični in informacijskih podaci o delovanju komponent, kar omogoča oceno učinkovitosti PostgreSQL in sprejetje ukrepov za izboljšanje zmogljivosti. Vendar pa je teh informacij zelo veliko in predstavljene so v precej poenostavljeni obliki. Obdelava in interpretacija teh informacij je včasih precej nenavadna naloga, medtem ko "živalski vrt" orodij in pripomočkov lahko enostavno zmede celo naprednega DBA.
Dober dan! Moje ime je Aleksej. Kot je Ilya povedal, bom govoril o statistiki PostgreSQL.
Statistika aktivnosti PostgreSQL. PostgreSQL ima dve vrsti statistike. Statistika aktivnosti, o kateri bo govora. In statistika načrtovalnika o porazdelitvi podatkov. Govoril bom predvsem o statistiki aktivnosti PostgreSQL, ki nam omogoča, da sodimo o zmogljivosti in jo nekako izboljšamo.
Povedal bom, kako učinkovito uporabljati statistiko za reševanje najrazličnejših problemov, s katerimi se srečujete ali se boste srečali.
Kaj ne bo v poročilu? V poročilu se ne bom dotaknil statistike načrtovalnika, saj je to ločena tema za ločeno poročilo o tem, kako se podatki shranjujejo v bazi in kako načrtovalnik poizvedb pridobi predstavo o kvalitativnih in kvantitativnih značilnostih teh podatkov.
In ne bo pregledov orodij, ne bom primerjal enega izdelka z drugim. Nobene reklame ne bo. Odpustimo to.
Želim vam pokazati da je korištenje statistike korisno. Potrebno je. Nije zastrašujuće koristiti je. Trebat će nam samo običan SQL i osnovna znanja o SQL-u.
Razgovarat ćemo o tome koju statistiku odabrati za rješavanje problema.
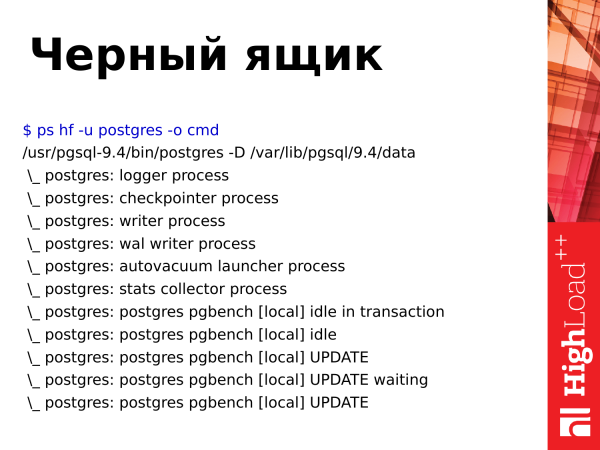
Ako pogledamo PostgreSQL i pokrenemo naredbu za pregled procesa u operativnom sustavu, vidjet ćemo 'crnu kutiju'. Vidjet ćemo neke procese koji nešto rade i po nazivima možemo otprilike pretpostaviti čime se bave. No, u suštini, to je crna kutija, ne možemo zaviriti unutra.
Možemo pogledati opterećenje CPU-a u top, možemo pogledati iskorištenost memorije putem nekih sistemskih alata, ali ne možemo zaviriti unutra u PostgreSQL. Za to su nam potrebni drugi alati.
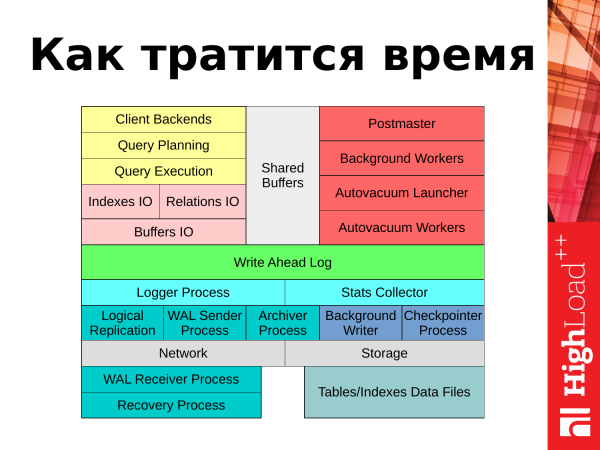
Nastavljajući dalje, ispričat ću gdje se troši vrijeme. Ako zamislimo PostgreSQL u obliku takve sheme, moći ćemo odgovoriti gdje se troši vrijeme. To su dvije stvari: obrada klijentskih zahtjeva od aplikacija i pozadinski zadaci koje PostgreSQL izvršava za održavanje svoje funkcionalnosti.
Ako počnemo razmatrati od gornjeg lijevog ugla, možemo pratiti kako se obrađuju klijentski zahtjevi. Zahtjev dolazi od aplikacije i za daljnji rad otvara se klijentska sesija. Zahtjev se prosljeđuje planeru. Planer sastavlja plan zahtjeva. Šalje ga dalje na izvršenje. Dogodi se blokovni ulaz/izlaz podataka povezan s tablicama i indeksima. Potrebni podaci se čitaju s diskova u memoriju u posebnu oblast 'shared buffers'. Rezultati zahtjeva, ako se radi o ažuriranjima ili brisanju, bilježe se u dnevnik transakcija u WAL-u. Neka statistička informacija završava u logu ili u kolektoru statistike. A rezultat zahtjeva se vraća klijentu. Nakon toga klijent može ponoviti sve iznova s novim zahtjevom.
Što je s pozadinskim zadacima i pozadinskim procesima? Imamo nekoliko procesa koji osiguravaju rad i održavaju bazu podataka u normalnom radnom režimu. Ti procesi također će biti obuhvaćeni u izlaganju: to su autovacuum, checkpointer, procesi vezani uz replikaciju, background writer. O svakom od njih ću govoriti tijekom izlaganja.
Koji su problemi sa statistikom?
- Obstaja veliko informacij. PostgreSQL 9.4 ponuja 109 metrik za ogled statističnih podatkov. Vendar pa, če v podatkovni bazi hranite veliko tabel, shem, baz, je treba vse te metrike pomnožiti s številom tabel in baz. To pomeni, da informacije postanejo še obsežnejše. Zlahka se je mogoče v njih izgubiti.
- Naslednji problem je, da je statistika predstavljena s števcem. Če si ogledamo to statistiko, bomo videli nenehno rastoče števce. In če je od zadnjega ponastavitve statistike minilo zelo dolgo, bomo videli milijardne vrednosti. Te nam ne povejo ničesar.
- Pomanjkanje zgodovine. Če pride do napake, nekaj odpove 15-30 minut nazaj, ne morete uporabiti statistike, da bi preverili, kaj se je dogajalo 15-30 minut nazaj. To je težava.
- Pomanjkanje vgrajenega orodja v PostgreSQL je problem. Razvijalci jedra ne zagotavljajo nobene uporabne programske opreme. Nimajo nič takega. Preprosto ponujajo statistiko v bazi. Uporabite jo, izvedite poizvedbe, kar želite, to tudi storite.
- Ker v PostgreSQL ni vgrajenega orodja, to povzroča drug problem. Mnoga zunanja orodja. Vsaka podjetje, ki ima vsaj malo spretnosti, poskuša napisati svoj program. In na koncu je v skupnosti veliko orodij, ki jih lahko uporabite za delo s statistiko. Nekatera orodja ponujajo določene možnosti, druga pa nimajo teh možnosti ali pa ponujajo nove možnosti. In tako se pojavi situacija, da morate uporabiti dva, tri ali štiri orodja, ki se med seboj prekrivajo in imata različne funkcije. To je zelo neprijetno.
Kaj iz tega sledi? Pomembno je znati pridobiti statistiko neposredno, da ne bi bili odvisni od programov, ali kako izboljšati ta orodja: dodati nekatere funkcije, da bi pridobili svojo korist.
In potrebna so osnovna znanja SQL. Da bi pridobili določene podatke iz statistike, morate sestaviti SQL poizvedbe, torej morate vedeti, kako se sestavljajo select, join.
Statistika nam ponuja več stvari. Te lahko razdelimo v kategorije.
- Prva kategorija obuhvaća događaje koji se dešavaju u bazi. Kada u bazi dođe do nekog događaja: zahtev, pristup tabeli, automatsko čišćenje, potvrde, to su sve događaji. Odgovarajući brojači se inkrementiraju. Tako možemo pratiti te događaje.
- Druga kategorija odnosi se na svojstva objekata, poput tabela i baza. Ona imaju svoja svojstva, kao što je veličina tabela. Možemo pratiti rast tabela, rast indeksa. Takođe možemo posmatrati promene u dinamici.
- Treća kategorija se odnosi na vreme utrošeno na događaj. Zahtev je događaj. Ima svoju konkretnu meru trajanja. Ovde je počelo, ovde je završeno. To možemo pratiti. Takođe se prate stvari kao što su vreme čitanja bloka sa diska ili pisanje.
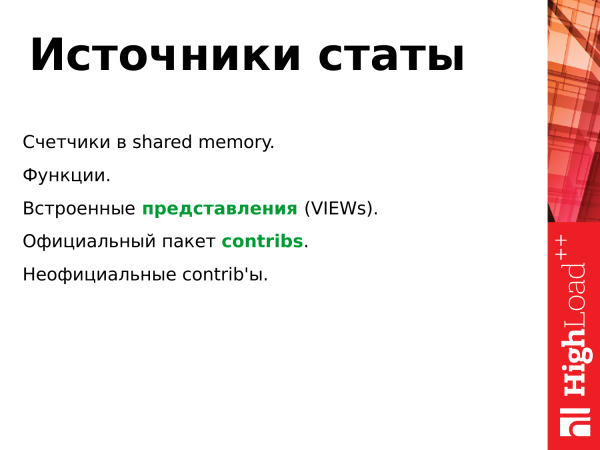
Izvori statistike predstavljeni su na sledeći način:
- U deljenoj memoriji (shared buffers) postoji segment za smeštaj statičkih podataka, tu su i ti brojači koji se neprekidno inkrementiraju kada se dešavaju određeni događaji ili nastaju neki momenti u radu baze.
- Svi ti brojači nisu dostupni korisniku, čak ni administratoru. To su niskonivojski detalji. Kako bismo im pristupili, PostgreSQL pruža interfejs u obliku SQL funkcija. Možemo napraviti SELECT upite pomoću tih funkcija i dobiti neku metriku (ili skup metrika).
- Međutim, upotreba ovih funkcija nije uvek zgodna, tako da su funkcije osnova za prikaze (VIEWs). To su virtuelne tabele koje pružaju statistiku za neku konkretnu podsistem, ili za određeni skup događaja u bazi podataka.
- Ova ugrađena prikaza (VIEWs) su glavni korisnički interfejs za rad sa statistikama. Dostupne su po defaultu bez dodatnog podešavanja, možete ih odmah koristiti da biste gledali i uzeli informacije. A postoji i nekoliko dodataka. Dodatci su zvanični. Možete instalirati paket postgresql-contrib (na primer, postgresql94-contrib), učitati potrebni modul u konfiguraciji, postaviti njegove parametre, ponovo pokrenuti PostgreSQL i možete ga koristiti. (Napomena. U zavisnosti od distribucije, u poslednjim verzijama, paket dodataka je deo osnovnog paketa.).
- Obstajajo tudi nepripadajoči contrib. Ti niso vključeni v standardno različico PostgreSQL. Treba jih je bodisi skompilirati bodisi namestiti kot knjižnico. Možnosti so lahko zelo različne, odvisno od tega, kaj je zamislil razvijalec tega nepripadajočega contriba.
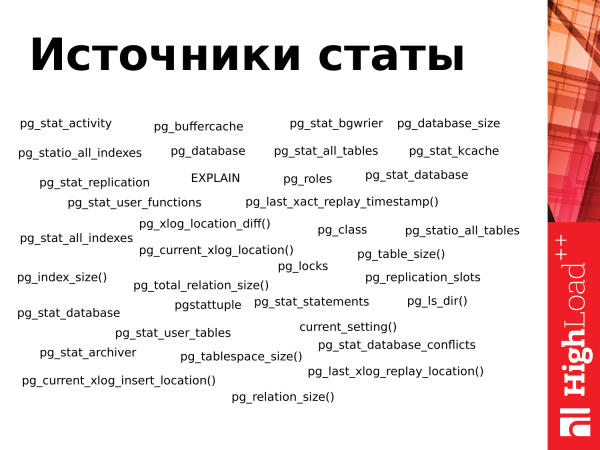
Na tej diapozitivni predstavi so predstavljeni vsi tisti pogledi (VIEWs) in del funkcij, ki so na voljo v PostgreSQL 9.4. Kot vidimo, jih je zelo veliko. Zelo lahko je zmedeno, če se s tem srečujete prvič.
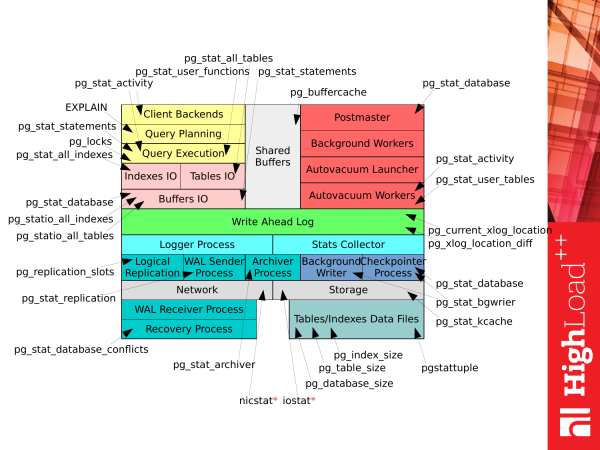
Če pa vzamemo prejšnjo sliko Kako se porablja čas na PostgreSQL in to uskladimo s tem seznamom, dobimo to sliko. Vsak pogled (VIEWs) ali vsako funkcijo lahko uporabimo za različne namene za pridobitev ustrezne statistike, ko PostgreSQL deluje. In lahko dobimo že nekaj informacij o delovanju podključa.
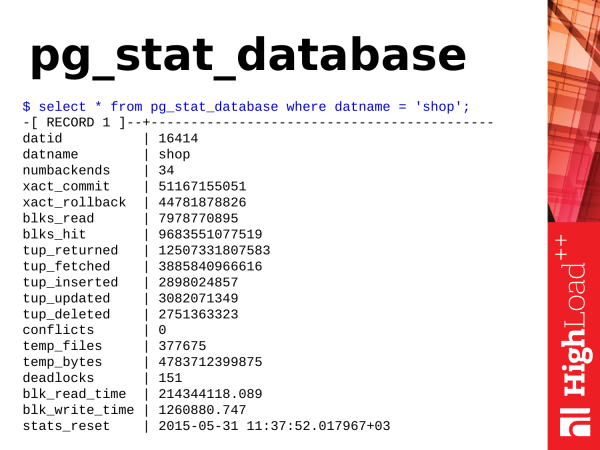
Prvo, kar bomo obravnavali, je pg_stat_database. Kot vidimo, je to pogled. V njem je veliko informacij. Različne informacije. In prinaša zelo koristno znanje o tem, kaj se dogaja v podatkovni bazi.
Kaj lahko koristnega pridobimo od tam? Začnimo s najpreprostejšimi stvarmi.
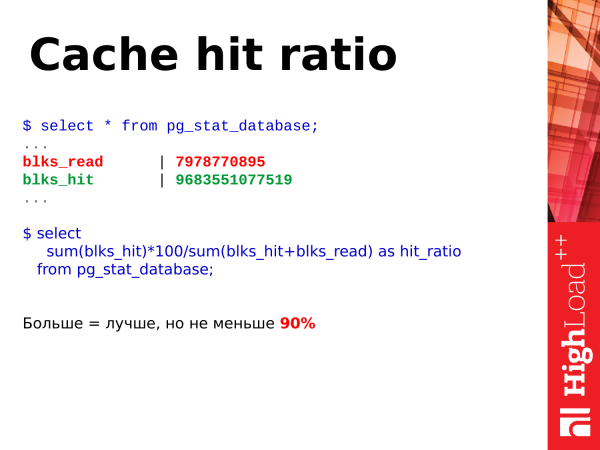
select
sum(blks_hit)*100/sum(blks_hit+blks_read) as hit_ratio
from pg_stat_database;
Prvo, kar lahko pogledamo, je odstotek zadetkov v predpomnilniku. Odstotek zadetkov v predpomnilniku je koristna metrika. Omogoča nam oceno, koliko podatkov se vzame iz predpomnilnika shared buffers in koliko podatkov se bere s diska.
Seveda večja kot je naša stopnja zadetkov v predpomnilniku, tem bolje. To metriko ocenjujemo kot odstotek. Na primer, če je naš odstotek zadetkov v predpomnilniku višji od 90 %, je to dobro. Če pade pod 90 %, pomeni, da nimamo dovolj pomnilnika, da bi obdržali vročo "glavo" podatkov v pomnilniku. In da bi te podatke uporabili, je PostgreSQL prisiljen dostopati do diska, kar je počasneje, kot če bi se podatki brali iz pomnilnika. Takrat je treba razmišljati o povečanju pomnilnika: bodisi povečati shared buffers bodisi razširiti fizični pomnilnik (RAM).
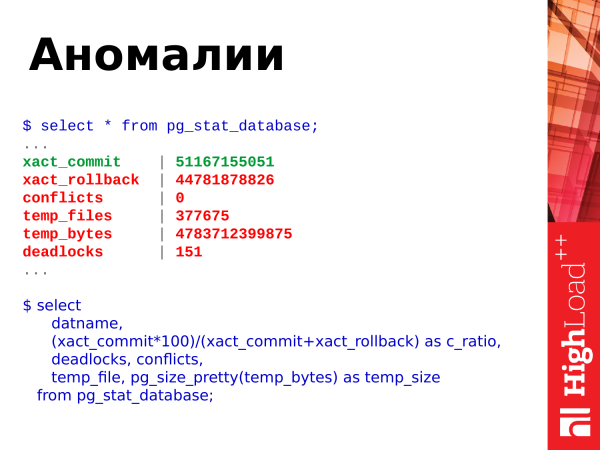
select
datname,
(xact_commit*100)/(xact_commit+xact_rollback) as c_ratio,
deadlocks, conflicts,
temp_file, pg_size_pretty(temp_bytes) as temp_size
from pg_stat_database;
Kaj drugega lahko izvlečemo iz tega pogleda? Lahko si ogledamo anomalije, ki se dogajajo v bazi. Kaj je tukaj prikazano? Tukaj so commits, rollbacks, ustvarjanje začasnih datotek, njihova velikost, deadlocks in konflikti.
Lahko uporabimo to poizvedbo. Ta SQL je precej preprost. In lahko si ogledamo te podatke pri nas.
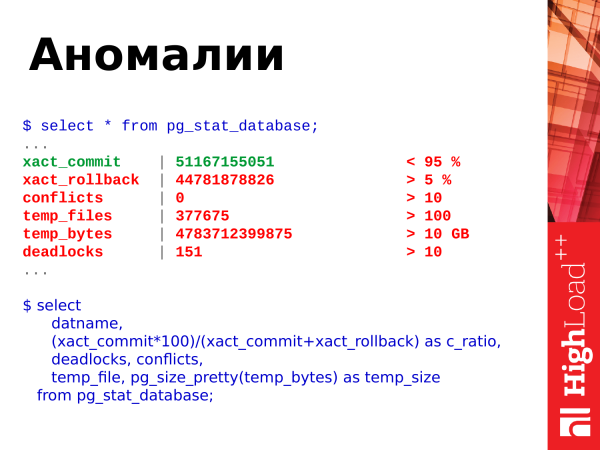
In tu so takoj mejne vrednosti. Ogledujemo si razmerje med commits in rollbacks. Commits so uspešna potrditev transakcije. Rollbacks so povratki, tj. transakcija je opravila neko delo, obremenila bazo, nekaj izračunala, nato pa je prišlo do napake in rezultati transakcije so bili zavrnjeni. T.j. številka rollbacks, ki se nenehno povečuje, je slaba. Treba se je izogibati temu in popraviti kodo, da do tega ne pride.
Konflikti (conflicts) so povezani z replikacijo. In tudi teh se je treba izogibati. Če imate kakšne poizvedbe, ki se izvajajo na replici in se pojavijo konflikti, je treba te konflikte obravnavati, ugotoviti, kaj se dogaja. Podrobnosti lahko najdete v dnevnikih. In odpraviti konfliktne situacije, da poizvedbe aplikacije delujejo brez napak.
Deadlocks so tudi slaba situacija. Ko se poizvedbe borijo za vire, se ena poizvedba obrne na en vir in pridobi blokado, druga poizvedba se obrne na drugi vir in tudi pridobi blokado, nato pa se obe poizvedbi obrnete na vire drug drugega in se zakleneta v pričakovanju, da bo sosed sprostil blokado. To je prav tako problematična situacija. Treba jih je reševati na ravni prepisovanja aplikacij in serializacije dostopa do virov. In če opazite, da se vaši deadlocks nenehno povečujejo, je treba preveriti podrobnosti v dnevnikih, obravnavati nastale situacije in ugotoviti, kje je težava.
Začasne datoteke (temp_files) so tudi slabe. Ko uporabniški poizvedbi zmanjkuje pomnilnika za gostovanje operativnih, začasnih podatkov, ustvari na disku datoteko. In vse operacije, ki bi jih lahko izvedel v začasnem pomnilniku, začne izvajati na disku. To je počasi. To povečuje čas izvedbe poizvedbe. In stranka, ki je poslala poizvedbo k PostgreSQL, bo dobila odgovor malo kasneje. Če se vse te operacije izvajajo v pomnilniku, bo Postgres odgovoril precej hitreje in stranka bo manj čakala.
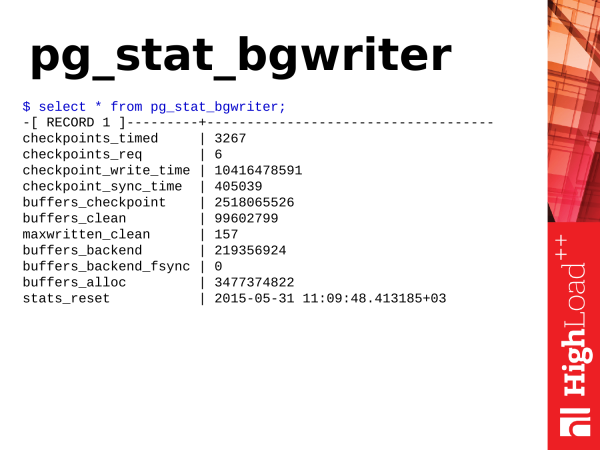
Pg_stat_bgwriter je prikaz, ki opisuje delo dveh v ozadju delujočih podsistemov PostgreSQL: to sta checkpointer in background writer.
Najprej razpravljajmo o kontrolnih točkah, t.i. checkpoints. Kaj so kontrolne točke? Kontrolna točka je pozicija v dnevniku transakcij, ki sporoča, da so vse spremembe podatkov v dnevniku uspešno sinhronizirane s podatki na disku. Postopek je lahko dolgotrajen, odvisno od delovne obremenitve in nastavitev, in pretežno vključuje sinhronizacijo »umazanih« strani v deljenih predpomnilnikih z datotečnimi datotekami na disku. Zakaj je to potrebno? Če bi PostgreSQL nepretrgoma dostopal do diska, od tam pridobival podatke in zapisoval podatke ob vsakem dostopu, bi bilo to počasno. Zato ima PostgreSQL segment pomnilnika, katerega velikost je odvisna od nastavitev v konfiguraciji. Postgres namesti te podatke v pomnilnik za nadaljnjo obdelavo ali za izdajo na zahtevo. V primeru sprememb podatkov pride do njihove spremembe. In dobimo dve različici podatkov. Ena je v pomnilniku, druga pa na disku. Občasno je potrebno te podatke sinhronizirati. Potrebno je, da sinhroniziramo tisto, kar je bilo spremenjeno v pomnilniku, na disk. To so kontrolne točke.
Kontrolna točka preide preko deljenih predpomnilnikov, označi umazane strani kot potrebne za kontrolno točko. Nato izvede drugi prehod preko deljenih predpomnilnikov. In strani, ki so označene za kontrolno točko, se sinhronizirajo. Tako se izvede sinhronizacija podatkov z diskom.
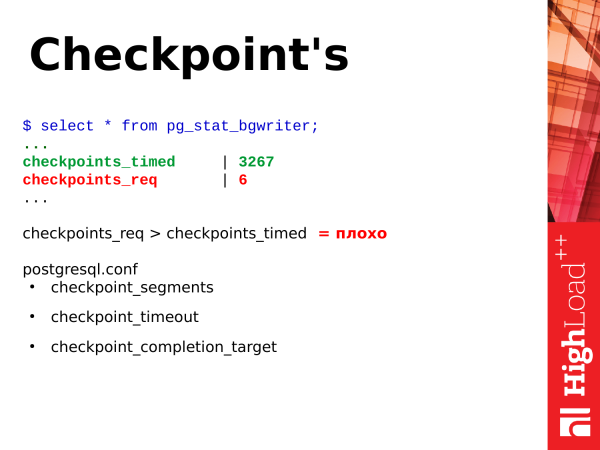
Obstajata dva tipa kontrolnih točk. Ena kontrolna točka se izvede na podlagi časovne omejitve. To je koristna in dobra kontrolna točka – checkpoint_timed. In obstajajo kontrolne točke na zahtevo – checkpoint required. Takšna kontrolna točka se zgodi, ko imamo zelo veliko pisanje podatkov. Zapisali smo veliko dnevnikov transakcij. In PostgreSQL meni, da mora vse to čim hitreje sinhronizirati, narediti kontrolno točko in nadaljevati.
In če ste pogledali statistiko pg_stat_bgwriter in videli, da imate checkpoint_req zelo veliko več kot checkpoint_timed, je to slabo. Zakaj slabo? To pomeni, da se PostgreSQL nahaja v nenehnem stresu, ko mora zapisovati podatke na disk. Kontrolna točka na podlagi časovne omejitve je manj stresna in se izvaja v skladu z notranjim urnikom ter se razteza v času. PostgreSQL ima možnost, da naredi premore v delovanju in ne obremenjuje disčnega sistema. To je za PostgreSQL koristno. In poizvedbe, ki se izvajajo med kontrolno točko, ne bodo izkusile stresa zaradi zasedenosti disčnega sistema.
In order to adjust the checkpoint, there are three parameters:
checkpoint_segments.checkpoint_timeout.checkpoint_completion_target.
These allow for the regulation of checkpoint operations. However, I won’t dwell on them. Their influence is a separate topic.
Attention: The version 9.4 discussed in the report is outdated. In modern versions of PostgreSQL, the parameter checkpoint_segments has been replaced by the parameters min_wal_size in max_wal_size.
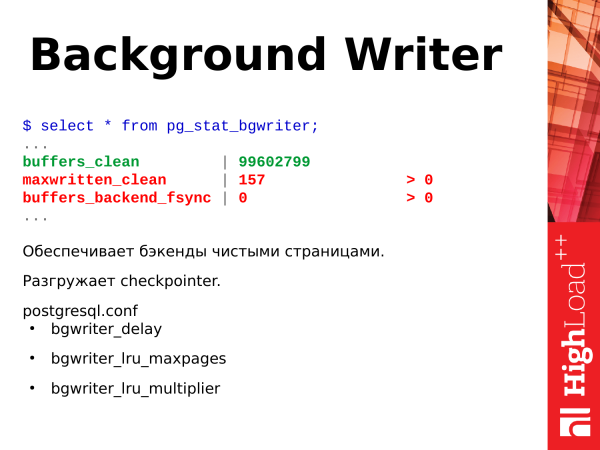
The next subsystem is the background writer — background writer. What does it do? It operates continuously in an infinite loop. It scans pages in the shared buffers and flushes the dirty pages it finds to disk. Thus, it helps the checkpointer do less work during the checkpoint process.
What else is it needed for? It ensures the need for clean pages in shared buffers in case they are required (in large quantities and all at once) for data placement. Suppose a situation arises where clean pages are needed to perform a query and they are already available in shared buffers. The PostgreSQL backend simply takes them and uses them; it doesn’t need to clean anything itself. But if such pages are suddenly unavailable, the backend pauses its work and starts looking for pages to flush to disk to take for its needs, which negatively affects the response time of the currently executing query. If you see that your parameter maxwritten_clean is high, this means that the background writer is failing to perform its job and the parameters need to be increased bgwriter_lru_maxpages, so it can do more work in one cycle and clean more pages.
Another very useful indicator is buffers_backend_fsync. Backends do not perform fsync, as it is slow. They pass fsync up the IO stack to the checkpointer. The checkpointer has its own queue; it periodically processes fsync and synchronizes the pages in memory with the files on disk. If the queue is large and filled at the checkpointer, then the backend is forced to perform fsync itself, which slows down its operation,meaning the client will receive a response later than it could. If you see that this value is greater than zero, then this is already a problem and you need to pay attention to the settings of the background writer and also evaluate the performance of the disk subsystem.
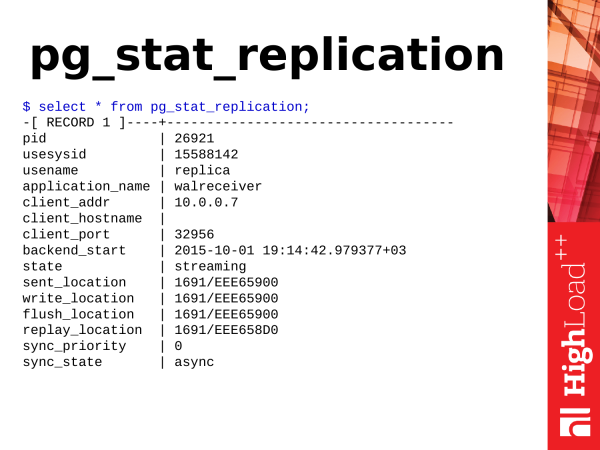
Attention: _Naslednji tekst opisuje statistične prikaze, povezane z replikacijo. Večina imen prikazov in funkcij je bila preimenovana v Postgres 10. Osnovna ideja preimenovanj je bila nadomestitev xlog na wal in lokacija na lsn v imenih funkcij/prikazov itd. Poseben primer, funkcija pg_xlog_location_diff() je bila preimenovana v pg_wal_lsn_diff()._
Tudi tukaj imamo veliko stvari. Toda potrebovali bomo le točke, povezane z lokacijo.
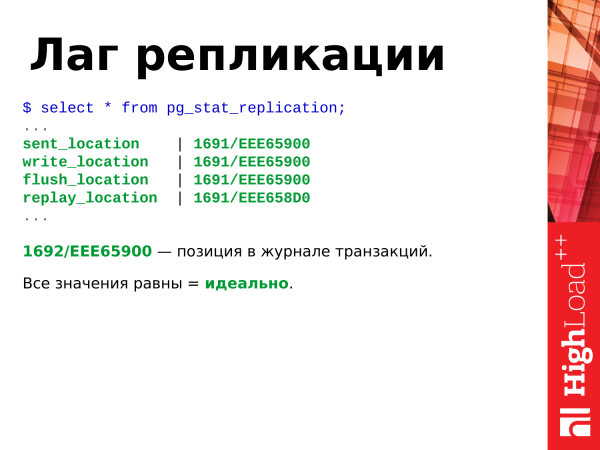
Če vidimo, da so vse vrednosti enake, je to idealna situacija in replika ne zaostaja za glavnim strežnikom.
Ta šesnajstiška pozicija je pozicija v dnevniku transakcij. Neprestano se povečuje, če v bazi obstaja kakšna aktivnost: vstavljanja, brisanja itd.
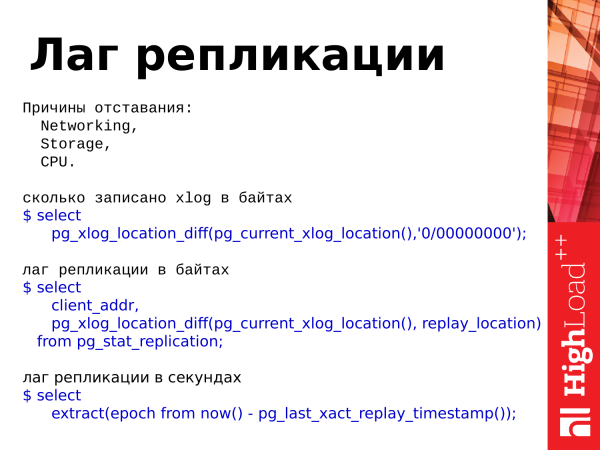
koliko je xlog zapisanih v bajtih
$ select
pg_xlog_location_diff(pg_current_xlog_location(),'0/00000000');
zakasnitev replikacije v bajtih
$ select
client_addr,
pg_xlog_location_diff(pg_current_xlog_location(), replay_location)
from pg_stat_replication;
zakasnitev replikacije v sekundah
$ select
extract(epoch from now() - pg_last_xact_replay_timestamp());
Če se te stvari razlikujejo, pomeni, da obstaja zakasnitev. Zakasnitev je zaostajanje replike za glavnim strežnikom, tj. podatki se razlikujejo med strežniki.
Obstajajo tri vzroki za zaostajanje:
- To je diskovni sistem, ki se ne more spopasti s pisanjem sinhronizacijskih datotek.
- To so morebitne napake v omrežju ali preobremenitev omrežja, ko podatki ne morejo pravočasno priti do replikatorja in ta jih ne more reproducirati.
- In procesor. Procesor – to je zelo redek primer. To sem videl dvakrat ali trikrat, a se tudi to lahko zgodi.
In tu so trije poizvedbe, ki nam omogočajo uporabo statistike. Lahko ocenimo, koliko je zapisano v dnevniku transakcij. Obstaja takšna funkcija pg_xlog_location_diff in lahko ocenimo zakasnitev replikacije v bajtih in sekundah. Tudi za to uporabljamo vrednost iz te predstavitve (VIEWs).
Opomba: _Namesto pg_xlog_locationdiff() funkcijo lahko uporabimo operator odštevanja in odštejemo eno lokacijo od druge. Udobno.
S zakasnitvijo, ki je v sekundah, je en vidik. Če na glavnem strežniku ne poteka nobena aktivnost, je bila transakcija tam nekje pred 15 minutami in ni nobene aktivnosti, in če na repliki pogledamo to zakasnitev, bomo videli zakasnitev 15 minut. To je vredno zapomniti. In to lahko zmede, ko pogledate to zakasnitev.
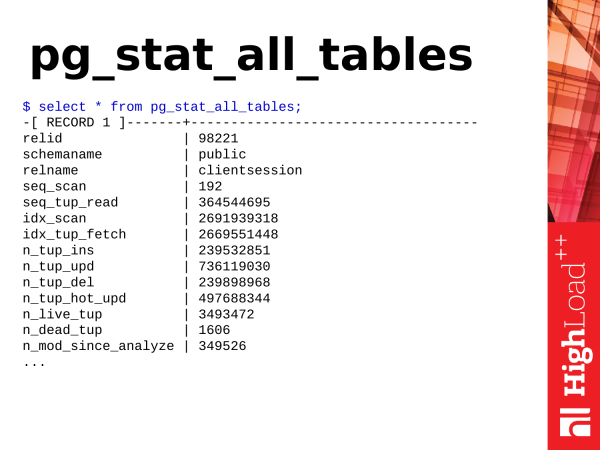
Pg_stat_all_tables – še eno koristno predstavitev. Prikazuje statistiko po tabelah. Ko imamo v bazi tabel, ki imajo neko aktivnost, določene akcije, lahko te informacije pridobimo iz te predstavitve.
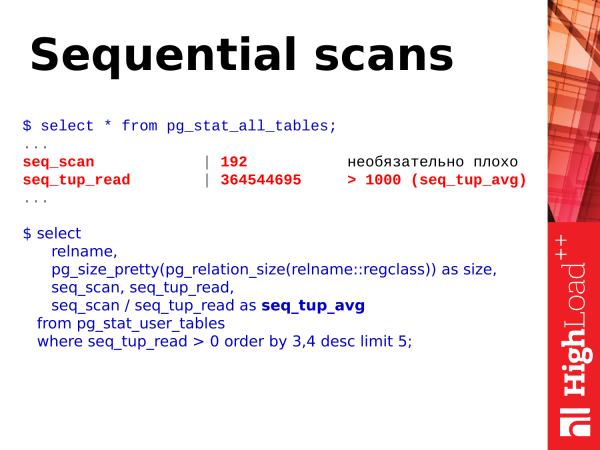
select
relname,
pg_size_pretty(pg_relation_size(relname::regclass)) as size,
seq_scan, seq_tup_read,
seq_scan / seq_tup_read as seq_tup_avg
from pg_stat_user_tables
where seq_tup_read > 0 order by 3,4 desc limit 5;
Prvo, kar lahko pogledamo, so sekvenčna skeniranja po tabeli. Sama številka po teh prehodih še ni nujno slaba in ne nakazuje, da bi morali že ukrepati.
Obstaja pa še druga metrika – seq_tup_read. To je število vrstic, vrnjenih kot rezultat sekvenčnega skeniranja. Če povprečno število preseže 1.000, 10.000, 50.000, 100.000, to že nakazuje, da morda potrebujete kje zgraditi indeks, da bi bile sklice po indeksu, ali pa morda optimizirati poizvedbe, ki uporabljajo taka sekvenčna skeniranja, da se to ne dogaja.
Enostaven primer – domnevajmo, da je poizvedba z velikim OFFSET in LIMIT nevzdržna. Na primer, skenira se 100.000 vrstic v tabeli in nato vzame 50.000 potrebnih vrstic, while so prejšnje skenirane vrstice zavržene. To je tudi slab primer. Takšne poizvedbe je treba optimizirati. Tukaj pa je tak preprost SQL-poizvedek, na katerem si to lahko ogledate in ocenite pridobljene številke.
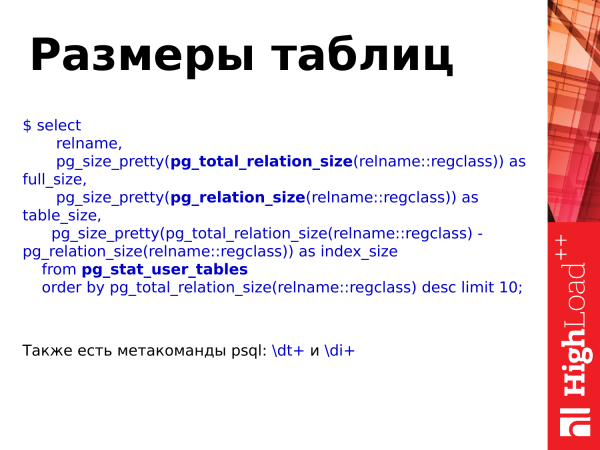
select
relname,
pg_size_pretty(pg_total_relation_size(relname::regclass)) as
full_size,
pg_size_pretty(pg_relation_size(relname::regclass)) as
table_size,
pg_size_pretty(pg_total_relation_size(relname::regclass) -
pg_relation_size(relname::regclass)) as index_size
from pg_stat_user_tables
order by pg_total_relation_size(relname::regclass) desc limit 10;
Velikosti tabel lahko prav tako pridobimo s pomočjo te tabele in dodatnih funkcij pg_total_relation_size(), pg_relation_size().
Na splošno obstajajo metakomande dt in di, ki jih lahko uporabimo v PSQL in tudi pogledamo velikosti tabel in indeksov.
Vendar pa nam uporaba funkcij pomaga pogledati velikosti tabel tudi ob upoštevanju indeksov ali brez upoštevanja indeksov ter nato oceniti rast baze podatkov, tj. kako hitro raste in iz tega sklepati o optimizaciji velikosti.
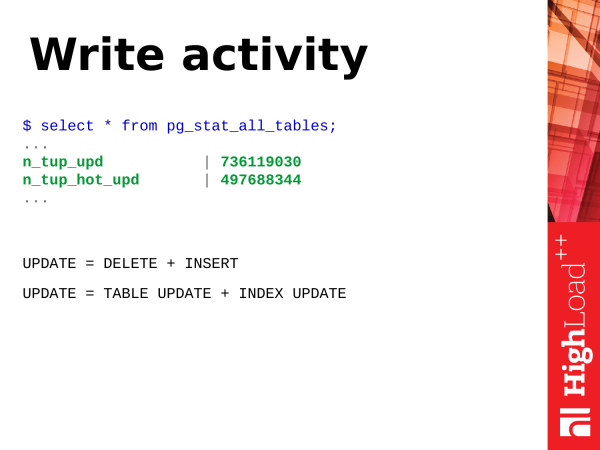
Aktivnost pri zapisovanju. Kaj pomeni zapis? Poglejmo operacijo UPDATE – operacija posodabljanja vrstic v tabeli. V bistvu je update dve operaciji (ali še več). To je vstavljanje nove različice vrstice in označevanje stare različice vrstice kot zastarele. V nadaljevanju bo prišel avtokavmenik, ki bo te zastarele različice vrstic odstranil in označil to mesto kot razpoložljivo za ponovno uporabo.
Poleg tega update ni le posodabljanje tabele. To je tudi posodabljanje indeksov. Če imate na tabeli veliko indeksov, bo ob update potrebno posodobiti tudi vse indekse, v katerih sodelujejo polja, posodobljena v poizvedbi. V teh indeksih bodo prav tako zastarele različice vrstic, ki jih je potrebno očistiti.
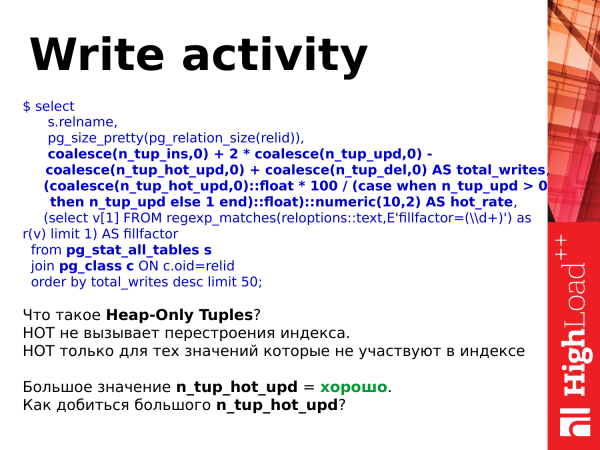
select
s.relname,
pg_size_pretty(pg_relation_size(relid)),
coalesce(n_tup_ins,0) + 2 * coalesce(n_tup_upd,0) -
coalesce(n_tup_hot_upd,0) + coalesce(n_tup_del,0) AS total_writes,
(coalesce(n_tup_hot_upd,0)::float * 100 / (case when n_tup_upd > 0
then n_tup_upd else 1 end)::float)::numeric(10,2) AS hot_rate,
(select v[1] FROM regexp_matches(reloptions::text,E'fillfactor=(\d+)') as
r(v) limit 1) AS fillfactor
from pg_stat_all_tables s
join pg_class c ON c.oid=relid
order by total_writes desc limit 50;
In zaradi svojega oblikovanja je UPDATE težka operacija. Vendar jo lahko olajšamo. Tu so hot updates. Pojavili so se v PostgreSQL različici 8.3. Kaj so to? To je lahko posodobitev, ki ne povzroči rekonstruiranja indeksov. To pomeni, da smo posodobili zapis, toda pri tem se je posodobil le zapis na strani (ki pripada tabeli), indeksi pa še naprej kažejo na isti zapis na strani. Tam je nekaj zanimive logike delovanja: ko pride vakuum, te verige hot rekonstruiše in vse še naprej deluje brez posodabljanja indeksov, kar poteka z manjšo porabo virov.
In ko imate n_tup_hot_upd veliko, to pomeni zelo dobro. To pomeni, da prevladujejo lahke posodobitve in je to za vire cenejše in vse deluje odlično.
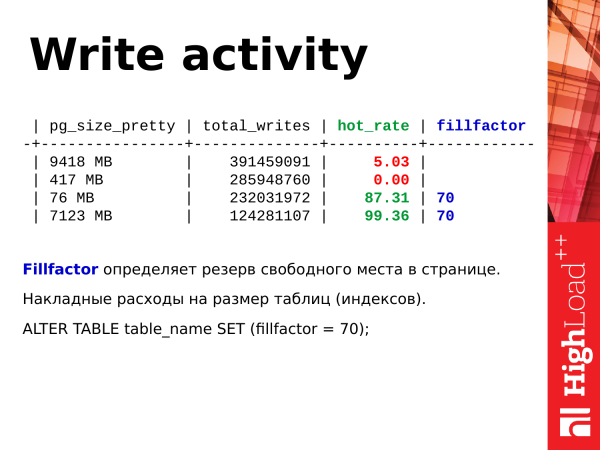
ALTER TABLE table_name SET (fillfactor = 70);Kako povečati obseg hot updateov? Lahko uporabimo fillfactor. Ta določa velikost rezerviranega prostega prostora pri zapolnjenju strani v tabeli s pomočjo INSERT-ov. Ko v tabelo pridejo vstavljanja, te povsem zapolnijo stran, ne puščajo praznega prostora. Nato se dodeli nova stran. Spet so podatki zapolnjeni. To vedenje je privzeto, fillfactor = 100 %.
Lahko nastavimo fillfactor na 70 %. To pomeni, da se ob vstavljanju dodeli nova stran, vendar se napolni le 70 % strani. 30 % ostane v rezervi. Ko bo potrebna posodobitev, se bo najbrž zgodila na isti strani, in nova različica vrstice se bo vnesla na isto stran. Opravljena bo hot_update. Tako se poenostavi zapis v tabelah.
select c.relname,
current_setting('autovacuum_vacuum_threshold') as av_base_thresh,
current_setting('autovacuum_vacuum_scale_factor') as av_scale_factor,
(current_setting('autovacuum_vacuum_threshold')::int +
(current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples))
as av_thresh,
s.n_dead_tup
from pg_stat_user_tables s join pg_class c ON s.relname = c.relname
where s.n_dead_tup > (current_setting('autovacuum_vacuum_threshold')::int
+ (current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples));
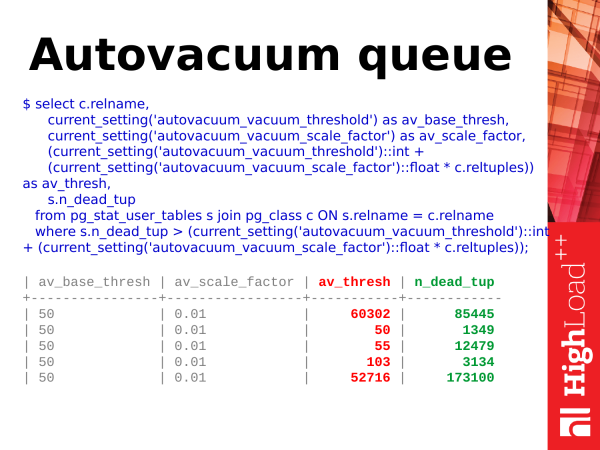
Čakalna vrsta avtoklasi. Avtoklasi so podsystem, kjer je statistike v PostgreSQL zelo malo. V tabelah lahko le v pg_stat_activity vidimo, koliko avtoklasov trenutno poteka. Vendar pa je zelo težko razumeti, koliko tabel je v čakalni vrsti.
Opomba: _Začelo se je izboljšanje s spremljanjem avtoklasi od različice Postgres 10 — uvedena je bila prikaz pg_stat_progressvacuum, kar močno poenostavi vprašanje spremljanja avtoklasi.
Lahko uporabimo to poenostavljeno poizvedbo. In lahko pogledamo, kdaj bo potrebno opraviti vacuum. Toda kako in kdaj naj se začne vacuum? Ustarezle različice vrstic, o katerih sem govoril prej. Posodobitev se je zgodila, nova različica vrstice je bila vstavljena. Pojavila se je ustarezla različica vrstice. V tabeli pg_stat_user_tables je taka parameter n_dead_tup. Pokaže število "mrtvih" vrstic. In takoj ko število mrtvih vrstic preseže določen prag, k tabeli pride avtoklas.
Kako se izračuna ta prag? To je zelo konkretna odstotna razmerja od skupnega števila vrstic v tabeli. Obstaja parameter autovacuum_vacuum_scale_factor. Ta določa odstotno razmerje. Recimo, 10 % + dodaten osnovni prag 50 vrstic. In kaj se zgodi? Ko imamo več mrtvih vrstic kot "10 % + 50" od vseh vrstic v tabeli, damo tabelo pod avtoklas.
select c.relname,
current_setting('autovacuum_vacuum_threshold') as av_base_thresh,
current_setting('autovacuum_vacuum_scale_factor') as av_scale_factor,
(current_setting('autovacuum_vacuum_threshold')::int +
(current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples))
as av_thresh,
s.n_dead_tup
from pg_stat_user_tables s join pg_class c ON s.relname = c.relname
where s.n_dead_tup > (current_setting('autovacuum_vacuum_threshold')::int
+ (current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples));
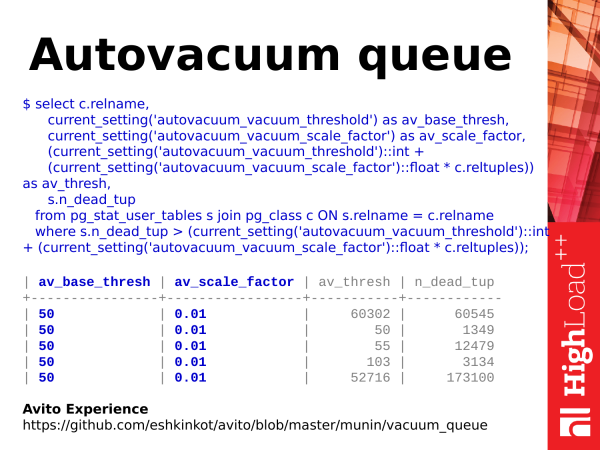
Vendar pa je tukaj en vidik. Osnovni pragovi parametrov av_base_thresh in av_scale_factor se lahko določijo individualno. Tako bo prag ne globalen, temveč individualen za tabelo. Zato je za izračun potrebno uporabiti nekatera opravila in trike. Če vas zanima, si lahko ogledate izkušnje naših kolegov iz Avita (povezava na diapozitivu je neveljavna in je bila posodobljena v besedilu).
Napisali so za , ki upošteva te stvari. Tam je dokumentacija dolga dva lista. A računa pravilno in precej učinkovito omogoča oceno, kje imamo veliko praznine, potrebne za tabele, kje pa malo.
Kaj lahko s tem storimo? Če imamo veliko vrsto in avto-vakuum ne obvladuje, lahko povečamo število delavcev vakuuma ali pa ga preprosto naredimo bolj agresivnega, da se sproži prej in obdeluje tabelo v manjših kosih. S tem se bo vrsta zmanjšala. — Najpomembneje je tukaj spremljati obremenitev diskov, saj je vakuum stvar, ki ni brezplačna, čeprav je s pojavom SSD/NVMe naprav težava postala manj opazna.
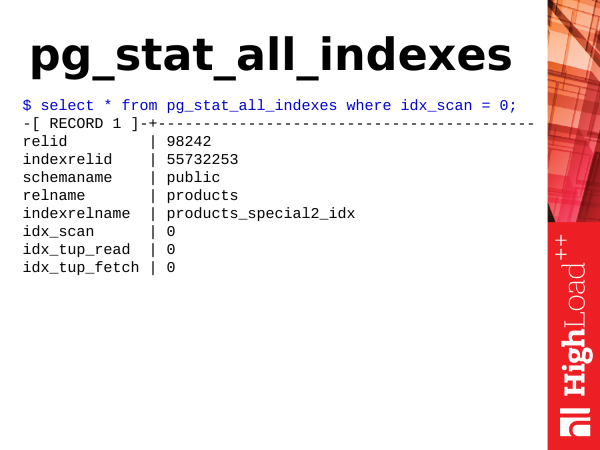
Pg_stat_all_indexes – to so statistike o indeksih. Je majhna. In po njej lahko pridobimo informacije o uporabi indeksov. Na primer, lahko določimo, kateri indeksi so odveč.
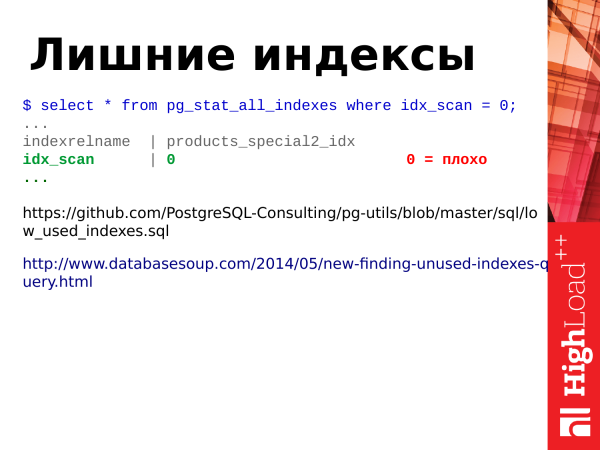
Kot sem že rekel, update – to ni samo posodabljanje tabel, še zlasti tudi posodabljanje indeksov. Tako, če imamo na tabeli veliko indeksov, je pri posodabljanju vrstic v tabeli tudi potrebno posodobiti indekse indeksiranih polj, in če imamo neuporabljene indekse, za katere ni indeksnih pregledov, za nas predstavljajo breme. In z njimi se je treba znebiti. Za to potrebujemo polje idx_scan. Preprosto pogledamo število indeksnih pregledov. Če imajo indeksi nič pregledov v relativno dolgo obdobje shranjevanja statistike (vsaj 2-3 tedne), potem so verjetno to slabi indeksi, katerih se moramo znebiti.
Opomba: Pri iskanju neuporabljenih indeksov v primeru klasterjev toka replikacije je treba preveriti vse vozlišča v clustru, saj statistika ni globalna, in če se indeks ne uporablja na glavnem strežniku, se lahko uporablja na replikah (če tam pride do obremenitve).
Dve povezavi:
To so bolj napredni primeri poizvedb za to, kako iskati neuporabljene indekse.
Druga povezava je precej zanimiv poizvedba. V njej je vgrajena zelo nenavadna logika. Priporočam, da jo preberete.
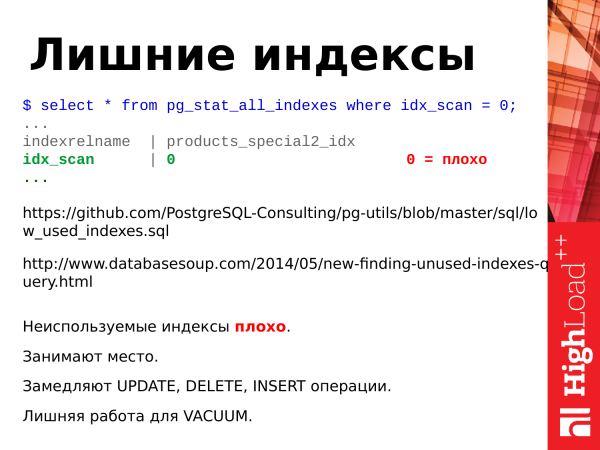
Kaj še povzamemo o indeksih?
Neporabljeni indeksi so slabi.
Zasedajo prostor.
Upočasnijo operacije posodabljanja.
Dodatno delo za vakuum.
Če odstranimo neporabljene indekse, bomo le izboljšali podatkovno bazo.
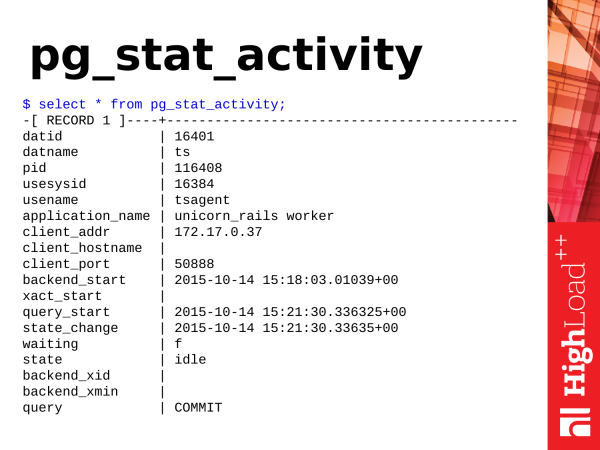
Naslednja predstavitev je pg_stat_activity. To je analog orodja ps, le v PostgreSQL. Če pss tem gledate procese v operacijskem sistemu, vam pg_stat_activity prikaže aktivnost znotraj PostgreSQL.
Kaj koristnega lahko od tam pridobimo?
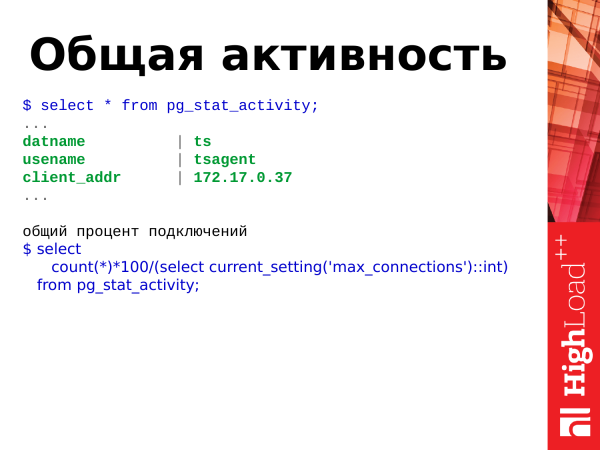
select
count(*)*100/(select current_setting('max_connections')::int)
from pg_stat_activity;
Lahko si ogledamo skupno aktivnost, kaj se dogaja v bazi. Lahko izvedemo novo namestitev. Tam smo imeli vse eksplodiralo, novi povezavi se ne sprejemajo, napake padajo v aplikaciji.
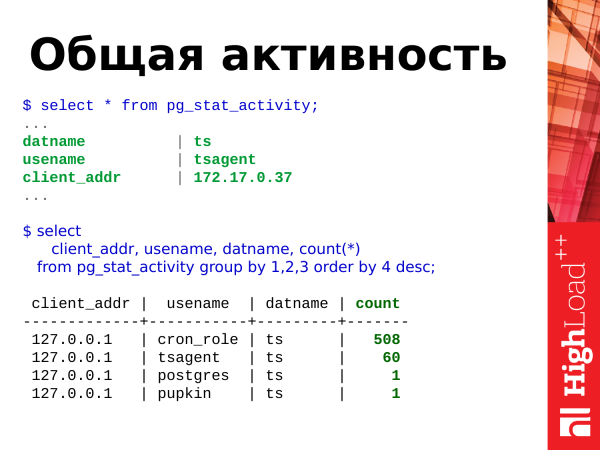
select
client_addr, usename, datname, count(*)
from pg_stat_activity group by 1,2,3 order by 4 desc;
Lahko izvedemo takšno poizvedbo in si ogledamo skupni odstotek povezav v razmerju do maksimalne omejitve povezav ter vidimo, kdo zaseda največ povezav. In v tem primeru vidimo, da je uporabnik cron_role odprl 508 povezav. In nekaj se je zgodilo z njim. Treba se je z njim ukvarjati in verjetno je, da gre za anomalno število povezav.
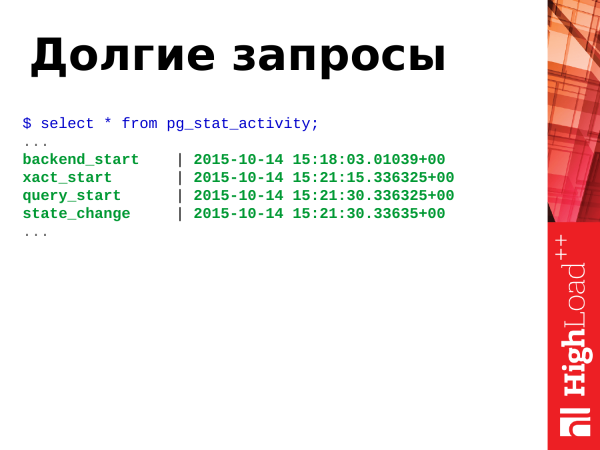
Če imamo OLTP obremenitev, naj bi se poizvedbe izvajale hitro, zelo hitro in ne sme biti dolgih poizvedb. Vendar, če se pojavijo dolge poizvedbe, to v kratkoročnem smislu ni nič hudega, vendar v dolgoročnem smislu dolge poizvedbe škodujejo bazi, povečujejo učinek bloat tabel, ko pride do fragmentacije tabel. Treba se je znebiti tako bloat kot dolgih poizvedb.
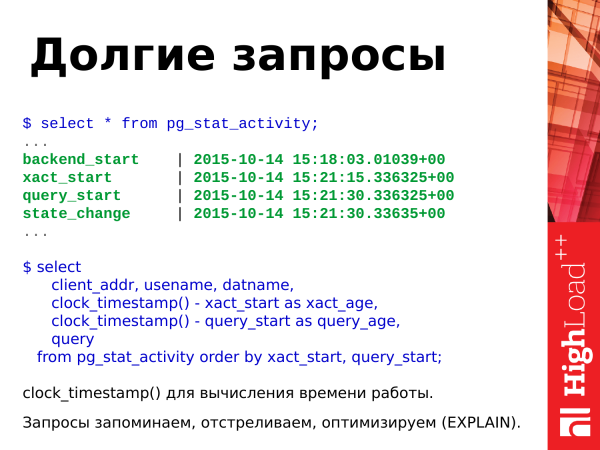
select
client_addr, usename, datname,
clock_timestamp() - xact_start as xact_age,
clock_timestamp() - query_start as query_age,
query
from pg_stat_activity order by xact_start, query_start;
Upoštevajte: s to poizvedbo lahko določimo dolge poizvedbe in transakcije. Uporabljamo funkcijo clock_timestamp() za določanje časa delovanja. Dolge poizvedbe, ki smo jih našli, lahko zapomnimo in izvedemo explain, si ogledamo načrte in kako jih optimizirati. Trenutne dolge poizvedbe ustavimo in živimo dalje.
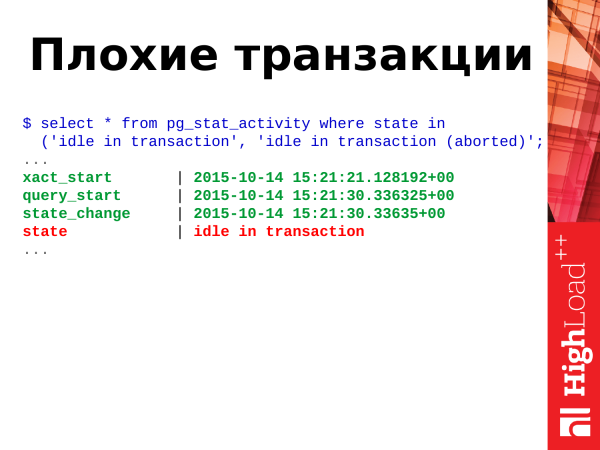
select * from pg_stat_activity where state in
('idle in transaction', 'idle in transaction (aborted)';
Slabe transakcije so transakcije v stanju idle in transaction ter idle in transaction (aborted).
Kaj to pomeni? Transakcije imajo več stanj. In eno od teh stanj lahko prevzamejo v vsakem trenutku. Za določanje stanj imamo polje state v tej predstavitvi. In to uporabljamo za določanje stanja.
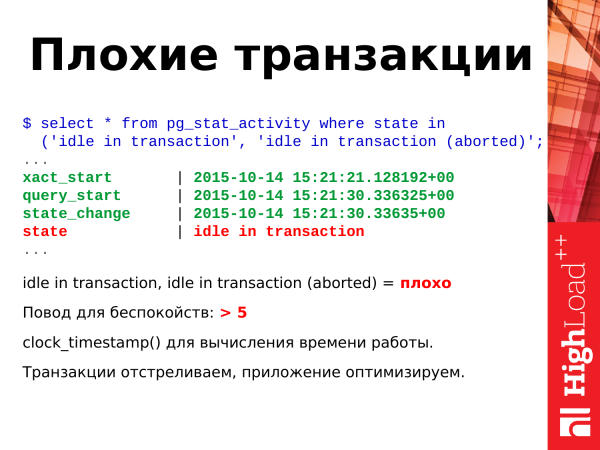
select * from pg_stat_activity where state in
('idle in transaction', 'idle in transaction (aborted)';
In, kot sem že omenil zgoraj, sta ti dve stanji idle in transaction in idle in transaction (aborted) – to je slabo. Kaj je to? To je, ko aplikacija odpre transakcijo, izvede nekaj dejanj in se odmakne. Transakcija ostane odprta. Ovisi, v njej se nič ne dogaja, prevzema povezavo, zaklepa spremenjene vrstice in potencialno še povečuje bloat drugih tabel, zaradi arhitekture transakcijskega motorja Postgres. Takšne transakcije je prav tako treba ustreliti, ker so na splošno škodljive, ne glede na okoliščine.
Če vidite, da jih imate v bazi več kot 5-10-20, morate biti že zaskrbljeni in začeti nekaj storiti.
Tu prav tako za čas izračuna uporabljamo clock_timestamp(). Transakcije ustrelimo, aplikacijo optimiziramo.
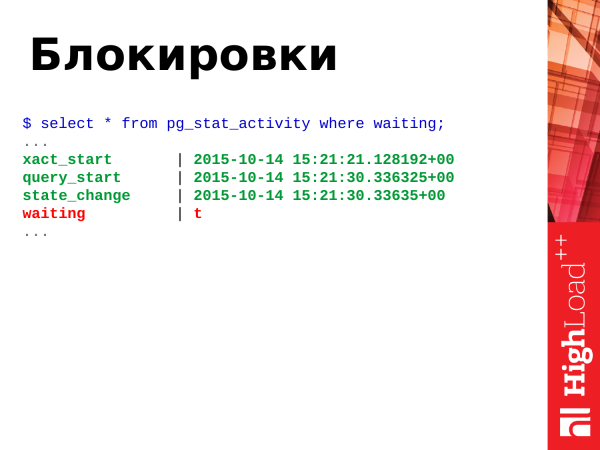
Kot sem že omenil zgoraj, so zaklepi – to je, ko se dve ali več transakcij borita za eno ali skupino virov. Za to imamo polje waiting z logično vrednostjo true ili false.
True – to pomeni, da proces čaka, nekaj je treba storiti. Ko proces čaka, to pomeni, da tudi stranka, ki je inicializirala ta proces, čaka. Stranka v brskalniku sedi in prav tako čaka.
Attention: _Začenši z različico Postgres 9.6 je polje waiting odstranjeno in namesto njega sta dodani dve bolj informativni polji wait_event_type in wait_event._
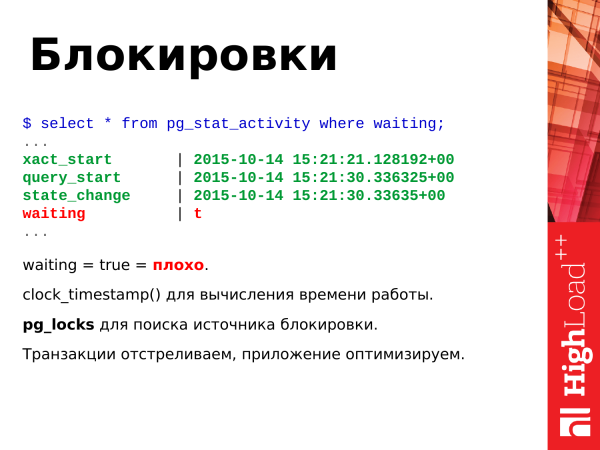
Kaj narediti? Če vidite true, že dolgo časa, to pomeni, da se je treba znebiti takih poizvedb. Preprosto takšne transakcije ustrelimo. Razvijalcem pišemo, da je treba optimizirati, da ne bi prišlo do tekmovanja za vire. In nato razvijalci optimizirajo aplikacijo, da se to več ne pojavlja.
In končni, a potencialno ne usoden primer – to je pojav deadlockov. Dve transakciji sta posodobili dva vira, nato pa se ponovno obrnejo na njih, že k nasprotni vir. PostgreSQL v tem primeru vzame in sam ustreli transakcijo, da lahko druga nadaljuje z delom. To je brezizhodna situacija in se sama ne razreši. Zato mora PostgreSQL sprejeti skrajne ukrepe.
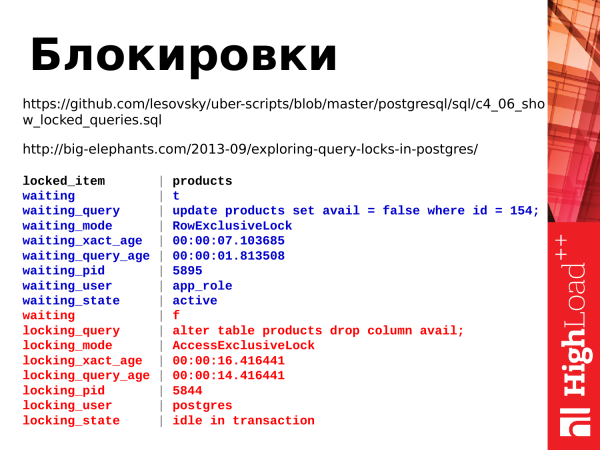
In tu sta dva poizvedba, ki omogočata sledenje zaklepanju. Uporabljamo predstavitev pg_locks, ki omogoča sledenje težkim zaklepom.
Prva povezava je sam besedilo poizvedbe. Kar precej dolga je.
In druga povezava je članek o zaklepih. Koristno je prebrati, zelo zanimivo je.
Torej, kaj vidimo? Vidimo dve poizvedbi. Transakcija z ALTER TABLE – to je zaklepajoča transakcija. Začela se je, a se ni končala, aplikacija, ki je sprožila to transakcijo, se nekje ukvarja z drugimi nalogami. Druga poizvedba je update. Čaka, da se alter table konča, da bi lahko nadaljevala z delom.
Tako lahko ugotovimo, kdo koga zaklepa, kdo drži in se lahko nadalje ukvarjamo s tem.
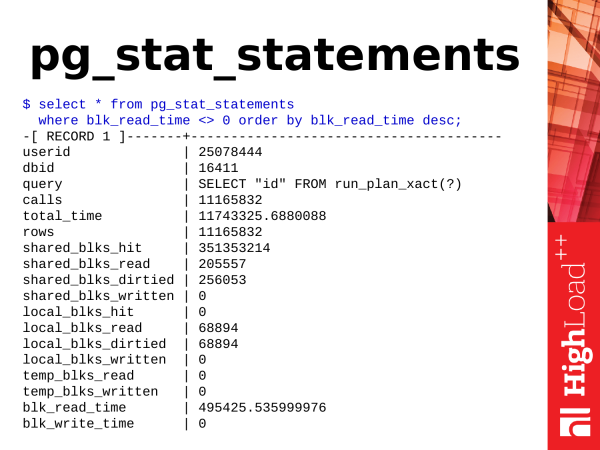
Naslednji modul je pg_stat_statements. Kot sem že omenil, to je modul. Da bi ga uporabili, je treba naložiti njegovo knjižnico v konfiguracijo, znova zagnati PostgreSQL, namestiti modul (z eno ukazno) in nato bomo dobili nov pogled.
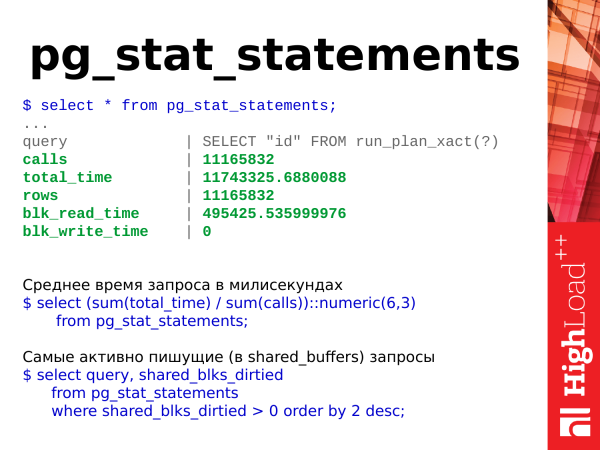
Povprečni čas poizvedbe v milisekundah
$ select (sum(total_time) / sum(calls))::numeric(6,3)
from pg_stat_statements;

Najbolj aktivne zapisne (v shared_buffers) poizvedbe
$ select query, shared_blks_dirtied
from pg_stat_statements
where shared_blks_dirtied > 0 order by 2 desc;
Kaj lahko vzamemo od tam? Če govorimo o preprostih stvareh, lahko vzamemo povprečni čas izvedbe poizvedbe. Čas narašča, to pomeni, da PostgreSQL odgovarja počasi in je treba nekaj ukreniti.
Lahko pogledamo najbolj aktivne zapisne transakcije v podatkovni bazi, ki spreminjajo podatke v shared buffers. Poglejmo, kdo posodablja ali briše podatke.
In lahko preprosto pogledamo različno statistiko o teh poizvedbah.
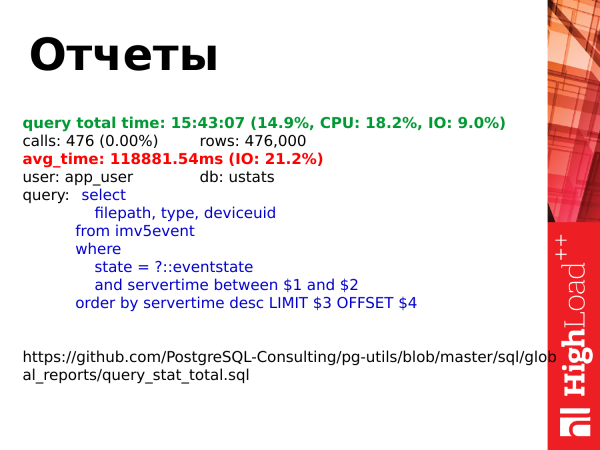
Mi pg_stat_statements uporabljamo za pripravo poročil. Statistiko ponastavimo enkrat na dan. Jo nabiramo. Pred ponastavitvijo statistike naslednjič, pripravimo poročilo. Tukaj je povezava do poročila. Lahko ga pogledate.
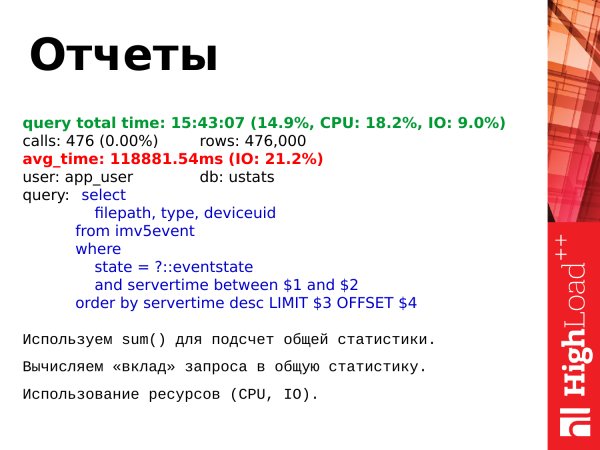
Kaj delamo? Štejemo skupno statistiko za vse poizvedbe. Nato za vsako poizvedbo izračunamo njen individualni prispevek k tej skupni statistiki.
In kaj lahko pogledamo? Lahko pogledamo skupni čas izvajanja vseh poizvedb določenega tipa v primerjavi z vsemi drugimi poizvedbami. Lahko pogledamo uporabo procesorja in vhodno-izhodnih virov glede na celotno sliko. In že optimiziramo te poizvedbe. Pripravljamo top poizvedbe po tem poročilu in že pridobimo snov za razmislek, kaj optimizirati.
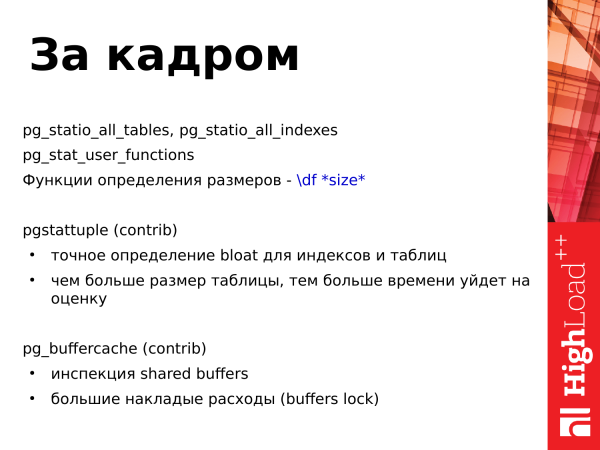
Kaj nam je ostalo za kulisami? Ostalo je še nekaj predstavitev, katerih nisem obravnaval, ker je čas omejen.
Je pgstattuple – to je še en dodatni modul iz standardnega paketa contrib. Omogoča oceno bloat tabele, t. i. fragmentacijo tabele. In če je fragmentacija velika, jo je treba odstraniti, uporabiti različna orodja. In funkcija pgstattuple traja dolgo. In čim več tabel je, tem dlje bo trajala.
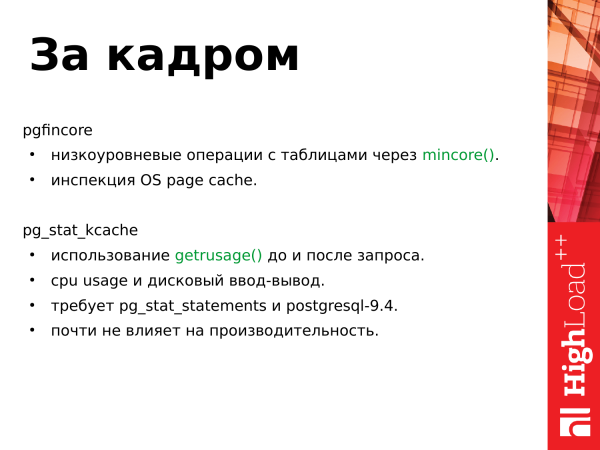
Naslednji contrib je pg_buffercache. Omogoča inšpekcijo deljenih podatkovnih predpomnilnikov: kako intenzivno in za katere tabele se uporabljajo strani predpomnilnika. In preprosto omogoča vpogled v deljene podatkovne predpomnilnike in oceno, kaj se tam dogaja.
Naslednji modul je pgfincore. Omogoča izvajanje nizko-nivojskih operacij s tabelami preko sistemskega klica mincore(), to je, omogoča nalaganje tabele v deljene podatkovne predpomnilnike ali njeno praznjenje. In omogoča poleg drugega tudi inšpekcijo strani predpomnilnika operacijskega sistema, to je, koliko prostora zavzema tabela v cache-u strani, v deljenih podatkovnih predpomnilnikih in preprosto omogoča oceno obremenitve tabele.
Naslednji modul je pg_stat_kcache. Uporablja tudi sistemski klic getrusage(). In ga izvaja pred in po izvajanju poizvedbe. In v pridobljeni statistiki omogoča oceno, koliko časa je naša poizvedba porabila za izvajanje diskovnih vhodov-izhodov, to je, operacij s sistemom datotek in gleda uporabo procesorja. Vendar je modul nov (ahem-ahem) in za svoje delovanje zahteva PostgreSQL 9.4 in pg_stat_statements, o katerem sem prej govoril.
Obvladovanje statistike je koristno. Niste potrebni zunanjih programov. Lahko sami pogledate, kaj lahko storite, izvedete.
Uporaba statistike ni težka, je navaden SQL. Zbrali ste poizvedbo, jo sestavili, poslali, pogledali.
Statistika pomaga odgovoriti na vprašanja. Če imate vprašanja, se obrnite na statistiko – poglejte, naredite zaključke, analizirate rezultate.
In eksperimentirajte. Poizvedb je veliko, podatkov je veliko. Vedno je mogoče optimizirati kakšno že obstoječo poizvedbo. Lahko naredite svojo različico poizvedbe, ki vam bolj ustreza kot izvirnik, in jo uporabite.
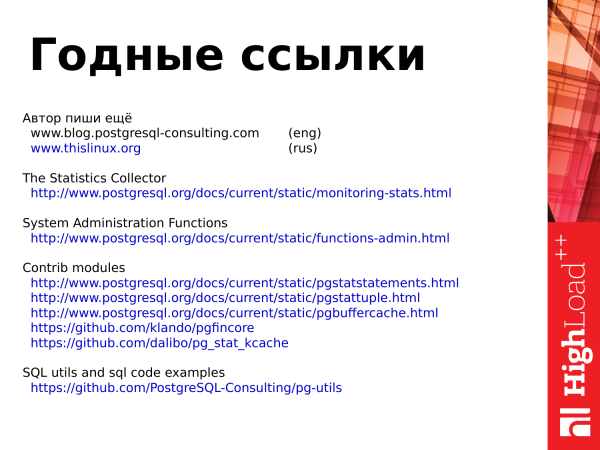
Povezave
Ustrezne povezave, ki so se pojavile v članku, na podlagi katerega je bil narejen referat.
Avtor piše še
(eng)
Zbiralec statistik
Funkcije sistemskega upravljanja
Dodatni moduli
SQL orodja in primeri SQL kode
Hvala vsem za pozornost!
Izvor: habr.com
