

Vedno me je zanimalo, kako bolje razporediti knjige v svoji elektronski knjižnici. Na koncu sem prišel do rešitve z avtomatskim štetjem strani in drugimi dodatnimi funkcijami. Vse zainteresirane prosim, da preberejo naprej.
Del 1. Dropbox
Vse knjige imam shranjene v Dropboxu. Ustvaril sem 4 kategorije, v katere sem vse razdelil: Učbeniki, Priročniki, Leposlovje, Ne-leposlovje. Priročnikov pa ne dodajam v tabelo.
Večina knjig je v .epub formatu, preostale so .pdf. To pomeni, da mora končna rešitev pokrivati oba formata.
Pot do knjig imam približno takšne:
/Книги/Нехудожественное/Новое/Дизайн/Юрий Гордон/Книга про буквы от А до Я.epub Če je knjiga leposlovna, se kategorija (torej 'Dizajn' v zgornjem primeru) odstrani.
Odločil sem se, da se ne bom ukvarjal z API-jem Dropboxa, ker imam njihove aplikacije, ki sinhronizirajo mapo. Torej, načrt je tak: vzamemo knjige iz mape, vsako knjigo pregleda število besed in dodamo v Notion.
Del 2. Dodajanje vrstice
Tabela bi morala izgledati približno takole. POZOR: imena stolpcev je bolje narediti v latinici.
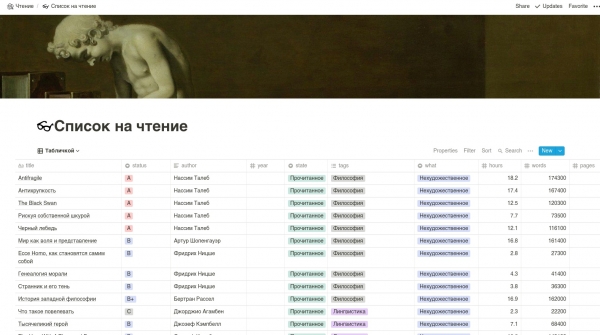
Uporabljali bomo neformalni API Notion, ker uradnega še niso izdal.

Pojdimo v Notion, pritisnemo Ctrl + Shift + J, gremo v Application -> Cookies, kopiramo token_v2 in ga poimenujemo TOKEN. Nato gremo na potrebno stran s tabelo knjižnice in kopiramo povezavo. Poimenujemo NOTION.
Potem napišemo kodo za povezavo z Notion.
database = client.get_collection_view(NOTION)
current_rows = database.default_query().execute()
Nato bomo napisali funkcijo za dodajanje vrstice v tabelo.
def add_row(path, file, words_count, pages_count, hours):
    row = database.collection.add_row()
    row.title = file

    tags = path.split("/")

    if len(tags) >= 1:
        row.what = tags[0]

    if len(tags) >= 2:
        row.state = tags[1]

    if len(tags) >= 3:
        if tags[0] == "Leposlovje":
            row.author = tags[2]

        elif tags[0] == "Ne-leposlovje":
            row.tags = tags[2]

        elif tags[0] == "Učbeniki":
            row.tags = tags[2]

    if len(tags) >= 4:
        row.author = tags[3]

    row.hours = hours
    row.pages = pages_count
    row.words = words_count
Kaj se tukaj dogaja. Vzamemo in dodamo novo vrstico v tabelo v prvi vrstici. Nato delimo našo pot po '/' in dobimo oznake. Oznake so v smislu 'Leposlovje', 'Dizajn', kdo je avtor in tako naprej. Nato določimo vsa zahtevana polja tabele.
Del 3. Številimo besede, ure in druge zanimivosti
To je že zahtevnejša naloga. Kot se spomnimo, imamo dva formata: ePub in PDF. Če je pri ePubu vse jasno — besede so verjetno tam, pri PDF pa ni nujno, da je tako: lahko je sestavljen samo iz povezanih slik.
Tako bo funkcija za štetje besed v PDF izgledala takole: vzamemo število strani in pomnožimo s določenim konstanto (povprečno število besed na strani).
Tukaj je:
def get_words_count(pages_number):
    return pages_number * WORDS_PER_PAGE
Vrednost WORDS_PER_PAGE za A4 stran je približno 300.
Zdaj pa napišimo funkcijo za štetje strani. Uporabili bomo .
def get_pdf_pages_number(path, filename):
    pdf = PdfFileReader(open(os.path.join(path, filename), 'rb'))
    return pdf.getNumPages()
Nato bomo napisali delček za štetje strani v ePub. Uporabili bomo . Tukaj vzamemo knjigo, jo pretvorimo v vrstice in za vsako vrstico preštejemo besede.
def get_epub_pages_number(path, filename):
    book = open_book(os.path.join(path, filename))
    lines = convert_epub_to_lines(book)
    words_count = 0

    for line in lines:
        words_count += len(line.split(" "))

    return round(words_count / WORDS_PER_PAGE)
Zdaj pa bomo izračunali čas branja. Vzamemo naše priljubljeno število besed in delimo s hitrostjo branja.
def get_reading_time(words_count):
    return round(((words_count / WORDS_PER_MINUTE) / 60) * 10) / 10
Del 4. Združevanje vseh delov
Moramo preiti vse možne poti v naši mapi z knjigami. Preveriti, ali je knjiga že v Notion: če je, vrstice ni treba ustvarjati.
Nato moramo določiti tip datoteke, na podlagi tega prešteti število besed. Na koncu dodamo knjigo.
Tukaj je koda, ki jo dobimo:
for root, subdirs, files in os.walk(BOOKS_DIR):
    if len(files) > 0 and check_for_excusion(root):
        for file in files:
            array = file.split(".")
            filetype = file.split(".")[len(array) - 1]
            filename = file.replace("." + filetype, "")
            local_root = root.replace(BOOKS_DIR, "")

            print("Dir: {}, file: {}".format(local_root, file))

            if not check_for_existence(filename):
                print("Dir: {}, file: {}".format(local_root, file))

                if filetype == "pdf":
                    count = get_pdf_pages_number(root, file)

                else:
                    count = get_epub_pages_number(root, file)

                words_count = get_words_count(count)
                hours = get_reading_time(words_count)
                print("Pages: {}, Words: {}, Hours: {}".format(count, words_count, hours))
                add_row(local_root, filename, words_count, count, hours)
Funkcija za preverjanje, ali je knjiga dodana, izgleda tako:
def check_for_existence(filename):
    for row in current_rows:
        if row.title in filename:
            return True

        elif filename in row.title:
            return True

    return False
Zaključek
Hvala svima koji su pročitali ovaj članak. Nadam se da će vam pomoći da čitate više 🙂
Izvor: habr.com
