

Pozdravljeni vsi! Ime mi je Pavel Agaletki. Delam kot vodja ekipe, ki razvija sistem dostave Lamoda. Leta 2018 sem nastopil na konferenci HighLoad++, danes pa želim predstaviti transkripcijo svojega predavanja.
Moja tema se osredotoča na izkušnje naše podjetja pri uvajanju sistemov in storitev v različna okolja. Začeli smo v naših zgodovinskih časih, ko smo vse sisteme uvajali na navadne virtualne strežnike, in končali s postopnim prehodom od Nomada do uvajanja v Kubernetes. Povedal bom, zakaj smo to storili in s kakšnimi težavami smo se srečali v postopku.

Uvajanje aplikacij na VM
Začnimo s tem, da so pred 3 leti vsi sistemi in storitve podjetja uvajali na navadne virtualne strežnike. Tehnično je bilo organizirano tako, da je bil celoten kodo naših sistemov shranjen in sestavljen s pomočjo avtomatiziranega zbiranja preko Jenkins. S pomočjo Ansible se je ta koda iz našega sistema za nadzor različic prenesla na virtualne strežnike. Vsak sistem v našem podjetju se je uvajal na vsaj 2 strežnika: eden je bil head, drugi pa tail. Ta dva sistema sta bila med seboj povsem enaka po vseh nastavitvah, zmogljivosti, konfiguraciji in drugem. Razlika med njima je bila le ta, da je head prejemal uporabniški promet, medtem ko tail nikoli ni prejemal prometa uporabnikov.
Zakaj je bilo to narejeno?
Ko smo uvajali nove različice naše aplikacije, smo želeli zagotoviti možnost brezšivnega uvajanja, torej brez opaznih posledic za uporabnike. To smo dosegli tako, da se je nova zgrajena različica s pomočjo Ansible prenesla na tail. Tam so ljudje, ki so se ukvarjali z uvajanjem, lahko preverili in se prepričali, da je vse v redu: vse metrike, razdelki in aplikacije delujejo; zagnani so potrebni skripti. Šele potem, ko so se prepričali, da je vse v redu, se je promet preusmeril. Začel se je usmerjati na tisti strežnik, ki je bil prej tail. Tisti, ki je bil prej head, pa je ostal brez uporabniškega prometa, vendar z obstoječo prejšnjo različico naše aplikacije.
Tako so uporabnikom omogočili neprekinjeno izkušnjo. Preklop se zgodi takoj, saj gre preprosto za preklop balancerja. Zelo enostavno se lahko vrnete na prejšnjo različico, tako da preklopite balancer nazaj. Prav tako smo lahko preverili zmogljivost aplikacije v produkciji še pred prihodom uporabniškega prometa, kar je bilo zelo priročno.
Kakšne prednosti smo videli v vsem tem?
- Predvsem to je zadostno enostavno deluje. Vsem je jasno, kako deluje taka shema uvajanja, ker je večina ljudi kdaj koli izvajala uvajanje na običajne virtualne strežnike.
- To je zadostno zanesljivo, saj je tehnologija uvajanja preprosta in jo je preizkusilo na tisoče podjetij. Milijoni strežnikov se uvajajo na ta način. Težko je kaj pokvariti.
- In končno, lahko smo dobili atomska uvajanja. Uvajanja, ki se za uporabnike zgodijo takoj, brez opaznega preklapljanja med staro in novo različico.
Toda v vsem tem smo prav tako opazili nekaj slabosti:
- Poleg produkcijskega okolja in okolja za razvoj obstajajo tudi druga okolja. Na primer, qa in predprodukcija. Takrat smo imeli veliko strežnikov in približno 60 storitev. Zaradi tega smo morali za vsako storitev ohranjati ustrezno različico virtualnega stroja. Če želite posodobiti knjižnice ali namestiti nove odvisnosti, to morate narediti v vseh okoljih. Prav tako je treba sinhronizirati čas, ko nameravate uvajati novo različico vaše aplikacije, s časom, ko devops izvede potrebne nastavitve okolja. V tem primeru je zlahka priti v situacijo, kjer se okolje nekoliko razlikuje v vseh okoljih zaporedoma. Na primer, v okolju QA bodo različne različice knjižnic, v produkciji pa druge, kar lahko povzroči težave.
- Zapletenost pri posodabljanju odvisnosti vaše aplikacije. To ne gre od vas, temveč od druge ekipe. Natančneje, ekipe devops, ki vzdržuje strežnike. Morate jim postaviti ustrezno nalogo in dati opis, kaj želite storiti.
- Takrat smo tudi želeli razdeliti velike monolite, ki smo jih imeli, na posamezne majhne storitve, saj smo razumeli, da jih bo vedno več. Takrat smo jih imeli že več kot 100. Za vsako novo storitev je bilo potrebno ustvariti novo virtualno napravo, ki jo je bilo treba vzdrževati in implementirati. Poleg tega potrebujemo več kot eno napravo, vsaj dve. Vse skupaj se še dodaja QA okolje. To povzroča težave in otežuje ustvarjanje in zagon novih sistemov. To je zapleten, drag in dolgotrajen postopek.
Zato smo se odločili, da bo bolj priročno preiti z uvajanja običajnih virtualnih naprav na uvajanje naših aplikacij v Docker vsebniku. Pri uporabi Dockera potrebujemo sistem, ki lahko zažene aplikacijo v grozdu, saj le tako ne morete preprosto zagnati vsebnika. Običajno želimo spremljati, koliko vsebnikov je aktiviranih, da se lahko samodejno zaženejo. Iz tega razloga smo potrebovali sistem za upravljanje.
Dolgo smo razmišljali, katero izmed njih izbrati. V tistem trenutku je bil naš sistem uvajanja na običajne virtualne strežnike nekoliko zastaran, saj so tam bile starejše različice operacijskih sistemov. V nekem trenutku je bila celo FreeBSD, ki je bila težko vzdrževati. Zavedali smo se, da moramo čim prej migrirati v Docker. Naši DevOps strokovnjaki so proučili svoje izkušnje z različnimi rešitvami in izbrali sistem Nomad.
Prehod na Nomad
Nomad je izdelek podjetja HashiCorp. Znani so tudi po svojih drugih rešitvah:
„Consul“ — to je orodje za odkrivanje storitev.
„Terraform“ — sistem za upravljanje strežnikov, ki vam omogoča, da jih konfigurirate prek infrastrukture kot kode.
„Vagrant“ omogoča pritrditev virtualnih naprav lokalno ali v oblaku s pomočjo določenih konfiguracijskih datotek.
Nomad se je tisti trenutek zdel dovolj preprost sistem, na katerega bi se lahko hitro preusmerili brez spremembe celotne infrastrukture. Prav tako je precej enostaven za obvladovanje. Zato smo ga izbrali kot sistem za filtriranje našega vsebnika.
Kaj potrebujete za uvajanje vašega sistema v Nomad?
- Najprej potrebujete docker sliko vašega aplikacije. Potrebno jo je zbrati in shraniti v shranjevanje slik Docker. V našem primeru je to artifactory — takšna sistem, ki omogoča nalaganje različnih artefaktov različnih tipov. Shranjuje lahko arhive, slike Docker, pakete Composer PHP, NPM pakete itd.
- Poleg tega je potrebno konfiguracijska datoteka, ki bo povedala Nomadu, kaj, kam in v kakšni količini želite implementirati.
Ko govorimo o Nomadu, kot format informacijskega dokumenta uporablja jezik HCL, kar pomeni HashiCorp Configuration Language. To je nadmnožica YAML, ki vam omogoča, da opišete svojo storitev v izrazih Nomada.
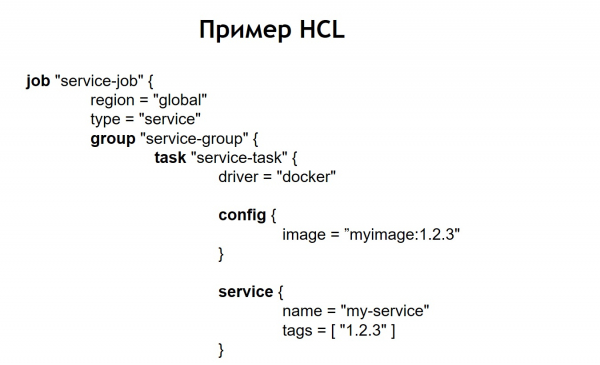
Omogoča vam, da določite, koliko vsebnikov želite implementirati, iz katerih slik jih želite prenesti ter različne parametre pri implementaciji. Tako posredujete to datoteko Nomadu, on pa sproži vsebnike v produkciji v skladu z njo.
V našem primeru smo ugotovili, da bi bilo nepraktično pisati enake identične HCL datoteke za vsako storitev, saj imamo veliko storitev in jih občasno želimo posodobiti. Zgodi se, da ena storitev ni implementirana v eni kopiji, temveč v različnih. Na primer, enega od sistemov, ki ga imamo v produkciji, upravlja več kot 100 instanc v produkciji. Ti se zagnajo iz istih slik, vendar se razlikujejo po konfiguracijskih nastavitvah in konfiguracijskih datotekah.
Zato smo se odločili, da bo priročno shraniti vse naše konfiguracijske datoteke za implementacijo v enem skupnem repozitoriju. Tako so postale pregledne: lahko jih je bilo enostavno vzdrževati in videli smo, kateri sistemi imamo. V primeru potrebe je tudi enostavno kar koli posodobiti ali spremeniti. Dodati nov sistem tudi ne bo težko — dovolj je le ustvariti konfiguracijsko datoteko znotraj nove mape. Znotraj nje se nahajajo datoteke: service.hcl, ki vsebuje opis naše storitve, in nekatere env-datoteke, ki omogočajo, da to storitev ob implementaciji v produkcijo ustrezno nastavite.
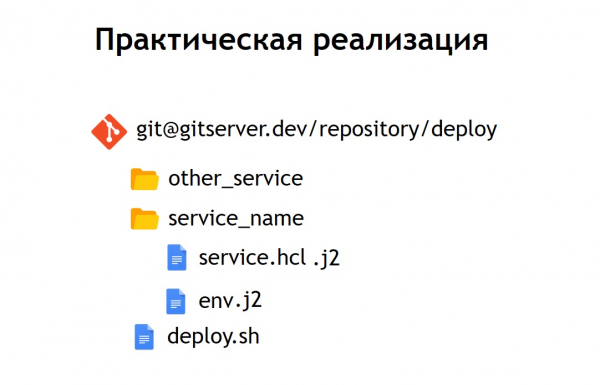
Vendar so nekatere naše storitve implementirane v produkciji ne v eni kopiji, temveč hkrati v več. Zato smo se odločili, da bo praktično shraniti ne konfiguracije v čisti obliki, ampak njihov šabloniziran videz. Kot jezik za šablonizacijo smo izbrali jinja 2. V tem formatu imamo shranjene tako konfiguracije same storitve kot tudi env-datoteke, ki jih potrebuje.
Poleg tega smo v repozitorij dodali skupen skript za namestitev, ki omogoča zagon in namestitev vaše storitve v produkcijo, v ustrezen okolje in cilj. Ko smo naš HCL-config pretvorili v predlogo, je ta HCL-datoteka, ki je prej bila običajen Nomad config, v tem primeru izgledala nekoliko drugače.
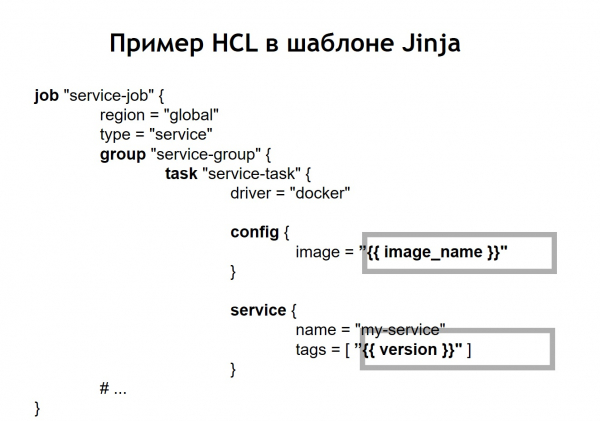
To pomeni, da smo nekaj mest v konfiguraciji zamenjali z variablami, ki jih dobimo iz env-datotek ali drugih virov. Poleg tega smo pridobili možnost dinamičnega sestavljanja HCL-datotek, torej lahko uporabljamo ne le običajne vstavke variabl. Ker jinja podpira zanke in pogoje, lahko tam oblikujemo konfiguracijske datoteke, ki se spreminjajo glede na to, kam dejansko nameščate svoje aplikacije.
Na primer, želite namestiti svojo storitev v preprodukcijo in v produkcijo. Recimo, da v preprodukciji ne želite zagnati cron-skriptov, ampak preprosto želite videti storitev na ločeni domeni, da se prepričate, da deluje. Za kogarkoli, ki namesti storitev, je postopek zelo enostaven in pregleden. Zadostuje, da izvedete datoteko deploy.sh, navedete, katero storitev želite namestiti in v kateri cilj. Na primer, če želite namestiti neko sistem v Rusijo, Belorusijo ali Kazahstan. Za to je dovolj, da spremenite enega od parametrov, in pravilna konfiguracijska datoteka se bo sestavila.
Ko je storitev Nomad že nameščena v vašem klastru, izgleda takole.
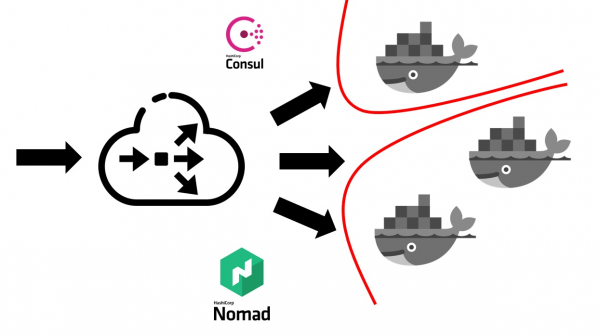
Najprej potrebujete nek zunanji uravnoteževalec, ki bo sprejemal ves uporabniški promet. Deloval bo skupaj s Consulom in od njega pridobil informacijo o tem, kje, na katerem vozlišču in po kakšnem IP adresom se nahaja določena storitev, ki ustreza določenemu imenu domene. Storitve v Consulu se pojavijo iz samega Nomada. Ker gre za izdelke iste podjetja, so dobro povezani med seboj. Lahko bi rekli, da Nomad privzeto zna registrirati vse storitve, ki jih zažene, znotraj Consula.
Ko se vaš zunanji balansirnik nauči, kam je treba usmeriti promet, ga preusmeri v ustrezen zabojnik ali več zabojnikov, ki ustrezajo vaši aplikaciji. Seveda je treba pri tem razmišljati tudi o varnosti. Tudi če se vsi storitve izvajajo na istih virtualnih strojih v zabojnikih, je običajno potrebno prepovedati prost dostop katere koli storitve do katere koli druge. To smo dosegli s segmentacijo. Vsaka storitev je bila izvajana v svoji virtualni mreži, na kateri so bile določene smernice za usmerjanje in pravila za dovoljenje/ prepoved dostopa do drugih sistemov in storitev. Teh sistemov in storitev je lahko bilo bodisi znotraj tega grozda bodisi zunaj njega. Na primer, če želite prepovedati storitvi povezovanje z določeno bazo podatkov, to lahko storite preko segmentacije na ravni mreže. To pomeni, da se niti po pomoti ne morete povezati iz testnega okolja z vašo produkcijsko bazo.
Koliko človeških virov nas je stala ta preklop?
Prehod celotne družbe na Nomad je trajal približno 5-6 mesecev. Prehajali smo storitveno, vendar v dovolj hitrem tempu. Vsaka ekipa je morala ustvariti svoje lastne zabojnike za storitve.
Imamo sprejet tak pristop, da vsaka ekipa sama odgovarja za docker slike svojih sistemov. DevOps pa zagotavlja skupno infrastrukturo, potrebno za distribucijo, torej podporo samega grozda, podporo CI-sistemom in tako naprej. In v tistem trenutku je več kot 60 sistemov prešlo na Nomad, nastalo je okoli 2000 zabojnikov.
DevOps odgovarja za skupno infrastrukturo vsega, kar je povezano z distribucijo, s strežniki. Vsaka razvijalska ekipa pa je odgovorna za implementacijo zabojnikov za svoj specifični sistem, saj ekipa najbolje ve, kaj sploh potrebuje v tem ali onem zabojniku.
Razlogi za opustitev Nomada
Kakšne prednosti smo pridobili, ko smo prešli na distribucijo z Nomadom in dockerjem?
- Mi zagotovili enake pogoje za vse okolja. V razvoju, QA okolju, predprodukciji in produkciji se uporabljajo iste slike kontejnerjev z istimi odvisnostmi. Tako imate skoraj ni možnosti, da bi v produkciji prišlo nekaj drugega, kot ste prej testirali lokalno ali v testnem okolju.
- Prav tako smo ugotovili, da je dovolj enostavno dodati novo storitev. Katere koli nove sisteme z vidika namestitve je zelo enostavno zagnati. Zadošča, da greste v repozitorij, ki shranjuje konfiguracije, dodate nov konfiguracijski file za vaš sistem in vse je pripravljeno. Svojo storitev lahko namestite v produkcijo brez dodatnih naporov s strani DevOps.
- Vse konfiguracijske datoteke v enem skupnem repozitoriju so bile pregledane. V trenutku, ko smo nameščali naše sisteme z uporabo virtuálních serverů, smo uporabljali Ansible, v katerem so bile konfiguracije shranjene v istem repozitoriju. Vendar je bilo za večino razvijalcev delo s tem nekoliko bolj zapleteno. Obseg konfiguracij in kode, ki jo je bilo treba dodati za namestitev storitve, se je močno zmanjšal. Poleg tega je bilo za DevOps zelo enostavno popraviti ali spremeniti. V primeru prehodov, na primer, na novi različici Nomad, so lahko množično posodobili vse operativne datoteke, ki ležijo na istem mestu.
Soočili pa smo se tudi s številnimi pomanjkljivostmi:
Ugotovili smo, da nismo mogli doseči brezšivnosti namestitev v primeru Nomad. Pri uvajanju kontejnerjev iz različnih okolij se lahko zgodi, da je bil kontejner zagnan in ga je Nomad zaznal kot pripravljenega za sprejem prometa. To se je zgodilo še preden se je aplikacija znotraj njega uspela zagnati. Zaradi tega je sistem za kratek čas začel izdajati napake 500, ker je promet začel priti na kontejner, ki še ni bil pripravljen za njegovo sprejemanje.
Soočili smo se z nekaterimi napakami. Najsajtniji problem je u tome što Nomad nije baš dobro osmišljen za velike klastere, ako imate mnogo sistema i kontejnera. Kada želite da isključite jedan od servera koji je deo Nomad klastera, postoji prilično velika verovatnoća da će klaster reagovati loše i raspasti se. Deo kontejnera može, na primer, pasti i ne podići se – to će vam kasnije vrlo skupo koštati, ako su svi vaši sistemi u produkciji upravo u klasteru kojim upravlja Nomad.
Zato smo odlučili da razmislimo o tome kuda dalje. U tom trenutku smo postali mnogo svesniji onoga što želimo da postignemo. A to je: želimo pouzdanost, malo više funkcionalnosti nego što Nomad nudi, i zreliji, stabilniji sistem.
U tom smislu naš izbor je pao na Kubernetes kao najpopularniju platformu za pokretanje klastera. Pogotovo s obzirom na to da je veličina i broj naših kontejnera bio prilično veliki. Za te svrhe Kubernetes se pokazao kao najprikladniji sistem među onima koje smo mogli da razmotrimo.
Prelazak na Kubernetes
Malo ću govoriti o osnovnim pojmovima Kubernetes-a i kako se razlikuju od Nomad-a.
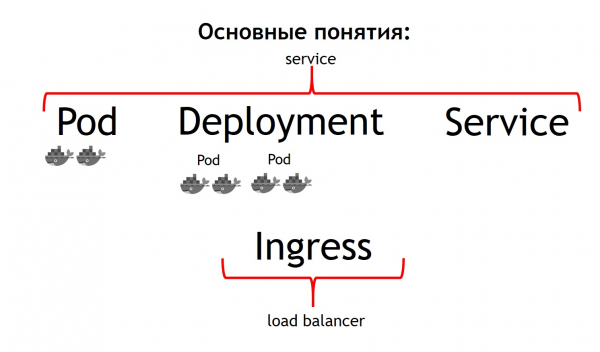
Pre svega, osnovni pojam u Kubernetes-u je pojam pod. Pod – to je grupa jednog ili više kontejnera koja se uvek pokreće zajedno. I rade kao da uvek strogo funkcionišu na jednoj virtuelnoj mašini. Dostupni su jedni drugima putem IP adrese 127.0.0.1 na različitim portovima.
Pretpostavimo da imate PHP aplikaciju koja se sastoji od nginx i php-fpm – klasična shema. Verovatno ćete želeti da i nginx i php-fpm kontejneri uvek budu zajedno. Kubernetes to omogućava opisivanjem njih kao jednog zajedničkog poda. To je upravo ono što nismo mogli postići uz pomoć Nomad-a.
Drugi pojam je deployment. Naime, pod sam po sebi je efemerna stvar, pokreće se i nestaje. Da li želite prvo da ubijete sve prethodne kontejnere, a zatim da odmah pokrenete nove verzije, ili želite da ih puštate postepeno – upravo za taj proces odgovara pojam deployment. On opisuje kako deploy-ujete svoje podele, u kojem broju i kako ih ažurirati.
Treći pojam je serviceVaš service je v bistvu vaš sistem, ki sprejema nek promet in ga nato usmerja na eno ali več podov, povezanih z vašim servisom. To pomeni, da omogoča usmerjanje vsega prihajajočega prometa na določen servis s točno določenim imenom v te specifične pode. Hkrati zagotavlja uravnoteženje prometa. To pomeni, da lahko zaženete dva poda vaše aplikacije in bo ves prihajajoči promet enakomerno uravnotežen med povezanimi podi tega servisa.
In četrti osnovni koncept je IngressTo je servis, ki se zažene v Kubernetes klastru. Deluje kot zunanjega uravnoteževalnika obremenitve, ki sprejema vse zahteve. S pomočjo API-ja Kubernetes Ingress lahko določi, kam je treba te zahteve usmeriti. In to počne zelo fleksibilno. Lahko rečete, da vse zahteve za to gostiteljsko ime in tak URL pošljete na ta servis. Te zahteve, ki prihajajo na to gostiteljsko ime in drug URL, pa pošljete na drug servis.
Najboljše z vidika razvijalca aplikacije je, da lahko vse to upravljate sami. Z nastavitvijo Ingress konfiguracije lahko celoten promet, ki prihaja na določen API, usmerite na ločene kontejnere, npr. napisane v Go. Ta promet, ki prihaja na isto domeno, ampak na drug URL, pa usmerite na kontejnere, napisane v PHP, kjer je veliko logike, vendar niso zelo hitri.
Če primerjamo vse te pojme z Nomad, lahko rečemo, da prvih treh pojmov ni možno obravnavati ločeno, saj skupaj sestavljajo Service. Zadnjega pojma v samem Nomadu ni. Za to smo uporabili zunanjega uravnoteževalnika: to je lahko haproxy, nginx, nginx+ in tako naprej. Pri kubernetesu vam ni treba uvesti tega dodatnega pojma. Vendar, če pogledate v notranjost Ingressa, je to bodisi nginx, bodisi haproxy, bodisi traefik, a vgrajeno v Kubernetes.
Vsa zgoraj opisana pojma so v bistvu viri, ki obstajajo znotraj Kubernetes klastru. Za njihovo opisovanje v kubernetesu se uporablja yaml-format, ki je bolj berljiv in znan kot HCL datoteke v primeru Nomada. Strukturalno pa opisujejo v primeru, na primer, poda enako. Pravijo - želim razporediti take pode tja, s takšnimi slikami, v takšni količini.
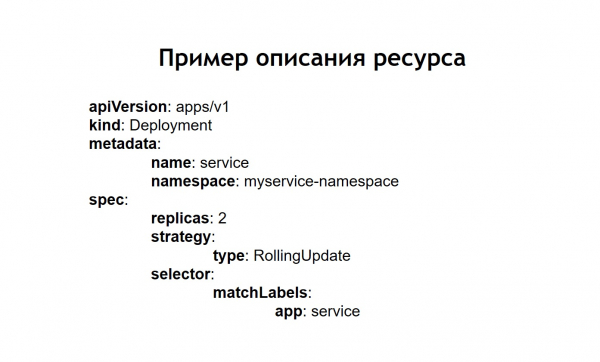
Poleg tega smo ugotovili, da ne želimo ročno ustvarjati vsakega posameznega vira: deployment, storitve, Ingress in podobno. Namesto tega smo želeli pri namestitvi opisati vsak naš sistem v pogojih Kubernetes, da nam ni treba ročno ponovno ustvarjati vseh potrebnih odvisnosti virov v pravem vrstnem redu. Kot takšen sistem, ki nam je omogočil to, smo izbrali Helm.
Osnovni pojmi v Helm
Helm je paketni upravljalnik za Kubernetes. Zelo je podoben delovanju paketnih upravljalnikov v programskih jezikih. Omogoča vam shranjevanje storitve, ki se na primer sestoji iz deploymenta nginx, deploymenta php-fpm, konfiguracije za Ingress, configmaps (to je entiteta, ki vam omogoča, da določite env in druge parametre za vaš sistem) v obliki t.i. chartov. Pri tem Helm deluje nad Kubernetes. Torej, to ni nek sistem, ki bi stal ob strani, ampak preprosto še ena storitev, ki se izvaja znotraj kupa. Z njim komunicirate preko njegovega API-ja preko konzolne ukazne vrstice. Njegova prednost in lepota je v tem, da celo, če se helm pokvari ali ga izbrišete iz klasterja, vaše storitve ne izginejo, saj helm služi v bistvu le za zagon sistema. Za delovanje in stanje storitev naprej odgovarja sam Kubernetes.
Prav tako smo ugotovili, da templating, ki smo ga prej morali izvajati sami z vključitvijo jinja v naše konfiguracije, predstavlja eno od osnovnih funkcionalnosti helma. Vse konfiguracije, ki jih ustvarite za svoje sisteme, so shranjene v helm v obliki predlog, ki so nekoliko podobne jinja, vendar v resnici uporabljajo templating jezika Go, v katerem je helm napisan, kot tudi Kubernetes.
Helm nam dodaja še nekaj dodatnih pojmov.
Chart — to je opis vaše storitve. V drugih paketnih upravljalnikih bi ga imenovali paket, bundle ali kaj podobnega. Tukaj se imenuje chart.
Vrednosti so spremenljivke, ki jih želite uporabiti za izdelavo vaših konfiguracij iz predlog.
ReleaseVsakokrat, ko se storitev, ki jo namestimo s Helmom, posodobi, dobi inkrementalno različico izpustitve. Helm si zapomni, kakšna je bila konfiguracija storitve pri prejšnji, predprejšnji izpustitvi in tako naprej. Zato, če je potrebno, se lahko preprosto vrnemo nazaj z ukazom helm rollback, ki mu določimo prejšnjo različico izpustitve. Tudi če v trenutku povratka ustrezna konfiguracija ni na voljo v vašem repozitoriju, Helm vseeno ve, kakšna je bila, in vrne vaš sistem v stanje pred prejšnjo izpustitvijo.
V primeru, ko uporabljamo Helm, običajne konfiguracije za Kubernetes postanejo tudi predloge, v katerih lahko uporabljamo spremenljivke, funkcije ter pogojne operatorje. Tako lahko sestavite konfiguracijo vaše storitve glede na okolje.
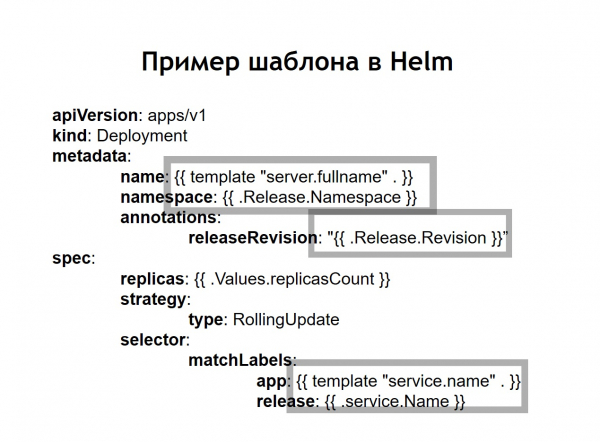
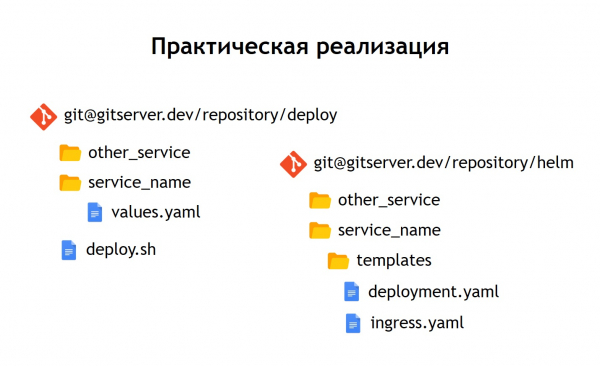
Na praktični ravni smo se odločili malce drugače kot pri Nomadu. Medtem ko smo v Nomadu shranjevali tako konfiguracije za namestitev kot n-spremenljivke, potrebne za namestitev naše storitve v enem istem repozitoriju, smo tu odločili, da jih razdelimo na dva ločena repozitorija. V repozitoriju 'deploy' so shranjene zgolj n-spremenljivke, potrebne za namestitev, medtem ko so v repozitoriju 'helm' shranjene konfiguracije ali grafi.
Kaj nam to prinaša?
Kljub temu, da v samih konfiguracijskih datotekah ne shranjujemo dejansko občutljivih podatkov, kot so gesla za podatkovne baze, ki jih hranimo kot secrets v Kubernetes, obstajajo kljub temu nekatere stvari, do katerih nočemo dati dostopa vsem. Zato je dostop do repozitorija 'deploy' bolj omejen, repozitorij 'helm' pa vsebuje zgolj opis storitve. Iz tega razloga lahko dostop do njega varno podelimo širšemu krogu posameznikov.
Ker imamo ne le produkcijsko okolje, temveč tudi druge okolja, nam takšna razdelitev omogoča ponovno uporabo naših helm-grafov za namestitev storitev ne le v produkciji, temveč tudi, na primer, v QA okolju. Tudi za lokalni razvoj uporabljamo. Minikube — to je ta stvar za lokalno zagon Kubernetes.
Znotraj vsakega repozitorija smo ohranili ločitev na posamezne imenike za vsako storitev. To pomeni, da se znotraj vsakega imenika nahajajo predloge, ki se nanašajo na ustrezno shemo in opisujejo vire, ki jih je treba obdržati za zagon našega sistema. V repozitoriju 'deploy' smo pustili samo envs. V tem primeru nismo uporabili predloge s pomočjo jinja, ker helm sam ponuja predlaganje iz škatle – to je ena njegovih osnovnih funkcij.
Pustili smo skripto za implementacijo – deploy.sh, ki poenostavi in standardizira zagon za implementacijo s pomočjo helma. Tako za kogarkoli, ki želi izvesti implementacijo, vmesnik za implementacijo izgleda točno tako, kot je bil v primeru implementacije prek Nomada. Enaka deploy.sh, ime vaše storitve in tja, kamor želite to implementirati. To pripelje do tega, da se znotraj zažene helm. Ta nato zbere konfiguracije iz predlog, v njih vnese potrebne values-datoteke in nato izvede implementacijo, tako da jih pošlje v Kubernetes.
Zaključki
Storitev Kubernetes se zdi bolj zapletena kot Nomad.
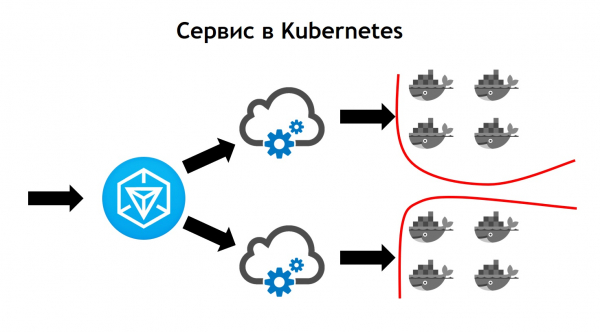
Tukaj izhodni promet prihaja v Ingress. To je prednji kontroler, ki sprejema vse zahtevke in jih nato pošilja ustreznim storitvam, povezanih z zahtevkom. Določa jih na podlagi konfiguracij, ki so del opisa vaše aplikacije v helmu in ki jih določijo razvijalci sami. Storitev nato pošilja zahteve svojim podom, torej konkretnim vsebnim enotam, pri čemer uravnava prihajajoči promet med vsemi vsebnimi enotami, ki se nanašajo na to storitev. In seveda ne smemo pozabiti na to, da na ravni omrežne varnosti ne smemo nikamor odhajati. Zato v Kubernetes grozdu deluje segmentacija, ki se temelji na označevanju. Vse storitve imajo določene oznake, s katerimi so povezane pravice dostopa storitev do določenih zunanjih/notranjih virov znotraj ali zunaj grozda.
Ko izvajamo prehod, smo opazili, da Kubernetes ponuja vse možnosti, ki jih je imel Nomad, ki smo ga uporabljali prej, ter dodaja številne nove funkcionalnosti. Razvijati ga je mogoče preko vtičnikov in dejansko preko prilagojenih tipov virov. To pomeni, da imate možnost ne le uporabljati tisto, kar je v Kubernetesu na voljo že privzeto, temveč tudi ustvariti svoj lasten vir in storitev, ki bo brala ta vir. To omogoča dodatne možnosti razširitve vašega sistema brez potrebe po ponovni namestitvi Kubernetes in brez potrebnih sprememb.
Primer takega uporabljanja je Prometheus, ki se poganja znotraj našega Kubernetes grozda. Da začne zbirati metrike z določenih storitev, moramo v opis storitve dodati dodatno vrsto vira, imenovano servisni nadzornik. Prometheus zaradi svoje zmožnosti branja, ko je zagnan v Kubernetesu, prilagojenih tipov virov, samodejno začne zbirati metrike iz novega sistema. To je precej priročno.
Prvi deployment, ki smo ga izvedli v Kubernetesu, je bil marca 2018. In v tem času nikoli nismo imeli težav z njim. Deluje dovolj stabilno brez večjih napak. Poleg tega ga lahko še naprej razvijamo. Trenutno nam zadoščajo zmožnosti, ki jih ima, in hitrost razvoja Kubernetes nam je zelo všeč. Trenutno je v Kubernetesu več kot 3000 kontejnerjev. Grozd zaseda več vozlišč. Pri tem je dobro upravljan, stabilen in zelo obvladljiv.
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish