

Živjo! Sem Oleg Sidorenkov, vodja infrastrukturne ekipe pri podjetju DomClick. V produkciji delamo z „Kocko“ že več kot tri leta in v tem času smo doživeli veliko različnih zanimivih trenutkov. Danes vam bom povedal, kako lahko ob pravnem pristopu iz „vanilijevega“ Kubernetes izvlečete še večjo zmogljivost za vaš klaster. Ready steady go!
Vsi veste, da je Kubernetes razširljiv sistem z odprto kodo za orkestracijo kontejnerjev; no, ali pa 5 binarnih datotek, ki ustvarjajo čarovnijo, upravljajoč življenjski cikel vaših mikroservisov v strežniškem okolju. Poleg tega je to precej prilagodljiv instrument, ki ga lahko sestavite kot Lego kocke za maksimalno prilagoditev različnim nalogam.
In vse se zdi v redu: vklopi strežnike v klaster kot drva v peč, in ne skrbi. A če si za ekologijo, se boš vprašal: „Kako lahko ohranim ogenj v peči in hkrati šparam gozd?“. Drugimi besedami, kako najti načine za izboljšanje infrastrukture in zmanjšanje stroškov.
1. Spremljajte vire ekip in aplikacij
Eden najslajših, a učinkovitih metod je uvedba zahtev/naredb. Razdelite aplikacije po imenskih prostorih in imenske prostore po razvojnim ekipam. Določite vrednosti porabe procesorskega časa, pomnilnika in minljivega shranjevanja, preden aplikacije namestite.
resources:
   requests:
     memory: 2Gi
     cpu: 250m
   limits:
     memory: 4Gi
     cpu: 500m
Z izkušnjami smo prišli do zaključka: ne smete povečati zahtevani pri maksimumih za več kot dvakrat. Obseg klasterja se izračuna na podlagi zahtev, in če boste določili aplikacijam razliko v virih, na primer 5-10 krat, si predstavljajte, kaj se zgodi z vašim vozliščem, ko se napolni z podi in nenadoma dobi obremenitev. Nič dobrega. Vsaj trotliranje, najslabše pa se poslovite od delavca in dobite ciklično obremenitev preostalih vozlišč po tem, ko se podi začnejo seliti.
Osim toga, putem limitranges lahko na začetku določite vrednosti za vire za vsebnik — minimalne, maksimalne in privzete:
➜  ~ kubectl opisati limitranges --namespace ops
Ime:       limit-range
Namespace:  ops
Tip        Resurs           Min   Max   Zadnji zahtev  Zadnja ograničenja  Maksimalni odnos ograničenja/zahteva
----        --------           ---   ---   ---------------  -------------  -----------------------
Container   cpu                50m   10    100m             100m           2
Container   ephemeral-storage  12Mi  8Gi   128Mi            4Gi            -
Container   memory             64Mi  40Gi  128Mi            128Mi          2
Ne zaboravite ograničiti resurse namespace-a kako jedna ekipa ne bi mogla da potroši sve resurse klastera:
➜  ~ kubectl opisati resourcequotas --namespace ops
Ime:                   resource-quota
Namespace:              ops
Resurs                Korišćeno          Ograničeno
--------                ----          ----
limits.cpu              77250m        80
limits.memory           124814367488  150Gi
pods                    31            45
requests.cpu            53850m        80
requests.memory         75613234944   150Gi
services                26            50
services.loadbalancers  0             0
services.nodeports      0             0
Kao što se može videti iz opisa resourcequotas, ako ekipa ops želi da postavi podove koji će koristiti još 10 cpu, planifier neće dozvoliti to da se uradi i izdaće grešku:
Greška prilikom kreiranja: podovi "nginx-proxy-9967d8d78-nh4fs" su zabranjeni: prekoračeno kvota: resource-quota, zahtevano: limits.cpu=5, requests.cpu=5, korišćeno: limits.cpu=77250m, requests.cpu=53850m, ograničeno: limits.cpu=10, requests.cpu=10Za rešavanje ovakvog problema možete napisati alat, recimo, kao , koji može da čuva i komituje stanje resursa timova.
2. Pronađite optimalnu uslugu skladištenja datoteka
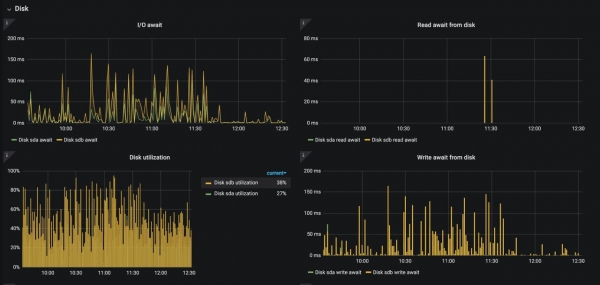
Ovde bih želeo da se dotaknem teme persistenta volumena i diskovnog sistema worker-nodova Kubernetes-a. Nadam se da niko ne koristi "Kube" na HDD-u u produkciji, ali ponekad i obični SSD postaje nedovoljan. Suočavali smo se sa problemom gde su logovi uništavali disk zbog operacija ulaza-izlaza i rešenja nije mnogo:
Koristite visokoperformantne SSD ili pređite na NVMe (ako upravljate svojom opremom).
Smanjite nivo logovanja.
Osigurajte „pametno“ balansiranje podova koji opterećuju disk (
podAntiAffinity).
Screenshot iznad pokazuje šta se dešava pod nginx-ingress-controller-om sa diskom kada je uključeno logovanje access_logs (~12k logova/sek.). Ovakvo stanje, svakako, može dovesti do degradacije svih aplikacija na toj nodi.
Što se tiče PV, nažalost, nisam isprobao sve PERSISTENT VOLUMES. Izberite najboljšo možnost, ki ustreza vašim potrebam. Imamo dolgo zgodovino, da le majhen del storitev potrebuje RWX volumne, zato smo že dolgo nazaj začeli uporabljati NFS shrambo za ta namen. Je poceni in ... zadostuje. Seveda, imeli smo slabe izkušnje — da ne omenjam, ampak smo se naučili, kako ga optimizirati, tako da nas to ne boli več. Če je mogoče, preidite na objektno shranjevanje S3.
3. Zberite optimizirane slike
Najbolje je uporabiti slike, optimizirane za kontejnerje, da lahko Kubernetes hitreje dostopa do njih in jih učinkoviteje izvaja.
Optimiziranost pomeni, da slike:
vsebujejo le eno aplikacijo ali izvajajo le eno funkcijo;
so majhne, ker velike slike slabše potujejo po omrežju;
imajo končne točke za preverjanje delovanja in pripravljenosti, s katerimi lahko Kubernetes sprejme ukrepe v primeru izpadov;
uporabljajo operacijske sisteme, prijazne do kontejnerjev (kot sta Alpine ali CoreOS), ki so bolj odporne na napake konfiguracije;
uporabljajo večstopenjske gradnje, da lahko namestite le prevedene aplikacije in ne priložene izvorne kode.
Obstaja veliko orodij in storitev, ki omogočajo preverjanje in optimizacijo slik v realnem času. Pomembno je, da jih vedno ohranjate posodobljene in preverjene glede varnosti. Na koncu dobite:
Zmanjšanje omrežnega obremenitve celotnega grozda.
Krajši čas zagona kontejnerja.
Manjši obseg vašega Docker registrarja.
4. Uporabite DNS predpomnilnik
Če govorimo o visokih obremenitvah, je brez optimizacije DNS sistema grozda življenje precej slabo. Pred dolgo časa so razvijalci Kubernetes podprli svojo rešitev kube-dns. Uvedena je bila tudi pri nas, vendar ta programska oprema ni bila posebej optimizirana in ni zagotavljala zahtevane zmogljivosti, čeprav se zdi, da je naloga preprosta. Nato se je pojavila coredns, na katero smo prešli in nismo imeli težav, kasneje je postala DNS storitev po privzetku v K8s. V določenem trenutku smo dosegli 40.000 rps na DNS sistemu in ta rešitev tudi ni zadostovala. A po srečni naključju je izšel Nodelocaldns, znan tudi kot local cache, znan tudi kot .
Zakaj to uporabljamo? V jedru Linuxa je napaka, ki pri večkratnem dostopu preko conntrack NAT po UDP povzroči stanje dirke pri zapisovanju v conntrack-čašete, kar povzroči, da del prometa preko NAT izgine (vsakič, ko greste skozi storitev, je NAT). Nodelocaldns rešuje to težavo, tako da se znebi NAT-a in nadgradi povezavo na TCP do upstream DNS, ter lokalno predpomnjenje DNS-poizvedb do upstreamov (vključno s kratkim 5-sekundnim negativnim predpomnilnikom).
5. Horizontalno in vertikalno avtomatsko skaliranje podov
Ali lahko z zagotovostjo trdite, da so vsi vaši mikroservisi pripravljeni na dvakratno ali trikratno povečanje obremenitve? Kako pravilno dodeliti vire svojim aplikacijam? Imajoč aktivna dodatna dva poda nad delovno obremenitvijo se lahko izkaže za odvečno, medtem ko imeti na robu tveganja prenašate izpad zaradi nenadnega povečanja prometa na storitev. Zlate sredine pomagajo doseči čarobne storitve, kot je in .
VPA omogoča avtomatsko povečanje requests/limits vaših kontejnerjev v podu glede na dejansko porabo. Kako vam lahko pomaga? Če imate pode, ki jih iz kakršnega koli razloga ni mogoče horizontalno skalirati (kar ni povsem zanesljivo), lahko poskusite zaupati VPA za spremembo njegovih virov. Njegova značilnost je sistem priporočil na podlagi zgodovinskih in trenutnih podatkov iz metric-serverja, zato, če ne želite samodejno spreminjati requests/limits, preprosto spremljajte priporočene vire za vaše kontejnerje in optimizirajte nastavitve za varčevanje s procesorjem in pomnilnikom v klastru.
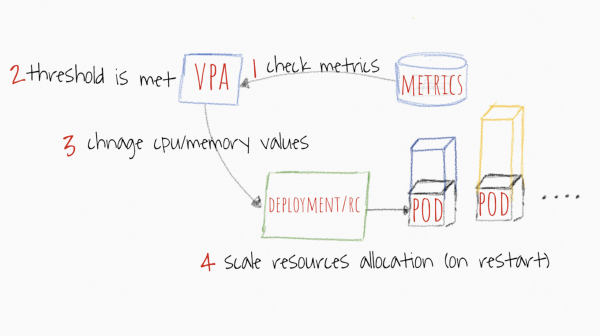 Slika je bila prevzeta z https://levelup.gitconnected.com/kubernetes-autoscaling-101-cluster-autoscaler-horizontal-pod-autoscaler-and-vertical-pod-2a441d9ad231
Načrtovalnik v Kubernetesu se vedno temelji na requests. Kakršno koli vrednost vnesete, načrtovalnik bo iskal ustrezno vozlišče na osnovi tega. Vrednosti limits potrebujemo kubeletu, da razume, kdaj omejiti ali ubiti pod. In ker je edini pomemben parameter vrednost requests, bo VPA delal z njim. Vsakič, ko določite vertikalno skaliranje aplikacije, določite, kakšne naj bodo requests. Kaj pa torej limits? Ta parameter bo prav tako proporcionalno skaliran.
Na primer, tukaj so običajne nastavitve poda:
viri:
   zahteve:
     pomnilnik: 250Mi
     cpu: 200m
   omejitve:
     pomnilnik: 500Mi
     cpu: 350m
Mehanizem priporočil določa, da vaša aplikacija za normalno delovanje potrebuje 300m CPU in 500Mi. Dobili boste takšne nastavitve:
viri:
   zahteve:
     pomnilnik: 500Mi
     cpu: 300m
   omejitve:
     pomnilnik: 1000Mi
     cpu: 525m
Kot je bilo omenjeno zgoraj, to predstavlja sorazmerno skaliranje na podlagi razmerja zahtev/omejitev v manifestu:
CPU: 200m → 300m: razmerje 1:1,75;
Pomnilnik: 250Mi → 500Mi: razmerje 1:2.
Kar zadeva HPA, v tem primeru je mehanizem delovanja bolj pregleden. Določene so pragovne vrednosti metrik, na primer, CPU in pomnilnik, in če povprečna vrednost vseh replik preseže prag, se aplikacija poveča za +1 pod, dokler vrednost ne pade pod prag ali dokler ne doseže največjega števila replik.
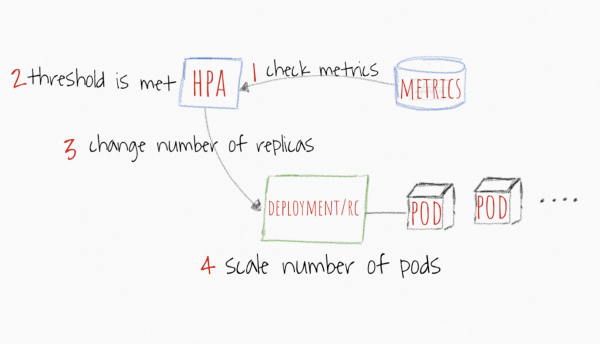 Slika je bila prevzeta z https://levelup.gitconnected.com/kubernetes-autoscaling-101-cluster-autoscaler-horizontal-pod-autoscaler-and-vertical-pod-2a441d9ad231
Poleg običajnih metrik, kot sta CPU in pomnilnik, lahko nastavite pragove na svojih prilagojenih metrikah iz Prometheus in z njimi upravljate, če menite, da je to najbolj natančna opredelitev trenutka, ko je treba skalirati vašo aplikacijo. Ko se aplikacija stabilizira pod določeno mejo metrike, bo HPA začel zmanjševati pode navzdol do minimalnega števila replik ali do trenutka, ko bo obremenitev zadovoljila določen prag.
6. Ne pozabite na Node Affinity in Pod Affinity
Ne vse vozlišča delujejo na enaki opremi, ne vse pode morajo izvajati aplikacije, ki zahtevajo intenzivno obdelavo. Kubernetes omogoča določitev specializacije vozlišč in podov s pomočjo Node Affinity in Pod Affinity.
Če imate vozlišča, primerna za operacije z intenzivno obdelavo, je za največjo učinkovitost najbolje povezati aplikacije z ustreznimi vozlišči. Za to uporabite nodeSelector z oznako vozlišča.
Recimo, da imate dve vozli: eno z CPUType=HIGHFREQ in velikim številom hitrih jeder, drugo z MemoryType=HIGHMEMORY velikim številom pomnilnika in večjo hitrostjo. Najlažje je dodeliti uvajanje poda vozlišču HIGHFREQ, tako da dodate v razdelku spec takšen selektor:
…
nodeSelector:
	CPUType: HIGHFREQ
Bolj draga in specifična možnost, da to dosežete, je uporaba nodeAffinity u polju affinity razdelka. specObstajata dva možnosti:
requiredDuringSchedulingIgnoredDuringExecution: stroga nastavitev (načrtovalnik bo uvajal pode samo na določenih vozliščih (in nikjer drugje));preferredDuringSchedulingIgnoredDuringExecution: mehka konfiguracija (načrtovalec bo poskušal razporediti na določenih vozlih, in če to ne uspe, bo poskušal razporediti na naslednjem razpoložljivem vozlu).
Lahko določite določen sintaksis za upravljanje oznak vozlov, na primer, V, NeV, Obstaja, NeObstaja, Večji ili Manjši. Vendar pa ne pozabite, da zapleteni Metodi v dolgih seznamih oznak upočasnijo sprejemanje odločitev v kritičnih situacijah. Drugimi besedami, ne zapletajte.
Kot je že omenjeno, Kubernetes omogoča določitev vezave trenutnih podov. To pomeni, da lahko določite, da določeni podi delujejo z drugimi podi v isti razpoložljivostni coni (kar je pomembno za oblake) ali vozlih.
V podAffinity polja affinity razdelka. spec so na voljo ista polja kot v primeru nodeAffinity: requiredDuringSchedulingIgnoredDuringExecution in preferredDuringSchedulingIgnoredDuringExecution. Edina razlika je, da matchExpressions veže pode na vozlo, na katerem že teče pod s to oznako.
Poleg tega Kubernetes ponuja polje podAntiAffinity, ki pa ne veže poda na vozlo s specifičnimi podi.
Glede izrazov nodeAffinity lahko damo isti nasvet: trudite se ohraniti enostavnost in logičnost pravil, ne poskušajte preobremeniti specifikacije podov s kompleksnim naborom pravil. Zelo enostavno je ustvariti pravilo, ki ne bo ustrezalo pogojem grozda, kar ustvarja nepotrebno obremenitev za načrtovalec in zmanjša splošno zmogljivost.
7. Tainti & Tolerancije
Obstaja še en način za upravljanje načrtovalca. Če imate veliko grozda s stotinami vozlov in tisoči mikro storitev, je zelo težko preprečiti, da se nekateri podi ne razporejajo na določene vozle.
Pri tem pomaga mehanizem taintov — prepovedujočih pravil. Na primer, lahko v določenih scenarijih prepoveste določenim vozlom, da pri sebi izvajajo pode. Za uporabo tainta na določenem vozlu morate uporabiti možnost taint v kubectl. Določite ključi in vrednost ter nato taint, kot je NoSchedule ili NoExecute:
$ kubectl taint nodes node10 node-role.kubernetes.io/ingress=true:NoSchedulePrav tako je vredno omeniti, da mehanizem taint podpira tri osnovne učinke: NoSchedule, NoExecute in PreferNoSchedule.
NoSchedulepomeni, da dokler v specifikaciji poda ne bo ustrezajoče vnostolerations, ne bo mogel biti razporejen na vozlu (v tem primerunode10).PreferNoSchedule— poenostavljena različicaNoSchedule. V tem primeru se načrtovalec trudi, da ne razporedi podov, ki nimajo ustreznega vnosatolerationsna vozlo, vendar to ni stroga omejitev. Če v grozdu ne bo virov, se bodo podi začeli razporejati na to vozlo.NoExecute— ta efekt povzroči takojšnjo evakuacijo pods, ki nimajo ustreznega zapisatolerations.
Zanimivo je, da se to vedenje lahko prekliče z mehanizmom toleranc. To je priročno, ko obstaja 'prepovedana' vozlišča in morate na njej postaviti le infrastrukturne storitve. Kako to storiti? Dovolite le tiste pods, za katere obstaja ustrezna toleranca.
Tako bo izgledala specifikacija poda:
spec:
   tolerations:
     - key: "node-role.kubernetes.io/ingress"
        operator: "Equal"
        value: "true"
        effect: "NoSchedule"
To ne pomeni, da bo pri naslednjem redeployu pod padel ravno na to vozlišče, to ni mehanizem Node Affinity in nodeSelector. Toda s kombiniranjem več funkcij lahko dosežete zelo prilagodljivo nastavitev razporejevalnika.
8. Nastavite prioriteto uvajanja pods
To, da ste nastavili priključitev pods na vozlišča, ne pomeni, da morajo biti vsi pods obravnavani z enako prioriteto. Na primer, morda boste želeli uvajati nekatere pods pred drugimi.
Kubernetes ponuja različne načine za nastavitev prioritete pods (Pod Priority and Preemption). Nastavitev se sestavlja iz več delov: objekta PriorityClass in opisa polja priorityClassName v specifikaciji poda. Poglejmo primer:
apiVersion: scheduling.k8s.io/v1
kind: PriorityClass
metadata:
  name: high-priority
value: 99999
globalDefault: false
description: "Ta razred prednosti naj se uporablja le za zelo pomembne pods"
Ustvarjamo PriorityClass, mu dodelimo ime, opis in vrednost. Bolj value, višja prioriteta. Vrednost je lahko katerokoli 32-bitno celo število, manjše ali enako 1 000 000 000. Višje vrednosti so rezervirane za kritične sistemske pods, ki običajno ne morejo biti izpodrinjeni. Izpodrivanje se bo zgodilo samo, če visoko prioritiziranemu podu ne bo mogoče razporediti, nato bodo nekateri pods z določenega vozlišča evakuirani. Če se vam zdi ta mehanizem preveč strog, lahko dodate možnost preemptionPolicy: Never, in takrat ne bo izpodrivanja, pod bo stal prvi v vrsti in čakal, da razporejevalnik najde proste vire zanj.
Nato ustvarimo pod, kjer navedemo ime priorityClassName:
apiVersion: v1
kind: Pod
metadata:
  name: static-web
  labels:
    role: myrole
 spec:
  containers:
    - name: web
      image: nginx
      ports:
        - name: web
          containerPort: 80
          protocol: TCP
  priorityClassName: high-priority
Lahko ustvarite neomejeno število razredov prioritet, čeprav se priporoča, da se s tem ne pretirava (na primer, omejite se na nizko, srednjo in visoko prioriteto).
Tako boste v primeru potrebe lahko povečali učinkovitost razporejanja kritičnih storitev, kot sta nginx-ingress-controller, coredns itd.
9. Optimizirajte ETCD-klaster
ETCD lahko imenujemo možgani celotnega klasterja. Zelo pomembno je, da to bazo podatkov vzdržujete na visoki ravni, saj od nje odvisna hitrost operacij v 'Kubi'. Standardna in hkrati dobra rešitev je, da ETCD klaster postavite na glavne vozlišča, da boste imeli minimalno zakasnitev do kube-apiserver. Če to ni izvedljivo, postavite ETCD čim bližje z dobrim prepustnostjo med udeleženci. Prav tako bodite pozorni na to, koliko vozlišč iz ETCD lahko izpade brez škode za klaster.
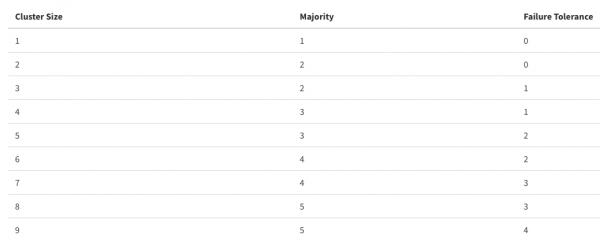
Imejte v mislih, da lahko pretirano povečanje števila udeležencev v klasterju poveča odpornost proti napakam na račun zmogljivosti; vse mora biti zmerno.
Če govorimo o nastavitvi storitev, je priporočil malo:
Imeti dobro strojno opremo, odvisno od velikosti klasterja (lahko preverite ).
Prilagoditi nekaj parametrov, če ste razporedili klaster med dvema podatkovnima centroma ali vaša omrežja in diski ne delujejo najbolje (lahko preverite ).
Zaključek
V tem članku so opisane točke, ki se jih naša ekipa prizadeva upoštevati. To ni korak za korakom opis dejanj, ampak možnosti, ki bi lahko koristile pri optimizaciji stroškov klasterja. Jasno je, da je vsak klaster edinstven, in rešitve za nastavitev se lahko precej razlikujejo, zato bi bilo zanimivo slišati vaše povratne informacije: kako spremljate svoj klaster Kubernetes in s čim izboljšujete njegovo delovanje. Delite svoje izkušnje v komentarjih, zanimivo bo izvedeti.
Izvor: habr.com
