

Pozdravljeni! Imamo odlične novice, junija OTUS ponovno začenja tečaj , zato tradicionalno z vami delimo koristne materiale.
Če ste se srečali s to zgodbo o mikroservisih brez kakršnegakoli konteksta, vam je lahko oproščeno, da jo imate za nekoliko nenavadno. Razdelitev aplikacije na koščke, med seboj povezane v omrežju, nujno pomeni dodajanje kompleksnih načinov odpornosti na napake v nastalo razdeljeno sistem.
Kljub temu, da tak pristop vključuje razdelitev na številne neodvisne storitve, je končni cilj veliko več kot le delovanje teh storitev na različnih napravah. Gre za interakcijo z okoljem, ki je po svoji naravi prav tako razdeljeno. Ne v tehničnem smislu, temveč bolj v smislu ekosistema, ki ga sestavlja mnogo ljudi, ekip, programov, pri čemer mora vsak del nekako opravljati svoje delo.
Podjetja na primer predstavljajo zbirko razdeljenih sistemov, ki skupaj prispevajo k doseganju določenega cilja. Ta dejstvo smo zanemarjali desetletja, medtem ko smo se trudili doseči integracijo, prenašali datoteke prek FTP ali uporabljali orodja za podjetniško integracijo, pri čemer smo se osredotočali na svoje osebne cilje. A s prihodom storitev se je vse spremenilo. Storitve so nam pomagale pogledati čez obzorje in videti svet medsebojno povezanih programov, ki delujejo skupaj. Vendar pa je za uspešno delovanje potrebno razumeti in zasnovati dva temeljno različna sveta: zunanji svet, kjer živimo v ekosistemu številnih drugih storitev, in naš osebni, notranji svet, kjer vlada Solo.
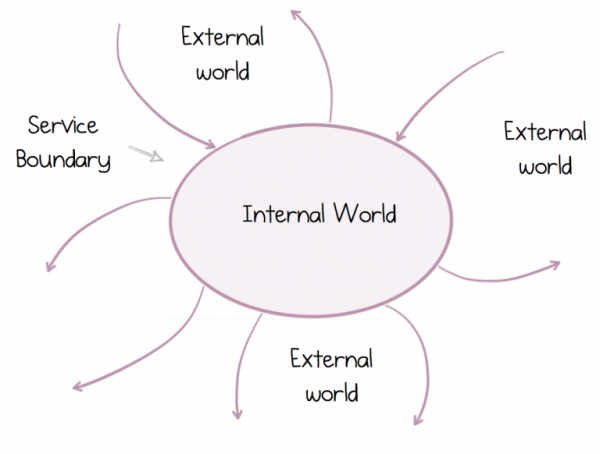
Ta razdeljen svet se razlikuje od tistega, v katerem smo odraščali in na katerega smo navajeni. Načela oblikovanja tradicionalne monolitne arhitekture ne prenesejo nobene kritike. Zato je pravilno razumevanje takih sistemov nekaj več kot le ustvarjanje super sheme na beli markerni tabli ali kul dokaz koncepta. Gre za to, da tak sistem uspešno deluje dolgotrajno. Na srečo storitve obstajajo že kar dolgo, čeprav izgledajo različno. še vedno velja, kljub dodatkom Docker, Kubernetes in nekoliko zanemarjenim hipsterskim bradam.
Torej danes bomo pogledali, kako so se pravila spremenila, zakaj moramo predelati naš pristop k storitvam in podatkom, ki si jih izmenjujejo, ter zakaj bomo potrebovali povsem drugačna orodja.
Inkapzulacija vam ne bo vedno v pomoč.
Mikrostoritve lahko delujejo neodvisno ena od druge. To lastnost jim daje največjo vrednost. Ta lastnost omogoča storitvam, da se razširijo in rastejo. Ne toliko v smislu razširjanja na kvadrilijone uporabnikov ali petabajte podatkov (čeprav lahko tudi pri tem pomagajo), ampak v smislu razširjanja z vidika ljudi, saj ekipe in organizacije nenehno rastejo.
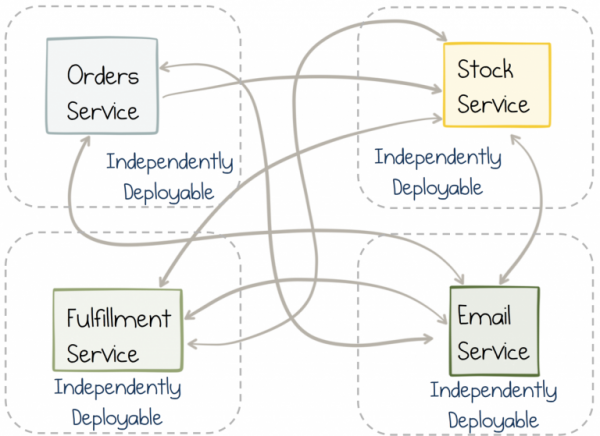
Vendar pa je neodvisnost dvorezni meč. To pomeni, da se storitev sama lahko izvaja enostavno in brez težav. Toda, če v storitvi izvedemo funkcijo, ki zahteva vključitev druge storitve, bomo na koncu morali spremeniti obe storitvi skoraj hkrati. Pri monolitu je to enostavno, preprosto spremenite in pošljete v izdajo, medtem ko se pri usklajevanju neodvisnih storitev pojavlja več težav. Koordinacija med ekipami in izdajnimi cikli ruši prožnost.
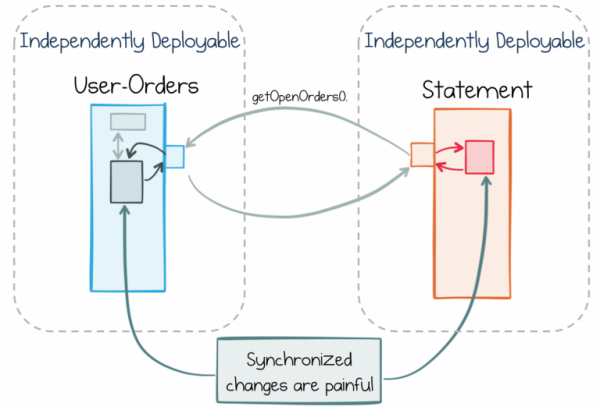
V okviru standardnega pristopa se skušajo nadležnim prečnim spremembam preprosto izogniti, tako da jasno ločijo funkcionalnost med storitvami. Storitev enotne točke dostopa je lahko dober primer tega. Ima jasno opredeljeno vlogo, ki jo ločuje od drugih storitev. Takšna jasna razdelitev pomeni, da v svetu hitro spreminjajočih se zahtev do okoliških storitev storitev enotne točke dostopa verjetno ne bo veliko spreminjala. Deluje v strogo omejenem kontekstu.
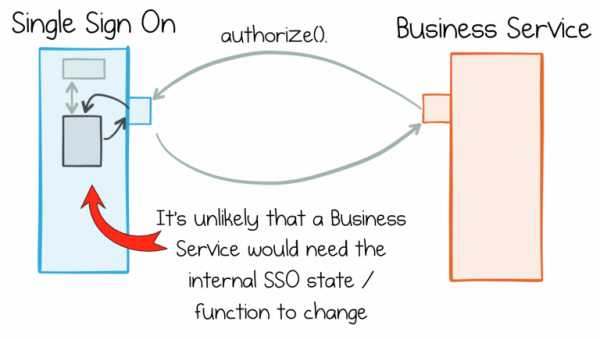
Težava je v tem, da v resničnem svetu poslovne storitve ne morejo nenehno vzdrževati popolne ločenosti vlog. Na primer, te iste poslovne storitve v večji meri delujejo z podatki, ki jih prejmejo od drugih takih storitev. Če se ukvarjate z elektronsko trgovino, bo obdelava toka naročil, kataloga izdelkov ali informacij o uporabnikih postala zahteva za mnoge vaše storitve. Vsaki od storitev bo za delovanje potreboval dostop do teh podatkov.
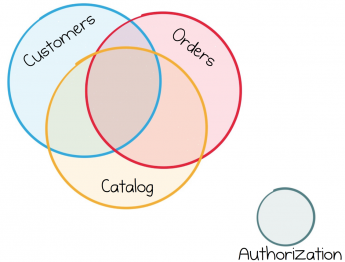
Večina poslovnih storitev uporablja isti tok podatkov, zato se njihovo delovanje neizogibno prepleta.
Tako smo prišli do pomembne točke, o kateri je vredno govoriti. Medtem ko storitve dobro delujejo za komponente infrastrukture, ki delujejo v veliki meri ločeno, se večina poslovnih storitev izkaže za tesno prepleteno.
Dikotomija podatkov
Pristopi, usmerjeni v storitve, morda že obstajajo, vendar še vedno ni veliko informacij o tem, kako izmenjavati velike količine podatkov med storitvami.
Glavna težava je, da sta podatka in storitve nedeljiva. Po eni strani nas inkapsulacija poziva, naj skrijemo podatke, da lahko storitve ločimo druga od druge in olajšamo njihovo rast in nadaljnje spremembe. Po drugi strani pa moramo imeti možnost svobodno deliti in imeti oblast nad skupnimi podatki, tako kot nad katerimikoli drugimi. Gre za to, da imamo možnost takoj začeti delati, tako svobodno, kot v kateri koli drugi informacijski sistem.
Vendar pa imajo informacijski sistemi malo skupnega z inkapsulacijo. Dejansko v nasprotju. Podatkovne baze naredijo vse, kar lahko, da omogočijo dostop do podatkov, ki jih hranijo. Na voljo so z močnim deklarativnim vmesnikom, ki omogoča, da oblikujete podatke, kot želite. Ta funkcionalnost je pomembna v fazi predhodnih raziskav, ne pa za upravljanje naraščajoče zapletenosti stalno razvijajoče se storitve.
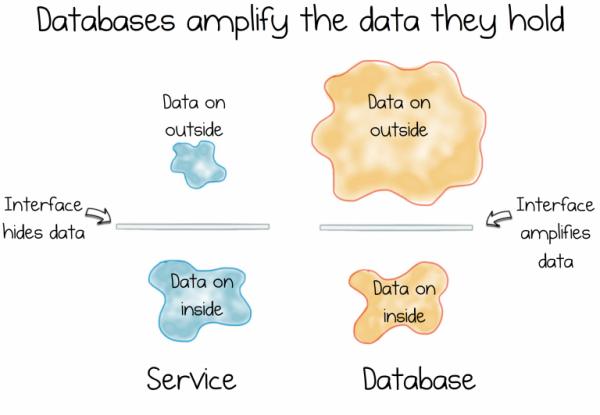
In tukaj se pojavi dilema. Proti govor. Dikotomija. Kajti informacijski sistemi so o zagotavljanju podatkov, storitve pa o skrivanju.
Ti dve sile sta osnovne. Ležijo v temelju večine našega dela, nenehno se borita za prevlado v sistemih, ki jih ustvarjamo.
Ko se sistemi storitev širijo in razvijajo, opažamo različne manifestacije posledic dihotomije podatkov. Ali bo vmesnik storitve rasel, ponujal vedno širši nabor funkcij in začenjal izgledati kot zelo čudna domača baza podatkov, ali pa nas bo doletelo razočaranje in razvili bomo kakšen način za množično ekstrakcijo ali premikanje celih nizov podatkov iz storitve v storitev.
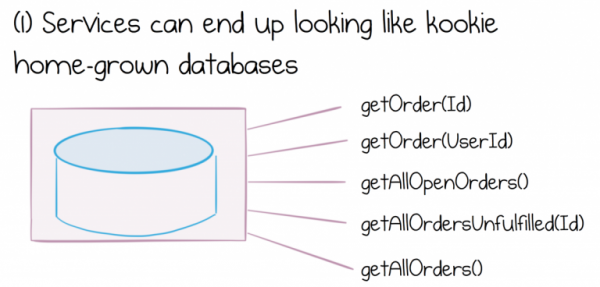
V samo ustvarjanje česarkoli, kar izgleda kot čudna domača baza podatkov, privede do vrsto težav. Ne bomo se poglabljali v podrobnosti tega, kako je nevarna shared database, ampak rečemo, da prinaša znatne drage inženirske ter operativne za podjetje, ki se trudi z njo.
Še slabše je, da se volumni podatkov pomnožijo težave z mejami storitev. Čim več skupnih podatkov leži znotraj storitve, težji postane vmesnik in težje je združiti niz podatkov, ki prihajajo iz različnih storitev.
Alternativni pristop z ekstrakcijo in premikanjem celih nizov podatkov prav tako ima svoje težave. Razširjen pristop k temu vprašanju se zdi preprosta ekstrakcija in hranjenje niza podatkov v celoti, nato pa shranjevanje lokalno v vsakem storitvenem uporabniku.
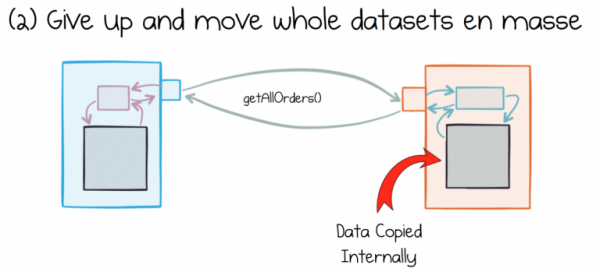
Težava je v tem, da različne storitve različno interpretirajo podatke, ki jih porabijo. Ti podatki so vedno pri roki. Spremenijo se in obdelajo lokalno. Zelo hitro prenehajo imeti kaj skupnega s podatki v viru.
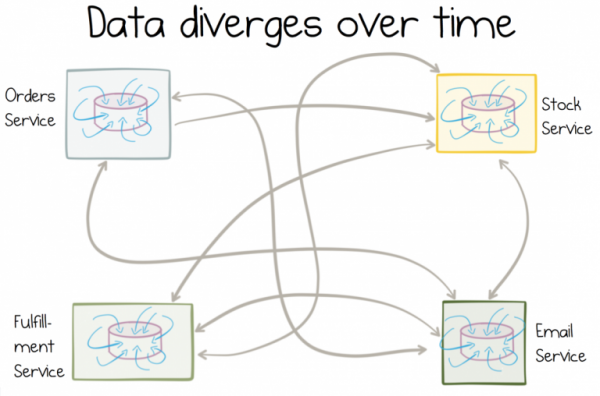
Čim bolj so kopije mutabilne, tem bolj se bodo podatki razlikovali s časom.
Še huje, takšne podatke je težko popraviti retrospektivno ( tukaj resnično lahko pride v pomoč). V resnici nekatere od težko rešljivih tehnoloških težav, s katerimi se podjetja soočajo, izhajajo iz heterogenih podatkov, ki se množijo od aplikacije do aplikacije.
Da bi našli rešitev tega problema o skupnih podatkih, je treba razmišljati drugače. Postati morajo objekti prvega razreda v arhitekturah, ki jih gradimo. imenuje takie dane 'zewnętrznymi', co jest bardzo istotną cechą. Potrzebujemy enkapsulacji, aby nie ujawniać wewnętrznej struktury usługi, ale musimy ułatwić usługom dostęp do wspólnych danych, aby mogły prawidłowo wykonywać swoją pracę.
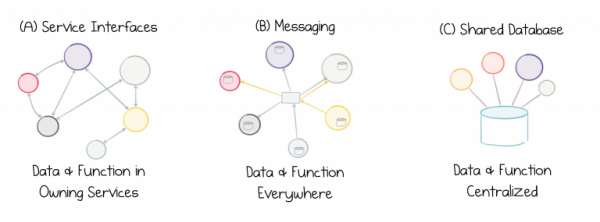
Problem polega na tym, że żadne z podejść dzisiaj nie jest już aktualne, ponieważ ani interfejsy usług, ani wymiana wiadomości, ani wspólna baza danych nie oferują dobrego rozwiązania do pracy z danymi zewnętrznymi. Interfejsy usług są słabo przystosowane do wymiany danych w jakiejkolwiek skali. Wymiana wiadomości przenosi dane, ale nie przechowuje ich historii, przez co z biegiem czasu dane ulegają zniekształceniu. Wspólne bazy danych zbytnio koncentrują się w jednym punkcie, co ogranicza rozwój postępu. Nieuchronnie utknęliśmy w cyklu niemożności danych:
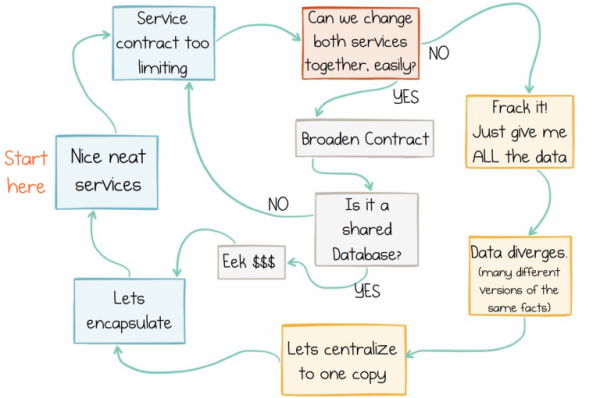
Cykl niemożności danych
Strumienie: zdecentralizowane podejście do danych i usług
W idealnym świecie musimy zmienić podejście do tego, jak usługi pracują z wspólnymi danymi. Na chwilę obecną każde podejście napotyka wspomnianą powyżej dychotomię, ponieważ nie ma żadnego magicznego proszku, którym można by to obficie posypać, aby to zniknęło. Możemy jednak przemyśleć problem i dojść do kompromisu.
Ten kompromis zakłada pewien stopień centralizacji. Możemy skorzystać z mechanizmu rozproszonych logów, ponieważ zapewnia on niezawodne, skalowalne strumienie. Teraz usługi muszą móc dołączać i pracować z tymi wspólnymi strumieniami, jednak chcemy uniknąć skomplikowanych, scentralizowanych usług God Service, które wykonują takie przetwarzanie. Dlatego najlepszą opcją jest wbudowanie przetwarzania strumieniowego w każdą usługę-konsumenta. W ten sposób usługi będą mogły łączyć zbiory danych z różnych źródeł i pracować z nimi w sposób, który jest im potrzebny.
Jednym ze sposobów dotarcia do takiego podejścia jest wykorzystanie platformy strumieniowej. Istnieje wiele opcji, ale dzisiaj przyjrzymy się dokładnie Kafka, ponieważ jej Stateful Stream Processing skutecznie rozwiązuje przedstawiony problem.
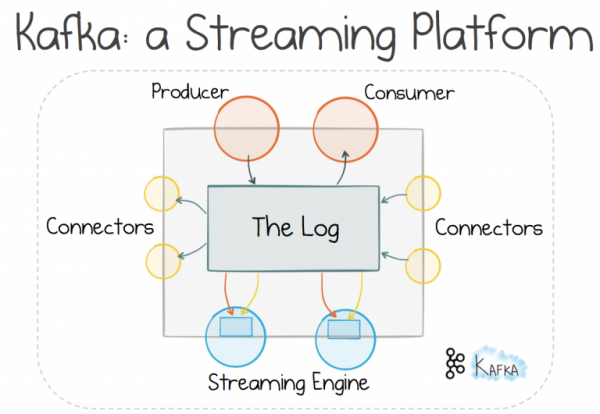
Wykorzystanie mechanizmu rozproszonego logowania pozwala nam podążać wytyczoną ścieżką i korzystać z wymiany wiadomości, aby pracować z . Verjame se, da ta pristop zagotavlja boljšo skalabilnost in razdelitev kot mehanizem "vprašanje-odgovor", saj nadzor nad tokom preda prejemniku, namesto pošiljatelju. Vendar pa je potrebno za vse v tem življenju plačati, zato boste potrebovali posrednika. Toda za velike sisteme je ta kompromis vreden (kar ne moremo reči za vaša povprečna spletna aplikacija).
Če za porazdeljeno beleženje poskrbi posrednik in ne tradicionalni sistem za izmenjavo sporočil, lahko izkoristimo dodatne funkcionalnosti. Transport je mogoče linearno skalirati skoraj tako dobro kot porazdeljeni sistem datotek. Podatki se lahko hranijo v dnevnikih dovolj dolgo, zato dobimo ne le izmenjavo sporočil, temveč tudi skladišče informacij. Skalabilno skladišče brez strahu pred spreminjanjem skupnega stanja.
Nato lahko uporabimo mehanizem obdelave toka s shranjevanjem stanja za dodajanje deklarativnih orodij baze podatkov v storitve-prejemnike. To je zelo pomembna misel. Dokler so podatki shranjeni v skupnih tokovih, do katerih imajo dostop vse storitve, je združevanje in obdelava, ki jo izvaja storitev, zasebna. So izolirane v strogo omejenem kontekstu.
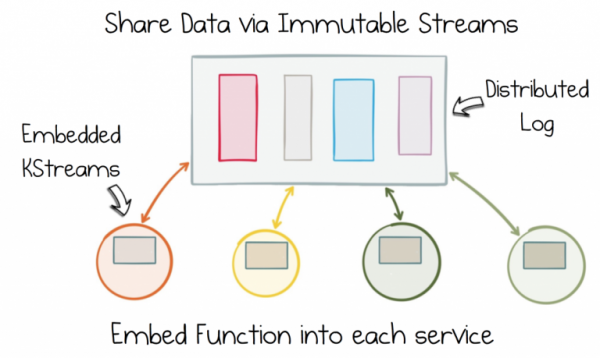
Znebite se dihotomije podatkov z delitvijo neomejenega toka stanj. Nato to funkcijo dodajte v vsako storitev s pomočjo obdelave toka s shranjevanjem stanja.
Tako, če vaša storitev mora delovati s naročili, katalogom izdelkov, skladiščem, bo imela popoln dostop: samo vi boste odločali, katere podatke združiti, kje jih obdelati in kako se morajo spreminjati s časom. Kljub temu, da so podatki skupni, je delo z njimi popolnoma decentralizirano. Poteka znotraj vsake storitve, v svetu, kjer vse poteka po vaših pravilih.
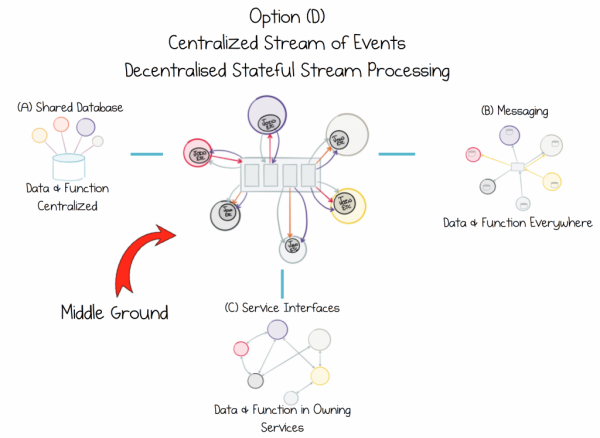
Delite podatke tako, da ne kršite njihove celovitosti. Inkapsulirajte funkcijo, ne vira, v vsaki storitvi, ki jo potrebuje.
Ponekad je potrebno masovno premestiti podatke. Ponekad servisu treba lokalni istorijski skup podataka u odabranom sistemu baze podataka. Ključna tačka je da se može garantovati da se, kada je potrebno, kopija može obnoviti iz izvora putem obraćanja mehanizmu distribuiranog logiranja. Povezivači u Kafki odlično obavljaju ovaj zadatak.
Dakle, pristup o kojem smo danas razgovarali ima nekoliko prednosti:
- Podaci se koriste kao zajednički tokovi, koji se mogu dugo čuvati u logovima, a sam mehanizam rada sa zajedničkim podacima je ugrađen u svaki pojedinačni kontekst, što omogućava servisima da funkcionišu lako i brzo. Na ovaj način se može izbalansirati dijalog podatka.
- Podaci koji dolaze iz različitih servisa se lako mogu spojiti u skupove. Ovo pojednostavljuje interakciju sa zajedničkim podacima i ukida potrebu za održavanjem lokalnih skupova podataka u bazi podataka.
- Stateful Stream Processing samo kešira podatke, a izvor istine ostaju zajednički logovi, tako da problem oštećenja podataka vremenom nije tako naglašen.
- U suštini, servisi su vođeni podacima, što znači da, uprkos stalnom rastu obima podataka, servisi i dalje mogu brzo reagovati na poslovne događaje.
- Problemi skalabilnosti padaju na brokera, a ne na servise. Tako da se znatno smanjuje složenost pisanja servisa, jer nije potrebno razmišljati o skalabilnosti.
- Dodavanje novih servisa ne zahteva promenu starih, tako da je povezivanje novih servisa olakšano.
Kao što vidite, ovo je više od samo REST-a. Dobili smo skup alata koji omogućavaju rad sa zajedničkim podacima decentralizovano.
U današnjem članku nisu istraženi svi aspekti. Još uvek moramo da se osvrnemo na to kako izbalansirati između paradigme "zahtev-odgovor" i paradigme orijentisane na događaje. O tome ćemo se baviti sledeći put. Ima tema sa kojima treba bolje da se upoznamo, na primer, zašto je Stateful Stream Processing tako dobar. O tome ćemo razgovarati u trećem članku. A postoje i druge moćne konstrukcije koje možemo iskoristiti, ako se odlučimo za njih, na primer, . Z njeno pomočjo se spreminjajo pravila igre za porazdeljene poslovne sisteme, saj ta konstrukcija zagotavlja transakcijske garancije za v skalabilni obliki. O tem bo govora v četrtem članku. In končno, morali bomo preleteti podrobnosti izvedbe teh načel.
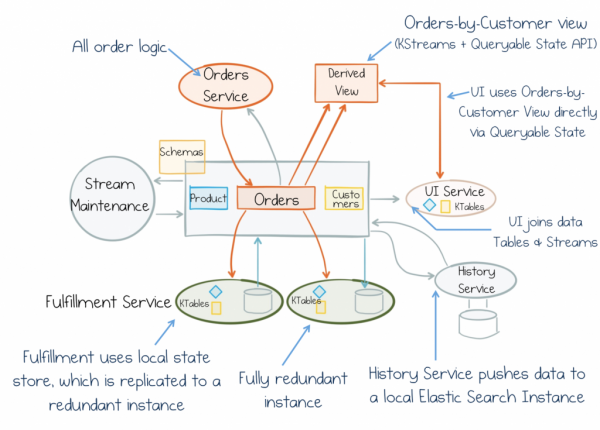
Ampak za zdaj si zapomnite naslednje: dihotomija podatkov je tista moč, s katero se soočamo pri ustvarjanju poslovnih storitev. In to moramo imeti v mislih. Fokus je v tem, da obrnemo vse na glavo in začnemo obravnavati skupne podatke kot prvoosebne objekte. Stateful Stream Processing ponuja edinstven kompromis za to. Izogiba se centraliziranim “Božjim komponentam”, ki ovirajo napredek. Poleg tega zagotavlja odzivnost, skalabilnost in odpornost podatkovnih tokov ter jih vključuje v vsako storitev. Tako se lahko osredotočimo na skupni tok zavesti, na katerega se lahko poveže katerakoli storitev in dela z njenimi podatki. Tako postanejo storitve bolj skalabilne, zamenljive in avtonomne. Zato bodo ne le dobro izgledale na označevalnih tablah in pri preverjanju hipotez, temveč tudi delovale in se razvijale desetletja.
Izvor: habr.com
