

Uvod
Informacijski sistem je z vidika uporabnika dobro opredeljen v GOST RV 51987 — "avtomatiziran sistem, katerega rezultat delovanja je predstavitev izhodnih informacij za nadaljnjo uporabo". Če gledamo notranjo strukturo, je v bistvu vsak IS sistem realiziranih v kodi medsebojno povezanih algoritmov. V širšem pomenu Turing-Črčeve teze algoritmi (in torej IS) izvajajo transformacijo množice vhodnih podatkov v množico izhodnih podatkov.
Lahko celo rečemo, da je smisel obstoja informacijskega sistema prav v transformaciji vhodnih podatkov. Posledično vrednost IS in celotnega kompleksa IS določa vrednost vhodnih in izhodnih podatkov.
Iz tega izhaja, da se mora načrtovanje začeti in temeljiti na podatkih ter prilagajati arhitekturo in metode strukturi in pomenu podatkov.
Shranjeni podatki
Ključna faza priprave na načrtovanje je pridobitev značilnosti vseh naborov podatkov, ki jih nameravamo obdelovati in shranjevati. Te značilnosti vključujejo:
— Obseg podatkov;
— Informacije o življenjskem ciklu podatkov (povečanje novih podatkov, trajanje življenja, obdelava zastarelih podatkov);
— Klasifikacija podatkov z vidika njihovega vpliva na osnovno poslovanje podjetja (torej triada zaupnosti, celovitosti, dostopnosti) skupaj s finančnimi kazalniki (npr. strošek izgube podatkov v zadnji uri);
— Geografija obdelave podatkov (fizična lokacija sistemov za obdelavo);
— Zahteve regulatorjev za vsako vrsto podatkov (npr. ZF-152, PCI DSS).
Informacijski sistemi
Podatki se ne le shranjujejo, ampak obdelujejo (transformirajo) z informacijskimi sistemi. Naslednji korak po pridobitvi značilnosti podatkov je čim bolj popolna inventarizacija informacijskih sistemov, njihovih arhitekturnih značilnosti, medsebojnih odvisnosti in zahtev po infrastrukturi v pogojnih enotah štirih vrst virov:
— Procesorska računska moč;
— Obseg delovne pomnilnika;
— Zahteve glede obsega in zmogljivosti sistema shranjevanja podatkov;
— Zahteve glede omrežja za prenos podatkov (zunanji kanali, kanali med komponentami IS).
Zahteve je treba določiti za vsak servis/mikroservis v okviru IS.
Pomembno je poudariti obveznost, da je za pravilno načrtovanje na voljo podatke o vplivu IS na osnovno poslovanje podjetja v obliki stroškov ustavljanja IS (evrov na uro).
Model groženj
Obvezno mora biti na voljo formalni model groženj, pred katerimi je načrtovana zaščita podatkov / storitev. Ta model groženj vključuje ne le vidike zaupnosti, temveč tudi celovitosti in dostopnosti. Torej, na primer:
— Okvara fizičnega strežnika;
— Okvara stikала top-of-the-rack;
— Prekinitev optičnega komunikacijskega kanala med podatkovnimi centri;
— Okvara podatkovne shranjevalne naprave v celoti.
V nekaterih primerih so modeli groženj napisani ne le za infrastrukturne komponente, temveč tudi za konkretne IS ali njihove komponente, kot je na primer okvara RDBMS z logičnim uničenjem strukture podatkov.
Vse odločitve v okviru projekta o zaščiti pred neobesenimi grožnjami so odveč.
Zahteve regulatorjev
Če obdelani podatki spadajo pod posebna pravila, ki jih določajo regulatorji, je obvezno potrebne informacije o naborih podatkov in pravilih obdelave/hramnega.
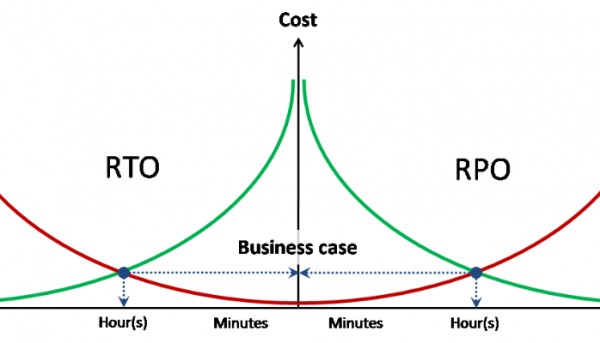
Ciljni kazalniki RPO / RTO
Načrtovanje kakršne koli oblike zaščite zahteva razpoložljivost kazalnikov ciljne izgube podatkov in ciljnega časa obnovitve storitve za vsako od opisanih groženj.
Pri tem bi morali imeti idealno RPO in RTO povezane stroške izgube podatkov in ustavljanja na enoto časa.
Delitev na sklade virov
Po zbiranju vseh osnovnih uvodnih informacij je prvi korak grupiranje naborov podatkov in IS v sklade, glede na modele groženj in zahteve regulatorjev. Določen je način delitve različnih skladov – programsko na ravni sistemske programske opreme ali fizično.
Primeri:
— Kontura, ki obdeluje osebne podatke, je popolnoma fizično ločena od drugih sistemov;
— Varnostne kopije so shranjene na ločeni napravi za shranjevanje podatkov.
Pri tem so lahko skladi s parcialno neodvisnostjo, na primer se določita dva sklada računalniških virov (procesorska moč + pomnilnik), ki uporabljata enoten sklad shranjevanja podatkov in enoten sklad virov prenosa podatkov.
Procesorska moč
Abstraktne potrebe po procesorski moči virtualiziranega podatkovnega centra se merijo v številu virtualnih procesorjev (vCPU) in koeficientu njihove konsolidacije na fizičnih procesorjih (pCPU). V tem konkretnem primeru 1 pCPU = 1 fizično jedro procesorja (brez upoštevanja Hyper-Threading). Število vCPU se sešteje za vse določene skupine virov (vsaka od njih lahko ima svoj koeficient konsolidacije).
Koeficient konsolidacije za obremenjene sisteme se pridobi empirično, na podlagi že obstoječe infrastrukture, ali med pilotno namestitvijo in obremenitvenim testiranjem. Za neobremenjene sisteme se uporabljajo ‘best practice’. Še posebej, VMware navaja povprečni koeficient 8:1.
Operativna pomnilnika
Skupna potreba po operativni pomnilniku se dobi z enostavnim seštevanjem. Uporaba preoverene operativne pomnilnike ni priporočena.
Skladiščni viri
Zahteve po skladiščnih virih se pridobijo z enostavnim seštevanjem vseh skupin po obsegu in zmogljivosti.
Zahteve po zmogljivosti se izražajo v IOPS v kombinaciji s povprečnim razmerjem branje/pisanje ter če je potrebno z maksimalnim zamikom odziva.
Ločeno morajo biti navedene zahteve za zagotavljanje kakovosti storitev (QoS) za posebne skupine ali sisteme.
Viri omrežja za prenos podatkov
Zahteve po omrežju za prenos podatkov se pridobijo z enostavnim seštevanjem vseh skupin pasovne širine.
Ločeno morajo biti navedene zahteve za zagotavljanje kakovosti storitev (QoS) in zamikov (RTT) za posebne skupine ali sisteme.
V okviru zahtev po virih omrežja za prenos podatkov so tudi določene zahteve po izolaciji in/ali šifriranju omrežnega prometa ter preferirani mehanizmi (802.1q, IPSec itd.)
Izbira arhitekture
V okviru tega vodnika se ne razpravlja o drugih možnostih, razen o arhitekturi x86 in 100% virtualizaciji strežnikov. Zato se izbira arhitekture računalniškega sistema zmanjša na izbiro platforme za virtualizacijo strežnikov, obliki strežnikov in splošnim zahtevam glede konfiguracije strežnikov.
Ključni trenutek izbire je odločitev za klasični pristop z ločitvijo funkcij obdelave, shranjevanja in prenosa podatkov ali konvergentni pristop.
Klasična arhitektura pripravlja uporabo inteligentnih zunanjih sistemov za shranjevanje in prenos podatkov, medtem ko strežniki v skupno rezervo fizičnih virov prispevajo le procesorsko moč in delovni pomnilnik. V ekstremnem primeru postanejo strežniki popolnoma anonimni, brez lastnih diskov in celo sistemskega identifikatorja. V tem primeru se uporablja nalaganje OS ali hipervizorja iz vgrajenih flash naprav ali zunanjega sistema za shranjevanje podatkov (boot from SAN).
V okviru klasične arhitekture izbira med noži (blade) in omarnimi (rack) temelji predvsem na naslednjih načelih:
— Ekonomičnost (v povprečju so omarni strežniki cenejši);
— Gostota izračunavanja (pri nožih je višja);
— Poraba energije in toplote (pri nožih je specifična višja na enoto);
— Razširljivost in upravljivost (noži na splošno zahtevajo manj truda pri velikih inštalacijah);
— Uporaba razširitvenih kartic (za nože je zelo omejena izbira).
Konvergirana arhitektura (znana tudi kot hiper-konvergirana) predvideva združitev procesnih in shranjevalnih funkcij, kar vodi v uporabo lokalnih diskov strežnikov in posledično opuščanje form-faktorja klasičnih nožev. Za konvergirane sisteme se uporabljajo bodisi omarni strežniki bodisi gručno sistemsko, ki združuje več strežnikov-nožev in lokalne diske v enotni ohišje.
CPU / Pomnilnik
Za pravilno izračun konfiguracije je potrebno razumeti vrsto obremenitve za okolje ali vsak neodvisen grozd.
CPU bound – okolje, omejeno z zmogljivostjo procesorske moči. Dodajanje delovnega pomnilnika ne bo bistveno vplivalo na zmogljivost (število VM na strežniku).
Memory bound – okolje, omejeno z delovnim pomnilnikom. Več delovnega pomnilnika na strežniku omogoča zagon večjega števila VM na strežniku.
GB / MHz (GB / pCPU) – povprečno razmerje porabe delovnega pomnilnika in procesorske moči za to specifično obremenitev. Lahko se uporablja za izračune potrebne količine pomnilnika pri določeni zmogljivosti in obratno.
Izračun konfiguracije strežnika
Za začetek je potrebno določiti vse vrste obremenitev in sprejeti odločitev o združevanju ali ločevanju različnih računalniških bazenov v različne gruče.
Nato za vsak od določenih gruče določimo razmerje GB / MHz ob znani obremenitvi. Če obremenitev ni znana vnaprej, vendar imamo približno razumevanje ravni obremenitve procesorske moči, lahko uporabimo standardne koeficiente vCPU:pCPU za pretvorbo zahtev bazenov v fizične.
Za vsako gruče delimo skupne zahteve bazenov vCPU s koeficientom:
vCPUskupaj / vCPU:pCPU = pCPUskupaj – zahtevano število fizičnih jeder
pCPUskupaj / 1.25 = pCPUht – število jeder s popravkom na Hyper-Threading
Recimo, da je potrebno izvesti izračun gruče z 190 jedri / 3.5TB RAM. Pri tem sprejmemo ciljno 50% obremenitev procesorske moči in 75% obremenitev pomnilnika.
pCPU
190
izkoriščenost CPU
50%
Pomnilnik
3500
izkoriščenost pomnilnika
75%
Vtičnica
Jedro
Srv / CPU
Srv Pomnilnik
Srv / Pomnilnik
2
6
25,3
128
36,5
2
8
19,0
192
24,3
2
10
15,2
256
18,2
2
14
10,9
384
12,2
2
18
8,4
512
9,1
V tem primeru vedno uporabljamo zaokroževanje na najbližje celo število navzgor (=ROUNDUP(A1;0)).
Iz tabele je očitno, da so uravnotežene za ciljne kazalnike več konfiguracij strežnikov:
— 26 strežnikov 2*6c / 192 GB
— 19 strežnikov 2*10c / 256 GB
— 10 strežnikov 2*18c / 512 GB
Izbira med temi konfiguracijami mora temeljiti na dodatnih dejavnikih, kot so toplotni paket in razpoložljivo hlajenje, že uporabljeni strežniki ali stroški.
Značilnosti izbire konfiguracije strežnika
Širok VM. Pri potrebi po postavitvi širših VM (primerljivih z 1 vozliščem NUMA in več) se priporoča, da izberete strežnik, katerega konfiguracija omogoča ostati takim VM znotraj vozlišča NUMA. Pri velikem številu širših VM obstaja nevarnost fragmentacije virov gruče, zato se izberejo strežniki, ki omogočajo čim tesnejšo postavitev širokih VM.
Velikost domene enotne odpovedi.
Izbira velikosti strežnika se prav tako izvaja po načelu minimizacije domene enotne odpovedi. Na primer, pri izbiri med:
— 3 x 4*10c / 512 GB
— 6 x 2*10c / 256 GB
Ob enakih drugih pogojih je treba izbrati drugo možnost, saj pri izpadu enega strežnika (ali vzdrževanju) ne izgubljamo 33% virov gruče, temveč 17%. Prav tako se na ta način prepolovi število VM in IS, na katerih se je odrazila okvara.
Izračun klasičnih SAN po zmogljivosti
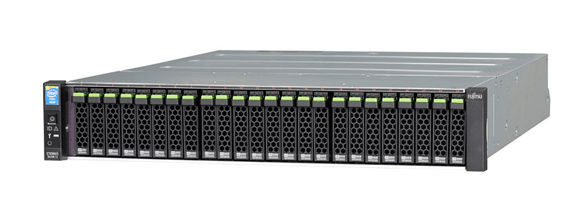
Klasičen SAN se vedno izračuna po najslabšem scenariju, brez vpliva operativnega predpomnilnika in optimizacije operacij.
Kot osnovne parametre zmogljivosti sprejmemo mehanično zmogljivost diskov (IOPSdisk):
— 7.2k – 75 IOPS
— 10k – 125 IOPS
— 15k – 175 IOPS
Nato se število diskov v diskovnem bazenu izračuna po naslednji formuli: = TotalIOPS * ( RW + (1 –RW) * RAIDPen) / IOPSdisk. Kjer je:
— TotalIOPS – skupna zahtevana zmogljivost v IOPS iz diskovnega bazena
— RW – odstotna delež bralnih operacij
— RAIDpen – RAID kazen za izbrano raven RAID
Več o RAID napravi in RAID kazni je opisano tukaj — in in
Na podlagi pridobljenega števila diskov se izračunajo možne možnosti, ki ustrezajo zahtevam po kapaciteti shranjevanja, vključno z možnostmi večnivojskega shranjevanja.
Izračun sistemov z uporabo SSD kot shranjevalne ravni se obravnava ločeno.
Posebnosti izračuna sistemov s Flash Cache
Flash Cache – splošno ime za vse blagovne tehnologije uporabe flash pomnilnika kot predpomnilnika druge ravni. Pri uporabi flash predpomnilnika se SAN običajno izračuna za zagotavljanje obremenitve iz magnetnih diskov, medtem ko vrhunskih obravnava predpomnilnik.
Pri tem je potrebno razumeti profil obremenitve in stopnjo lokalizacije zahtevkov na bloke shranjevanja. Flash Cache je tehnologija za obremenitve z visoko lokalizacijo zahtevkov in skoraj ni uporabna za enakomerno obremenjene bloke (na primer za sisteme analitike).
Izračun hibridnih sistemov low-end / mid-range
Hibridni sistemi spodnjega in srednjega razreda uporabljajo večnivojsko shranjevanje z premikanjem podatkov med nivoji po razporedu. Pri tem je velikost bloka večnivojskega shranjevanja pri najboljših modelih 256 MB. Te značilnosti ne omogočajo, da bi tehnologijo večnivojskega shranjevanja obravnavali kot tehnologijo za povečanje zmogljivosti, kot napačno menijo mnogi. Večnivojsko shranjevanje v sistemih spodnjega in srednjega razreda je tehnologija optimizacije stroškov shranjevanja za sisteme z izrazito neenakomernostjo obremenitve.
Pri večnivojskem shranjevanju se najprej izračuna zmogljivost zgornje ravni, medtem ko se spodnja raven shranjevanja šteje le za dodajanje potrebne zmogljivosti shranjevanja. Za hibridni večnivojski sistem je obvezna uporaba tehnologije predpomnjenja SSD za večnivojski bazen, da se kompenzira padec zmogljivosti za nenadoma obremenjene podatke s spodnje ravni.
Uporaba SSD v večnivojskem diskovnem bazenu
Uporaba SSD v večnivojskem diskovnem bazenu se razlikuje glede na specifike implementacije algoritmov predpomnjenja nesolid-state pri tem proizvajalcu.
Splošna praksa politike shranjevanja za diskovni bazen s SSD je SSD first.
Predpomnilnik samo za branje. Za predpomnilnik samo za branje se raven shranjevanja na SSD pojavijo pri znatni lokalizaciji zapisnih operacij ne glede na predpomnilnik.
Predpomnilnik za branje / pisanje. Pri predpomnilniku za pisanje se najprej nastavi največji obseg predpomnilnika, raven shranjevanja na SSD pa pride v poštev le, če je obseg predpomnilnika nezadosten za obvladovanje celotne lokalizirane obremenitve.
Izračun zmogljivosti SSD in predpomnilnika se vsakokrat izvede v skladu s priporočili proizvajalca, vendar vedno za najslabši scenarij.
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish