

Nadaljujemo temo zapisovanja velikih podatkovnih tokov, ki smo jo začeli , v tem pa bomo obravnavali načine, kako lahko zmanjšamo „fizično“ velikost shranjenih v PostgreSQL in njihov vpliv na zmogljivost strežnika.
Govora bo o nastavitvah TOAST in poravnavanju podatkov. „V povprečju“ ti načini ne bodo prihranili preveč virov, vendar - povsem brez modifikacije kode aplikacije.
Naše izkušnje pa so se izkazale za zelo produktivne na tem področju, saj je shranjevanje skoraj vseh monitoriranj po svoji naravi večinoma append-only glede na zapisane podatke. In če vas zanima, kako lahko naučite bazo pisati na disk namesto 200MB/s dvakrat manj - prosim, preberite naprej.
Majhne skrivnosti velikih podatkov
Glede na profil dela , redno prejemamo iz registrov besedilne pakete.
Ker , katere podatkovne baze monitoriramo, je večkomponentni produkt s kompleksnimi podatkovnimi strukturami, so tudi poizvedbe za dosego maksimalne zmogljivosti zelo . Tako da je obseg vsake posamezne poizvedbe ali rezultatnega načrta izvedbe v logu, ki ga prejmemo, v povprečju kar velik.
Poglejmo strukturo ene od tabel, v katero zapisujemo „surove“ podatke - torej izvirno besedilo iz registra:
CREATE TABLE rawdata_orig(
  pack -- PK
    uuid NOT NULL
, recno -- PK
    smallint NOT NULL
, dt -- ključ sekcije
    date
, data -- najpomembnejše
    text
, PRIMARY KEY(pack, recno)
);
Tipična takšna tabela (že sekcionirana, seveda, zato je to - predloga sekcije), kjer je najpomembnejše - besedilo. Včasih kar obsežno.
Ne pozabimo, da „fizična“ velikost enega zapisa v PG ne more biti večja od ene podatkovne strani, a „logična“ velikost - to je neka druga zgodba. Za zapis obsežnih vrednosti v polje (varchar/text/bytea) se uporablja :
PostgreSQL uporablja fiksno velikost strani (ponavadi 8 KB) in ne dovoljuje, da vloge zasedejo več strani. Zato neposredno shranjevanje zelo velikih vrednosti polj ni mogoče. Da bi premagali to omejitev, se velike vrednosti polj stisnejo in/ali razdelijo na več fizičnih vrstic. To se zgodi neopazno za uporabnika in ima le majhen vpliv na večino strežniške kode. Ta metoda je znana kot TOAST …
Dejansko se za vsako tabelo z "potencialno velikimi" polji samodejno vsake "velike" vnose na segmente po 2KB:
TOAST(
  chunk_id
    integer
, chunk_seq
    integer
, chunk_data
    bytea
, PRIMARY KEY(chunk_id, chunk_seq)
);
Torej, če imamo za zapisati vrstico z "veliko" vrednostjo data, se dejansko zapisovanje zgodi ne samo v glavno tabelo in njen PK, temveč tudi v TOAST in njen PK.
Zmanjšujemo vpliv TOAST
Toda večina vnosov kljub temu ni tako velika, v 8KB bi se morala prilegati — kako pri tem prihraniti?..
Tu nam pride v pomoč atribut pri stolpcu tabele:
- EXTENDED dovoli tako stiskanje kot tudi ločeno shranjevanje. To je standardna možnost za večino tipov podatkov, združljivih s TOAST. Najprej se poskuša izvesti stiskanje, nato pa se shrani izven tabele, če je vrstica še vedno prevelika.
- MAIN dovoli stiskanje, vendar ne ločenega shranjevanja. (Dejansko bo ločeno shranjevanje v tem primeru izvedeno za takšne stolpce, ampak le kot skrajna rešitev, ko ni druge možnosti za zmanjšanje vrstice, da bi se prilegala na stran.)
Dejansko točno to potrebujemo za besedilo — maksimalno stisniti, in če ne gre nikakor — prenesti v TOAST. To lahko storimo kar "v živo", z enim ukazom:
ALTER TABLE rawdata_orig ALTER COLUMN data SET STORAGE MAIN;Kako oceniti učinek
Ker se vsak dan pretok podatkov spreminja, ne moremo primerjati absolutnih številk, toda v relativnih je manjši delež zapisali v TOAST — tem bolje. Toda tukaj je nevarnost — čim večji je "fizični" obseg vsakega posameznega vnosa, tem "širši" postane indeks, ker mora pokriti večje število podatkovnih strani.
Oddelek pred spremembami:
heap  = 37GB (39%)
TOAST = 54GB (57%)
PK    =  4GB ( 4%)
Oddelek po spremembah:
heap  = 37GB (67%)
TOAST = 16GB (29%)
PK    =  2GB ( 4%)
Dejansko smo začeli zapisovati v TOAST dvakrat redkeje, kar je olajšalo ne le disk, ampak tudi CPU:
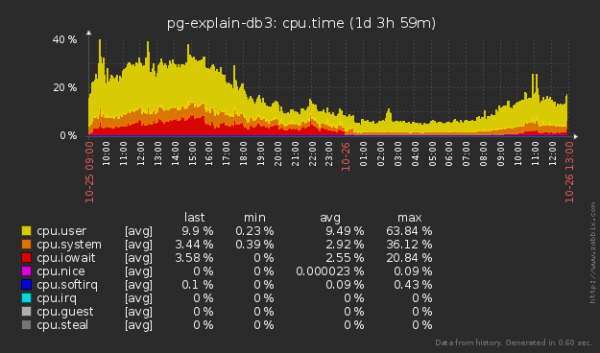
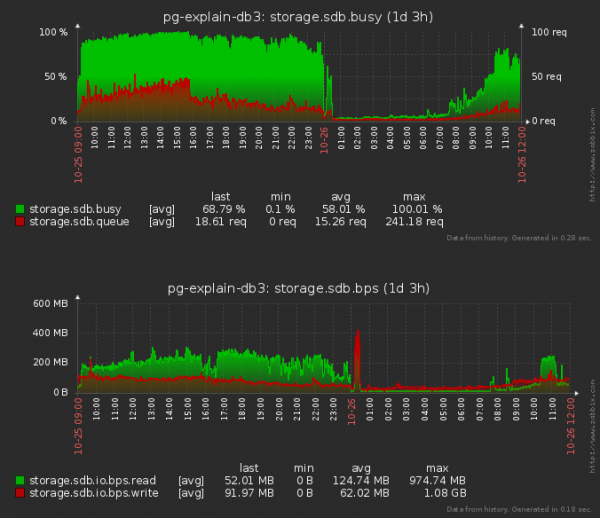
Opazil bom, da smo 'brali' disk manj, ne le 'pisali' - saj je pri vstavljanju zapisov v katero koli tabelo potrebno 'prebrati' tudi del drevesa vsakega od indeksov, da bi določili njegovo prihodnjo pozicijo v njih.
Komu je na PostgreSQL 11 lepo
Po nadgradnji na PG11 smo se odločili nadaljevati s 'fine-tuningom' TOAST in opazili, da je od te različice naprej na voljo parameter za nastavitev :
Koda za obdelavo TOAST se aktivira le, če je velikost niza, ki ga je treba shraniti v tabeli, večja od TOAST_TUPLE_THRESHOLD bajtov (običajno 2 Kb). Koda TOAST bo stiskala in/ali prenašala vrednosti polja izven tabele, dokler velikost niza ne bo manjša od TOAST_TUPLE_TARGET bajtov (spremenljiva velikost, običajno tudi 2 Kb) ali dokler ne bo mogoče zmanjšati obsega.
Odločili smo se, da so naši podatki običajno ali 'zelo kratki' ali 'zelo dolgi', zato smo se odločili omejiti na najmanjšo možno vrednost:
ALTER TABLE rawplan_orig SET (toast_tuple_target = 128);Poglejmo, kako so nove nastavitve vplivale na obremenitev diska po ponastavitvi:
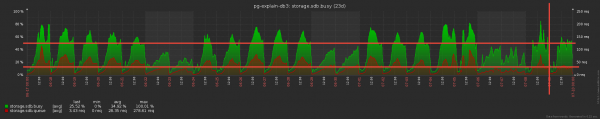
Ne slabo! Povprečna vrsta v vrsti do diska se je zmanjšala približno 1,5-krat, medtem ko je 'zasedenost' diska padla za 20%! Morda pa je to na kakšen način vplivalo na CPU?
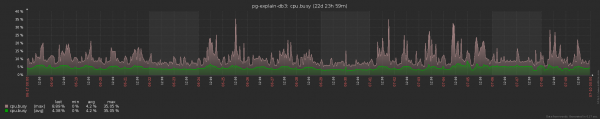
Vsaj slabše zagotovo ni postalo. Čeprav je težko presoditi, če tudi takšne količine še vedno ne morejo dvigniti povprečne obremenitve CPU nad 5%.
Izmenjava mestne zneske… se spreminja!
Kot je znano, peni varčuje rublje, in pri naših shranjevanjih okoli 10TB/mesec tudi majhna optimizacija lahko prinese dober dobiček. Zato smo pozorni na fizično strukturo svojih podatkov - kako točno 'so razporejeni' polja znotraj zapisa vsake od tabel.
Ker zaradi to neposredno :
Številne arhitekture predvidevajo poravnavo podatkov na mejah strojnih besed. Na primer, na 32-bitnem sistemu x86 bodo celi števili (tip integer, zasede 4 bajte) poravnani na meji 4-bajtnih besed, prav tako kot števila z dvojno natančnostjo (tip double precision, 8 bajtov). Na 64-bitnem sistemu bodo vrednosti double poravnane na meji 8-bajtnih besed. To je še en razlog za nezdružljivost.
Zaradi poravnanja, velikost tabelarne vrstice je odvisna od vrstnega reda postavitve polj. Običajno je ta učinek slabo opazen, vendar lahko v nekaterih primerih povzroči znatno povečanje velikosti. Na primer, če mešamo polja tipov char(1) in integer, bo med njimi praviloma 3 bajte izgubljenih.
Začnimo s sintetičnimi modeli:
SELECT pg_column_size(ROW(
  '0000-0000-0000-0000-0000-0000-0000-0000'::uuid
, 0::smallint
, '2019-01-01'::date
));
-- 48 bajtov

SELECT pg_column_size(ROW(
  '2019-01-01'::date
, '0000-0000-0000-0000-0000-0000-0000-0000'::uuid
, 0::smallint
));
-- 46 bajtov
Od kod so prišla dodatna dva bajta v prvem primeru? Preprosto — 2-bajtni smallint se poravna na 4-bajtno mejo pred naslednjim poljem, medtem ko, ko je zadnji, ni ničesar, kar bi se lahko poravnalo, in ni potrebe.
V teoriji je vse dobro in lahko premikamo polja po želji. Poglejmo to na realnih podatkih, na primeru ene od tabel, katere dnevni odsek zaseda 10–15GB.
Izvorna struktura:
CREATE TABLE public.plan_20190220
(
-- Podedovano iz tabele plan:  pack uuid NOT NULL,
-- Podedovano iz tabele plan:  recno smallint NOT NULL,
-- Podedovano iz tabele plan:  host uuid,
-- Podedovano iz tabele plan:  ts timestamp with time zone,
-- Podedovano iz tabele plan:  exectime numeric(32,3),
-- Podedovano iz tabele plan:  duration numeric(32,3),
-- Podedovano iz tabele plan:  bufint bigint,
-- Podedovano iz tabele plan:  bufmem bigint,
-- Podedovano iz tabele plan:  bufdsk bigint,
-- Podedovano iz tabele plan:  apn uuid,
-- Podedovano iz tabele plan:  ptr uuid,
-- Podedovano iz tabele plan:  dt date,
  CONSTRAINT plan_20190220_pkey PRIMARY KEY (pack, recno),
  CONSTRAINT chck_ptr CHECK (ptr IS NOT NULL),
  CONSTRAINT plan_20190220_dt_check CHECK (dt = '2019-02-20'::date)
)
INHERITS (public.plan)
Odsek po spremembi vrstnega reda stolpcev — enaki isti polji, le drugačen vrstni red:
CREATE TABLE public.plan_20190221
(
-- Podedovano iz tabele plan:  dt date NOT NULL,
-- Podedovano iz tabele plan:  ts timestamp with time zone,
-- Podedovano iz tabele plan:  pack uuid NOT NULL,
-- Podedovano iz tabele plan:  recno smallint NOT NULL,
-- Podedovano iz tabele plan:  host uuid,
-- Podedovano iz tabele plan:  apn uuid,
-- Podedovano iz tabele plan:  ptr uuid,
-- Podedovano iz tabele plan:  bufint bigint,
-- Podedovano iz tabele plan:  bufmem bigint,
-- Podedovano iz tabele plan:  bufdsk bigint,
-- Podedovano iz tabele plan:  exectime numeric(32,3),
-- Podedovano iz tabele plan:  duration numeric(32,3),
  CONSTRAINT plan_20190221_pkey PRIMARY KEY (pack, recno),
  CONSTRAINT chck_ptr CHECK (ptr IS NOT NULL),
  CONSTRAINT plan_20190221_dt_check CHECK (dt = '2019-02-21'::date)
)
INHERITS (public.plan)
Skupni obseg odseka se določi s številom „dejstev“ in je odvisen le od zunanjih procesov, zato bomo delili velikost heap (pg_relation_size) we will get the number of records in it — that is, we will obtain the average size of an actual stored record:
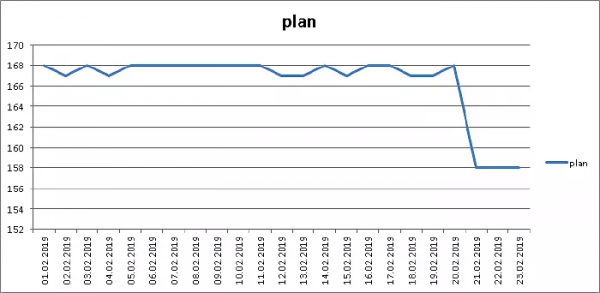
Minus 6% in volume, great!
But it’s not all that rosy — after all, we cannot change the order of fields in the indexes, and therefore "in general" (pg_total_relation_size)…
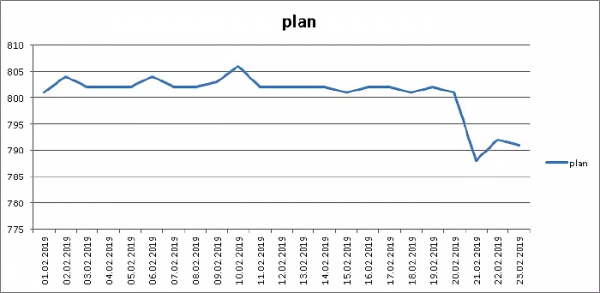
… still in this case we saved 1.5%, without changing any lines of code. Indeed!
I should note that the above arrangement of fields is not necessarily the most optimal. Because some blocks of fields we don’t want to "break apart" for aesthetic reasons — for example, a pair (pack, recno), which serves as the PK for this table.
Overall, defining the "minimal" arrangement of fields is a fairly simple "combinatorial" task. So you may achieve even better results with your data than we did — give it a try!
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish