

Na podlagi razprav v klepetu
V zadnjem času se resnično odvijajo bitke glede opredelitve pojma DevOps in SRE.
Kljub temu, da so se razprave o tej temi že nekoliko zasitile tudi pri meni, sem se odločil, da jo predložim v oceno skupnosti Habr in svoj pogled na to temo. Kdor ga zanima, dobrodošel pod kat. Naj se vse začne znova!
Pozadina
Nekoč je obstajala ločena ekipa razvijalcev programske opreme in skrbnikov strežnikov. Prvi so uspešno pisali kodo, drugi pa, s številnimi toplimi nežnimi besedami na račun prvih, nastavljali strežnike, občasno prihajali do razvijalcev in prejemali podrobno odgovor „na mojem računalniku deluje vse“. Poslovanje je čakalo na programsko opremo, vse je zastalo, občasno pokvarilo, vsi so bili nervozni. Še posebej tisti, ki je plačeval za vse to zmešnjavo. Čudovita, topla doba. A vi že veste, kje so korenine DevOps.
Rojstvo DevOps praks
Nato so prišli resni moški in rekli - to ni industrija, tako ne moremo delati. In prinesli so modele življenjskega cikla. Tukaj je na primer V-model.
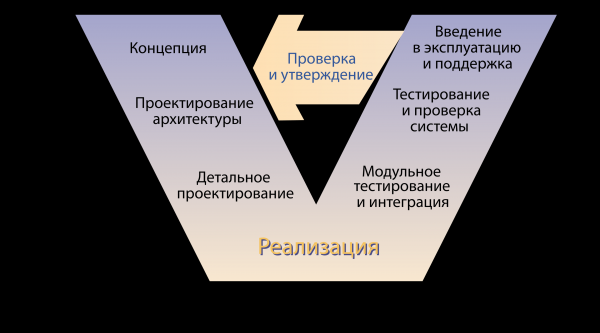
Torej, kaj vidimo? Poslovanje prihaja s konceptom, arhitekti načrtujejo rešitve, razvijalci pišejo kodo, nato - propad. Nekdo nekako testira izdelek, nekdo nekako ga dostavi končnemu uporabniku in nekje na izhodu tega čudovitega modela sedi osamljeni poslovni naročnik in čaka na obljubljeno vreme. Prišli so do zaključka, da so potrebne metode, ki bi omogočile ureditev tega procesa. Odločili so se vzpostaviti prakse, ki bi jih uresničevale.
Lirično odstopanje glede tega, kaj je praksa
Pod prakso razumem povezavo tehnologije in discipline. Primer - praksa opisovanja infrastrukture s kodo na terraform. Disciplina je to, kako opisati infrastrukturo s kodo, to je v mislih razvijalca, tehnologija pa je pravzaprav terraform.
In the end, they decided to call them DevOps practices — I think they meant from Development to Operations. They coined various complex terms — CI/CD practices, practices based on the IaC principle, thousands of them. And off we went; developers write code, DevOps engineers transform system descriptions into code that becomes operational systems (yes, code is unfortunately just a description, not the embodiment of the system), delivery is spinning, and so on. Former administrators, mastering new practices, proudly retrained as DevOps engineers, and it all started. And there was evening, and there was morning… sorry, wrong context.
Everything is once again not going well.
Just as everything calmed down, various clever 'methodologists' began writing thick books on DevOps practices, quietly sparking debates on who the infamous DevOps engineer really is and that DevOps is a culture of production, discontent began to brew again. Suddenly, it became clear that software delivery is an absolutely non-trivial task. Each development infrastructure has its own stack; somewhere you need to assemble, somewhere you need to deploy the environment, here you need Tomcat, there you need some uniquely crafted launch method — in general, it’s overwhelming. Additionally, the problem, strangely enough, turned out to be primarily in organizing processes — this delivery function, like a bottleneck, started to block the processes. Moreover, production (Operations) was not canceled. It is not visible in the V-model, and there is the entire lifecycle on the right. Ultimately, you need to maintain the infrastructure, monitor it, manage incidents, and also deal with delivery. That is, you have to straddle both development and operations — and suddenly Development & Operations was born. On top of that, there was a widespread hype about microservices. With that, development started moving from local machines to the cloud — good luck debugging locally with dozens or hundreds of microservices, where constant delivery becomes a means of survival. For a 'small modest company', it's manageable, but still? What about Google?
SRE from Google
Prišel je Google, pojedel največje kaktuse in se odločil - to nam ne ustreza, potrebujemo zanesljivost. Zanesljivost je treba upravljati. Odločil se je, da potrebujemo strokovnjake, ki bodo upravljali zanesljivost. Imenoval jih je SRE in jim rekel, tu imate vse, naredite, kot je običajno, dobro. Tu imate SLI, tu imate SLO, tu imate nadzor. In jih je usmeril k operacijam. Svoj „zanesljiv DevOps“ je poimenoval SRE. Zdi se, da je vse v redu, a obstaja ena umazana pot, ki si jo je Google lahko privoščil - na mesto SRE inženirjev zaposlovati ljudi, ki so imeli znanje razvijalcev in se še malo spoznali na delujoče sisteme. In tudi Google ima težave pri zaposlovanju takih ljudi - predvsem zato, ker sam s sabo tekmuje - nekdo mora opisovati tudi poslovno logiko. Dostavo je prepustil inženirjem za izdaje, SRE inženirji upravljajo zanesljivost (jasno, ne neposredno, ampak z vplivom na infrastrukturo, spreminjanjem arhitekture, spremljanjem sprememb in kazalnikov, ter reševanjem incidentov). Lepo, lahko . Kaj pa, če niste Google in vas zanesljivost vseeno skrbi?
Razvoj idej DevOps
Tukaj je prav prišel Docker, ki je zrasel iz lxc, nato različni sistemi orkestracije, kot sta Docker Swarm in Kubernetes, in inženirji DevOps so si oddahnili - unifikacija praks je poenostavila dostavo. Poenostavila je do te mere, da je bilo mogoče celo predati dostavo razvijalcem - kaj pa je tam deployment.yaml. Kontejnerizacija rešuje problem. In zrelost sistemov CI/CD je že na ravni enega napisanega datoteka in vse se je začelo - razvijalci se bodo sami znašli. In tukaj začnemo govoriti, kako narediti svoj SRE, s... ja, kar s komerkoli.
SRE ne v Google
No ok, we’ve handed over the delivery, it seems we can finally breathe and return to the good old days when admins monitored CPU loads, optimized systems, and quietly sipped something mysterious from their mugs in tranquility… Wait. That’s not why we started this all (what a pity!). Suddenly, it turns out that in Google's approach, we can take excellent practices — it's not CPU loads that matter, nor how often we change disks, or how we optimize costs in the cloud, but business metrics — those same notorious SLx metrics. And nobody has taken the management of infrastructure off our hands, we still need to handle incidents, occasionally be on duty, and generally stay on top of business processes. And guys, start programming at a good level little by little, Google is waiting for you.
In summary. Suddenly, but you’re already tired of reading this and can’t wait to comment to the author of the article. DevOps, as a delivery practice, has existed, exists, and will continue to exist. And it won’t go anywhere. SRE, as a set of operational practices, makes that very delivery successful.
Izvor: habr.com
