

Dovolite mi, da vam povem tehnično zgodbo.
Pred mnogimi leti sem razvijal aplikacijo z vključenimi funkcijami za sodelovanje. To je bil priročen eksperimentalni sklad, ki je izkoristil celoten potencial zgodnjega Reacta in CouchDB. V realnem času je sinhroniziral podatke preko JSON. . Uporabljali so ga v notranjem delu podjetja, vendar je bila široka uporabnost in potencial na drugih področjih očitna.
Med poskusom prodaje te tehnologije potencialnim strankam smo se srečali z nepričakovanim oviranjem. V demo videu je naša tehnologija izgledala in delovala odlično, tukaj ni bilo nobenih težav. Video je prikazoval natančno to, kako deluje, in nič ni bilo simulirano. Izumili in kodirali smo realističen scenarij uporabe programa.
Dejansko je to postalo težava. Naš demo je deloval natančno tako, kot so vsi drugi simulirali delovanje svojih aplikacij. Konkretno, informacije so se takoj prenašale od A do B, tudi če so to bili veliki medijski datoteki. Po prijavi je vsak uporabnik videl nove vnose. Z aplikacijo so različni uporabniki lahko sodelovali pri istem projektu, tudi če je bilo internetno povezavo kje v vasi prekinjeno. To je implicitno zajeto v katerem koli videu o izdelku, narejenem v After Effects.
Čeprav so vsi vedeli, za kaj je gumb Refresh, nihče ni povsem razumel, da so spletne aplikacije, ki jih prosijo, da jih ustvarimo, običajno podvržene svojim omejitvam. In kaj se zgodi, če jih ne potrebujemo več, bo uporabniška izkušnja povsem drugačna. Večinoma so opazili, da lahko 'klepetajo', puščajoč sporočila sogovornikom, zato so se spraševali, kaj je drugače, na primer od Slacka. Uf-f-f!
Oblikovanje vsakodnevnih sinhronizacij
Če že imate izkušnje z razvojem programske opreme, vas mora motiti potreba, da si zapomnite, da večina ljudi ne more preprosto pogledati slike vmesnika in razumeti, kaj bo počel pri interakciji z njim. O tem, kar se dogaja v sami aplikaciji, niti ne govorimo. Zavedanje o tem, kaj lahko se zgodi — je v veliki meri rezultat znanja o tem, kaj se ne more zgoditi in kar se ne sme zgoditi. To zahteva ne samo ono što softver radi, već i kako su njegovi delovi usklađeni i komuniciraju jedni s drugima.
Klasičan primer ovog je korisnik koji dvadeset minuta gleda u spinner.gif, pitajući se kada će konačno rad završiti. Programer bi shvatio da je proces verovatno zavezan i da gif nikada neće nestati sa ekrana. Ova animacija imituje izvršavanje posla, ali nije povezana s njegovim stanjem. U takvim slučajevima neki tehničari vole prevrnuti očima, zapanjeni stepenom zablude korisnika. Ipak, primetite ko od njih pokazuje na pokretače sata i kaže da su oni zapravo nepomični?
U tome se sastoji suština vrednosti stvarnog vremena. Danas se baze podataka u stvarnom vremenu i dalje koriste veoma malo, i mnogi ih gledaju sumnjičavo. Većina takvih baza podataka aktivno se priklanja NoSQL stilu, zbog čega se obično koriste rešenja zasnovana na Mongo-u, o kojima je bolje zaboraviti. Međutim, za mene to znači udobnost rada s CouchDB, kao i istraživanje dizajna struktura koje će moći puniti podacima ne samo neki birokrata. Mislim da svoje vreme trošim efikasnije.
Ali prava tema ovog posta je ono što danas koristim. Ne svojom voljom, već zbog ravnodušno i slepo primenjene korporativne politike. Zbog toga ću napraviti Potpuno Poštenu i Nepristrasnu podelu između dva tesno povezana proizvoda za rad s bazama podataka u stvarnom vremenu Google-a.
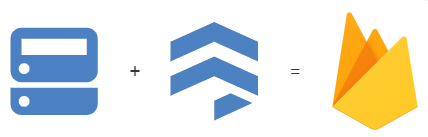
U nazivima oba ima reč Fire. Jedan se sa setom sećam. Drugi za mene predstavlja drugi oblik vatre. Ne žurim da kažem njihova imena, jer jedva da to uradim, suočićemo se s prvim velikim problemom — imenima.
Prvi se zove Firebase Real-Time Database, a drugi — Firebase Cloud Firestore. Oboje su proizvodi iz Firebase suite Google-a. Njihovi API-ji se zovu, redom, firebase.database(…) in firebase.firestore(…).
Tako je ispalo jer je Real-Time Database jednostavno izvorni Firebase pre nego što ga je Google kupio 2014. godine. Potom je Google odlučio da stvori paralelni proizvod kao kopiju kopa Firebase na osnovu velikih podataka kompanije, i nazvao je Firestore with a cloud. Nadam se da se još niste zbunili. Ako ste se ipak zbunili, ne brinite, i sam sam prepisivao ovaj deo članka deset puta.
Zato što treba navesti Firebase v zvezi s Firebase, in Firestore v zvezi s Firebase, vsaj, da so vas pred nekaj leti razumeli na Stack Overflow.
Če bi obstajala nagrada za najslabše poimenovanje programske opreme, bi bil ta primer zagotovo eden izmed kandidatov. Hammingova razdalja med tema imenom je tako majhna, da zmede tudi izkušene inženirje, katerih prsti tipkajo eno ime, medtem ko misli zadevajo drugo. To so načrti, ki so propadli s strahotnim udarcem, zasnovani z najboljšimi nameni; izpolnili so prerokbo, da bo baza podatkov v ognju. In ne šalim se. Oseba, ki je zasnovala to shemo poimenovanja, je postala vzrok za kri, znoj in solze.
Pirova zmaga
Lahko bi pomislili, da je Firestore nadomestilo Firebase, njegov naslednik naslednje generacije, vendar bi to bila zmota. Firestore zagotovo ni primeren kot nadomestilo za Firebase. Zdi se, da je nekdo iz njega izrezal vse zanimivo, veliko preostalega pa zmedel na različne načine.
Vendar lahko hitri pogled na dva izdelka zmede: zdi se, da delata isto, preko večinoma enakih API-jev in celo v istem seji baz podatkov. Razlike so težko opazne in jih odkrijemo le pri skrbnem primerjalnem pregledu obsežne dokumentacije. Ali ko poskušate prenesti kodo, ki deluje brezhibno na Firebase, da bi delovala s Firestore. Takrat že ugotovite, da se vmesnik baze podatkov vžge, takoj ko poskušate izvesti povleci in spusti v realnem času. Še enkrat, ne šalim se.
Odjemalec Firebase je vljuden v tem smislu, da predpomni spremembe in izvaja samodejno ponavljanje poskusov posodobitve, pri čemer daje prednost zadnji operaciji zapisa. Vendar Firestore omejuje na 1 operacijo zapisa na dokument na uporabnika na sekundo, kar omejuje strežnik. Pri delu z njim se morate sami potruditi, da najdete način za obhod te omejitve in implementacijo omejevalnika hitrosti posodobitev, tudi ko poskušate ustvariti svojo aplikacijo. Torej je Firestore baza podatkov v realnem času brez stranke v realnem času, ki se maskira kot taka s pomočjo API.
Na tem, mi začnemo videti prve znake smisla obstoja Firestore. Morda se motim, vendar sumim, da je nekdo visoko v vodstvu Googla po nakupu Firebase samo rekel: "Ne, o moj bog, ne. To je nesprejemljivo. Samo ne pod mojim vodstvom."
Pojavil se je iz svojih prostorov in razglasil:
"Eden velik dokument JSON? Ne. Podatki bodo razdeljeni na ločene dokumente, vsak od njih ne sme presegati 1 megabajta."
Zdi se, da takšno omejitev ne bo preživela prvega srečanja z dovolj motivirano bazo uporabnikov. Veste, da je to res. Pri nas na delu imamo na primer več kot poltretjega tisoča predstavitev, in to je popolnoma normalno.
Ob takšni omejitvi se boste morali sprijazniti s tem, da en "dokument" v bazi podatkov ne bo podoben nobenemu objektu, ki bi ga uporabnik lahko poimenoval dokument.
"Matrike matrik, ki lahko rekurzivno vsebujejo druge elemente? Ne. Matrike bodo vsebovale le objekte ali števila fiksne dolžine, kot je bilo zamišljeno s strani Gospoda."
Zato, če ste upali v svojo Firestore umestiti GeoJSON, boste ugotovili, da je to nemogoče. Nihče ne dovoljuje nič neprenormalnega. Upam, da imate radi Base64 in/ali JSON znotraj JSON.
"Uvoz in izvoz JSON prek HTTP, orodja za ukazno vrstico ali nadzorna plošča? Ne. Lahko boste le izvozili in uvozili podatke v Google Cloud Storage. Tako se, zdi se, zdaj imenuje. In ko rečem 'vi', mislim samo na tiste, ki imajo pooblastila Project Owner. Vsi ostali lahko gredo in ustvarijo tikete."
Kot vidite, je model podatkov FireBase enostavno opisati. Vsebuje en velik dokument JSON, ki povezuje JSON ključe s potmi URL. Če zapišete z uporabo HTTP PUT u / FireBase naslednje:
{
  "hello": "world"
}
Potem GET /hello vrne "world". Na splošno to deluje točno tako, kot pričakujete. Zbirka objektov FireBase /my-collection/:id je ekvivalentna JSON slovarju {"my-collection": {...}} v korenu, vsebina je dostopna v /my-collection:
{
  "id1": {...object},
  "id2": {...object},
  "id3": {...object},
  // ...
}
To deluje odlično, če ima vsak vstavljen ID brez kolizij, za kar ima sistem standardno rešitev.
Drugimi besedami, baza podatkov je 100% združljiva z JSON (*) in odlično deluje s HTTP, na primer, s CouchDB. Vendar jo večinoma uporabljate prek API-ja v realnem času, ki abstrahira websockets, avtentifikacijo in naročnine. Administratorska plošča ima obe možnosti, kar omogoča tako urejanje v realnem času kot tudi uvoz/izvoz JSON-a. Če se boste v svoji kodi držali tega, boste presenečeni, koliko specializirane kode bo izginilo, ko boste razumeli, da patch in diff JSON omogočata rešitev 90% rutinskih nalog pri obdelavi trajnega stanja.
Podatkovni model Firestore je podoben JSON-u, vendar se v nekaterih kritičnih vidikih razlikuje od njega. Že sem omenil pomanjkanje tabel v tabelah. Model pod-collection je zasnovan tako, da so koncepti prvega razreda, ločeni od dokumenta JSON, ki jih vsebuje. Ker ne obstaja nobena pripravljena serializacija, za pridobivanje in zapisovanje podatkov potrebujete specializirano pot izvajanja kode. Za obdelavo lastnih zbirk morate napisati svoje skripte in orodja. Administratorska plošča vam omogoča, da opravite le majhne spremembe na enem polju naenkrat in nima možnosti uvoza/izvoza.
Vzeli so podatkovno bazo NoSQL v realnem času in jo spremenili v počasno ne-SQL z avtozdruževanjem in ločenim stolpcem ne-JSON. Nekaj v stilu GraftQL.
Zagret Java
Če naj bi Firestore postal bolj zanesljiv in razširljiv, je ironija v tem, da bo povprečni razvijalec prejel manj zanesljivo rešitev, kot če bi izbral FireBase ‘iz škatle’. Programska oprema, ki jo potrebujete za Mrzlega Administratorja Baze Podatkov, zahteva takšno raven truda in kalibra strokovnjakov, da je to preprosto nerealistično za nišo, v kateri naj bi bil dober izdelek. To je podobno temu, kot da HTML5 Canvas nikakor ni zamenjava za Flash, če ni orodij za razvoj in predvajalnika. Poleg tega se je Firestore ujela v prizadevanju za čistost podatkov in sterilno validacijo, kar preprosto ne ustreza načinom, kako povprečni poslovni uporabnik rad dela: zanj ni vse nujno, ker na koncu vse ostaja osnutek.
Glavni nedostatak FireBase-a je to što je klijent napravljen nekoliko godina pre svog vremena, još pre nego što su većina web programera saznala o imutabilnosti. Zbog ovog FireBase pretpostavlja da ćete menjati podatke, pa ne koristi prednosti koje pruža imutabilnost. Pored toga, ne koristi podatke ponovo u snapshot-ima koje korisnik dobija, zbog čega je razlika daleko teža za izvršavanje. Za velike dokumente, njegov mehanizam transakcija baziran na promenljivim razlikama je jednostavno neadekvatan. Momci, već imamo WeakMap u JavaScript-u. To je zgodno.
Ako se podacima da odgovarajući oblik, i ne pravi prevelika stabla, ovu problematiku je moguće zaobići. Ali me zanima, da li bi FireBase bio mnogo zanimljiviji da su programeri izbacili stvarno dobar klijentski API koji koristi imutabilnost zajedno sa ozbiljnim praktičnim savetima o strukturi baza podataka. Umesto toga, izgleda da su pokušali da poprave ono što nije pokvareno, i to je samo pogoršalo situaciju.
Ne znam svu logiku koja je stajala iza stvaranja Firestore-a. Razmišljanja o motivima unutar crne kutije su takođe deo zabave. Takvo suprotstavljanje dva izuzetno slična, ali nesrazmerna baze podataka se retko sreće. Kao da je neko pomislio: „Firebase je samo funkcija koju možemo emulirati u Google Cloud-u“, ali pritom još nije otkrio koncept definisanja zahteva iz stvarnog sveta ili kreiranja korisnih rešenja koja zadovoljavaju sve te zahteve. „Neka o tome misle programeri. Samo učinite UI lepim... A možemo li dodati više vatre?“
Razumem nekoliko stvari o strukturama podataka. Jasno vidim da je koncepcija „sve u jednom velikom JSON stablu“ pokušaj da se iz baze podataka odstrani bilo kakvo osećanje za velike strukture. Očekivati da će softver jednostavno da se izbori sa bilo kojim sumnjivim fraktalom strukture podataka je jednostavno ludost. Ne treba mi ni da zamislim koliko loše može biti, obavljao sam rigorozne revizije koda i video sam stvari o kojima vi, ljudi, ni ne sanjate. Ali takođe znam kako izgledaju dobre strukture, in Lahko si predstavljam svet, kjer bi se Firestore zdela povsem smiselna, ljudje, ki so jo ustvarili, pa bi menili, da so opravili dobro delo. Ampak ne živimo v tem svetu.
Podpora za gradnjo poizvedb v FireBase je slaba po katerikoli meri, skoraj je ni. Nedvomno potrebujemo izboljšave ali vsaj pregled situacije. A Firestore ni veliko boljša, saj je omejena na iste enodimenzionalne indekse, ki jih najdemo v preprostem SQL-u. Če potrebujete poizvedbe, ki jih ljudje izvajajo z naključnimi podatki, potrebujete polno besedno iskanje, filtre za več razponov in poljubno urejanje s strani uporabnikov. Ob natančnejšem pregledu so funkcije preprostega SQL-a same po sebi preveč omejene. Poleg tega edini SQL-poizvedbe, ki jih ljudje lahko izvajajo v produkciji, so hitre poizvedbe. Potrebovali boste specializirano rešitev za indeksiranje s premišljenimi podatkovnimi strukturami. Za vse ostalo bi vsaj morala biti inkrementalna map-reduce ali kaj podobnega.
Če boste poiskali informacije o tem v dokumentaciji Googla, vas bodo upam da usmerili k čemu takemu kot sta BigTable in BigQuery. Vendar so vse te rešitve obremenjene s tako velikim volumnom gostega korporativnega žargona, da se boste hitro vrnili nazaj in začeli iskati nekaj drugega.
Zadnja stvar, ki jo potrebujete pri bazi podatkov v realnem času, je nekaj ustvarjenega za ljudi in od ljudi, ki delujejo na temelju plač vodstva.
(*) To je šala, ne obstaja tak koncept kot .
V okviru oglaševanja
Iščete strežnik za razvijanje in gostovanje projektov? Ste naš strankarski profil 🙂 Plačilo po dnevih za strežnike različnih konfiguracij, antiDDoS in licence Windows so že vključene v ceno.
Izvor: habr.com
