

Predlagam, da se seznanite z razlago poročila Romana Havronenka "ExtendedPromQL"
Na kratko o meni. Ime mi je Roman. Delam v CloudFlare, živim v Londonu. Sem tudi vzdrževalec VictoriaMetrics.
In sem avtor za Grafano in – to je majhen proxy za ClickHouse.
Začeli bomo s prvim delom, ki se imenuje 'Težave pri prevodu', kjer bom govoril o tem, da je vsak jezik ali celo preprosto komunikacijski jezik zelo pomemben. To je način, kako prenesete svoje misli drugemu človeku ali sistemu, kako oblikujete svoj zahtevek. Ljudje na internetu razpravljajo o tem, kateri jezik je boljši – java ali kateri drug. Zame sem se odločil, da izberem tistega, ki ustreza nalogi, saj je vse to specifično.
Začnimo od začetka. Kaj je PromQL? PromQL je jezik poizvedovanja Prometheus. To je način, kako oblikujemo poizvedbe v Prometheusu, da pridobimo časovne serije podatkov.
Kaj so podatki časovne serije? Če do dobesedno, so to trije parametri.
To je:
- Na kaj gledamo.
- Kdaj na to gledamo.
- In katero vrednost kaže.
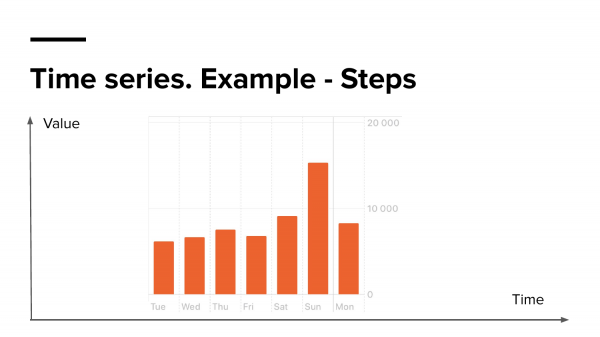
Če pogledamo to diagramo (to je diagram s mojega telefona, ki prikazuje statistiko mojih korakov), lahko hitro odgovorimo na ta vprašanja.
Gledamo na korake. Vidimo vrednost in vidimo čas, ko gledamo na to. To pomeni, da je preprosto reči, da sem v nedeljo prehodil približno 15.000 korakov. To so podatki časovne serije.
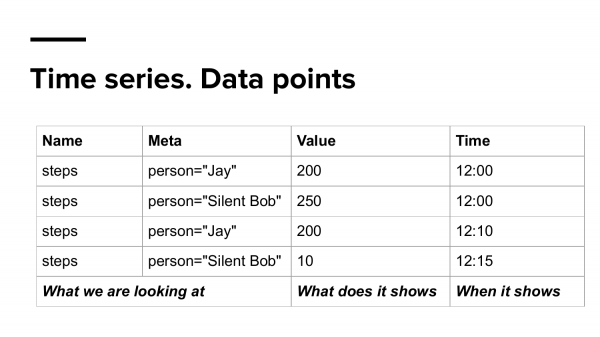
Zdaj razdelimo (pretvorimo) te podatke v drugo podatkovno strukturo v obliki tabele. Tu imamo spet to, na kar gledamo. Dodal sem dodatne podatke, ki jih bomo imenovali meta-podatki, torej to niso bili samo jaz, temveč dva človeka, recimo Jay in Silent Bob. To je tisto, na kar gledamo; kaj to prikazuje in kdaj prikazuje to vrednost.
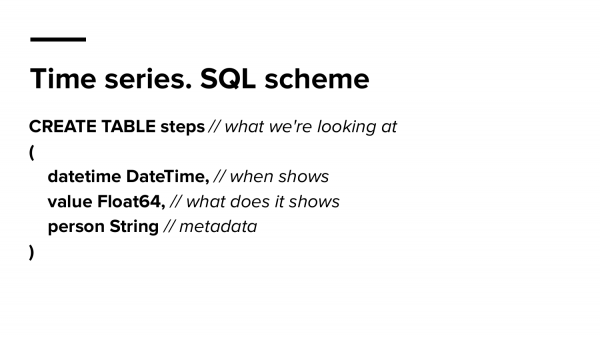
Zdaj poskusimo shraniti vse te podatke v bazo podatkov. Za primer sem vzel sintakso ClickHouse. Tukaj ustvarjamo eno tabelo, ki se imenuje 'Steps', torej na kar gledamo. Tam je čas, ko na to gledamo; kaj to prikazuje in nekaj meta-podatkov, kjer bomo shranili, kdo sta to: Jay in Silent Bob.
In da bi vse to poskušali vizualizirati, bomo uporabili Grafano, ker je to estetsko privlačno.
Tudi mi bomo uporabili ta vtičnik. Za to sta dva razloga. Prvi je, ker sem ga napisal. In točno vem, kako težko je pridobiti časovne serije iz ClickHouse, da jih prikažemo v Grafani.
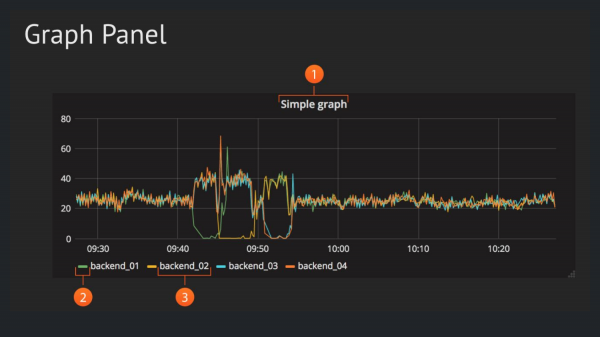
Prikazali bomo v Graf Panel. To je najbolj priljubljena plošča v Grafani, ki prikazuje odvisnost vrednosti od časa, zato potrebujemo le dva parametra.
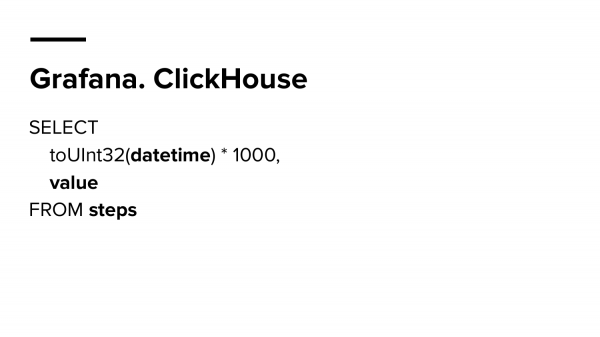
Napišimo najprej najprej najpreprostejši poizvedbo – kako prikazati statistiko korakov v Grafani, ki te podatke shranjuje v ClickHouse, v tisti tabeli, ki smo jo ustvarili. In napisali bomo takšno preprosto poizvedbo. Izberemo iz korakov. Izberemo vrednost in čas teh vrednosti, torej istih treh parametrov, o katerih smo govorili.
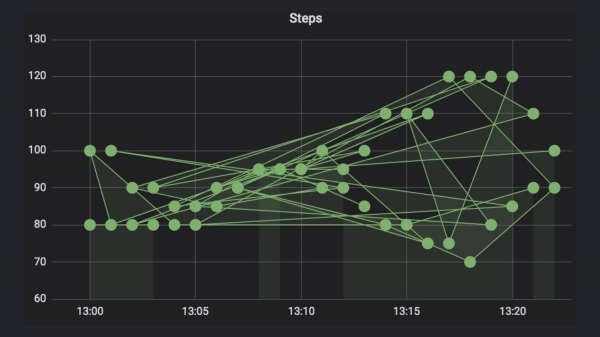
In rezultat bo tak graf. Kdo ve, zakaj je tako nenavaden?
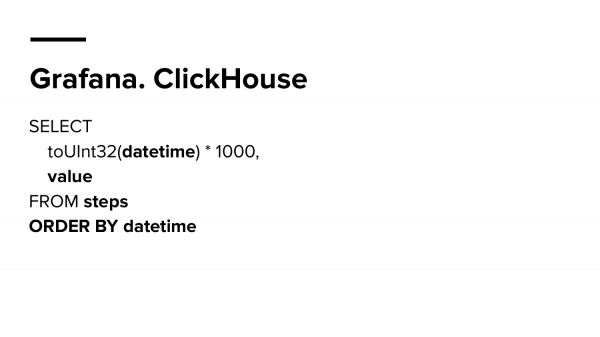
Prav, potrebno ga je razvrstiti po času.
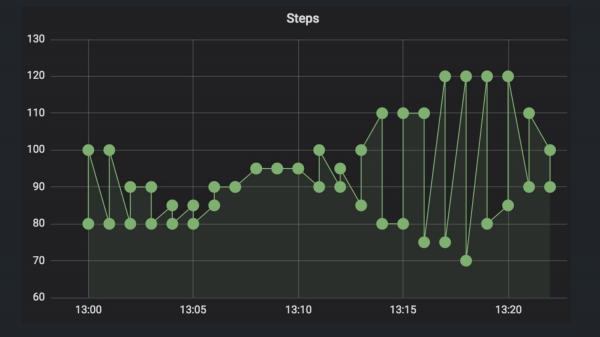
In na koncu bomo dobili že boljši, a še vedno nenavaden graf. Kdo ve, zakaj? Prav, tam sta dva udeleženca, in v Grafani posredujemo dve časovni seriji, ker če se ponovno poglobimo v podatkovni model, je vsaka časovna serija edinstvena kombinacija imena in vseh ključ-vrednostnih oznak.
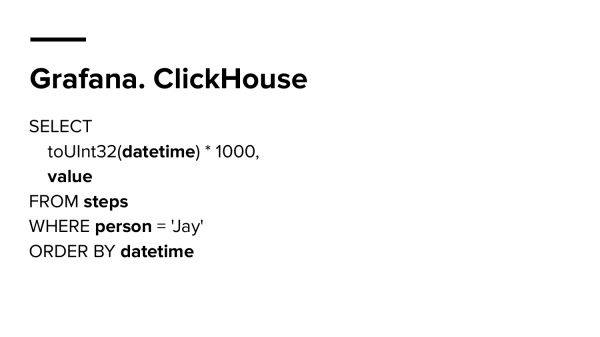
Zato moramo izbrati določenega človeka. Izberemo Jaya.

In narišemo še enkrat. Zdaj graf okusno spominja na resnico. Zdaj je to normalen graf in vse deluje dobro.
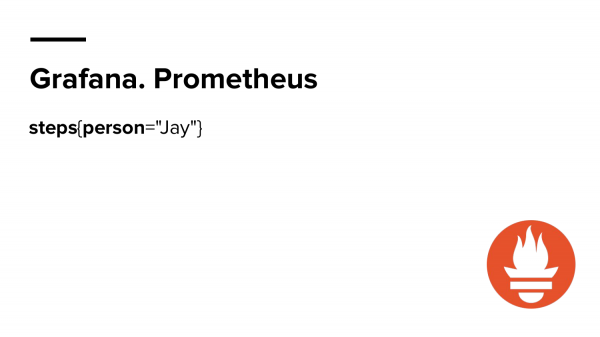
In verjetno veste, kako narediti približno enako, vendar v Prometheusu preko PromQL. Približno tako. Malenkost lažje. In še razdelili bomo vse to. Vzeli smo korake. In filtriramo po Jayu. Tu ne navajamo, da moramo pridobiti vrednost in ne izbiramo časa.
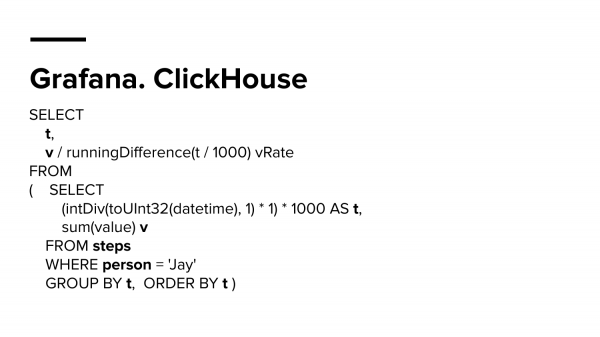
Zdaj poskusimo izračunati hitrost premikanja Jaya ali Silent Boba. V ClickHouse bomo morali uporabiti runningDifference, torej izračunati razliko med pari točk in jo deliti s časom, da dobimo natančno hitrost. Poizvedba bo izgledala približno takole.
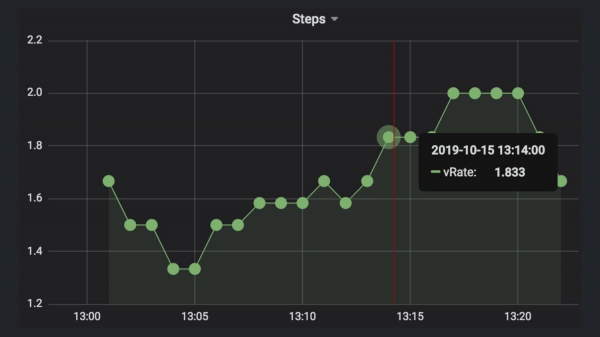
In prikazal bo približno takšne vrednosti, torej približno 1,8 koraka na sekundo dela Silent Bob ali Jay.
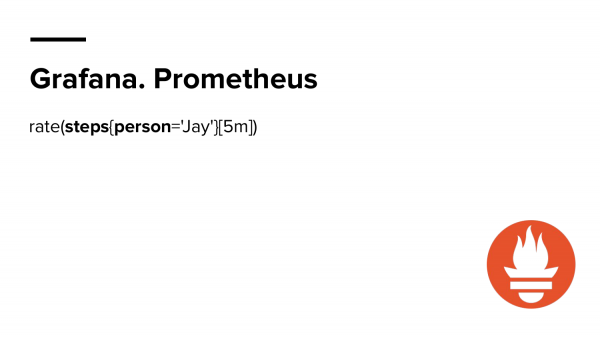
In v Prometheusu veste, kako to narediti tudi. Veliko lažje, kot je bilo prej.
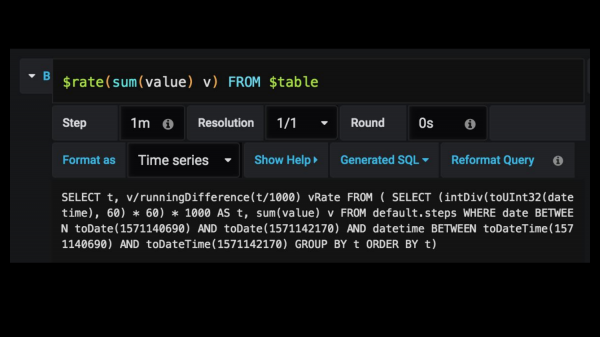 Da bi to ostalo jednostavno za rad u Grafani, dodao sam ovu omotnicu koja veoma slično izgleda kao PromQL. Zove se Rate Macros ili kako god želite da je nazovete. U Grafani jednostavno napišete „rate“, ali negde u dubini to se transformiše u ovako veliki upit. I ne morate ni da ga gledate, on je negde tu, ali štedite puno vremena, jer pisanje ovako ogromnih SQL upita je uvek skupo. Možete lako napraviti grešku i zatim dugo ne shvatati šta se događa.
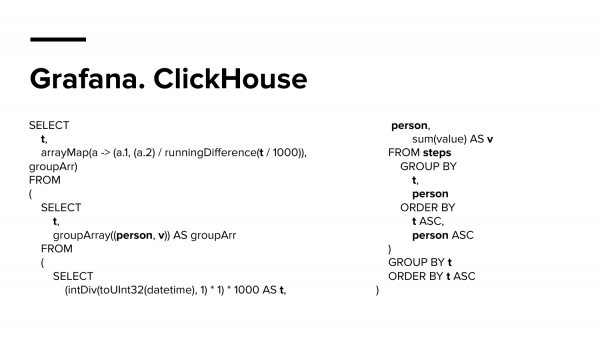
A ovo je upit koji se nije mogao stati čak ni na jedan slajd, pa sam ga morao razbiti na dve kolone. Ovo je takođe upit u ClickHouse-u koji radi isto što i rate, ali za obe vremenske serije: Silent Bob i Jay, da bismo imali dve vremenske serije na našem panelu. I to je već veoma komplikovano, po mom mišljenju.
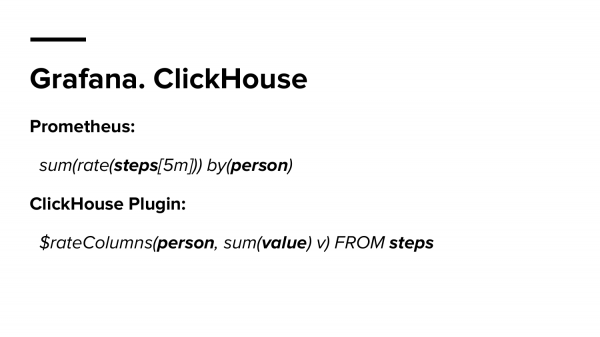
I za Prometheus to će biti sum(rate). Za ClickHouse sam napravio poseban makro koji se zove RateColumns, koji izgleda kao upit u Prometheus.
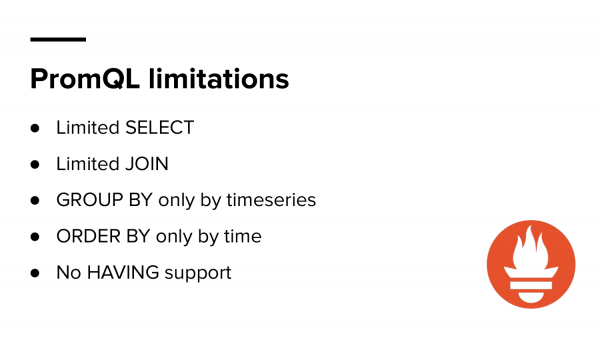
Pogledali smo i izgleda da je PromQL savršen, ali naravno da ima ograničenja.
To je:
- Ograničen SELECT.
- Granični JOIN.
- Nema podrške za HAVING.
I ako ste dugo radili sa njim, znate da je ponekad veoma teško uraditi nešto u PromQL, dok u SQL-u možete uraditi praktično sve, jer su svi ovi slučajevi koje smo sada razgovarali mogli da budu uradjeni u SQL-u. Da li bi to bilo praktično za korišćenje? To me navodi na pomisao da nije uvek najmoćniji jezik i najpraktičniji.
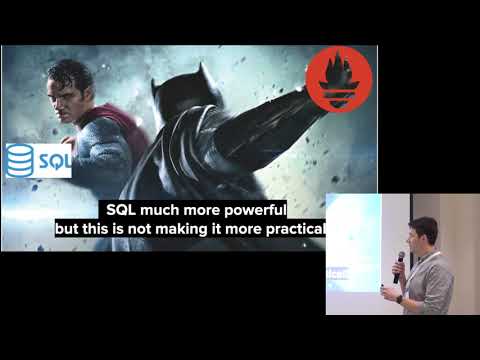
Zato ponekad treba birati jezik prema zadacima. To je kao borba Betmena sa Supermanom. Jasno je da je Superman jači, ali Betmen je uspeo da ga pobedi, jer je praktičniji i tačno je znao šta radi.
A sledeći deo je proširivanje PromQL.
Ponovo o VictoriaMetrics. Šta je VictoriaMetrics? To je time series baza podataka, open-source, distribuiramo njene single i cluster verzije. Prema našim benchmarkom, ona je najbrža na tržištu sada, a po kompresiji slično, tj. živi ljudi prijavljaju kompresiju negde oko 0,4 bajta po tački, dok je u Prometheus-u to 1,2-1,4.
Podržavamo ne samo Prometheus. Podržavamo InfluxDB, Graphite, OpenTSDB.
U nas možete "pisati", tj. možete prenositi stare podatke.
I još savršeno radimo sa Prometheus-om i Grafanom, tj. podržavamo PromQL engine. I u Grafani možete jednostavno promeniti Prometheus endpoint na VictoriaMetrics i svi vaši dashboardi će raditi kao i ranije.
Toda pa lahko uporabite dodatne funkcije, ki jih ponuja VictoriaMetrics.
Hitro bomo prešli skozi funkcije, ki smo jih dodali.
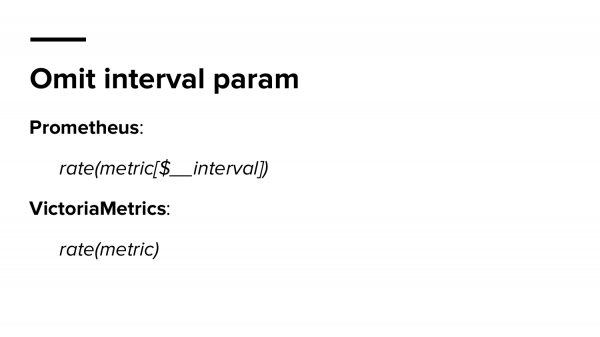
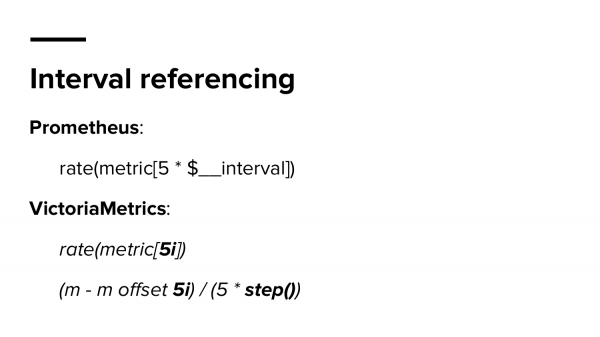
Omit interval param – lahko preskočite parameter interval v Grafani. Ko nočete prejeti nenavadnih grafik pri zoom-in/out na plošči, je priporočljivo uporabiti spremenljivko {$__interval}. To je interna spremenljivka Grafane in sama izbira podatkovni razpon. VictoriaMetrics pa lahko sama razume, kakšen ta razpon mora biti. In ni vam treba posodabljati vseh vaših poizvedb. Bodo veliko lažje.Druga funkcija je referencing intervala. Ta interval lahko uporabite v svojih izrazih. Lahko ga množite, delite, predajate, nanj se lahko sklicujete.
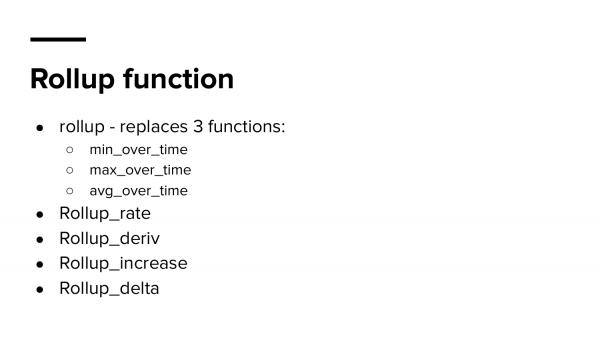
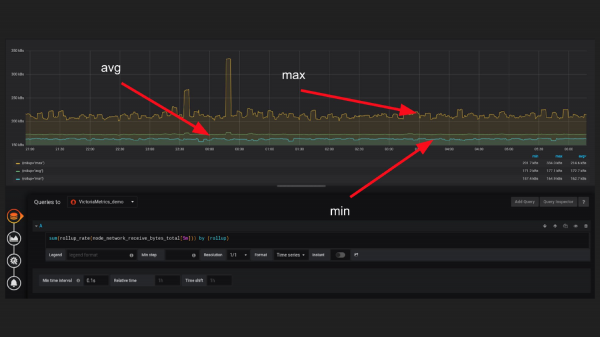
Nato družina rollup funkcij. Rollup funkcija transformira vaše časovne serije v tri ločene časovne serije. To so min, max in avg. Meni se zdi, da je to zelo priročno, ker včasih lahko pokaže nekatere anomalije in neusklajenosti.
In če preprosto uporabljate irate ali rate, verjetno lahko preskočite nekatere primere, ko se časovna serija obnaša drugače, kot ste predvidevali. S to funkcijo je veliko lažje videti, recimo, da je max zelo oddaljen od avg.
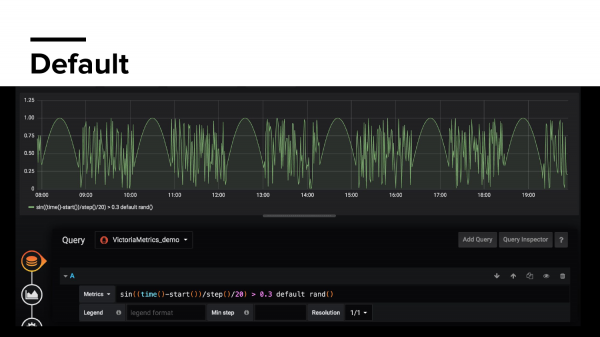
Naprej je spremenljivka default. Default pomeni, katero vrednost moramo prikazati v Grafani, če trenutno nimamo časovne serije. Kdaj se to zgodi? Na primer, izvažate neko metriko glede napak. In imate tako dobro aplikacijo, da ko ste jo zagnali, nimate napak in celo naslednje tri ure ali dan ni napak. In imate nadzorne plošče, ki prikazujejo razmerje med uspehom in napako. In pokazale vam bodo nič, ker nimate metrike napak. V default lahko navedete karkoli.
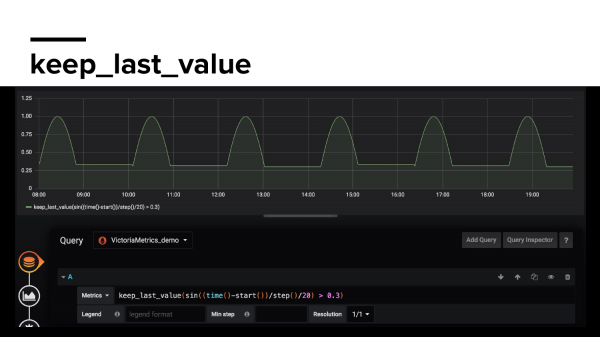
Keep_last_Value – shrani zadnjo vrednost metrike, če je ta izginila. Če Prometheus po naslednjem skriptu ne najde metrike v 5 minutah, bomo tukaj zapomnili njeno zadnjo vrednost in vaši grafi se ne bodo znova pokvarili.
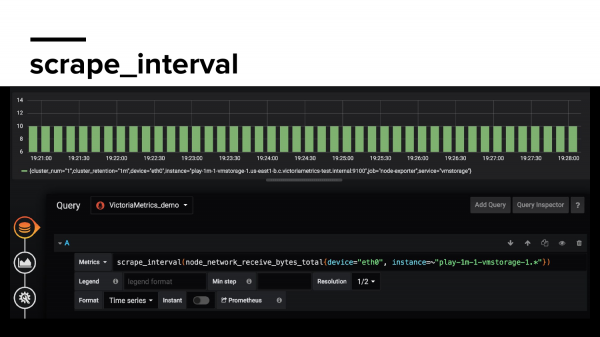
Scrape_interval – prikazuje, kako pogosto Prometheus zbira podatke o vaši metrični vrednosti, s kakšno frekvenco. Tukaj lahko vidite zamudo, na primer.
Label replace – priljubljena funkcija. Menimo pa, da je nekoliko zapletena, ker sprejema več argumentov. In morate se ne le spomniti 5 argumentov, temveč tudi njihov vrstni red.
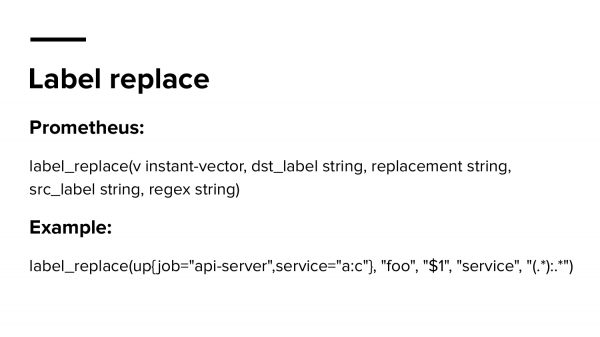
Label replace – популярная функция. Но мы считаем, что она немного сложная, потому что она принимает целых аргументов. И вам надо не только помнить 5 аргументов, но еще и помнить их последовательность.
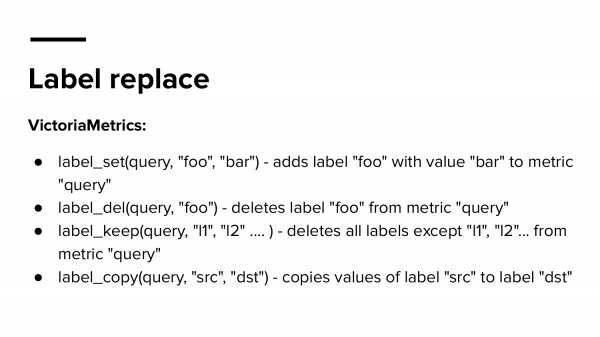
Zato, zakaj jih ne bi poenostavili? T. j. razbiti na manjše funkcije s pregledno sintakso.
In zdaj najbolj zanimivo. Zakaj menimo, da je to razširjeni PromQL? Ker podpiramo skupne tabelarne izraze. Oglejte si QR kodo (), si oglejte povezave z primeri, s playgroundom, kjer lahko izvajate poizvedbe neposredno v VictoriaMetrics brez namestitve, kar lahko storite preprosto v brskalniku.
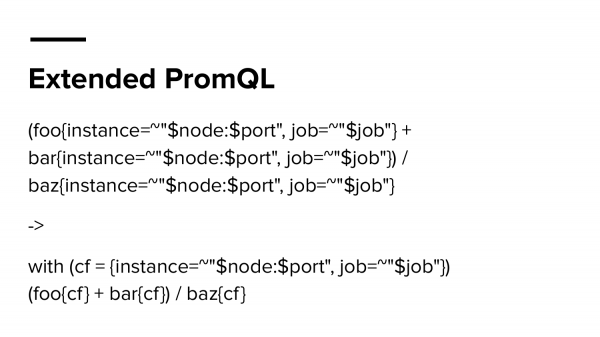
In kaj to sploh je? Ta zgornja poizvedba je precej priljubljena. Mislim, da v kateri koli nadzorni plošči v mnogih podjetjih uporabljate enak filter za vse. Običajno je tako. A ko morate dodati nov filter, morate posodobiti vsako ploščo ali prenesti nadzorno ploščo, jo odpreti v JSON-u, opraviti iskanje in zamenjavo, kar prav tako vzame čas. Zakaj tega vrednosti ne bi shranili v spremenljivko in jo ponovno uporabili? To se mi zdi veliko preprostejše in bolj razumljivo.
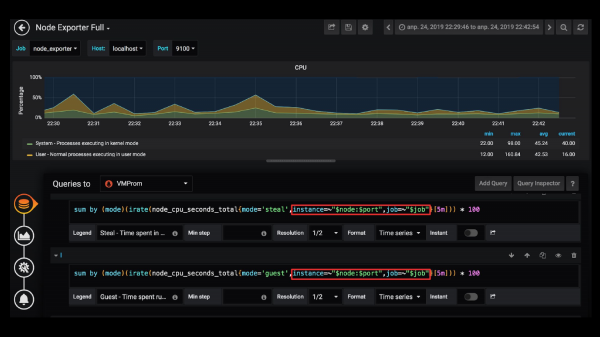
Na primer, ko moram posodabljati filtre v Grafani v vseh poizvedbah, nadzorna plošča pa je lahko ogromna ali jih je morda več. Kako bi želel rešiti to težavo v Grafani?
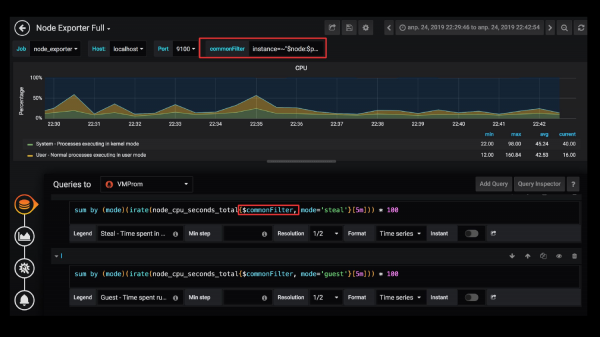
To težavo rešujem tako, da naredim commonFilter in v njem določim ta filter, nato pa ga ponovno uporabim v poizvedbah. A če sedaj storite prav tako, to ne bo delovalo, ker Grafana ne dovoli, da uporabljate spremenljivke znotraj spremenljivk poizvedb. To je malce čudno.
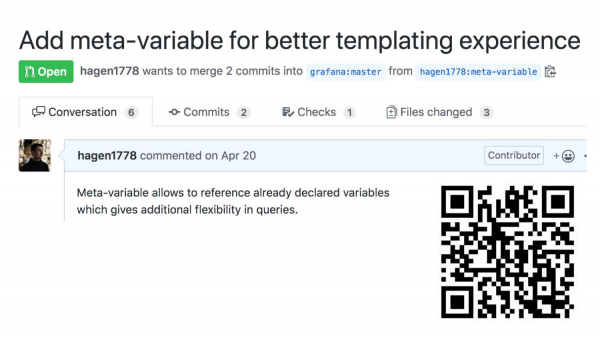
In zato sem naredil takšno različico, ki to omogoča. Če vas zanima ali želite to funkcijo, potem podprite to ali izrazite nezadovoljstvo, če vam ta ideja ni všeč.
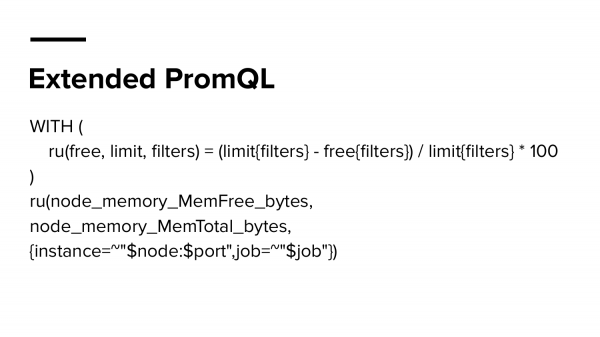
Naprej o razširjenem PromQL. Tukaj ne definiramo le spremenljivke, ampak kar celo funkcijo. Poimenujemo jo ru (poraba virov). Ta funkcija sprejema proste vire, omejitev virov in filter. Zdi se, da je sintaksa zelo preprosta in izjemno enostavno je uporabiti to funkcijo ter izračunati odstotek prostega pomnilnika. T. j. koliko pomnilnika imamo, kakšna je omejitev in kako filtrirati. To se zdi veliko bolj priročno, če bi vse to pisali, pri čemer bi ponovno uporabljali iste filtre, ker bi se to spremenilo v ogromen ogromen poizvedbeni stavek.
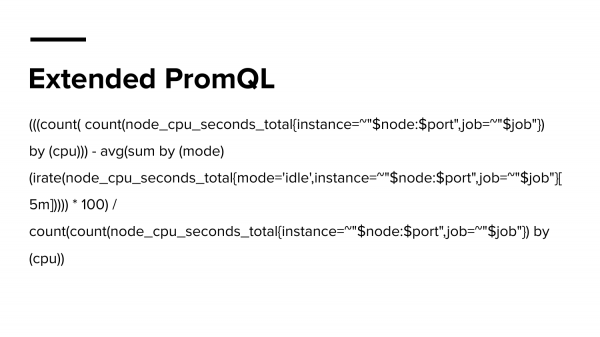
In this example, we have a very large query. It's from the official NodeExporter dashboard for Grafana. However, I have a limited understanding of what's happening here. I mean, I get it if I look closely, but the number of parentheses can quickly diminish the motivation to figure out what's going on. So why not make it simpler and clearer?
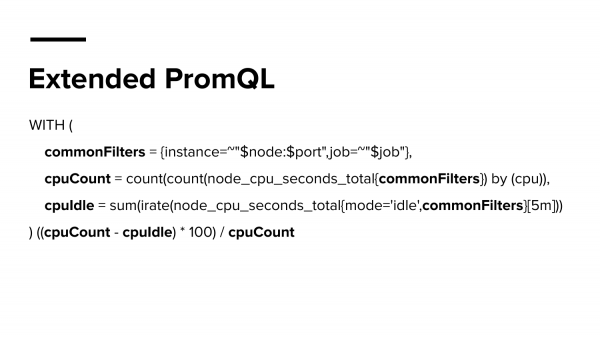
For instance, like this, highlighting important elements or parts in variables. Then perform your basic math. This already looks more like programming, and that's what I would like to see in the future in Grafana.
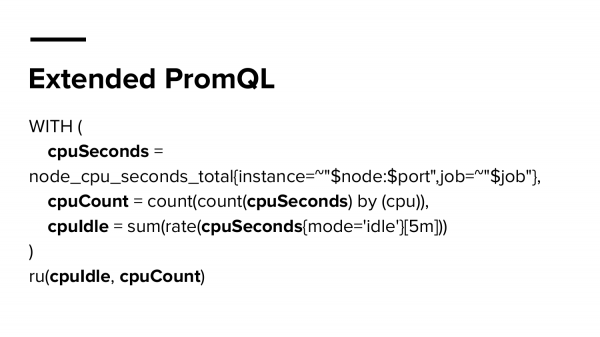
Here’s a second example of how we can make it even simpler if we already had that function 'ru', which is already available directly in VictoriaMetrics. Then you simply pass the cached value that you've defined in the CTE.
I've already talked about how important it is to use the right programming language. And probably in every company, something unique is happening in Grafana. You likely also provide access to Grafana to your developers, and they do their own thing. And they all do it in different ways. It would be nice to have some consistency, i.e., to standardize everything.
Suppose you not only have system engineers, but perhaps even experts, DevOps, or SREs. Maybe you have experts who know what monitoring is, who are familiar with Grafana, having worked with it for years, and they know exactly how to do it right. They've already written it a hundred times and explained it to everyone, yet for some reason, no one listens.
What if they could embed that knowledge directly into Grafana so that other users could reuse those functions? If they needed to calculate the percentage of free memory, they would just apply the function. What if the exporters' creators also provided a set of functions for working with their metrics along with their product because they know exactly what those metrics are and how to calculate them correctly?
This actually doesn't exist. I created this myself. This is library support in Grafana. Suppose the folks who made NodeExporter did what I described and also provided a set of functions.
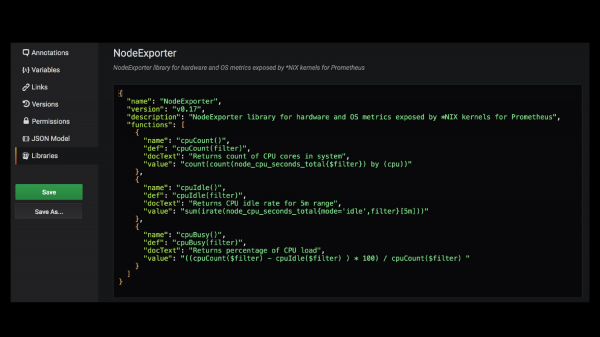
To je, kako to izgleda. Povežete to knjižnico v Grafano, vstopite v urejanje in tu je zelo preprosto napisano v JSON-u, kako delati s to metriko. To je, nek paket funkcij, njihovo opisovanje in v kaj se razvijajo.
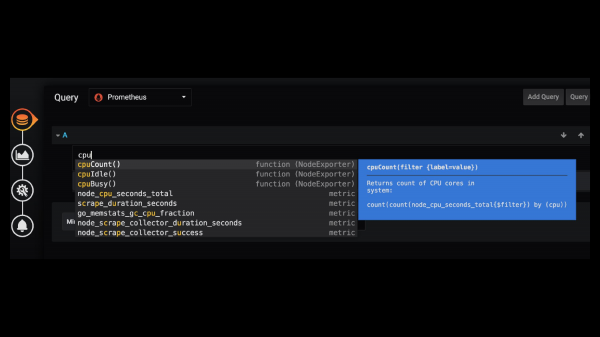
Po mojem mnenju bi to lahko bilo koristno, saj bi potem v Grafani preprosto pisali tako. In Grafana vam "pravi", da obstaja taka funkcija iz te knjižnice – pojdimo jo uporabiti. Mislim, da bi to bilo res super.
Malo o VictoriaMetrics. Delamo veliko zanimivih stvari. Preberite naše članke o kompresiji, o naših tekmovanjih z drugimi aplikacijami za podatkovne časovne vrste, naše razlage, kako delati s PromQL, saj je tu še veliko novincev, ter o vertikalni skalabilnosti in nasprotovanju Thanosu.
Vprašanja:
Začel bom svoje vprašanje s preprosto življenjsko zgodbo. Ko sem prvič začel uporabljati Grafano, sem napisal zelo prepričljiv poizvedbo dolžine 5 vrstice. Na koncu je nastal zelo prepričljiv graf. Ta graf se je skoraj odpravil v produkcijo. A ob podrobnejšem pregledu je bilo ugotovljeno, da ta graf kaže absolutno neumnost, ki nima nobene zveze z resničnostjo, čeprav številke padejo v razpon, ki smo ga pričakovali. In moje vprašanje. Imamo knjižnice, imamo funkcije, kako pa pišemo teste za Grafano? Napisali ste kompleksno poizvedbo, od katere je odvisna poslovna odločitev – naročiti pravi strežnik ali ne naročiti. In kako vemo, da ta funkcija, ki riše graf, izgleda kot resnica. Hvala.
Hvala za vprašanje. Tu sta dve strani. Prva - imam občutek, na podlagi svojih izkušenj, da večina uporabnikov, ko gleda svoje grafikone, ne razume, kaj jim prikazujejo. Nekako so ljudje zelo dobri v izmišljevanju opravičil za kakršne koli anomalije, ki se pojavijo na grafikah, celo če gre za napako v funkciji. In druga del - mislim, da bi bila uporaba takih funkcij veliko bolj primerna za rešitev vaše težave, namesto da bi vsak vaš razvijalec delal svoj načrt zmogljivosti in se zmotil z neko verjetnostjo.
Kako preveriti?
Kako preveriti? Verjetno nekako ne.
V obliki testa v Grafani.
Kaj ima Grafana s tem? Grafana posreduje to poizvedbo neposredno v DataSource.
Dodajamo malo v parametre.
Ne, v Grafana nič ne dodajajo. Tam so lahko GET-parametri, kot je na primer step. Ta se ne navaja izrecno, ampak ga lahko prepišete, lahko pa tudi ne, vendar se samodejno doda. Tukaj ne morete napisati testov. Menim, da se ne bi smeli zanašati na Grafano kot vir resnice.
Hvala za poročilo! Hvala za stiskanje! Omenili ste mapping spremenljivke v grafu, da v Grafani ne morete uporabiti spremenljivke znotraj druge spremenljivke. Razumete, o čem govorim?
Da.
To je bilo prvotno glavobol, ko sem želel narediti alert v Grafani. In tam je potrebno narediti alert za vsako napravo posebej. Ali ta zadeva, ki ste jo naredili, deluje za alerte v Grafani?
Če se Grafana ne obrača na spremenljivke na kak način drugače, potem - ja, delovala bo. Ampak moj nasvet je, da v Grafani sploh ne uporabljate alertiranja, bolje je uporabiti alertmanager.
Da, uporabljam ga, vendar se je v Grafani to zdelo lažje za nastavitev, vseeno hvala za nasvet!
Izvor: habr.com
