

In the summer, both consumer activity and the intensity of changes in web project infrastructure traditionally decrease, as Captain Obvious tells us. Simply because even IT professionals sometimes take vacations. And so do CTOs. It's tougher for those who remain on duty, but that's not the main topic: perhaps this is why summer is the best time to calmly reconsider the existing backup scheme and develop a plan for its improvement. Eгор Андреев's experience will be useful in this regard from , which he shared at the conference .
When building backup sites and dealing with backups, there are several pitfalls that one can fall into. And we definitely shouldn't fall into them. What ruins us in all this, as in many other things, is perfectionism and… laziness. We try to do everything perfectly, but perfection is not necessary! We should only focus on certain things, but do them right, finish them, so that they work properly.
Failover is not just some fun thing to have; it’s something that should do one clear thing—reduce downtime so that the service and company lose less money. In all backup methods, I suggest thinking in the following context: where is the money?
The first pitfall: when we build large reliable systems and work on backups, we reduce the number of failures. This is a terrible misconception. When we manage backups, we are likely increasing the number of failures instead. And if we do everything correctly, we can reduce the overall downtime. There will be more failures, but they will occur with lower costs. After all, what is backup?—it’s system complexity. Any complexity is bad: we have more screws, more gears, in short, more elements—thus, the chance of breakage increases. And they really will break. And they will break more often. A simple example: let’s say we have some website with PHP, MySQL, and it urgently needs to be backed up.
No, (c) We are taking the second site, building an identical system... The complexity doubles — we have two entities. Additionally, we are layering specific data transfer logic from one site to another — that is, data replication, static content copying, and so on. So, the replication logic is usually very complex, and therefore the cumulative complexity of the system can be not 2, but 3, 5, or even 10 times greater.
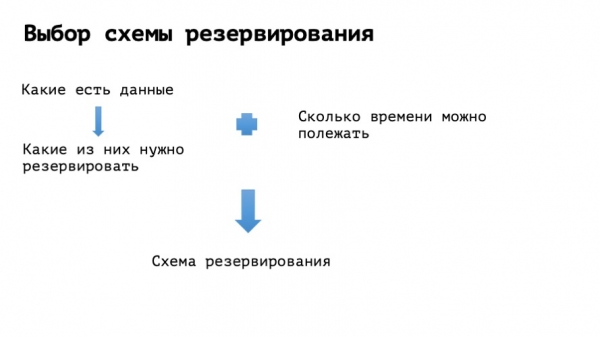
The second trap: when we build truly large complex systems, we fantasize about what we ultimately want to achieve. Voila: we want a super-reliable system that works with no downtime at all, switches in half a second (or better yet, instantly), and we start to turn our dreams into reality. But there is also a nuance here: the smaller the desired switching time, the more complex the system logic becomes. The more complicated we have to make this logic, the more often the system will fail. And one can find themselves in a very unpleasant situation: we are trying by all means to reduce downtime, but in reality, we are complicating everything, and when something goes wrong, the downtime ends up being greater. Often you catch yourself thinking: better not to reserve. It would be better if it worked alone with a clear downtime.
How can we counter this? We need to stop lying to ourselves, stop flattering ourselves that we are going to build a spaceship, but realistically understand how long the project might take. And based on this maximum time, we will choose the methods we will use to increase the reliability of our system.
It's time for 'stories from life'... from life, of course.
Example number one
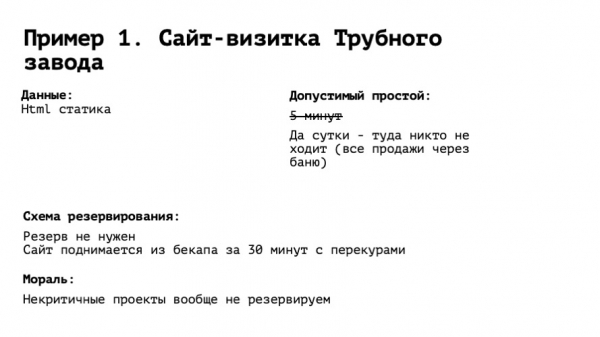
Predstavljajte si spletno vizitko ceviške tovarne številka 1 v mestu N. Na njej je v velikih črkah napisano – CEVIŠKA TOVARNA ŠTEVILKA 1. Malo nižje je slogan: „Naše cevi so najbolj okrogle cevi v N“. In spodaj je telefonska številka generalnega direktorja ter njegovo ime. Zavedamo se, da je treba rezervirati – to je zelo pomembna stvar! Začnemo raziskovati, iz česa vse to sestavlja. Html-statičnost – torej nekaj slik, kjer generalni direktor sedi za mizo v savni s svojim partnerjem in razpravljata o kakšni trenutni pogodbi. Začnemo razmišljati o času nedelovanja. Na misel mi pride: tam ležati je treba pet minut, ne več. In tukaj se postavi vprašanje: koliko prodaj je bilo sploh s te naše spletne strani? Koliko, koliko? Kaj pomeni „nič“? To pomeni, da so vse štiri pogodbe iz preteklega leta generalni direktor sklenil za isto mizo, s tistimi istimi ljudmi, s katerimi hodijo v savno in sedijo za mizo. In ugotavljamo, da tudi če bi spletna stran en dan ležala – ne bi bilo nič strašnega.
Glede na izhodišča imamo dan za dvig te zgodbe. Začnemo razmišljati o shemi rezervacije. In izberemo najbolj idealno shemo za rezervacijo v tem primeru: rezervacije ne potrebujemo. Vse to lahko dvigne kateri koli administrator v pol ure z odmori. Namestiti spletni strežnik, naložiti datoteke – vse. Delovalo bo. Ničesar ni treba spremljati, ničesar ni treba posebej pozorni. Torej, zaključek iz primera številka ena je kar očiten: storitve, ki jih ni treba rezervirati – ni treba rezervirati.
Primer številka dva
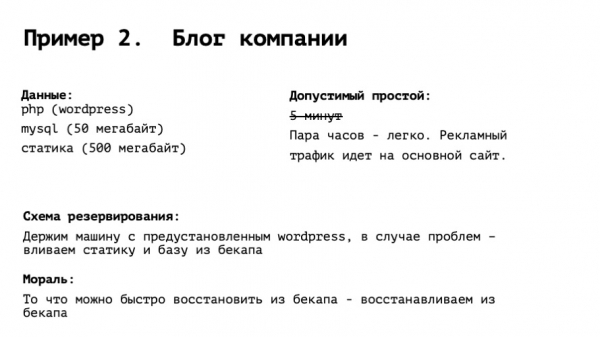
Podjetniški blog: posebni usposobljeni ljudje pišejo novice, tu smo sodelovali na določeni razstavi, tu je izšel še en nov izdelek in tako naprej. Recimo, da je to standardni PHP z WordPress, majhna baza podatkov in malo statike. V misli se spet pojavijo pomisleki, da nikakor ne smemo pospravljati — 'ne več kot pet minut!', to vse. Ampak razmislimo še naprej. Kaj ta blog počne? Vanj prihajajo obiskovalci iz Yandexa, iz Googla po nekaterih iskalnih poizvedbah, po naravni poti. Super. Kako pa je to povezano s prodajo? Razsvetljenje: ne posebej. Oglaševalski promet gre na glavno spletno mesto, ki je na drugem strežniku. Začnemo razmišljati o načrtu rezervacije bloga. V resnici ga je treba dvigniti v dveh urah in prav bi bilo, da se na to pripravimo. Razumljivo bi bilo najeti stroj v drugem podatkovnem središču, na njega namestiti okolje, to je spletni strežnik, PHP, WordPress, MySQL, in to pustiti v mirovanju. V trenutku, ko spoznamo, da je vse broken, je potrebno narediti dve stvari — obnoviti MySQL dump velikosti 50 MB, to bo trajalo minuto, in obnoviti nek delež slik iz varnostne kopije. Tudi tega ni prav veliko. Tako se vse to dvigne v pol ure. Nobene replikacije ali, po čudežu, samodejnega prehoda v rezervno stanje. Izvleček: tisto, kar lahko hitro obnovimo iz varnostne kopije, ni potrebno rezervirati.
Primer številka tri, nekoliko bolj zapleten
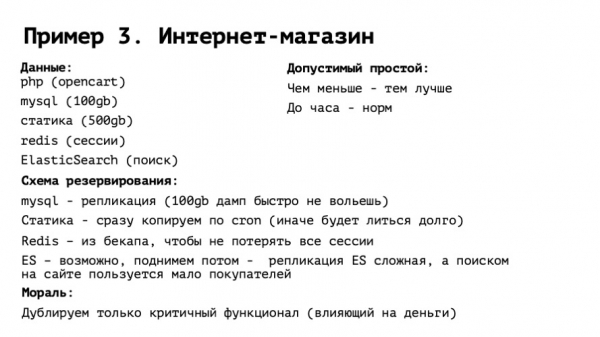
Spletna trgovina. PhP z malce predelanim open heart, MySQL z obsežno bazo. Dokaj veliko statike (končno v spletni trgovini so lepa HD slika in vse to), Redis za seje in Elasticsearch za iskanje. Začnemo razmišljati o času izpada. In tu je seveda očitno, da spletna trgovina ne more brez bolečin ležati en dan. Kajti dlje ko leži, več denarja izgubljamo. Treba je pospešiti. In kako močno? Menim, da če ležimo eno uro, nihče ne bo padel v obup. Da, nekaj bomo izgubili, ampak če začnemo preveč delati — bo le še huje. Določimo shemo izpada, ki je dovoljena v eni uri.
Kako to vse rezervirati? Avto je nujno potreben: ena ura je precej malo. Mysql: tu že potrebujemo replikacijo, živo replikacijo, saj za eno uro 100 GB v dump verjetno ne bo vstopilo. Statika, slikice: spet, v eni uri morda 500 GB ne bo uspelo priti. Zato je bolje, da takoj kopiramo slike. Redis: tu pa je stvar bolj zanimiva. V Redis so shranjene seje — enostavno ga vzeti in ukiniti ne moremo. Ker to ne bi bilo najbolje: vsi uporabniki bi bili odjavljeni, nakupovalne košarice bi bile prazne in tako naprej. Ljudje bi morali znova vnesti svoj prijavni in geslo, in veliko ljudi bi se lahko odklopilo in nakupa ne bi dokončalo. Tako bo konverzija padla. Po drugi strani pa Redis ni potrebna 100-odstotno aktualen, s potrebnimi zadnjimi prijavljenimi uporabniki. In dober kompromis je vzeti Redis in ga obnoviti iz varnostne kopije, iz včerajšnje, ali, če jo imate vsakih 60 minut, — iz ure stare. Na srečo je obnova iz varnostne kopije preprosto kopiranje enega datoteke. Najbolj zanimiva zgodba pa je Elasticsearch. Kdo je kdaj vzpostavil replikacijo MySQL? Kdo je kdaj vzpostavil replikacijo Elasticsearch? In komu je ta delovala normalno? Mislim, da v našem sistemu vidimo neko entiteto. Zdi se koristna — a je zapletena.
Zapleteno v tem smislu, da naši inženirji nimajo izkušenj z njo. Ali pa imajo negativne izkušnje. Ali razumemo, da je to precej nova tehnologija s svojimi odtenki ali nedodelanostmi. Razmišljamo… Hm, elastic je prav tako velik, dolgotrajno ga je obnoviti iz varnostne kopije, kaj narediti? Razumemo, da se elastic v našem primeru uporablja za iskanje. Kako prodaja naš spletni trgovec? Gremo do tržnikov, vprašamo, od kod prihajajo ljudje. Odgovorijo: „90% prihaja iz Yandex-trga neposredno v kartico izdelka“. In ali kupijo ali ne. To pomeni, da iskanje potrebujemo le 10% uporabnikov. In imeti replikacijo elastic’a, zlasti med različnimi podatkovnimi centri v različnih območjih, ima res veliko odtenkov. Kakšna je rešitev? Elastic vzamemo na rezerviranem območju in z njim nič ne delamo. Če se bo zadeva zavlekla, ga morda kasneje obudimo, vendar to ni gotovo. To je v bistvu še enkrat potrditev: storitve, ki ne vplivajo na denar, znova ne rezerviramo. Da bi shema ostala preprosta.
Primer številka štiri, še zahtevnejši.
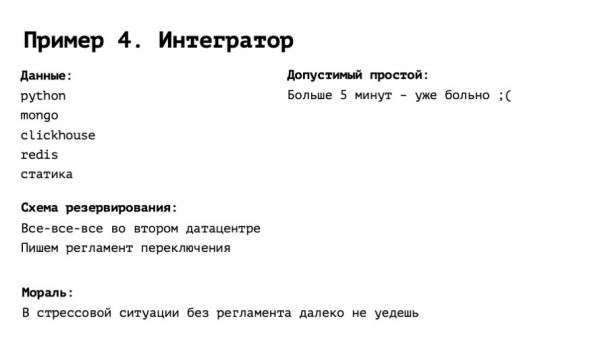
Integracija: prodaja cvetja, klic taksija, prodaja blaga, v bistvu karkoli. Resna zadeva, ki deluje 24/7 za veliko število uporabnikov. S polnopravno zanimivo tehnologijo, kjer so zanimive baze, rešitve, visoka obremenitev, in kar je najpomembnejše, ležanje več kot 5 minut je boleče. Ne samo, in ne toliko, zato, ker ljudje ne bodo kupili, ampak zato, ker bodo ljudje videli, da ta stvar ne deluje, se razočarali in morda sploh ne pridejo drugič.
V redu. Pet minut. Kaj bomo s tem naredili? V tem primeru odraslo in za vse denarje postavimo pravo rezervno platformo, z replikacijo vsega in še česa, in morda celo maksimiziramo avtomatizacijo preklopa na to platformo. In poleg tega ne smemo pozabiti narediti še eno pomembno stvar: napisati postopek preklopa. Postopek, tudi če imate vse avtomatizirano, je lahko zelo preprost. Nekaj v smislu: 'zaženi ta in ta ansible skript', 'v route 53 označi to in to' in tako naprej - toda to mora biti nek točen seznam dejanj.
Zdi se, da je vse jasno. Preklop replikacije je trivialna naloga, ali pa se bo preklopila sama. Prepisovanje domene v dns je iz iste serije. Težava nastane, ko takšen projekt propade, začne se panika, in celo najbolj izkušeni admini so lahko podvrženi temu. Brez jasnih navodil 'odpri terminal, pojdi sem, naslov našega strežnika je še vedno takšen' je težko očuvati petminutni rok za reanimacijo. Poleg tega, ko uporabljamo ta postopek, je lahko enostavno popraviti kakšne spremembe v infrastrukturi in ustrezno spremeniti postopek.
Če je sistem rezerviranja zelo zapleten in v nekem trenutku naredimo napako, lahko uničimo tudi naš rezervoar, podatki pa se lahko spremenijo v bučo na obeh lokacijah — to bi bilo zelo žalostno.
Primer številka pet, popoln hardcore
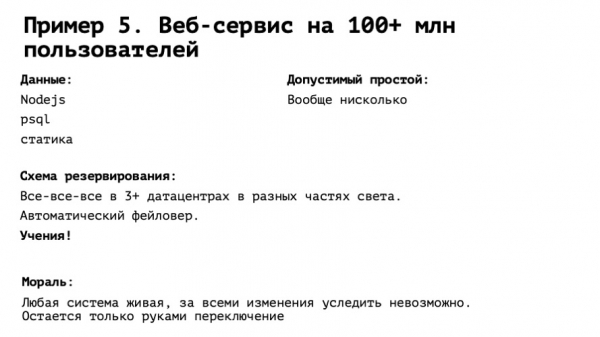
Mednarodna storitev s stotimi milijoni uporabnikov po vsem svetu. Vse časovne pasove, ki jih le obstajajo, highload na maksimumu, ne sme pasti. Ena minuta — in žalost bo prišla. Kaj storiti? Rezervirati, znova, po polni program. Storili smo vse, kar sem omenil v prejšnjem primeru, in še nekoliko več. Idealen svet in naša infrastruktura je po vseh kriterijih devops IaaC. Torej je vse v git-u, le pritisnite gumb.
Kaj manjka? Enega — usposabljanj. Brez njih ne gre. Zdi se, da imamo vse popolno, vse imamo pod nadzorom. Pritisnemo gumb, vse se zgodi. Tudi če je tako — in razumemo, da ni tako — naš sistem deluje z nekaterimi drugimi sistemi. Na primer, to je dns od route 53, s3 shrambi, integracija z nekaterimi api. Vse predvideti v tem umskem eksperimentu ne moremo. In dokler dejansko ne potegnemo stikala — ne bomo izvedeli, ali bo delovalo ali ne.
Na tem, verjetno, vse. Ne lenarite in se ne trudite preveč. In naj bo uptime z vami!
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish