

Danes bomo govorili o zanimivi tehnologiji, implementirani v shranjevalnih sistemih Unity/Unity XT, – FAST VP. Če o Unity slišite prvič, si lahko na povezavi na koncu članka ogledate specifikacije sistema. V projektni ekipi Dell EMC sem delal na FAST VP več kot eno leto. Danes želim podrobneje predstaviti to tehnologijo in razkriti nekatere detajle njene implementacije. Seveda samo tiste, ki jih je dovoljeno razkriti. Če vas zanimajo vprašanja učinkovitega shranjevanja podatkov ali preprosto še niste povsem razumeli dokumentacije, bo ta članek zagotovo koristen in zanimiv.
Takoj bom povedal, česar v gradivu ne bo. Ne bo iskanja konkurentov in primerjave z njimi. Prav tako ne nameravam govoriti o podobnih tehnologijah iz open source, ker radovedni bralci to že poznajo. In seveda ne nameravam ničesar oglaševati.
Tiering shranjevanja. Cilji in naloge FAST VP
FAST VP pomeni Fully Automated Storage Tiering for Virtual Pool. Zapleteno? Nič hudega, zdaj bomo razjasnili. Tiering je način organizacije shranjevanja podatkov, pri katerem obstajajo več ravni (tiers), kjer so ti podatki shranjeni. Vsaka ima svoje značilnosti. Najpomembnejše so: zmogljivost, volumen in cena shranjevanja enote informacij. Seveda obstaja med njimi medsebojna povezanost.
Pomembna lastnost tieringa je v tem, da je dostop do podatkov enoten ne glede na to, na kateri ravni shranjevanja se trenutno nahajajo, medtem ko je velikost bazena enaka vsoti velikosti virov, ki jih vsebuje. Tukaj se skrivajo razlike od predpomnilnika: velikost predpomnilnika se ne doda skupnemu volumnu vira (bazena v tem primeru), podatki iz predpomnilnika pa podvajajo del podatkov glavnega nosilca (ali bodo podvajali, če podatki iz predpomnilnika še niso zapisani). Prav tako je razporeditev podatkov po ravneh skrita pred uporabnikom. To pomeni, da ne vidi, kateri podatki so na vsaki ravni, čeprav lahko nanjo posredno vpliva z določitvijo politik (o katerih bomo govorili pozneje).
Zdaj si poglejmo posebnosti implementacije tieringa shranjevanja v Unity. V Unity ločimo 3 ravni, ali tierje:
- Ekstremna zmogljivost (SSD-ji)
- Zmogljivost (SAS HDD 10k/15k RPM)
- Kapaciteta (NL-SAS HDD 7200 RPM)
So so se razvrščeni po padajočem vrstnem redu zmogljivosti in cene. V Extreme performance so vključeni izključno trdi diski SSD. V dveh drugih ravneh so diskovni trdi diski, ki se razlikujejo po hitrostih vrtenja in s tem po zmogljivosti.
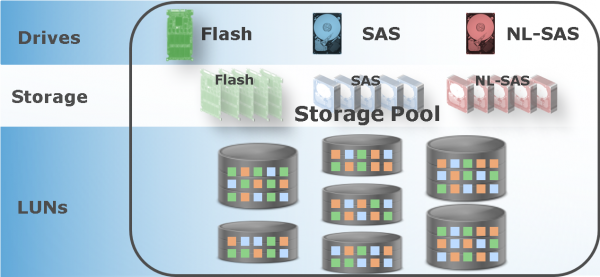
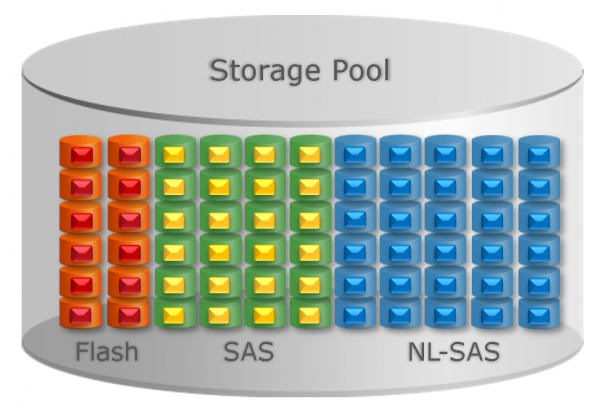
Pomožni mediji istega nivoja in velikosti se združijo v RAID-matriko, ki oblikuje RAID-skupino (RAID group, kratica – RG); o razpoložljivih in priporočljivih nivojih RAID lahko preberete v uradni dokumentaciji. Iz RAID-skupin z enega ali več nivojev nastanejo skladiščne enote (Storage pool), iz katerih se nato razporeja prosto mesto. Iz skladiščne enote se nato dodeli prostor za datotečne sisteme in LUN-e.
Zakaj potrebujem Tiering?
Na kratko in abstraktno: da dosežem večji rezultat z minimalnimi viri. Če bolj konkretno, rezultat običajno pomeni skupne značilnosti SAN-a – hitrost in čas dostopa, stroške shranjevanja in drugo. Minimalni viri pa pomenijo najmanjše stroške: denarja, energije itd. FAST VP ravno to implementira z mehanizmi prerazporejanja podatkov po različnih nivojih v SAN-u Unity/Unity XT. Če verjamete, lahko preskočite naslednji odstavek. Za ostale bom razložil malo podrobneje.
Pravilno prerazporejanje podatkov po nivojih shranjevanja omogoča znižanje skupnih stroškov SAN-a, žrtvovanje hitrosti dostopa do redko uporabljenih informacij in povečanje zmogljivosti s premikanjem pogosto uporabljenih podatkov na hitrejše nosilce. Tu se morda nekomu zdi, da tudi brez tieringa običajen skrbnik ve, kam postaviti katere podatke, kakšne so želene značilnosti SAN-a za njegovo nalogo itd. Nedvomno drži, vendar ima ročno prerazporejanje podatkov svoje pomanjkljivosti:
- zahteva čas in pozornost skrbnika;
- ni vedno možno "preoblikovati" virov SAN-a glede na spremenjene okoliščine;
- izgine pomembna prednost: enotna dostopnost do virov, ki se nahajajo na različnih nivojih shranjevanja.
Da bi se skladišni administratori manje brinuli o sigurnosti posla, dodajem da je pravilno planiranje resursa ovde takođe ključno. Sada kada su zadaci tieringa ukratko objašnjeni, hajde da pogledamo šta možemo očekivati od FAST VP. Ovo je pravo vreme da se vratimo definiciji. Prve dve reči – Fully Automated – doslovno znače „potpuno automatizovan“ i označavaju da se raspodela po nivoima vrši automatski. Virtual Pool je skup podataka koji uključuje resurse iz različitih nivoa skladištenja. Ovako to izgleda:
Pre nego što pređem dalje, da kažem da FAST VP premesta podatke samo unutar jednog bazena, a ne između više bazena.
Zadaci koje rešava FAST VP
Prvo ćemo razgovarati apstraktno. Imamo bazen i neki mehanizam koji može redistribuirati podatke unutar tog bazena. Imajući u vidu da nam je cilj postizanje maksimalne performanse, postavićemo pitanje: kojim putem to možemo postići? Mogu biti različiti, a FAST VP ima ponudu za korisnika, pošto tehnologija predstavlja više od jednostavnog skladištenja. Ovako FAST VP može povećati performanse bazena:
- Raspodela podataka po različitim tipovima diskova, nivoima
- Raspodela podataka među diskovima istog tipa
- Raspodela podataka prilikom proširenja bazena
Pre nego što razložimo kako se ovi zadaci rešavaju, potrebno je da znamo neke važne činjenice o radu FAST VP. FAST VP operiše blokovima određene veličine – 256 megabajta. To je minimalni kontinuirani „komad“ podataka koji može biti pomeren. U dokumentaciji se tako naziva: slice. Iz perspektive FAST VP svi RAID grupe se sastoje od seta takvih „komada“. Samim tim, sva statistika ulazno-izlaznih operacija se prikuplja za te blokove podataka. Zašto je odabrana baš ta veličina blokova i hoće li biti smanjena? Blok je dovoljno velik, ali to je kompromis između granularnosti podataka (manja veličina bloka – preciznija raspodela) i dostupnih procesorskih resursa: pri postojećim strogim ograničenjima na RAM i velikom broju blokova, statistički podaci mogu zauzeti previše, a broj izračunavanja će proporcionalno rasti.
Kako FAST VP raspoređuje podatke u bazenu. Politike
Za upravljanje razporejanjem podatkov v bazenu z aktiviranim FAST VP obstajajo naslednje politike:
- Najvišji razpoložljivi sloj
- Samodejno razvrščanje
- Začni z visokim in nato samodejno razvrsti (privzeto)
- Najnižji razpoložljivi sloj
Te politike vplivajo tako na začetno razporeditev blokov (ko so podatki prvič zapisani) kot tudi na kasnejše prerazporejanje. Ko so podatki enkrat shranjeni na diskih, se prerazporeditev sproži po urniku ali ročno.
Najvišji razpoložljivi sloj se trudi novo blok podati na najuspešnejši nivo. Če ni dovolj prostora, se doda na naslednji nivo z večjo uspešnostjo, toda podatki se lahko kasneje premaknejo na bolj uspešen nivo (ob razpoložljivem prostoru ali s pomikom drugih podatkov). Samodejno razvrščanje shranjuje nove podatke na različnih nivojih, odvisno od velikosti razpoložljivega prostora, prerazporeditev pa poteka glede na povpraševanje in prosti prostor. Začni z visokim in nato samodejno razvrsti – politika po privzetku in hkrati priporočen način. Pri začetnem razporejanju deluje kot najvišji razpoložljivi sloj, nato pa se podatki premikajo glede na statistiko porabe. Politika najnižjega razpoložljivega sloja si prizadeva shraniti podatke na najmanj uspešnem nivoju.
Prerazporeditev podatkov poteka z nizkim prioritetom, da ne moti uporabe shranjevanja podatkov, vendar obstaja nastavitev 'Hitrost prerazporeditve podatkov', ki spremeni prioritet. Ima pa posebnost: ne vsi podatkovni bloki imajo enako vrstno prioriteto v prerazporeditvi. Na primer, bloki, označeni kot metapodatki, bodo najprej premaknjeni na hitrejši nivo. Metapodatki so lahko razumljeni kot 'podatki o podatkih', dodatne informacije, ki niso uporabniški podatki, temveč opisujejo te podatke. Na primer, informacije v datotečnem sistemu o tem, v katerem bloku se nahaja določen datoteka. Tako hitrost dostopa do podatkov odvisna od hitrosti dostopa do metapodatkov. Glede na to, da so metapodatki običajno precej manjši, se pričakuje, da bo korist od njihovega premika na bolj uspešne diske večja.
Kriteriji, ki jih Fast VP uporablja pri delu
Glavni kriterij za svaki blok, grubo rečeno, je karakteristika "traženosti" podataka, koja zavisi od broja operacija čitanja i pisanja fragmenta podataka. Ova karakteristika se kod nas naziva "Temperatura". Postoje traženi (hot) podaci koji su „topliji“ od neprocenjenih. Računa se periodično, po default-u svakih sat vremena.
Funkcija izračunavanja temperature ima sledeće osobine:
- U nedostatku ulaza-izlaza podaci tokom vremena "hlade".
- Pri više-manje jednakom opterećenju tokom vremena, temperatura prvo raste, a zatim se stabilizuje u određenom opsegu.
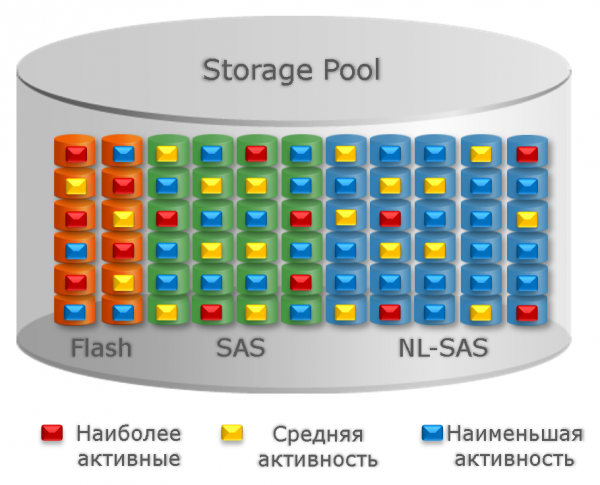
Dalje se uzimaju u obzir politike opisane iznad, kao i slobodan prostor na svakom tier-u. Za ilustraciju ću prikazati sliku iz dokumentacije. Ovde su crvenom, žutom i plavom bojom označeni blokovi sa visokom, srednjom i niskom temperaturom.
Ali da se vratimo zadacima. Dakle, možemo preći na analizu onoga što se radi da bi se rešavali zadaci FAST VP.
A. Distribucija podataka po različitim tipovima diskova, nivoima.
U suštini, to je osnovni zadatak FAST VP. Ostali su, na neki način, derivati od njega. U zavisnosti od odabrane politike, podaci će se distribuirati po različitim nivoima čuvanja. Pre svega se uzima u obzir politika smeštaja, zatim temperatura blokova i veličina/brzina RAID-grupa.
Za politike Highest/Lowest Available Tier sve je prilično jednostavno. Za ostale dve je situacija ovakva. Po različitim nivoima, podaci se distribuiraju uzimajući u obzir veličinu i performanse RAID-grupa: tako da omjer ukupne "temperature" blokova i "uslovne maksimalne performanse" svake RAID-grupe bude otprilike jedinstven. Na taj način se opterećenje raspoređuje više-manje ravnomerno. Više traženi podaci se premestaju na brže medije, retko korišćeni – na sporije. U idealnom slučaju distribucija bi trebala izgledati otprilike ovako:
B. Distribucija podataka među diskovima istog tipa.
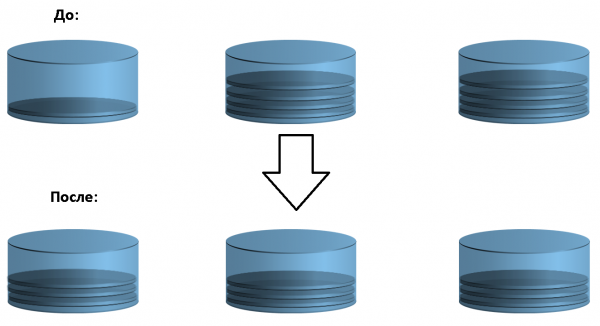
Zapamtite, na početku sam rekao, da su mediji informacija iz jednog ili više Ali ravni se združujejo v en skupni bazen? V primeru enotnega nivoja za FAST VP je prav tako potreben trud. Da bi bila zmogljivost kateregakoli nivoja maksimalna, je priporočljivo, da se podatki enakomerno porazdelijo med diskih. To bo teoretično omogočilo dosego maksimalnega števila IOPS. Podatke znotraj RAID-skupine lahko obravnavamo kot enakomerno porazdeljene med diski, medtem ko to med RAID-skupinami ni vedno tako. V primeru neuravnoteženosti bo FAST VP premikal podatke med RAID-skupinami sorazmerno z njihovimi obsegi in 'pogoji zmogljivosti' (v numeričnem izrazu). Za večjo jasnočo bom prikazal shemo ponovno uravnoteženja med tremi RAID-skupinami:
V. Porazdelitev podatkov pri širjenju bazena
To nalogo obravnavamo kot poseben primer prejšnje in se izvede, ko se v bazen doda RAID-skupina. Da nova RAID-skupina ne bi ostala neizkoriščena, bodo nekateri podatki preneseni nanjo, s tem pa se bo obremenitev vseh RAID-skupin preredistricirala.
Usklajevanje obrabe SSD
S pomočjo usklajevanja obrabe FAST VP lahko podaljša življenjsko dobo SSD, čeprav ta funkcija ni neposredno povezana s Storage Tiering. Ker so podatki o temperaturi že na voljo, je tudi število zapisov upoštevano, sposobni smo premikati podatkovne bloke, zato bi bilo smiselno, da FAST VP reši tudi to nalogo.
V primeru, ko je število zapisov v eno RAID-skupino znatno večje od števila zapisov v drugi, bo FAST VP prenesel podatke v skladu s številom zapisov. Po eni strani to zmanjšuje obremenitev in ohranja vire nekaterih diskov, po drugi strani pa dodaja 'delo' za manj obremenjene diske, kar povečuje skupno zmogljivost.
Tako FAST VP prevzema tradicionalne naloge Storage Tieringa in dela še nekoliko več. Vse to omogoča učinkovito shranjevanje podatkov v družini Unity.
Nekaj nasvetov
- Ne prezrite branja dokumentacije. Obstajajo najboljše prakse, in te delujejo precej dobro. Če se jih držite, običajno ne pride do resnih težav. Ostali nasveti v glavnem ponavljajo ali dopolnjujejo te.
- Če ste nastavili in aktivirali FAST VP, ga je najbolje obdržati vklopljenega. Naj razporeja podatke v odmerjenem času in postopoma, namesto enkrat letno, kar bi resno vplivalo na zmogljivost drugih nalog. V takih primerih se lahko preusmeritev podatkov zelo podaljša.
- Pozorno izberite okno za relokacijo. Čeprav se to zdi očitno, se poskusite odločiti za čas z najmanj obremenitvijo za Unity in si vzemite dovolj časa.
- Načrtujte širitev shranjevanja podatkov in to storite pravočasno. To je splošen nasvet, ki je pomemben tudi za FAST VP. Če je količina prostega prostora zelo majhna, se bo premikanje podatkov upočasnilo ali pa postalo nemogoče. Še posebej, če ste prezrli točko 2.
- Pri širjenju skladišča z vključenim FAST VP ne začnite z najpočasnejšimi diski. Torej bodisi dodajte vse načrtovane RAID skupine hkrati, bodisi najprej dodajte najhitrejše diske. V tem primeru bo preusmeritev podatkov na nove 'hitre' diske povečala skupno hitrost skladišča. V nasprotnem primeru, če začnete z 'počasnimi' diski, se lahko znajdete v zelo neprijetni situaciji. Prva bo potekal prenos podatkov na nove, sorazmerno počasne diske, nato pa ob dodajanju hitrejših v nasprotni smeri. Tu so odtenki, povezani z različnimi politikami FAST VP, a na splošno je taka situacija mogoča.
Če se zanimajte za ta izdelek, lahko preizkusite Unity brezplačno tako, da prenesete Unity VSA virtualno napravo.
Na koncu gradiva delim nekaj koristnih povezav:
- Stran
- – kratki opis funkcionalnosti
- , pdf format
Zaključek
Želim pisati o mnogih stvareh, a razumem, da niso vse podrobnosti zanimive za bralca. Na primer, lahko bi podrobneje razložil merila, po katerih FAST VP sprejema odločitve o premikih podatkov, o procesih analize statistike vhodno-izhodnega delovanja. Tudi tema sodelovanja z , pa to zahteva posebno temo. Lahko bi celo domneval o razvoju te tehnologije. Upam, da ni bilo dolgočasno in vas nisem utrudil. Se vidimo prihodnjič!
Izvor: habr.com
