

Komanda ponuja inženjera Rahula Bhatia iz kompanije Clairvoyant o tome koje postoje vrste datoteka u velikim podacima, koje su najčešće funkcije Hadoop formata i koja vrsta je najbolja za korišćenje.
Zašto su potrebni različiti formati datoteka
Seriozni usko mesto u performansama aplikacija koje podržavaju HDFS, poput MapReduce i Spark — vreme pronalaženja, čitanja i pisanja podataka. Ovi problemi se pogoršavaju teškoćama u upravljanju velikim skupovima podataka, kada nemamo fiksnu, već evoluirajuću shemu, ili postoje neka ograničenja u skladištenju.
Obrada velikih podataka povećava opterećenje na skladišnom sistemu — Hadoop skladišti podatke u višku radi postizanja otpornosti na greške. Pored diskova, opterećenja su i procesor, mreža, sistem ulaza-izlaza i tako dalje. Kako se povećava obim podataka, tako raste i cena njihovo obrade i skladištenja.
Različiti formati datoteka u smisleni su da reše upravo ove probleme. Odabir odgovarajućeg formata datoteka može doneti značajne prednosti:
- Brže vreme čitanja.
- Brže vreme pisanja.
- Deljive datoteke.
- Podrška za evoluciju shema.
- Povećana podrška za kompresiju.
Neki formati datoteka su namenjeni opštoj upotrebi, drugi za specifične varijante, a neki su razvijeni s obzirom na konkretne karakteristike podataka. Tako da je izbor zaista prilično veliki.
Format datoteka Avro
Za serijalizacije podataka široko koristi Avro — to je format skladištenja podataka koji se zasniva na redovima, odnosno redovni, format skladista podataka u Hadoop-u. On skladišti šemu u JSON formatu, olakšavajući njeno čitanje i interpretaciju svakoj aplikaciji. Sami podaci su u binarnom formatu, kompaktnom i efikasnom.
Sistem serijalizacije Avro je neutralan prema jeziku. Datoteke se mogu obraditi raznim jezicima, trenutno su to C, C++, C#, Java, Python i Ruby.
Ključna karakteristika Avro-a je pouzdana podrška za sheme podataka koje se menjaju tokom vremena, odnosno evoluiraju. Avro razume promene sheme — brisanje, dodavanje ili modifikovanje polja.
Avro podržava razne strukture podataka. Na primer, možete kreirati zapis koji sadrži niz, enumerisani tip i podzapis.
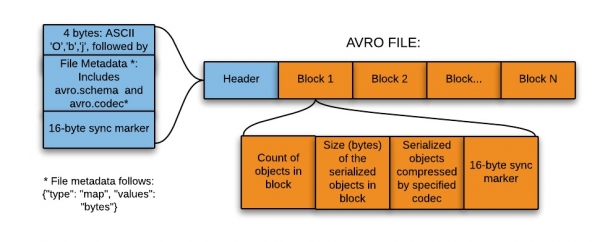
Ta oblika je idealna za zapis v pristajalno območje podatkovnega jezera (, ali data lake — zbirka instanc za shranjevanje različnih vrst podatkov, poleg neposrednih virov podatkov).
Torej, za zapis v pristajalno območje podatkovnega jezera je ta oblika najbolj primerna iz naslednjih razlogov:
- Podatki iz tega območja se običajno berejo v celoti za nadaljnjo obdelavo s strani spodnjih sistemov — in oblika, ki temelji na vrsticah, je v tem primeru bolj učinkovita.
- Spodnji sistemi lahko enostavno pridobivajo sheme tabel iz datotek — ni treba shranjevati shem ločeno v zunanje meta-shrambe.
- Vsaka sprememba izvorne sheme se enostavno obravnava (evolucija sheme).
Datotečna oblika Parquet
Parquet je odprtokodna datotečna oblika za Hadoop, ki shranjuje vložene strukture podatkov v ravnem stolpčni obliki.
V primerjavi s tradicionalnim vrstičnim pristopom je Parquet bolj učinkovit z vidika shranjevanja in delovanja.
To je še posebej uporabno za poizvedbe, ki berejo določene stolpce iz široke (z mnogimi stolpci) tabele. Zaradi datotečne oblike se berejo le potrebni stolpci, kar zmanjša vhodno-izhodne operacije.
Majhna odstopanja razlaga: da bi bolje razumeli datotečno obliko Parquet v Hadoopu, si poglejmo, kaj pomeni stolpčna oblika — torej stolpčna — oblika. V tej obliki se skupaj shranjujejo enako tipizirane vrednosti vsakega stolpca.
, zapis vključuje polja ID, Ime in Oddelek. V tem primeru bodo vse vrednosti stolpca ID shranjene skupaj, prav tako pa tudi vrednosti stolpca Ime in tako naprej. Tabela bo izgledala približno tako:
ID
Ime
Oddelek
1
delavec1
d1
2
delavec2
d2
3
delavec3
d3
V vrstični obliki se bodo podatki shranili na naslednji način:
1
delavec1
d1
2
delavec2
d2
3
delavec3
d3
V stolpčni obliki se bodo isti podatki shranili tako:
1
2
3
delavec1
delavec2
delavec3
d1
d2
d3
Stolpčna oblika je bolj učinkovita, kadar želite poizvedovati iz tabele več stolpcev. Prebral bo le potrebne stolpce, ker so ti blizu skupaj. Tako se vhodno-izhodne operacije zmanjšajo na minimum.
Na primer, potrebujete le stolpec IME. V Vsaka zapis v podatkovnem naboru je treba naložiti, razdeliti na polja in nato izvleči podatke NAME. Stolpci omogočajo neposredno prehod k stolpcu Name, saj so vse vrednosti za ta stolpec shranjene skupaj. Ni treba skenirati celotnega zapisa.
Tako stolčni format povečuje učinkovitost poizvedb, saj je za dostop do zahtevanih stolpcev potrebnega manj časa iskanja in se zmanjša število vhodno-izhodnih operacij, saj se berejo le potrebni stolpci.
Ena od edinstvenih značilnosti je, da v tem formatu lahko hrani podatke z vdelanimi strukturami. To pomeni, da je v Parquet datoteki mogoče brati celo vdelana polja ločeno, ne da bi bilo treba prebrati vsa polja v vdelani strukturi. Za shranjevanje vdelanih struktur Parquet uporablja algoritem drobljenja in sestavljanja.
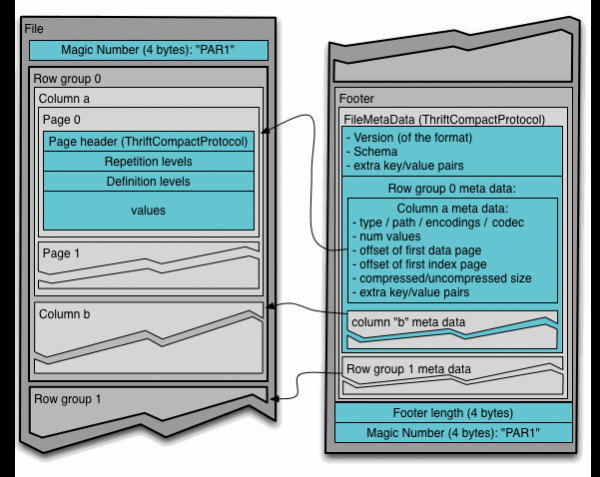
Da bi razumeli format datoteke Parquet v Hadoopu, je treba poznati naslednje izraze:
- Skupina vrstic (row group): logično horizontalno razdelitev podatkov na vrstice. Skupina vrstic se sestavlja iz fragmenta vsakega stolpca v podatkovnem naboru.
- Fragment stolpca (column chunk): fragment določenega stolpca. Ti fragmenti stolpcev živijo v določeni skupini vrstic in so zagotovljeno sosednji v datoteki.
- Stran (page): fragmenti stolpcev so razdeljeni na strani, zapisane ena za drugo. Strani imajo skupno glavo, tako da lahko pri branju preskočite nepotrebne.
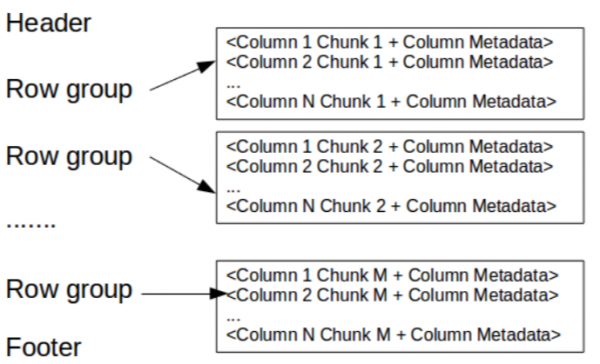
Tukaj glava preprosto vsebuje čarobno število PAR1 (4 bajti), ki identificira datoteko kot datoteko v formatu Parquet.
V nogi je zapisano naslednje:
- Metapodatki datoteke, ki vsebujejo začetne koordinate metapodatkov vsakega stolpca. Pri branju je najprej treba prebrati metapodatke datoteke, da najdete vse zanimive fragmente stolpcev. Nato je treba fragmente stolpcev brati zaporedoma. Poleg tega metapodatki vključujejo različico formata, shemo in vse dodatne pare ključ-vrednost.
- Dolžina metapodatkov (4 bajti).
- Čarobno število PAR1 (4 bajti).
Format datotek ORC
Optimizirana vrstično-stolpčna oblika datotek (Optimized Row Columnar, ) ponuja zelo učinkovit način shranjevanja podatkov in je bil zasnovan za premagovanje omejitev drugih formatov. Shranjuje podatke v popolnoma kompaktni obliki, kar omogoča izpuščanje nepotrebnih podrobnosti — pri tem ne zahteva gradnje velikih, zapletenih ali ročno vzdrževanih indeksov.
Prednosti formata ORC:
- En datotek na izhodu vsake naloge, kar zmanjšuje obremenitev NameNode (vozlišča imen).
- Podpora za Hive tipe podatkov, vključno z DateTime, decimalnimi in zapletenimi tipi podatkov (struct, list, map in union).
- Hkratno branje iste datoteke z različnimi procesi RecordReader.
- Možnost delitve datotek brez skeniranja za iskanje oznak.
- Ocena največje možne dodelitve pomnilnika kupu za procese branja/pisanja na podlagi informacij v nogi datoteke.
- Metapodatki se shranjujejo v binarni obliki serializacije Protocol Buffers, kar omogoča dodajanje in odstranjevanje polj.
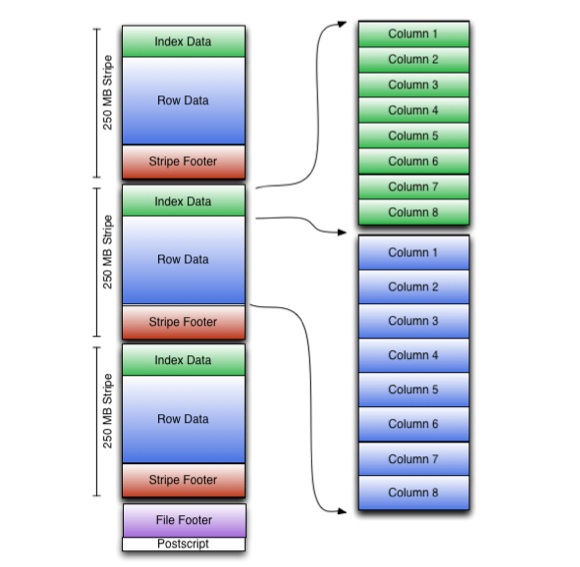
ORC shranjuje zbirke nizov v eni datoteki, medtem ko se znotraj zbirke nizni podatki shranjujejo v stolpcih.
Datoteka ORC shranjuje skupine nizov, imenovanih stripe, in pomožna informacije v nogi datoteke. Postscript na koncu datoteke vsebuje parametre stiskanja in velikost stisnjene noge.
Privzeta velikost stripa je 250 MB. Zaradi stripov te velikosti je branje iz HDFS bolj učinkovito: v velikih neprekinjenih blokih.
V nogi datoteke je zapisan seznam stripa v datoteki, število nizov na stripe in tip podatkov vsakega stolpca. Tam so tudi zapisani rezultati count, min, max in sum za vsak stolpec.
Noga stripa vsebuje katalog lokacij toka.
Nizni podatki se uporabljajo pri skeniranju tabel.
Indeksni podatki vključujejo najmanjše in največje vrednosti za vsak stolpec ter pozicije nizov v vsakem stolpcu. Indeksi ORC se uporabljajo samo za izbiro stripa in skupin nizov, ne pa za odgovarjanje na poizvedbe.
Primerjava različnih formatov datotek
Avro v primerjavi s Parquet
- Avro je format shranjevanja po nizih, medtem ko Parquet shranjuje podatke po stolpcih.
- Parquet je bolje prilagojen za analitične poizvedbe, torej so operacije branja in poizvedbe podatkov veliko bolj učinkovite kot pisanje.
- Operacije pisanja v Avro se izvajajo bolj učinkovito kot v Parquet.
- Avro deluje zreleje z evolucijo shem. Parquet podpira le dodajanje sheme, medtem ko Avro omogoča večnamensko evolucijo, kar pomeni dodajanje ali spreminjanje stolpcev.
- Parquet je idealen za poizvedbe po podmnožicah stolpcev v večstolpcni tabeli. Avro pa je primeren za ETL operacije, kjer zahtevamo vse stolpce.
ORC v primerjavi s Parquet
- Parquet bolje shranjuje vdelane podatke.
- ORC je bolje prilagojen za potiskanje predikatov (predicate pushdown).
- ORC podpira lastnosti ACID.
- ORC boljše stisne podatke.
Kaj še prebrati o temi:
- .
- .
- .
Izvor: habr.com
