

Predlagam, da se seznanite z razlago poročila iz konca leta 2019, ki ga je pripravil Aleksander Valjalkin "Optimizacije Go v VictoriaMetrics"
— hitra in skalabilna SDB za shranjevanje in obdelavo podatkov v obliki časovnih vrst (vnos oblikuje čas in niz vrednosti, ki ustrezajo temu času, na primer, pridobljenih preko periodičnega nadzora stanja senzorjev ali zbiranja metrik).
Tukaj je povezava na video tega poročila —
Najprej bom nekaj povedal o sebi. Sem Aleksander Valjalkin. Tukaj je . Rad se ukvarjam z Go in optimizacijo zmogljivosti. Napisal sem številne uporabne in ne tako uporabne knjižnice. Te se začnejo bodisi z fast, ali z quick predpono.
Trenutno delam na VictoriaMetrics. Kaj je to in kaj tam delam? O tem bom govoril v tej predstavitvi.
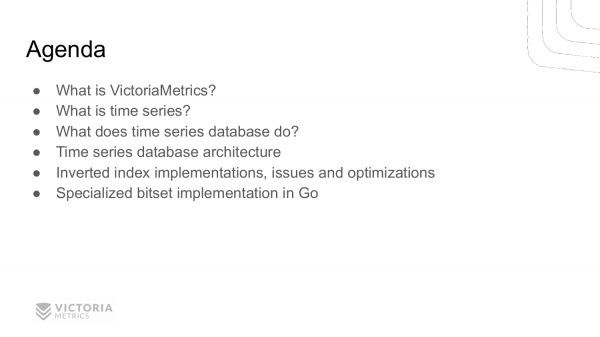
Načrt poročila je naslednji:
- Na začetku vam bom predstavil, kaj je VictoriaMetrics.
- Potem bom razložil, kaj so časovne vrste.
- Nato bom razložil, kako deluje zbirka podatkov časovnih vrst.
- Nato bom govoril o arhitekturi zbirke podatkov: iz česa je sestavljena.
- In potem bomo prešli k optimizacijam, ki jih ima VictoriaMetrics. To sta optimizacija obrnjenega indeksa in optimizacija za bitset-implementacijo v Go.
Ali kdo v občinstvu pozna VictoriaMetrics? Uau, že veliko ljudi ve. To je dobra novica. Za tiste, ki ne vedo – to je zbirka podatkov za časovne vrste. Temelji na arhitekturi ClickHouse, na nekaterih podrobnostih implementacije ClickHouse-a. Na primer, na takih, kot so: MergeTree, vzporedno računanje na vseh razpoložljivih jedrih procesorja in optimizacija zmogljivosti z delom na blokih podatkov, ki se shranijo v procesorskem predpomnilniku.
VictoriaMetrics zagotavlja boljše stiskanje podatkov v primerjavi z drugimi zbirkami podatkov za časovne vrste.
Poleg tega se VictoriaMetrics vertikalno skalira — torej lahko dodate več procesorjev, več pomnilnika na enem računalniku. VictoriaMetrics bo uspešno koristila te razpoložljive vire in izboljšala linearno zmogljivost.
VictoriaMetrics se tudi horizontalno skalira — torej lahko dodate dodatne vozlišča v grozd VictoriaMetrics in njena zmogljivost se bo skoraj linearno povečevala.
Kot ste uganili, je VictoriaMetrics hitra zbirka podatkov, ker drugih ne morem pisati. In napisana je v Go, zato o njej govorim na tem srečanju.
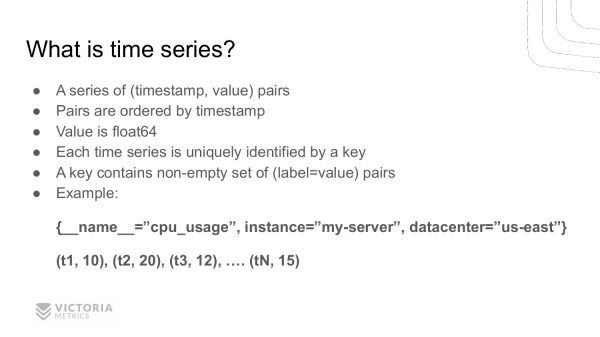
Kdo ve vež jo zna, kaj je časovna vrsta? Tudi veliko ljudi ve. Časovna vrsta je zaporedje parov (časovni žig, vrednost), kjer so ti pari razvrščeni po času. Vrednost predstavlja število s plavajočo vejico – float64.
Vsaka časovna vrsta je edinstveno identificirana s ključem. Iz česa je sestavljen ta ključ? Sestavljen je iz nepraznega niza parov ključ-vrednost.
Tukaj je primer časovne vrste. Ključ te vrste je seznam parov: __name__="cpu_usage" – to je ime metrike, instance="my-server" — to je računalnik, na katerem je ta metrika zbrana, datacenter="us-east" — to je podatkovni center, kjer se nahaja ta računalnik.
Imamo ime časovne vrste, sestavljeno iz treh parov ključ-vrednost. Ta ključ ustreza seznamu par (časovni žig, vrednost). t1, t3, t3, ..., tN — to so časovni žigi, 10, 20, 12, ..., 15 — ustrezne vrednosti. To je cpu-usage v tem trenutku za to vrsto.
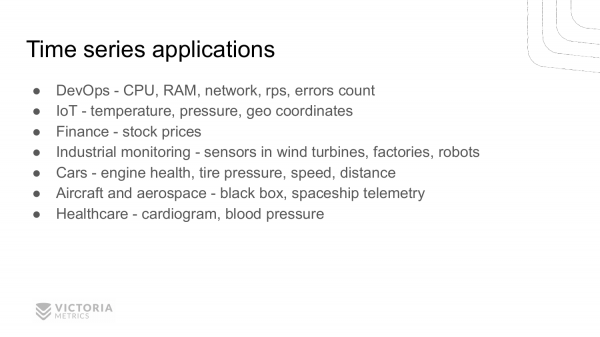
Kje se lahko uporabijo časovne vrste? Ima kdo kakšne ideje?
- V DevOps lahko merimo obremenitve CPU, RAM, omrežja, rps, število napak itd.
- IoT – lahko merimo temperaturo, pritisk, geografske koordinate in še kaj.
- Prav tako finance – lahko spremljamo cene različnih delnic in valut.
- Poleg tega se časovne vrste lahko uporabljajo za spremljanje proizvodnih procesov v tovarnah. Imamo uporabnike, ki uporabljajo VictoriaMetrics za spremljanje vetrnih turbin, za robote.
- Časovne vrste so prav tako uporabne za zbiranje informacij s senzorjev različnih naprav. Na primer, za motor; za merjenje pritiska v pnevmatikah; za merjenje hitrosti, razdalje; za merjenje porabe benzina itd.
- Časovne vrste se lahko uporabljajo tudi za spremljanje letal. Vsako letalo ima črno skrinjico, ki zbira časovne vrste po različnih parametrih zdravja letala. Časovne vrste se prav tako uporabljajo v vesoljski industriji.
- Zdravstvo – to so krvni tlak, pulz itd.
Morda so še druge uporabe, o katerih sem pozabil, ampak upam, da ste razumeli, da se časovne vrste aktivno uporabljajo v sodobnem svetu. In obseg njihove uporabe narašča iz leta v leto.
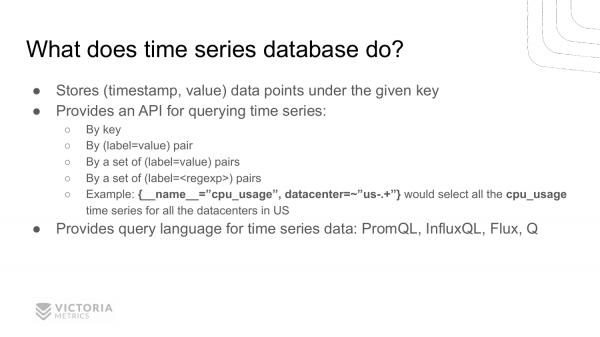
Zakaj potrebujemo bazo podatkov za časovne vrste? Zakaj ne moremo uporabiti običajne relacijske baze za shranjevanje časovnih vrst?
Ker pa so v časovnih vrstah ponavadi velike količine informacij, ki jih je težko shraniti in obdelati v običajnih podatkovnih bazah. Zato so nastale specializirane Baza podatkov za časovne vrste. Te baze učinkovito shranjujejo točke (časovni žig, vrednost) s predvideno ključno besedo. Nudijo API za branje shranjenih podatkov po ključno besedo, po eni par ključno-vrednost, bodisi po več takih parih, bodisi po regexp. Na primer, če želite najti obremenitev procesorja vseh vaših storitev v podatkovnem centru v Ameriki, morate uporabiti takšen psedoklic.
Običajno podatkovne baze za časovne vrste predstavljajo specializirani jeziki poizvedb, ker SQL za časovne vrste ni najbolj primeren. Čeprav obstajajo podatkovne baze, ki podpirajo SQL, ta ni najbolj primeren. Bolj primerni so jeziki poizvedb, kot so , , , . Upam, da je nekdo vsaj s katerim od teh jezikov že slišal. O PromQL verjetno marsikdo že ve. To je jezik poizvedb Prometheus.
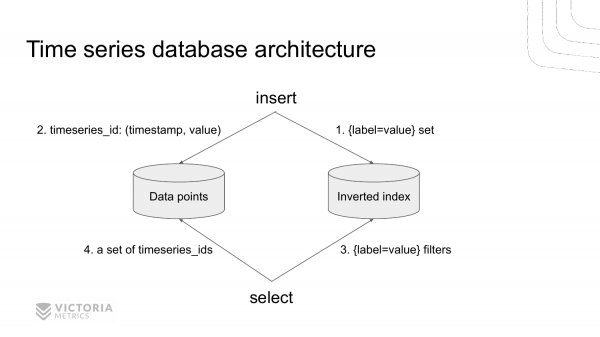
Tako izgleda arhitektura sodobne podatkovne baze za časovne vrste na primeru VictoriaMetrics.
Sestavljena je iz dveh delov. To je skladišče za inverzni indeks in skladišče za vrednosti časovnih vrst. Ta skladišča sta ločena.
Ko nova zapis pride v podatkovno bazo, najprej dostopamo do inverznega indeksa, da najdemo identifikator časovne vrste po določenem naboru label=value za to metriko. Najdemo ta identifikator in shranimo vrednost v podatkovno skladišče.
Ko pride kakšna poizvedba za pridobitev podatkov iz TSDB, najprej dostopamo do inverznega indeksa. Pridobimo vse timeseries_ids zapise, ki ustrezajo danemu naboru label=value. Nato pridobimo vse potrebne podatke iz podatkovnega skladišča, indeksiranega po timeseries_ids.
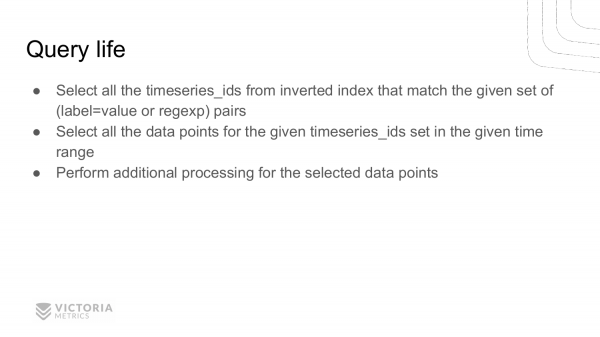
Poglejmo primer, kako podatkovna baza za časovne vrste obdela prihajajočo select-poizvedbo.
- Najprej pridobi vse
timeseries_idsiz inverznega indeksa, ki vsebujejo predvidene parelabel=value, ali ustrezajo danemu regularnemu izrazu. - Nato pridobi vse podatkovne točke iz skladišča podatkov za določen časovni interval za najdene
timeseries_ids. - Po tem podatkovna baza izvede določena izračunavanja na teh podatkovnih točkah v skladu s poizvedbo uporabnika. In nato vrne odgovor.
V tej predstavitvi vam bom predstavil prvi del. To je iskanje timeseries_ids po inverznem indeksu. O drugi in tretji del si lahko ogledate kasneje , ali pa počakajte, da pripravim druge predstavitve 🙂
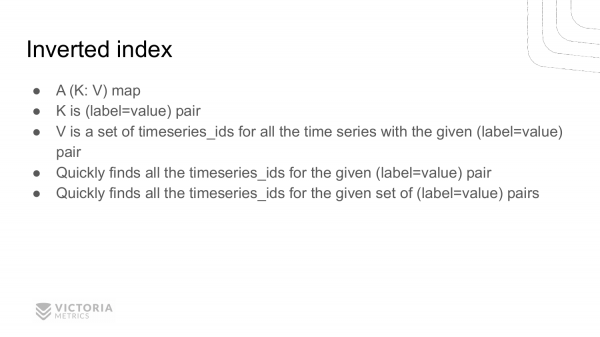
Začnimo z inverznim indeksom. Mnogim se lahko zdi, da je to preprosto. Kdo ve, kaj je inverzni indeks in kako deluje? O, že ni več toliko ljudi. Poskusimo razumeti, kaj je to.
V resnici je vse preprosto. To je le slovar, ki prikazuje ključ na vrednost. Kaj je ključ? Ta par label=value, gde label in value — so nizi. In vrednosti so nabor timeseries_ids, ki vsebuje določen par label=value.
Inverzni indeks omogoča hitro iskanje vseh timeseries_ids, ki imajo določen label=value.
Prav tako omogoča hitro iskanje timeseries_ids časovnih vrst za več parov label=value, ali za pare label=regexp. Kako to deluje? S pomočjo iskanja preseka množice timeseries_ids za vsak par label=value.
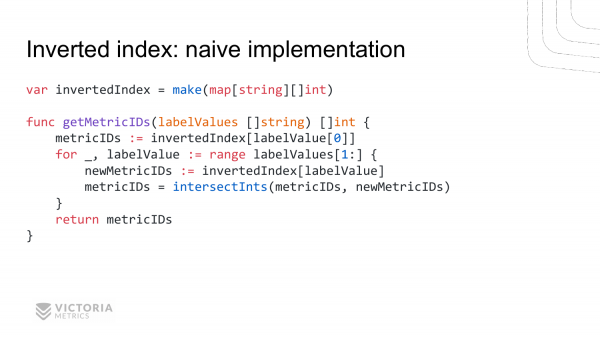
Poglejmo različne implementacije inverznega indeksa. Začeli bomo s najenostavnejšo naivno implementacijo. Izgleda takole.
Funkcija getMetricIDs pridobi seznam nizov. Vsak niz vsebuje label=value. Ta funkcija vrne seznam metricIDs.
Kako to deluje? Tukaj imamo globalno spremenljivko, ki se imenuje invertedIndex. To je običajen slovar (map), ki prikazuje niz na slice int-ov. Niz vsebuje label=value.
Implementacija funkcije: pridobimo metricIDs za prvi label=value, nato pa preidemo skozi vse ostale label=value, pridobimo metricIDs zanje. In pokličemo funkcijo intersectInts, o kateri bo govorjeno kasneje. In ta funkcija vrne presek teh seznamov.
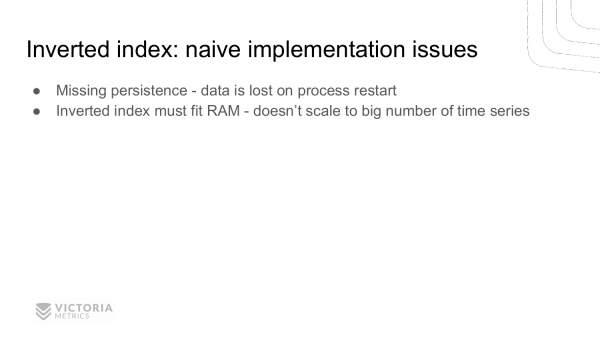
Kot vidite, implementacija inverznega indeksa ni tako zapletena. Toda to je naivna implementacija. Kakšne so njene pomanjkljivosti? Glavna pomanjkljivost naivne implementacije je, da se tak inverzni indeks hrani v operativni pomnilniku. Po ponovnem zagonu aplikacije izgubimo ta indeks. Ni shranjevanja tega indeksa na disk. Za bazo podatkov ta inverzni indeks verjetno ne bo ustrezal.
Druga pomanjkljivost je prav tako povezana s pomnilnikom. Inverzni indeks mora biti shranjen v operativni pomnilnik. Če preseže velikost operativnega pomnilnika, je očitno, da bomo dobili napako – out of memory error. In program ne bo deloval.
To težavo lahko rešimo s pomočjo že pripravljenih rešitev, kot so , ali .
Na kratko, potrebujemo bazo podatkov, ki omogoča hitro izvajanje treh operacij.
- Prva operacija je zapisovanje
ključ-vrednostv to bazo. To počne zelo hitro, kjerključ-vrednostso poljubne vrstice. - Druga operacija je hiter iskanje vrednosti po določenem ključu.
- In tretja operacija je hiter iskanje vseh vrednosti po določenem prefiksu.
LevelDB in RocksDB sta zapisani v Google in Facebook. Najprej je prišel LevelDB. Potem so fantje iz Facebooka vzeli LevelDB in začeli ga izboljševati, naredili so RocksDB. Sedaj skoraj vse notranje baze podatkov znotraj Facebooka delujejo na RocksDB, tudi MySQL so prenesli na RocksDB. Poimenovali so ga .
Inverzni indeks lahko realiziramo s LevelDB. Kako to storiti? Ključ shranimo label=value. In kot vrednost - identifikator časovne vrste, kjer je prisotna par label=value.
Če imamo veliko časovnih vrst s to par label=value, bo v tej bazi podatkov veliko vrstic z enakim ključem in različnimi timeseries_ids. Da dobimo seznam vseh timeseries_ids, ki se začnejo s to label=prefix, izvedemo range scan, za katerega je ta baza podatkov optimizirana. T. j. izberemo vse vrstice, ki se začnejo s label=prefix in dobimo potrebne timeseries_ids.
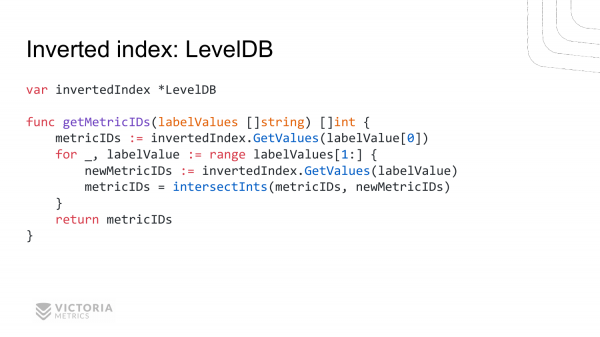
Tukaj je okvirna realizacija, kako bi izgledala v Go. Imamo inverzni indeks. To je LevelDB.
Funkcija je taka kot pri naivni realizaciji. Skoraj vrstica za vrstico ponavlja naivno realizacijo. Edini trenutek je, da namesto klicanja map se obračamo na inverzni indeks. Dobimo vse vrednosti za prvi label=value. Potem pregledamo vse preostale pare label=value in dobimo ustrezne nize metricIDs zanje. Nato najdemo presečišče.
Zveni dobro, a to rešitev ima pomanjkljivosti. VictoriaMetrics je sprva realizirala inverzni indeks na osnovi LevelDB. A na koncu so se morale odreči temu.
Zakaj? Ker je LevelDB počasnejši kot naivna realizacija. V naivni realizaciji ob danem ključu takoj dobimo celoten slice metricIDs. To je zelo hitra operacija — celoten slice je pripravljen za uporabo.
Pri LevelDB pa je pri vsakem klicu funkcije GetValues potrebno prebrati vse vrstice, ki se začnejo s label=value. In za vsako vrstico dobiti vrednost timeseries_ids. Iz takih timeseries_ids zbiramo slice teh timeseries_ids. Očitno je, da je to mnogo počasneje, kot preprosto klicanje običajnega mapu po ključu.
Drugi nedostatak je to što je LevelDB napisan u C-u. Pozivanje C funkcija iz Go-a nije vrlo brzo. To traje stotine nanosekundi. To nije brzo jer se u poređenju sa običnim pozivom funkcije napisanom u Go-u, koji traje 1-5 nanosekundi, razlika u performansama ispostavlja u desetinama puta. Za VictoriaMetrics, to je bio fatalni nedostatak 🙂
Zato sam napisao vlastitu implementaciju obrnute indeksa. I nazvao je .
Mergeset se oslanja na strukturu podataka MergeTree. Ova struktura podataka je preuzeta iz ClickHouse. Očigledno je da mergeset treba biti optimizovan za brzo pretraživanje timeseries_ids po zadatom ključu. Mergeset je napisan potpuno u Go-u. Možete pogledati . Implementacija mergeseta se nalazi u folderu . Možete pokušati da shvatite šta se tamo dešava.
API mergeseta je veoma sličan LevelDB-u i RocksDB-u. Tj. omogućava brzo čuvanje novih zapisa i brzo preuzimanje zapisa po zadatom prefiksu.
O nedostacima mergeseta ćemo razgovarati kasnije. Sada ćemo govoriti o problemima koji su nastali sa VictoriaMetrics u produkciji prilikom implementacije obrnute indeksa.
Zašto su se javili?
Prvi razlog je visok churn rate. U prevodu na srpski – to je česta promena vremenskih serija. To je kada vremenska serija završi i počne nova serija, ili počinje mnogo novih vremenskih serija. I to se događa često.
Drugi razlog je veliko broj vremenskih serija. Isprva, kada je monitoring postajao popularan, broj vremenskih serija je bio mali. Na primer, za svako računalo je potrebno pratiti opterećenje procesora, memorije, mreže i diska. 4 vremenske serije po računaru. Recimo da imate 100 računara i 400 vremenskih serija. To je vrlo malo.
Vremenom su ljudi smislili da se može meriti detaljnije informacije. Na primer, meriti opterećenje ne celog procesora, već pojedinačno svakog procesorskog jezgra. Ako imate 40 procesorskih jezgara, odgovarajuće, imate 40 puta više vremenskih serija za merenje opterećenja procesora.
Ampak to še ni vse. Vsaka procesorska jedro ima lahko več stanj, kot je stanje neaktivnosti (idle), ko miruje. Kot tudi delovanje v uporabniškem prostoru, delovanje v jedrnem prostoru in druga stanja. In vsako to stanje se prav tako lahko meri kot posamezna časovna vrsta. To dodatno povečuje število vrst za 7-8 krat.
Iz enega merila smo dobili 40 x 8 = 320 meril le za en računalnik. Pomnožimo s 100 in dobimo 32 000 namesto 400.
Nato je prišel Kubernetes. In to je še poslabšalo situacijo, ker lahko v Kubernetes gosti veliko različnih storitev. Vsaka storitev v Kubernetesu je sestavljena iz mnogih podov. In vse to je treba spremljati. Poleg tega imamo stalno uvajanje novih različic vaših storitev. Za vsako novo različico je potrebno ustvariti nove časovne vrste. Na koncu se število časovnih vrst eksponentno povečuje in soočamo se s težavo velikega števila časovnih vrst, ki se imenuje high-cardinality. VictoriaMetrics se s tem uspešno spopada v primerjavi z drugimi podatkovnimi bazami za časovne vrste.
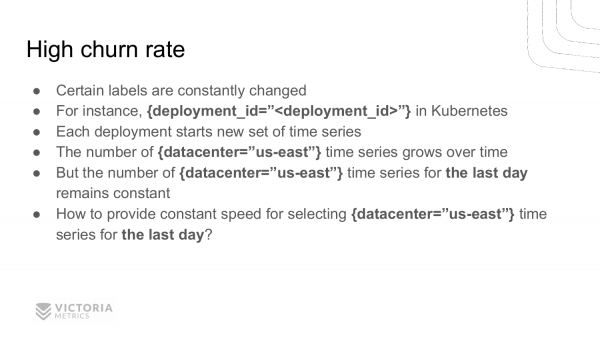
Podrobneje bomo obravnavali high churn rate. Kaj povzroča high churn rate v produkciji? Ker se nekatere vrednosti oznak in tagov nenehno spreminjajo.
Na primer, vzemimo Kubernetes, v katerem obstaja koncept deployment, tj. ko se uvaja nova različica vaše aplikacije. Razvijalci Kubernetesa so nekako odločili, da dodajo id oznake deploymenta v oznako.
Kam je to pripeljalo? Do tega, da se pri vsakem novem uvajanju vseh prejšnjih časovnih vrst prekine, namesto njih pa se začnejo nove časovne vrste z novo vrednostjo oznake deployment_id. Takšnih vrst je lahko sto tisoč in celo milijone.
Pomembna značilnost vsega tega je, da se skupno število časovnih vrst povečuje, vendar število časovnih vrst, ki so trenutno aktivne in prejemajo podatke, ostaja konstantno. To stanje se imenuje – high churn rate.
Osnovni problem high churn rate je zagotoviti stalno hitrost iskanja vseh časovnih vrst po določenem nizu oznak v določenem časovnem obdobju. Običajno je to časovno obdobje zadnja ura ali zadnji dan.
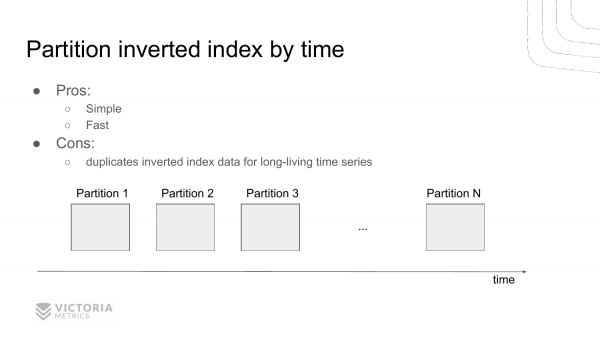
Kako rešiti ovaj problem? Evo prve opcije. To je da se invertovani indeks deli na nezavisne delove prema vremenu. Odnosno, prolazi neki vremenski interval, završavamo rad sa trenutnim invertovanim indeksom. I kreiramo novi invertovani indeks. Prolazi još jedan vremenski interval, kreiramo još jedan i tako dalje.
I prilikom pretrage ovih invertovanih indeksa pronalazimo skup invertovanih indeksa koji spadaju u zadati interval. I, shodno tome, biramo odatle id vremenskih serija.
To omogućava uštedu resursa, jer ne treba da pregledamo delove koji ne spadaju u zadati interval. Odnosno, obično, ako biramo podatke za poslednji sat, preskočimo zahteve za prethodne vremenske intervale.
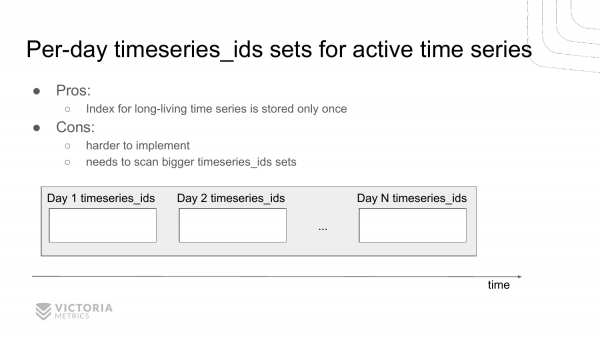
Postoji još jedna opcija za rešenje ovog problema. To je da za svaki dan čuvamo posebnu listu id vremenskih serija koje su se pojavile tog dana.
Prednost ovog rešenja u odnosu na prethodno rešenje je u tome što ne dupliramo informacije o vremenskim serijama koje ne nestaju tokom vremena. One su stalno prisutne i ne menjaju se.
Mane su u tome što je takvo rešenje složenije za implementaciju i teže se debaguje. I VictoriaMetrics je izabrala ovo rešenje. Tako je istorijski formirano. Ovo rešenje takođe daje dobre rezultate, u poređenju s prethodnim. Jer ovo rešenje nije implementirano zbog potrebe da se dupliraju podaci u svakoj particiji za vremenske serije koje se ne menjaju, tj. koje ne nestaju tokom vremena. VictoriaMetrics je prvobitno optimizovana za potrošnju diskovnog prostora, a prethodna implementacija je pogoršavala potrošnju diskovnog prostora. A ovo rešenje je bolje prilagođeno za minimizaciju potrošnje diskovnog prostora, pa je ono izabrano.
Morali smo se boriti s tim. Borba se svela na to da u ovoj implementaciji i dalje trebamo da biramo znatno veći broj timeseries_ids za podatke nego kada je invertovani indeks podeljen prema vremenu.
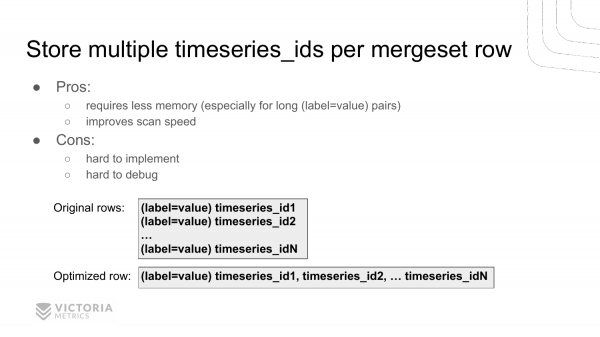
Kako smo rešili ovaj problem? Rešili smo ga na originalan način – čuvanjem nekoliko identifikatora vremenskih serija u svakoj stavci invertovanog indeksa umesto jednog identifikatora. Odnosno, imamo ključ label=value, ki se pojavlja v vsakem časovnem nizu. In zdaj shranjujemo več timeseries_ids v eni zapis.
Tukaj je primer. V preteklosti smo imeli N zapisov, zdaj pa imamo en zapis, katerega predpona je enak kot pri vseh drugih. Prejšnji zapis vsebuje vse id-je časovnih nizov.
To je omogočilo povečanje hitrosti iskanja takega obrnjenega indeksa do 10-krat. In zmanjšalo je porabo pomnilnika za predpomnilnik, ker zdaj shranjujemo niz label=value le enkrat v predpomnilniku, skupaj N-krat. In ta niz je lahko obsežen, če imate v oznakah in etiketanadelkih dolge vrstice, ki jih tja običajno dodaja Kubernetes.
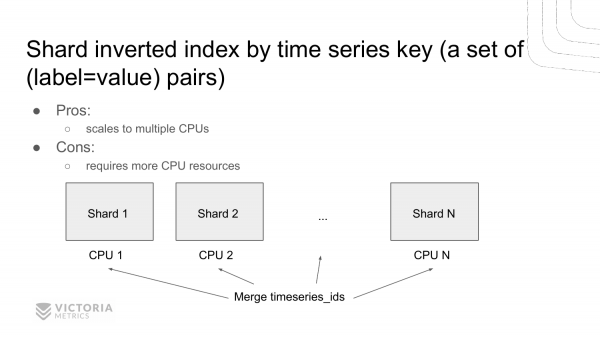
Še ena možnost za pospešitev iskanja po obrnjenem indeksu je delitev. Ustvarjanje več obrnjenih indeksov namesto enega in razdelitev podatkov med njimi po ključi. To je niz key=value parov. Torej imamo več neodvisnih obrnjenih indeksov, ki jih lahko povprašujemo hkrati na več procesorjih. Prejšnje implementacije so omogočale delo le v enoprocesorskem načinu, tj. skeniranje podatkov le na eni jedru. To rešitev omogoča skeniranje podatkov hkrati na več jeder, kar ClickHouse zelo rad počne. To nameravamo realizirati.
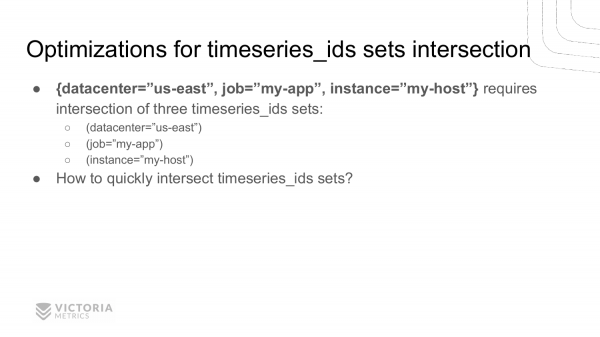
In zdaj se vrnimo k našim ovsom – k funkciji preseka timeseries_ids. Oglejmo si, kakšne bi mogle biti implementacije. Ta funkcija omogoča iskanje timeseries_ids za določen niz label=value.
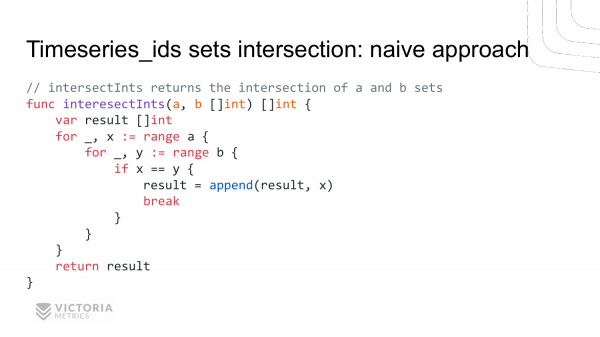
Prva možnost – to je naivna implementacija. Dva vgrajena cikla. Tukaj dobimo vhodne funkcije intersectInts dva slices — a in b. Na izhodu bi morala vrniti presek teh slices.
Naivna implementacija izgleda tako. Prehodimo skozi vse vrednosti iz slice a, znotraj tega cikla prehodimo skozi vse vrednosti slice b. In jih primerjamo. Če se ujemata, smo našli presek. In ga shranimo v result.
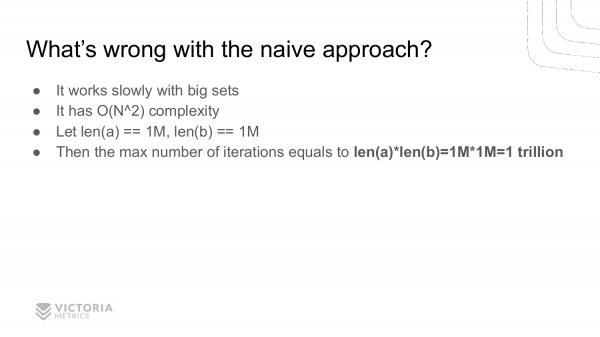
Kakšne so pomanjkljivosti? Kvadratna kompleksnost – to je njena glavna pomanjkljivost. Na primer, če imate velikosti slice a in b ena milijon, ta funkcija nikoli ne bo vrnila odgovora. Ker bo morala opraviti en bilijon iteracij, kar je zelo veliko tudi za moderne računalnike.
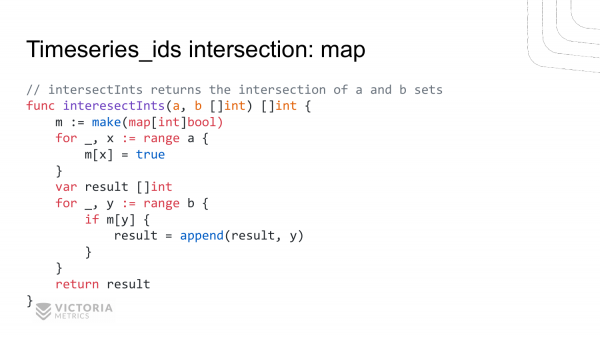
Druga implementacija temelji na mapi. Ustvarimo mapo. V to mapo postavimo vse vrednosti iz slice a. Nato gremo skozi posebno zanko po slice b. In preverimo – ali je ta vrednost iz slice b v map. Če obstaja, ga dodamo rezultatu.
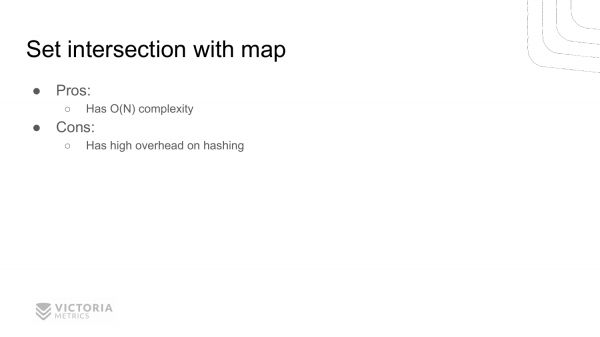
Kakšne so prednosti? Prednost je v tem, da ima tukaj le linearno kompleksnost. To pomeni, da se funkcija izvede veliko hitreje za velike velikosti rezin. Za rezino z milijon elementi bo ta funkcija izvedena v 2 milijonih iteracij, medtem ko je pri prejšnji funkciji potrebnih trikrat milijon iteracij.
Slabost pa je, da ta funkcija zahteva več pomnilnika za ustvarjanje te map.
Druga slabost je velika obremenitev zaradi heširanja. Ta slabost ni tako očitna. Za nas ni bila prav tako očitna, zato je bila sprva v VictoriaMetrics implementacija preseka preko map. A kasneje je profiliranje pokazalo, da se večina procesorskega časa porabi za zapisovanje v map in preverjanje obstoja vrednosti v tej map.
Zakaj se na teh mestih porablja procesorski čas? Ker v teh vrsticah Go izvaja operacijo heširanja. To pomeni, da izračuna hash ključa, da se nato lahko sklicuje na določen indeks v HashMap. Operacija izračuna hasha traja desetine nanosekund. To je za VictoriaMetrics počasi.
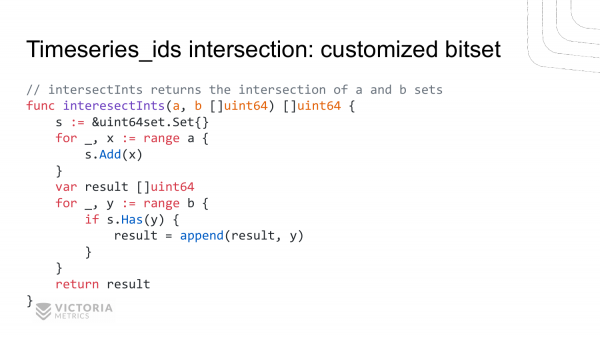
Odločil sem se za implementacijo bitseta, optimiziranega posebej za ta primer. Tako zdaj izgleda preseče dveh rezin. Tukaj ustvarimo bitset. Dodamo vanj elemente iz prve rezine. Potem preverimo prisotnost teh elementov v drugi rezini. In jih dodamo rezultatu. To pomeni, da se skoraj ne razlikuje od prejšnjega primera. Edina razlika je, da smo tukaj namesto obravnave z map uporabili prilagojene funkcije. add in has.
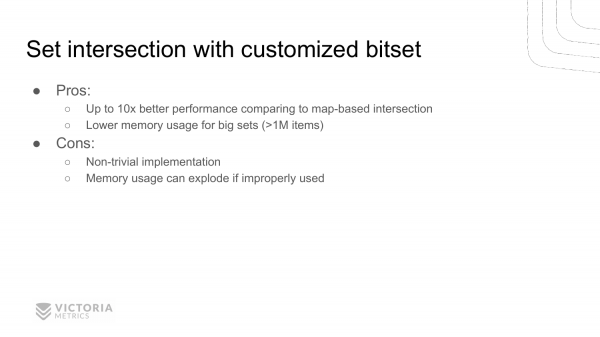
Na prvi pogled se zdi, da bi to moralo delovati počasneje, če je bila prej uporabljena standardna map, zdaj pa se kličejo še dodatne funkcije, vendar profiliranje kaže, da ta stvar deluje 10-krat hitreje kot standardna map za primer VictoriaMetrics.
Poleg tega porabi precej manj pomnilnika v primerjavi z implementacijo na map. Ker tukaj hranimo bite namesto osmobytnh vrednosti.
Slabost te implementacije pa je, da ni tako očitna, ni trivialna.
Še en pomanjkljivost, ki jo mnogi morda ne opazijo, je, da ta implementacija morda v nekaterih primerih slabo deluje. To pomeni, da je optimizirana za specifičen primer, v tem primeru za prekrivanje ids časovnih vrst VictoriaMetrics. To ne pomeni, da bo ustrezala vsem primerom. Če jo bomo napačno uporabili, ne bomo dobili izboljšanja zmogljivosti, temveč napako s pomanjkanjem pomnilnika in upočasnitev zmogljivosti.
Oglejmo si implementacijo te strukture. Če želite pogledati, se nahaja v izvorih VictoriaMetrics, v mapi . Optimizirana je prav za primer VictoriaMetrics, kjer timeseries_id predstavlja 64-bitno vrednost, kjer prvih 32 bitov ostane konstantnih, spremeni se le zadnjih 32 bitov.
Ta podatkovna struktura se ne shranjuje na disk; deluje le v pomnilniku.
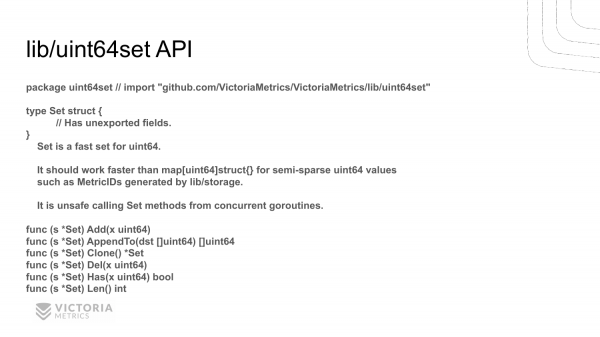
Tukaj je njen API. Ni zelo zapleten. API je prilagojen prav specifičnemu primeru uporabe VictoriaMetrics. To pomeni, da tukaj ni odvečnih funkcij. Tukaj so funkcije, ki jih jasno uporablja VictoriaMetrics.
Obstajajo funkcije add, ki dodaja nove vrednosti. Obstaja funkcija has, ki preverja nove vrednosti. In obstaja funkcija del, ki odstrani vrednosti. Obstaja pomožna funkcija len, ki vrne velikost množice. Funkcija clone klonira množico. In funkcija appendto pretvori to množico v slice timeseries_ids.
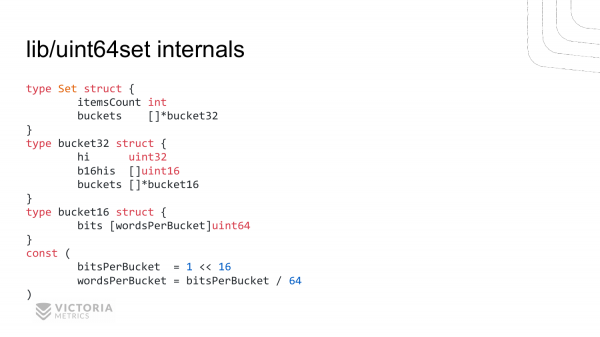
Tako izgleda implementacija te podatkovne strukture. V set sta dva elementa:
ItemsCount– to je pomožno polje, da hitro vrnemo število elementov v set. Brez tega pomožnega polja bi se lahko odpravili, vendar smo ga morali dodati, ker VictoriaMetrics pogosto preverja dolžino bitseta v svojih algoritmih.Drugo polje je
buckets. To je slice iz strukturebucket32. V vsaki strukturi je shranjenohipolje. To so zgornji 32 bitov. In dva slice —b16hisinbucketsizbucket16struktur.
Tukaj so shranjeni zgornji 16 bitov drugega dela 64-bitne strukture. Tukaj so bitseti za spodnjih 16 bitov vsakega bajta.
Bucket64 sestavlja niz uint64. Dolžina se izračuna s temi konstantami. V enem bucket16 lahko maksimalno shrani 2^16=65536 bitov. Če to delimo z 8, je to 8 kilobajtov. Če to delimo še enkrat z 8, je to 1000 uint64 vrednost. To pomeni, da Bucket16 – to je 8-kilobajtna struktura.
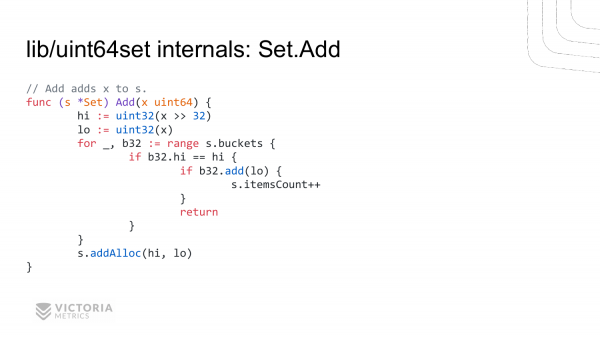
Oglejmo si, kako je implementiran eden od metod te strukture za dodajanje nove vrednosti.
Vse se začne s uint64 vrednosti. Izračunavamo gornjih 32 bita, izračunavamo donjih 32 bita. Prolazimo kroz sve buckets. Upoređujemo gornjih 32 bita u svakom bucket-u s dodatim vrednostima. I ako se poklapaju, pozivamo funkciju add u strukturi b32 buckets. I dodajemo donjih 32 bita. I ako to vrati true, to znači da smo dodali tu vrednost i da nismo imali takvu vrednost. Ako vrati false, to znači da je takva vrednost već postojala. Potom povećavamo broj elemenata u strukturi.
Ako nismo pronašli potrebnu spremnik s potrebnim hi-vrednostima, pozivamo funkciju addAlloc, koja alocira novu spremnik, dodajući je u strukturu bucket-a.
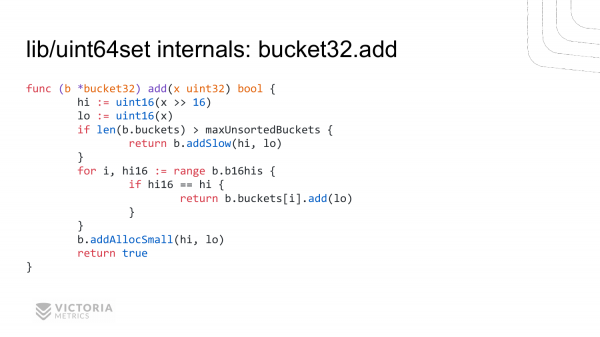
Ovo je implementacija funkcije b32.add. Slična je prethodnoj implementaciji. Izračunavamo gornjih 16 bita, donjih 16 bita.
Zatim prolazimo kroz sve gornjih 16 bita. Pronalazimo podudaranja. I kod podudaranja pozivamo metodu add, koju ćemo razmotriti na sledećoj strani za bucket16.
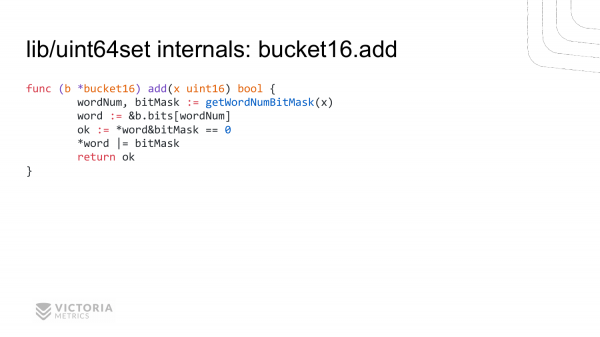
I ovo je najniži nivo, koji treba maksimalno optimizovati. Izračunavamo za uint64 id vrednost u slice bit-u, kao i bitmask. To je maska za ovu 64-bitnu vrednost, pomoću koje možemo proveriti da li je ovaj bit prisutan ili ga postaviti. Proveravamo prisutnost ovog bita, postavljamo ga i vraćamo prisutnost. Ova implementacija nam omogućava da ubrzamo operaciju preklapanja ids vremenskih serija 10 puta u poređenju sa običnim mapama.
U VictoriaMetrics, osim ove optimizacije, postoji mnogo drugih optimizacija. Većina ovih optimizacija dodana je ne bez razloga, već nakon profilisanja koda u produkciji.
To je glavno pravilo optimizacije – ne dodavati optimizaciju, pretpostavljajući da će ovde biti usko mesto, jer se može ispostaviti da ne postoji usko mesto. Optimizacija obično pogoršava kvalitet koda. Zato trebate optimizovati samo nakon profilisanja i poželjno u produkciji, tako da su to realni podaci. Kome je zanimljivo, možete pogledati izvorne kodove VictoriaMetrics i istražiti druge optimizacije koje su tamo prisutne.
Imam pitanje o bitset-u. Veoma podseća na implementaciju C++ vector bool, optimizovani bitset. Da li ste uzeli implementaciju odande?
Ne, ne od tam. Pri uresničitvi tega bitseta sem se orientiral na znanje strukture teh ids časovnih serij, ki se uporabljajo v VictoriaMetrics. Struktura je takšna, da so zgornji 32 biti večinoma stalni. Spodnji 32 bita se lahko spreminjajo. Čim nižji bit, tem pogosteje se lahko spreminja. Zato je ta implementacija posebej optimizirana za to strukturo podatkov. C++ implementacija, kolikor vem, je optimizirana za splošne primere. Če optimizirate za splošne primere, to pomeni, da ne bo najbolj optimalna za konkretne primere.
Priporočam, da si še ogledate predavanje Alekseja Milovida. Pred približno mesecem dni je govoril o optimizacijah v ClickHouse pod določenimi specializacijami. Pove, da so splošne C++ implementacije ali katerikoli druge implementacije prilagojene za dobro delovanje povprečno. Lahko delujejo slabše kot specializirane implementacije pod določenimi znanji, kot jih imamo mi, ko vemo, da so zgornji 32 biti večinoma stalni.
Imam drugo vprašanje. Katera so kardinalne razlike od InfluxDB?
Kardinalnih razlik je veliko. Glede zmogljivosti in porabe pomnilnika InfluxDB v testih kaže 10-krat večjo porabo pomnilnika za visoko kardinalne časovne serije, ko jih imate veliko, na primer milijone. Na primer, VictoriaMetrics porabi 1 GB na milijon aktivnih serij, medtem ko InfluxDB porabi 10 GB. To je velika razlika.
Druga kardinalna razlika je v tem, da ima InfluxDB čudne jezike poizvedb - Flux in InfluxQL. Nista posebej priročna za delo s časovnimi serijami v primerjavi s , ki ga podpira VictoriaMetrics. PromQL – to je jezik poizvedb iz Prometheusa.
In še ena razlika - InfluxDB ima nekoliko nenavaden model podatkov, kjer lahko vsaka vrstica hrani več polj z različnimi nabori oznak. Te vrstice so razdeljene še na različne tabele. Ta dodatna zapletenost otežuje kasnejše delo s to bazo. Težko jo je vzdrževati in razumeti.
V VictoriaMetrics je vse veliko bolj preprosto. Vsaka časovna serija predstavlja ključ-vrednost. Vrednost je niz točk - (časovni žig, vrednost), ključ pa je niz label=value. Nič ne ločuje aktivnosti in meritve. To vam omogoča, da izberete poljubne podatke in jih nato kombinirate, seštejete, odštejete, pomnožite in delite, kar je v nasprotju z InfluxDB, kjer med različnimi vrsticami še vedno niso uresničene nobene kalkulacije, kolikor vem. Tudi če so uresničene, so zapletene, morate napisati kup kode.
Imam dodatno vprašanje. Sem prav razumel, da je bila neka težava, o kateri ste govorili, da ta inverzni indeks ne more stati v spominu, zato poteka particioniranje?
Najprej sem prikazal naivno implementacijo inverznega indeksa na standardni Go map. Takšna implementacija ni primerna za zbirke podatkov, ker ta inverzni indeks ne shranjuje na disku, zbirka podatkov pa mora shranjevati na disk, da ostanejo ti podatki dostopni po ponovnem zagonu. V tej implementaciji se pri ponovnem zagonu aplikacije vaš inverzni indeks izgubi. In izgubite dostop do vseh podatkov, ker jih ne boste mogli najti.
Pozdravljeni! Hvala za predstavitev! Ime mi je Pavel. Sem iz podjetja Wildberries. Imamo nekaj vprašanj za vas. Prvo vprašanje. Kako menite, da bi bilo, če bi izbrali načelo pri zasnovi svoje aplikacije in podatke particionirali po času, potem bi morda lahko izvajali preseke podatkov med iskanjem, ki temeljijo samo na tem, da so v eni particiji podatki za en časovni interval, tj. za en časovni razpon, tako da ne bi bilo treba skrbeti, da so kosi različno razmetani? Drugo vprašanje — ker izvajate tak algoritem z bitsetom in vsemi ostalimi stvarmi, morda ste poskusili uporabiti procesorske instrukcije? Mogoče ste poskusili takšne optimizacije?
Na drugo takoj odgovorim. Do tega še nismo prišli. Ampak, če bo treba, bomo prišli. A prvi, kakšno je bilo vprašanje?
Razpravljali ste o dveh scenarijih. In rekli ste, da ste izbrali drugega s kompleksnejšo implementacijo. In niste izbrali prvega, kjer so podatki particionirani po času.
Da. V prvem primeru bi bil skupni obseg indeksa večji, ker bi morali v vsakem particiji shranjevati podvojene podatke za tiste časovne vrste, ki se nadaljujejo skozi vse te particije. In če imate nizek churn rate časovnih vrst, tj. nenehno se uporabljajo iste vrste, bi v prvem primeru veliko bolj izgubili v zasedenem diskovnem prostoru v primerjavi z drugim primerom.
Tako da – da, particioniranje po času je dobra izbira. To uporablja Prometheus. Vendar pa ima Prometheus še eno pomanjkljivost. Pri združevanju teh koščkov podatkov mora obdržati v pomnilniku meta-informacije o vseh oznakah in časovnih vrstah. Zato, če so koščki podatkov veliki, ki jih združuje, se poraba pomnilnika močno poveča pri združevanju, v nasprotju z VictoriaMetrics. Pri združevanju VictoriaMetrics sploh ne porabi pomnilnika, porabi le nekaj kilobajtov, ne glede na velikosti združevanih koščkov podatkov.
Algoritem, ki ga uporabljate, porabi pomnilnik. V njem so označene oznake časovnih vrst, na katerih so vrednosti. Na ta način preverjate parno prisotnost v enem nizu podatkov in v drugem. In razumete – ali je prišlo do preseka ali ne. Običajno v bazah podatkov izvajajo kurzorje, iteratorje, ki hranijo svoje trenutno stanje in tečejo po razvrščenih podatkih, kar omogoča enostavno kompleksnost teh operacij.
Zakaj ne uporabljamo kurzorjev za presek podatkov?
Da.
Imamo v LevelDB ali v mergeset prava razvrščena vrstica. Lahko gremo s kurzorjem in najdemo presek. Zakaj ne uporabljamo? Ker – je to počasi. Ker kurzorji predvidevajo, da je treba ob vsakem vrstici klicati funkcijo. Klic funkcije je 5 nanosekund. In če imate 100.000.000 vrstic, potem porabimo pol sekunde samo za klic funkcije.
To je res, ja. In zadnje vprašanje imam. Vprašanje se morda zdi malo nenavadno. Zakaj ob vnosu podatkov ne moremo takoj izračunati vse potrebne agregate in jih shraniti v želenem oblikovanju? Zakaj shranjevati ogromne količine v kakšne sisteme, kot so VictoriaMetrics, ClickHouse itd., da bi nato porabili veliko časa z njimi?
Dajem vam primjer kako bi to bilo jasnije. Recimo, kako radi mali igračka brzinomjer? On bilježi udaljenost koju ste prešli, cijelo vrijeme je dodajući u jednu vrijednost, u drugu – vrijeme. I dijeli. I dobiva prosječnu brzinu. Možete napraviti otprilike isto. Sabirati u letu sve potrebne činjenice.
Dobro, razumio sam pitanje. Vaš primjer ima smisla. Ako znate koje vam agregate trebaju, to je najbolja implementacija. No problem je što ljudi pohranjuju te metrike, neke podatke u ClickHouse i ne znaju još kako će ih u budućnosti agregirati, filtrirati, pa moraju pohranjivati sve sirove podatke. Ali ako znate da trebate izračunati nešto prosječno, zašto to ne biste izračunali, umjesto da spremate hrpu sirovih vrijednosti? No to je samo u slučaju ako točno znate što vam treba.
Usput, baze za pohranu vremenskih serija podržavaju izračunavanje agregata. Na primjer, Prometheus podržava . Odnosno, to se može učiniti ako znate koji će vam agregati trebati. U VictoriaMetrics to još nije dostupno, ali obično se ispred nje postavlja Prometheus, u kojem to možete učiniti s pravilima snimanja.
Na prethodnom poslu, bilo je potrebno izračunati broj događaja u kliznom prozoru za posljednji sat. Problem je što smo morali raditi prilagođenu implementaciju u Gou, tj. servis za izračunavanje ovog. Taj servis na kraju nije bio trivijalan, jer je teško izračunati. Implementacija može biti jednostavna ako trebate izračunati neke aggregate na fiksnim vremenskim intervalima. No, ako želite izračunati događaje u kliznom prozoru, to nije tako jednostavno kao što se čini. Mislim da to još nije implementirano ni u ClickHouse-u ni u bazama vremenskih serija, jer je komplicirano za implementaciju.
I još jedno pitanje. Sada smo govorili o prosjeku i sjetio sam se da je nekada postojala stvar kao što je Graphite s backend-om Carbon. I on je mogao prorijediti stare podatke, tj. ostaviti jednu točku u minuti, jednu točku na sat itd. U načelu, to je prilično praktično ako su nam potrebni sirovi podaci, uvjetno govoreći, za mjesec dana, a sve ostalo se može prorijediti. No, Prometheus i VictoriaMetrics ne podržavaju ovu funkcionalnost. Planira li se podržavati? Ako ne, zašto?
Hvala na pitanju. Naši korisnici to povremeno postavljaju. Pitaju kada ćemo dodati podršku za smanjivanje (downsampling). Tu je nekoliko problema. Prvo, svaki korisnik to shvata na svoj način: downsampling neko želi da dobije bilo koju proizvoljnu tačku na zadanom intervalu, neko želi maksimalne, minimalne, prosečne vrednosti. Ako u vašu bazu podataka piše mnogo sistema, ne može ih se obraditi na isti način. Može se desiti da svaka sistema zahteva različito smanjivanje. I to je teško za implementaciju.
Drugo, VictoriaMetrics, kao i ClickHouse, optimizovana je za rad sa velikim obimima sirovih podataka, tako da može obraditi milijardu redova za manje od sekunde, ako imate mnogo jezgara u vašem sistemu. Skener vremenskih serija u VictoriaMetrics – 50.000.000 tačaka u sekundi po jezgru. I ta performansa se skalira na dostupna jezgra. Dakle, ako imate 20 jezgara, na primer, dobićete skeniranje milijarde tačaka u sekundi. Ova osobina VictoriaMetrics i ClickHouse-a smanjuje potrebu za downsampling.
Još jedna osobina je ta što VictoriaMetrics efikasno kompresuje te podatke. Kompresija u proseku na produkciji iznosi od 0,4 do 0,8 bajta po tački. Svaka tačka predstavlja timestamp + vrednost. I ona se kompresuje ispod jednog bajta u proseku.
Sergije. Imam pitanje. Koja je minimalna kvanta vremena za zapis?
Jedna milisekunda. Nedavno smo razgovarali sa drugim programerima baza podataka za vremenske serije. Njihova minimalna kvanta vremena je jedna sekunda. I u Graphite, na primer, takođe jedna sekunda. U OpenTSDB takođe jedna sekunda. U InfluxDB – nanosekundna preciznost. U VictoriaMetrics – jedna milisekunda, jer je u Prometheus jedna milisekunda. VictoriaMetrics je prvobitno razvijena kao udaljena pohrana za Prometheus. Ali sada može čuvati podatke i iz drugih sistema.
Osoba sa kojom sam razgovarao kaže da je njihova preciznost u sekundama — njima je to dovoljno, jer zavisi od tipa podataka koji se čuvaju u bazi vremenskih serija. Ako su to DevOps podaci ili podaci sa infrastrukture, gde ih prikupljate svakih 30 sekundi ili minute, tada je sekundna preciznost dovoljna, manje nije potrebno. A ako prikupljate te podatke iz sistema visokofrekventnog trgovanja, tada je potrebna nanosekundna preciznost.
Milisekundna preciznost u VictoriaMetrics odgovara DevOps slučajevima i može se koristiti za većinu slučajeva koje sam spomenuo na početku izlaganja. Jedina situacija u kojoj možda neće odgovarati je visoko frekventno trgovanje.
Hvala! I još jedno pitanje. Kakva je kompatibilnost sa PromQL?
Potpuna obrnuta kompatibilnost. VictoriaMetrics potpuno podržava PromQL. Pored toga, dodaje dodatne napredne funkcionalnosti na PromQL, koja se naziva . O ovoj dodatnoj funkcionalnosti postoji izlaganje na YouTubeu. Govorio sam o tome na Monitoring Meetup-u na proleće u Sankt Peterburgu.
Telegram kanal .
Samo registrovani korisnici mogu učestvovati u anketi. , molim vas.
Šta vas sprečava da pređete na VictoriaMetrics kao dugoročno skladište za Prometheus? (Pišite u komentarima, dodao bih to u anketu))
71,4%Ne koristim Prometheus5
28,6%Nisam znao za VictoriaMetrics2
Glasalo je 7 korisnika. Uzdržalo se 12 korisnika.
Izvor: habr.com
