

Pozdravljeni, Habrčani. Tradicionalno nadaljujemo z deljenjem zanimivih vsebin pred začetkom novih tečajev. Danes smo posebej za vas prevedli članek o Google Cloud Spanner, priredili pa smo ga ob začetku tečaja. .
Prvotno objavljeno na .
Kot podjetje, ki ponuja vrsto oblačnih POS rešitev za trgovce, restavracije in spletne prodajalce po vsem svetu, Lightspeed uporablja več različnih vrst platform baz podatkov za številne transakcijske, analitične in iskalne primere. Vsaka od teh platform baz podatkov ima svoje prednosti in slabosti. Ko je Google predstavil Cloud Spanner z obetavnimi funkcijami, neviden v svetu relacijskih baz podatkov, kot so skoraj neomejena horizontalna razširljivost in 99,999% pogodba o nivoju storitev (SLA), nismo mogli zamuditi priložnosti, da jo dobimo v naše roke!
Da bi dali celovit pregled našega izkustva s Cloud Spanner ter meril, ki smo jih uporabili, bomo obravnavali naslednje teme:
- Naša merila
- Cloud Spanner v dveh besedah
- Naša ocena
- Naši zaključki
1. Naša merila
Preden se poglobimo v značilnosti Cloud Spanner ter njegove podobnosti in razlike z drugimi rešitvami na trgu, najprej spregovorimo o osnovnih uporabnih primerih, ki smo jih imeli v mislih, ko smo razmišljali o tem, kje implementirati Cloud Spanner v naši infrastrukturi:
- Kot zamenjavo (prevladujočega) tradicionalnega rešitve za SQL bazo podatkov
- Kot OLTP rešitev z podporo OLAP
Opomba: Za poenostavitev in udobje primerjave ta članek primerja Cloud Spanner z različicami MySQL družine rešitev GCP Cloud SQL in Amazon AWS RDS.
Uporaba Cloud Spanner kot zamenjave tradicionalnega rešitve za SQL bazo podatkov
V okolju tradicionalnih baz podatkov, ko čas odziva na poizvedbo v bazo podatkov približa ali celo preseže vnaprej določene mejne vrednosti aplikacije (predvsem zaradi povečanega števila uporabnikov in/ali poizvedb), obstaja več načinov za zmanjšanje časa odziva na sprejemljive ravni. Vseeno pa večina teh rešitev vključuje ročno posredovanje.
Na primer, prvi korak, ki ga je treba narediti, je, da se osredotočite na različne parametre baze podatkov, povezane z zmogljivostjo, in jih prilagodite, da se čim bolje ujemajo s scenariji uporabe aplikacij. Če to ne zadostuje, lahko izberete vertikalno ali horizontalno skaliranje baze podatkov.
Vertikalno skaliranje aplikacije pomeni nadgradnjo instance strežnika, običajno z dodajanjem več procesorjev/jedrov, več RAM-a, hitrejših shranjevanj itd. Dodajanje več strojnih virov prinaša povečanje zmogljivosti baze podatkov, merjeno predvsem v transakcijah na sekundo in zakasnitvah transakcij za sisteme OLTP. Relacijski sistemi podatkovnih baz (ki uporabljajo večnitni pristop), kot je MySQL, se dobro vertikalno skalirajo.
Ta pristop ima več pomanjkljivosti, najobstojnejša pa je največja velikost strežnika na trgu. Ko dosežete mejo največje instance strežnika, ostane le še ena pot: horizontalno skaliranje.
Horizontalno skaliranje je pristop, pri katerem se klastru dodajajo novi strežniki, da se idealno linearno povečuje zmogljivost z dodajanjem števila strežnikov. Večina tradicionalnih sistemov podatkovnih baz slabo horizontalno skalira ali pa se sploh ne skalira. Na primer, MySQL se lahko horizontalno skalira za operacije branja, tako da doda slave-bralnike, ne more pa se horizontalno skalirati za operacije pisanja.
Po drugi strani pa lahko Cloud Spanner zaradi svoje narave enostavno horizontalno skalira z minimalnim posegom.
Funkcionalna baza podatkov kot storitev mora biti ocenjena z različnih vidikov. Kot osnovo smo vzeli najpopularnejšo oblačno bazo podatkov — Google, GCP Cloud SQL in Amazon, AWS RDS. Pri naši oceni smo se osredotočili na naslednje kategorije:
- Ujemanje funkcij: razširitev SQL, DDL, DML; knjižnice povezav/konectorji, podpora transakcijam in tako naprej.
- Podpora razvoju: enostavnost razvoja in testiranja.
- Podpora za upravljanje: upravljanje primeri — na primer, navzgor/navzdol skaliranje in nadgradnja primerov; SLA, varnostno kopiranje in obnova; varnost/nadzor dostopa.
Uporaba Cloud Spanner kot rešitve OLTP s podporo OLAP
Čeprav Google izrazito ne trdi, da je Cloud Spanner namenjen analitičnemu obdelovanju, deli nekatere lastnosti z drugimi mehanizmi, kot sta Apache Impala & Kudu in YugaByte, ki so namenjeni OLAP obremenitvam.
Tudi če bi obstajala le majhna verjetnost, da je Cloud Spanner vključil dosledno horizontalno razširljiv HTAP (hibridna transakcijska/analitična obdelava) z (bolj ali manj) uporabnim nizom funkcij OLAP, menimo, da bi to zaslužilo našo pozornost.
Ob tem v mislih smo preučili naslednje kategorije:
- Nalaganje podatkov, indeksi in podpora za particioniranje
- Učinkovitost poizvedb in DML
2. Cloud Spanner v dveh besedah
Google Spanner je klasterski sistem za upravljanje relacijskih podatkovnih baz (RDBMS), ki ga Google uporablja za več svojih storitev. Google ga je odprl za uporabnike Google Cloud Platform na začetku leta 2017.
Tukaj je nekaj lastnosti Cloud Spanner:
- Močno dosledno razširljiv klaster RDBMS: uporablja strojno sinhronizacijo časa za zagotavljanje doslednosti podatkov.
- Podpora za transakcije preko tabel: transakcije lahko zajemajo več tabel — ni nujno omejiti se na eno samo tabelo (za razliko od Apache HBase ali Apache Kudu).
- Tabele na osnovi primarnega ključa: vse tabele morajo imeti določen primarni ključ (PK), ki je lahko sestavljen iz več stolpcev tabele. Podatki v tabeli so shranjeni po PK, kar omogoča zelo učinkovito in hitro iskanje po PK. Kot druge sisteme, ki temeljijo na PK, je treba implementacijo oblikovati ob upoštevanju vnaprej načrtovanih uporabniških primerov, da se doseže .
- Izmenjive tabele: tabele mogu imati fizičke zavisnosti jedna od druge. Redovi podtabele mogu biti povezani sa redovima roditeljske tabele. Ovaj pristup ubrzava pretraživanje odnosa koji se mogu definisati u fazi modeliranja podataka, na primer, prilikom zajedničkog smeštaja klijenata i njihovih faktura.
- Indeksi: Cloud Spanner podržava sekundarne indekse. Indeks se sastoji od indeksiranih kolona i svih kolona PK. Ako je potrebno, indeks može sadržavati i druge neindeksirane kolone. Indeks može biti izmenjen u odnosu na roditeljsku tabelu za ubrzavanje upita. Na indekse se primenjuju određena ograničenja, kao što je maksimalan broj dodatnih kolona koje se čuvaju u indeksu. Takođe, upiti preko indeksa mogu biti manje direktni nego u drugim RDBMS-ovima.
„Cloud Spanner automatski bira indeks samo u retkim slučajevima. Konkretno, Cloud Spanner ne bira sekundarni indeks automatski ako upit zahteva bilo koje kolone koje nisu sačuvane u ».
- Sporazum o nivou usluge (SLA): implementacija u jednoj regiji sa SLA od 99,99%; višeregionalne implementacije sa SLA od 99,999%. Iako je sam sporazum o nivou usluge samo sporazum, a ne neka garancija, verujem da zaposleni u Google-u zaista imaju neke tačne podatke da bi mogli da daju tako ozbiljno tvrdnju. (Za informacije, 99,999% znači 26,3 sekunde nedostupnosti usluge mesečno.)
- Više:
Opomba: Projekat Apache Tephra dodaje proširenu podršku za transakcije u Apache HBase (takođe sada implementiran u Apache Phoenix kao beta verzija).
3. Naša ocena
Dakle, svi smo čitali tvrdnje Google-a o prednostima Cloud Spanner-a — praktično neograničeno horizontalno skaliranje uz visok nivo doslednosti i veoma visok SLA. Iako su ovi zahtevi, u svakom slučaju, izuzetno teški za postizanje, naš cilj nije bio da ih opovrgavamo. Umesto toga, fokusirajmo se na druge stvari koje brinu većinu korisnika baza podataka: jasnoća i jednostavnost korišćenja.
Oceni smo Cloud Spanner kao zamenu za Sharded MySQL
Google Cloud SQL in Amazon AWS RDS sta najbolj priljubljena OLTP podatkovna skladišča na trgu oblakov in imata zelo široko izbiro funkcij. Vendar pa, da bi lahko skalirali te podatkovne baze preko velikosti enega vozlišča, morate izvajati delitev aplikacij. Takšen pristop prinaša dodatno kompleksnost tako za aplikacije kot za upravljanje. Oglejali smo si, kako Spanner ustreza scenariju združitve več segmentov v en instančni model in katere funkcije (če sploh) boste morda morali opustiti.
Podpora za SQL, DML in DDL, pa tudi za priključek in knjižnice?
Najprej, ko zaženete katero koli podatkovno bazo, morate ustvariti podatkovni model. Če menite, da lahko povežete JDBC Spanner s svojim najljubšim SQL orodjem, boste odkrili, da lahko podatke dostopate z njegovo pomočjo, vendar ne morete uporabljati za ustvarjanje tabel ali spreminjanje (DDL) ali katerekoli operacije vstavljanja/posodabljanja/brisanja (DML). Uradni JDBC iz Google ne podpira nobenega od obeh.
„Trenutno gonilniki ne podpirajo DML ali DDL operacij.“
Dokumentacija Spanner
S konzolo GCP situacija ni boljša - lahko pošiljate le SELECT poizvedbe. Na srečo obstaja JDBC gonilnik s podporo za DML in DDL iz skupnosti, vključno s transakcijami. . Čeprav je ta gonilnik izjemno koristen, preseneča odsotnost lastnega JDBC gonilnika od Google. Na srečo Google ponuja precej široko podporo za odjemalske knjižnice (na podlagi gRPC): C#, Go, Java, node.js, PHP, Python in Ruby.
Skoraj obvezna uporaba lastnih API vmesnikov Cloud Spanner (zaradi pomanjkanja DDL in DML v JDBC) prinaša določene omejitve za povezane področja kode, kot so skladišča povezav ali ogrodja za povezovanje podatkov (na primer, Spring MVC). Na splošno pri uporabi JDBC lahko prosto izbirate svoj najljubši skladišče povezav (na primer, HikariCP, DBCP, C3PO itd.), ki je testirano in dobro deluje. V primeru lastnih API Spanner moramo zaneseti na ogrodja/skupe povezovanja/seje, ki smo jih ustvarili sami.
Zasnova, usmerjena na primarni ključ (PK), omogoča Cloud Spannerju zelo hitro dostopanje do podatkov preko PK, vendar prav tako povzroča nekatere težave pri poizvedbah.
- Ne morete posodobiti vrednosti primarnega ključa; najprej morate izbrisati zapis z izvirnim PK in ga znova vstaviti z novo vrednostjo. (To je podobno drugim PK usmerjenim bazam podatkov/mehanizmom shranjevanja.)
- Vsi operaterji UPDATE in DELETE morajo določiti PK v WHERE, zato ne more biti praznih operaterjev DELETE all - vedno mora biti podpoizvedba, na primer: UPDATE xxx WHERE id IN (SELECT id FROM table1)
- Pomanjkanje možnosti avtoinkrementa ali česa podobnega, kar določa zaporedje za polje PK. Da to deluje, mora ustrezna vrednost biti ustvarjena na strani aplikacije.
Sekundarni indeksi?
Google Cloud Spanner ima vgrajeno podporo za sekundarne indekse. To je zelo prijetna funkcija, ki ni vedno prisotna v drugih tehnologijah. Apache Kudu trenutno sploh ne podpira sekundarnih indeksov, medtem ko Apache HBase ne podpira indeksov neposredno, jih pa lahko dodaja preko Apache Phoenix.
Indekse v Kudu in HBase lahko modeliramo kot ločeno tabelo z različno sestavo primarnih ključev, vendar mora atomarnost operacij, ki jih izvajamo s starševsko tabelo in povezanimi indeksnimi tabelami, potekati na ravni aplikacij in ni trivialna pri pravilni izvedbi.
Kot je omenjeno v pregledu Cloud Spanner, se njegovi indeksi lahko razlikujejo od indeksov MySQL. Zato je treba biti še posebej previden pri sestavljanju poizvedb in profiliranju, da zagotovimo uporabo ustreznega indeksa tam, kjer je to potrebno.
Pogledi?
Zelo priljubljen in koristen objekt v bazi podatkov so pogledi. Lahko so koristni za veliko število uporabniških primerov; moja dva najljubša sta raven logične abstrakcije in raven varnosti. Na žalost Cloud Spanner NE podpira pogledov. Vendar nas to le delno omejuje, saj za dovoljenja доступа ni podrobnosti na ravni stolpcev, kjer bi lahko bili pogledi sprejemljiva rešitev.
V dokumentaciji Cloud Spanner v razdelku, ki podrobno opisuje kvote in omejitve (), vključno s tem, da obstaja eno, ki je lahko problematično za nekatere aplikacije: Cloud Spanner ima privzeto omejitev največ 100 baz podatkov na instanco. Očitno je, da lahko to postane resna ovira za bazo podatkov, namenjeno širjenju na več kot 100 baz podatkov. Na srečo smo po pogovoru z našim tehničnim predstavnikom Googla ugotovili, da se ta omejitev lahko poveča skoraj do poljubne vrednosti prek Googleove podpore.
Podpora za razvoj?
Cloud Spanner ponuja precej dobro podporo programskim jezikom za delo z njegovim API-jem. Uradno podprte knjižnice vključujejo C#, Go, Java, node.js, PHP, Python in Ruby. Dokumentacija je dovolj podrobna, a tako kot pri drugih naprednih tehnologijah je skupnost precej majhna v primerjavi z najpopularnejšimi tehnologijami baz podatkov, kar lahko povzroči daljše čase reševanja manj pogostih primerov uporabe ali težav.
Kaj pa podpora za lokalni razvoj?
Nismo našli načina za ustvarjanje instance Cloud Spanner v lokalnem okolju. Najbližje, kar smo dobili, je Docker slika. , ki je v osnovi podobna, a se v praksi močno razlikuje. Na primer, CockroachDB lahko uporablja PostgreSQL JDBC. Ker mora biti razvojno okolje čim bližje delovnemu okolju, Cloud Spanner ni idealen, saj se je treba zanašati na popolno instanco Spanner. Za zmanjšanje stroškov lahko izberete instanco za eno regijo.
Podpore za administracijo?
Ustvarjanje instance Cloud Spanner je zelo preprosto. Preprosto izberete med ustvarjanjem večregijske ali instance za eno regijo, navedete regijo(e) in število vozlišč. Kmalu po manj kot minuti bo instanca zagnana in pripravljena za delo.
Nekatere osnovne metrike so neposredno dostopne na strani Spanner v konzoli Google. Podrobnejši pregledi so na voljo prek Stackdriverja, kjer lahko tudi nastavite mejne vrednosti metrik in politike obveščanja.
Dostop do virov?
MySQL ponuja obsežne in zelo podrobne nastavitve dovoljenj/rol uporabnikov. Enostavno je mogoče nastaviti dostop do določene tabele ali celo le do podmnožice njenih stolpcev. Cloud Spanner uporablja orodje Google Identity & Access Management (IAM), ki omogoča določanje politik in dovoljenj le na zelo visoki ravni. Najbolj podroben variants je dovoljenje na ravni baze podatkov, ki ne ustreza večini proizvodnih primerov. To omejitev vas prisili, da dodate dodatne varnostne ukrepe v vašo kodo, infrastrukturo ali oboje, da preprečite nepooblaščen dostop do virov Spanner.
Varnostne kopije?
Preprosto rečeno, varnostne kopije v Cloud Spanner ne obstajajo. Čeprav visoki zahtevki Google SLA lahko zagotovijo, da ne boste izgubili podatkov zaradi okvar strojne opreme ali baz podatkov, človeških napak, napak aplikacij itd. Vsi poznamo pravilo: visoka razpoložljivost ne nadomesti razumne strategije varnostnega kopiranja. Trenutno je edini način varnostnega kopiranja podatkov programska pretok podatkov iz baze v ločeno shranjevanje.
Učinkovitost poizvedb?
Za nalaganje podatkov in testiranje poizvedb smo uporabili Yahoo! Cloud Serving Benchmark. V spodnji tabeli je prikazana delovna obremenitev B YCSB s razmerjem branja 95 % in pisanja 5 %.
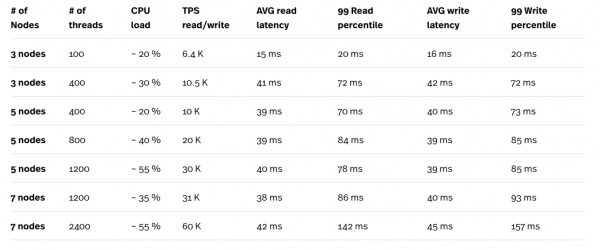
* Obremenitveni test je bil izveden na računalniškem motorju (CE) n1-standard-32 (32 vCPU, 120 GB pomnilnika), testni instančni nikoli ni bil ozko grlo pri testih.
** Maksimalno število niti v enem primeru YCSB je 400. Na splošno je bilo potrebno zagnati šest vzporednih instanc YCSB testov, da bi dobili skupno 2400 niti.
Gledajući rezultate testova, posebno kombinaciju opterećenja procesora i TPS-a, jasno vidimo da se Cloud Spanner prilično dobro skalira. Veliko opterećenje koje stvara veliki broj niti kompenzuje se većim brojem čvorova u Cloud Spanner klasteru. Iako izgleda da je latencija prilično visoka, posebno pri radu sa 2400 niti, da bi se dobili precizniji podaci moglo bi biti potrebno ponoviti testiranje sa 6 manjim instancama računalnog motora. Svaka instanca će pokretati jedan YCSB test umesto jedne velike CE instance sa 6 paralelnih testova. Tako će biti lako razlikovati latencije zahteva Cloud Spanner-a i latencije koje dodaje mrežna veza između Cloud Spanner-a i CE instance na kojoj se test izvršava.
Kako Cloud Spanner funkcioniše kao OLAP?
Particionisanje?
Deljenje podataka na fizički i\/ili logički nezavisne segmente, nazvane particije, vrlo je popularna koncepcija koja je prisutna u većini OLAP mehanizama. Particije mogu značajno poboljšati performanse upita i održavanje baze podataka. Dalje istraživanje particija bi se produbilo u poseban članak (članake), stoga hajde da samo pomenemo važnost postojanja šeme particionisanja i sub-particionisanja. Mogućnost deljenja podataka na particije, a čak i dalje na sub-particije je ključ za performanse analitičkih upita.
Cloud Spanner ne podržava particije kao takve. On deli podatke unutar na takozvane split-ove na osnovu opsega primarnog ključa. Deljenje se automatski vrši radi ravnoteže opterećenja u Cloud Spanner klasteru. Vrlo korisna funkcija Cloud Spanner-a je razdvajanje osnovnog opterećenja roditeljske tabele (tabele koja se ne prepliće sa drugom). Spanner automatski određuje da li split sadrži podatke koji se čitaju češće od podataka u drugim split-ima, i može doneti odluku o daljem deljenju. Tako sada može biti uključeno više čvorova u upitu, što takođe efikasno povećava propusnost.
Učitavanje podataka?
Način Cloud Spanner za velike podatke je isti kao i pri uobičajenoj učitavanju. Da biste postigli maksimalnu performansu, morate slediti nekoliko preporuka, uključujući:
- Sortirajte vaše podatke prema primarnom ključu.
- Podelite ih na 10*broj čvorova odvojenih sekcija.
- Kreirajte skup radnih zadataka koji učitavaju podatke paralelno.
Pri takvom učitavanju podataka koriste se svi čvorovi Cloud Spanner-a.
Koristili smo opterećenje A YCSB za generisanje skupa podataka od 10M redova.
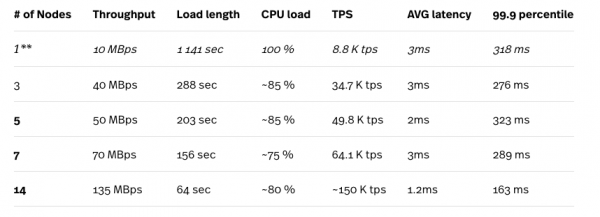
* Opterećenje je testirano na računarskom motoru n1-standard-32 (32 vCPU, 120 GB RAM), a test instanca nikada nije bila usko grlo u testovima.
** Postavljanje na 1 čvor se ne preporučuje za bilo kakvo proizvodno opterećenje.
Kao što je ranije pomenuto, Cloud Spanner automatski obrađuje deljenje na osnovu njihovog opterećenja, tako da se rezultati poboljšavaju nakon nekoliko uzastopnih ponavljanja testa. Rezultati predstavljeni ovde su najbolji rezultati koje smo dobili. Gledajući na gornje brojeve, možemo videti kako Cloud Spanner (dobro) skalira sa povećanjem broja čvorova u klasteru. Brojevi koji se ističu predstavljaju izuzetno niske prosečne latencije, što kontrastira sa rezultatima mešanih opterećenja (95% za čitanje i 5% za pisanje), kako je opisano u prethodnom odeljku.
Skaliranje?
Povećavanje i smanjenje broja čvorova Cloud Spanner-a je zadatak koji se obavlja jednim klikom. Ako želite brzo učitati podatke, možete razmotriti povećanje instance do maksimuma (u našem slučaju to je bilo 25 čvorova u regionu US-EAST), a zatim smanjiti broj čvorova koji odgovaraju vašem uobičajenom opterećenju, nakon što su svi podaci u bazi podataka, imajući u vidu ograničenje od 2 TB/čvor.
Podsetili smo se na ovo ograničenje čak i sa mnogo manjom bazom podataka. Nakon nekoliko prolaza opterećenja testova, naša baza podataka imala je veličinu od oko 155 GB, a prilikom smanjenja na instancu od 1 čvora dobili smo sledeću grešku:
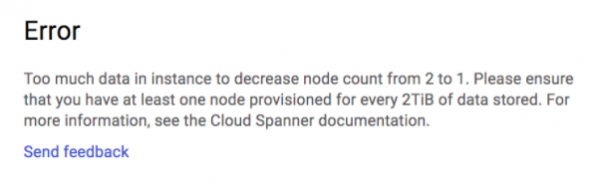
Uspešno smo smanjili sa 25 na 2 instance, ali smo zapeli na dva čvora.
Povečanje i smanjenje broja čvorova u Cloud Spanner klasteru može se automatizovati pomoću REST API-ja. To može biti posebno korisno za smanjenje preopterećenja sistema tokom perioda velike aktivnosti.
Performanse OLAP upita?
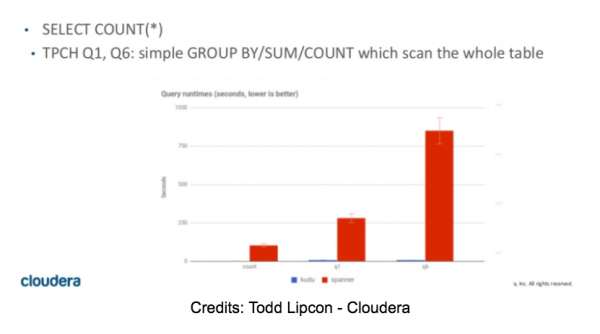
Prvobitno smo planirali posvetiti značajno vreme našoj proceni Spanner-a u ovom delu. Nakon nekoliko SELECT COUNT upita, odmah smo shvatili da će testiranje biti kratko i da Spanner NEće biti pogodan kao OLAP motor. Bez obzira na broj čvorova u klasteru, jednostavno prebrojavanje broja redova u tabeli koja ima 10M redova trajalo je od 55 do 60 sekundi. Pored toga, svaki upit koji je zahtevao veći obim memorije za čuvanje međurezultata završio je greškom OOM.
SELECT COUNT(DISTINCT(field0)) FROM usertable; — (10M jedinstvenih vrednosti) -> SpoolingHashAggregateIterator je ponestalo memorije tokom nove linije.
Neke brojke za TPC-H upite mogu se pronaći u članku Todda Lipkona , slajdovi 42 i 43. Ove brojke se slažu sa našim sopstvenim rezultatima (nažalost).
4. Naša zapažanja
Uzimajući u obzir trenutno stanje funkcija Cloud Spanner-a, teško je zamisliti njegovu jednostavnu zamenu za postojeće OLTP rešenje, posebno kada vaše potrebe prevaziđu njegove mogućnosti. Bilo bi potrebno uložiti značajno vreme kako bi se izgradilo rešenje uzimajući u obzir nedostatke Cloud Spanner-a.
Kada smo počeli evaluaciju Cloud Spanner-a, očekivali smo da će njegove funkcije upravljanja biti na nivou ili barem ne tako daleko od drugih Google SQL rešenja. Međutim, bili smo iznenađeni potpunim nedostatkom rezervnih kopija i veoma ograničenim pristupom resursima. Da ne spominjemo nedostatak prikaza, odsustvo lokalnog razvojnog okruženja, nepodržane sekvence, JDBC bez podrške za DML i DDL i tako dalje.
Torej, kam naj gre tisti, ki potrebuje razširitev transakcijske baze podatkov? Zdi se, da trenutno na trgu ni enotne rešitve, ki bi ustrezala vsem primerom uporabe. Na voljo je več rešitev s closed in open source (nekatere so omenjene v tem članku), od katerih ima vsaka svoje prednosti in slabosti, vendar nobena ne ponuja SaaS z SLA 99,999% in visoko stopnjo doslednosti. Če je visok nivo SLA vaša glavna prioriteta in niste nagnjeni k razvoju lastne rešitve za več oblačnih okolij, bi lahko bil Cloud Spanner rešitev, ki jo iščete. Vendar pa morate biti obveščeni o vseh njegovih omejitvah.
Za poštenost je treba omeniti, da je Cloud Spanner bil na voljo javnosti šele spomladi 2017, zato je razumljivo pričakovati, da se lahko nekateri njegovi trenutni pomanjkljivosti sčasoma odpravijo (upajmo), in ko se to zgodi, bi lahko spremenili igro. Navsezadnje je Cloud Spanner več kot le stranski projekt za Google. Google ga uporablja kot osnovo za druge Google proizvode. Ko je Google nedavno zamenjal Megastore v Google Cloud Storage z Cloud Spanner, je to omogočilo, da je Google Cloud Storage postalo strogo dosledno za sezname objektov na svetovni ravni (kar še vedno ne velja za ).
Torej, upanje še obstaja… upamo.
S tem je vse. Tako kot avtor članka tudi mi še naprej upamo, kaj pa vi mislite o tem? Pišite v komentarjih.
Vse zainteresirane vabimo na obisk našega v okviru katerega bomo podrobno predstavili tečaj od OTUS.
Izvor: habr.com
