

Prazniki so minili in vrnili smo se z drugim zapisom v seriji o Istio Service Mesh.
Današnja tema je Circuit Breaker, kar v slovenščini pomeni 'samodejni odklopnik' ali 'varovalka'. V Istio ta odklopnik ne izključi kratkega stika ali prenapolnjenega vezja, ampak okvarjene kontejnerje.
Kako naj bi to delovalo v idealnem primeru
Ko mikroservisi upravlja Kubernetes, na primer v okviru platforme OpenShift, se avtomatsko prilagajajo obremenitvi navzgor in navzdol. Ker mikroservisi delujejo v podih, je na eni končni točki lahko več primerkov kontejneriziranega mikroservisa, Kubernetes pa usmerja zahteve in uravnava obremenitve med njimi. In – v idealnem svetu – bi vse to moralo delovati brezhibno.
Spomnimo se, da so mikroservisi majhni in efemerni. Efmernost, ki tu pomeni enostavno nastajanje in izginjanje, se pogosto podcenjuje. Rojstvo in smrt novega primerka mikroservisa v podu sta povsem pričakovana, OpenShift in Kubernetes se s tem dobro spopadata, vse deluje odlično – a spet, le v teoriji.
Kako to dejansko deluje
In zdaj si predstavljajte, da je nek konkreten primer mikroservisa, torej kontejner, odpovedal: bodisi ne odgovarja (napaka 503), bodisi – kar je še slabše – reagira, vendar prepočasno. Z drugimi besedami, deluje slabo ali ne odgovarja na zahteve, a kljub temu ni samodejno odstranjen iz baze. Kaj storiti v tem primeru? Ponoviti poskus? Odstraniti ga iz usmerjevanja? In kaj pomeni 'predolgo' – koliko je to v številkah in kdo to določa? Morda ga preprosto pustiti na miru in poskusiti kasneje? Če da, kako dolgo pa?
Kaj je Pool Ejection v Istio
In tu priskoči na pomoč Istio s svojimi zaščitnimi mehanizmi Circuit Breaker, ki začasno odstranijo pokvarjene kontejnerje iz bazena virov za usmerjanje in uravnavanje obremenitve ter izvajajo postopek Pool Ejection.
Z uporabo strategije zaznavanja odstopanj (outlier detection) Istio zaznava nenavadne pode in jih odstrani iz bazena virov za določen čas, ki ga imenujemo 'spalno okno' (sleep window).
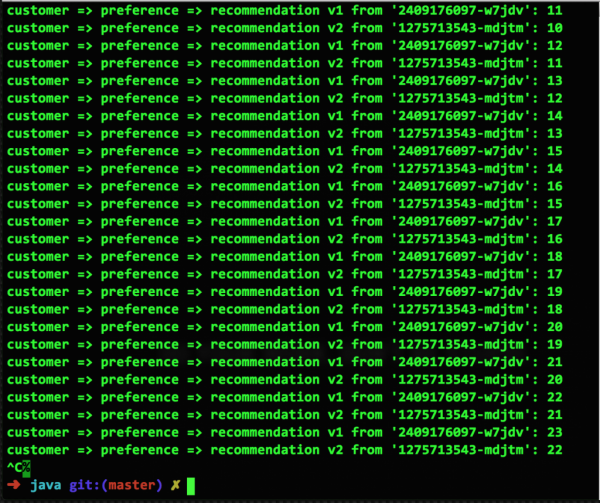
Da bi pokazali kako to radi u Kubernetesu na platformi OpenShift, započinjemo sa screenshotom normalno funkcionalnih mikroservisa iz primjera u repozitoriju . Ovdje imamo dva pod-a, v1 i v2, u kojem svaki radi jedan kontejner. Kada se ne koriste Istio pravila usmjeravanja, Kubernetes po defaultu primjenjuje ravnomjerno uravnoteženo cikličko usmjeravanje:
Pripremamo se za kvar
Prije nego što napravimo Pool Ejection, trebamo stvoriti Istio pravilo usmjeravanja. Recimo da želimo raspodijeliti zahtjeve između podova u omjeru 50/50. Također, povećat ćemo broj kontejnera v2 s jednog na dva, ovako:
oc scale deployment recommendation-v2 --replicas=2 -n tutorial
Sada postavljamo pravilo usmjeravanja da se promet raspodijeli između podova u omjeru 50/50.
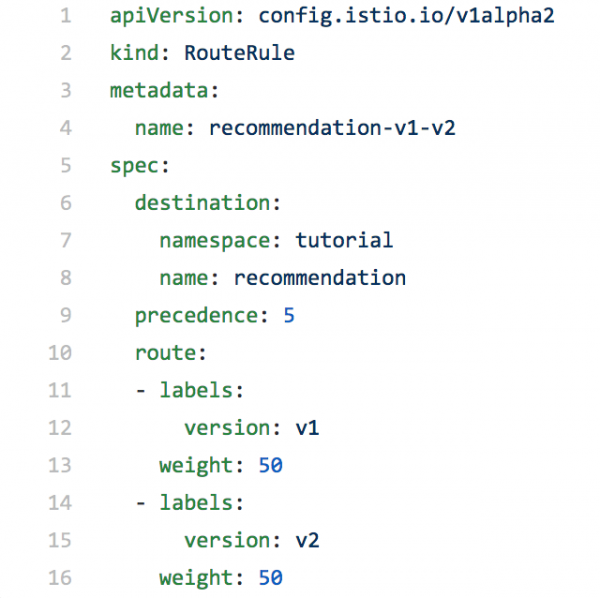
A evo kako izgleda rezultat ovog pravila:
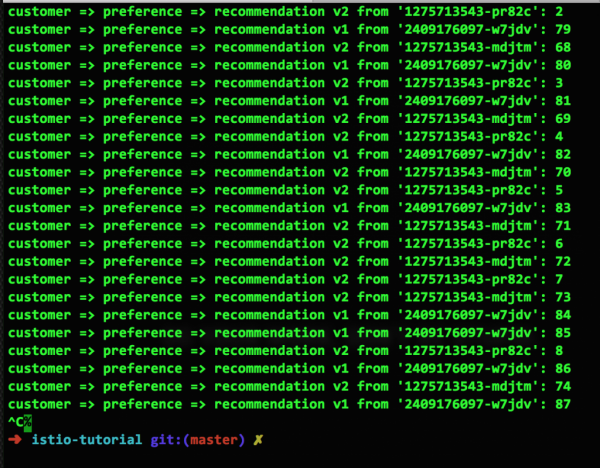
Može se prigovoriti da na ovom ekranu nije 50/50, već 14:9, ali s vremenom će se situacija stabilizirati.
Uzrokovanje kvara
Sada ćemo izbaciti jedan od dva kontejnera v2, tako da imamo jedan ispravan kontejner v1, jedan ispravan kontejner v2 i jedan neispravan kontejner v2:
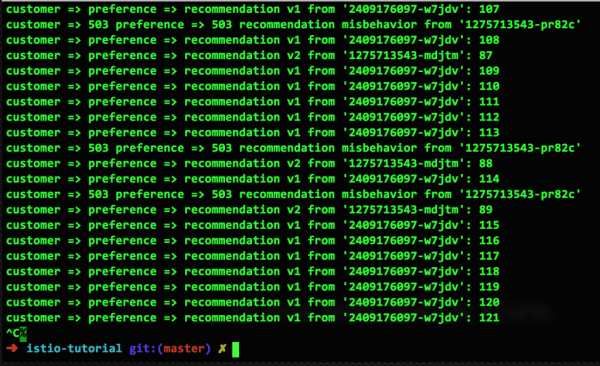
Popravak kvara
Dakle, imamo neispravan kontejner i došlo je vrijeme za Pool Ejection. Uz vrlo jednostavnu konfiguraciju isključit ćemo ovaj neispravni kontejner iz bilo kojih shema usmjeravanja na 15 sekundi s nadom da će se sam vratiti u ispravno stanje (ili će se ponovo pokrenuti ili obnoviti svoju funkcionalnost). Evo kako izgleda ova konfiguracija i rezultati njenog rada:
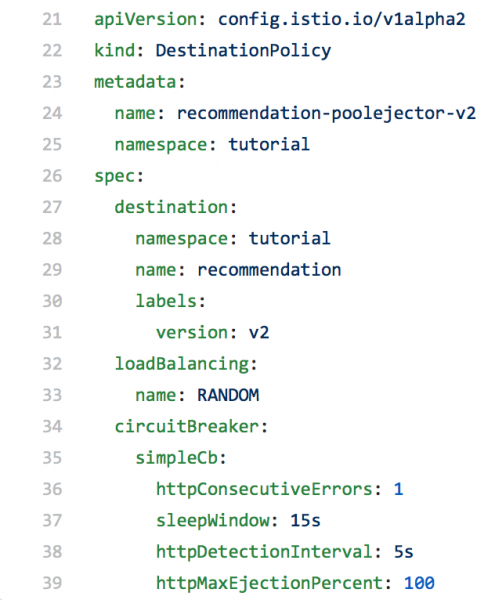
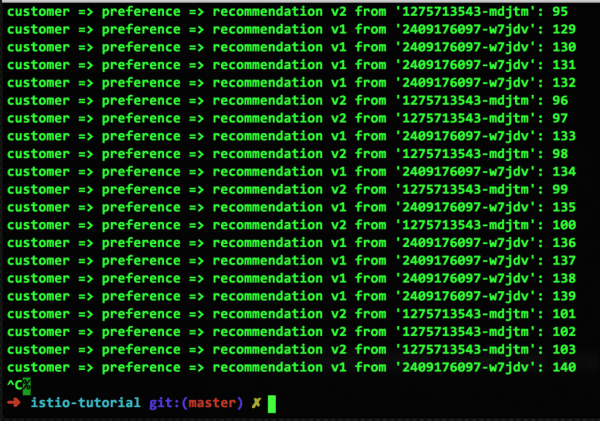
Kao što se može vidjeti, neispravan kontejner v2 više se ne koristi pri usmjeravanju zahtjeva, jer je isključen iz pulta. No, nakon 15 sekundi automatski će se vratiti u pul. U suštini, upravo smo pokazali kako radi Pool Ejection.
Počinjemo graditi arhitekturu
Pool Ejection u kombinaciji s mogućnostima praćenja Istio-a omogućava početak izgradnje okvira za automatsku zamjenu neispravnih kontejnera kako bi se smanjili, a u nekim slučajevima i potpuno uklonili zastoji i kvarovi.
NASA ima jedan poznati moto – Failure Is Not an Option, čiji je autor šef misije . V slovenščino ga lahko prevedemo kot „Poraz ni možnost“, kar pomeni, da lahko vse deluje, če imate dovolj volje. V resničnem življenju pa napake ne nastanejo le občasno, ampak so neizbežne, povsod in v vsem. Kako se torej spopasti z njimi v primeru mikroservisov? Po našem mnenju je bolje zanašati se ne na voljo, temveč na sposobnosti kontejnerjev. , , i .
Istio, kot smo že omenili, izvaja odlično uveljavljeno koncept avtomatskih odklopnikov iz fizičnega sveta. Tako kot električni odklopnik prekine težavni del vezja, tako programski Circuit Breaker v Istio prekine povezavo med tokom zahtevkov in problematičnim kontejnerjem, ko nekaj ni v redu s končno točko, na primer, ko je strežnik padel ali začel upočasniti.
Pri tem se v drugem primeru težave le povečujejo, saj usihanje enega kontejnerja ne povzroča le verižnih zamud v storitvah, ki se sklicujejo nanj, in posledično znižuje učinkovitost sistema kot celote, temveč tudi povzroča ponavljajoče se zahtevke na že tako počasi delujočo storitev, kar le še poslabša situacijo.
Circuit Breaker v teoriji
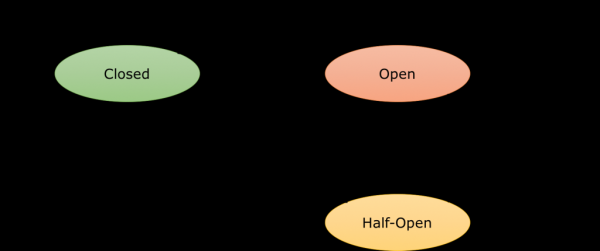
Circuit Breaker je proxy, ki nadzira tok zahtevkov do končne točke. Ko ta točka preneha delovati ali - odvisno od nastavitev - začne upočasniti, proxy prekine povezavo s kontejnerjem. Po tem se promet preusmeri na druge kontejnerje, preprosto zaradi uravnavanja obremenitve. Povezava ostaja odprta (open) v času določenega okna spanja, recimo dve minuti, nato pa se šteje za polodprto (half-open). Poskus pošiljanja naslednjega zahtevka določa nadaljnje stanje povezave. Če je s storitvijo vse v redu, se povezava vrne v delovno stanje in postane spet zaprta (closed). Če pa s storitvijo še vedno nekaj ni v redu, se povezava znova prekine in okno spanja se ponovno aktivira. Tako izgleda poenostavljena diagram stanja Circuit Breaker:
Pomembno je opozoriti, da vse to poteka na ravni, recimo, sistemske arhitekture. Zato boste v nekem trenutku morali naučiti svoje aplikacije delovati s Circuit Breakerjem, na primer, da v odgovoru posredujejo privzeto vrednost ali pa, če je to mogoče, ignorirajo obstoj storitve. Za to se uporablja bulkhead pattern, vendar presega obseg tega članka.
Circuit Breaker v praksi
Za primer bomo na OpenShiftu zagnali dve različici našega mikrostoritve za priporočila. Različica 1 bo delovala normalno, medtem ko bomo v v2 vključili zamudo, da posnemamo zaostanke na strežniku. Za ogled rezultatov uporabljamo orodje :
siege -r 2 -c 20 -v customer-tutorial.$(minishift ip).nip.io
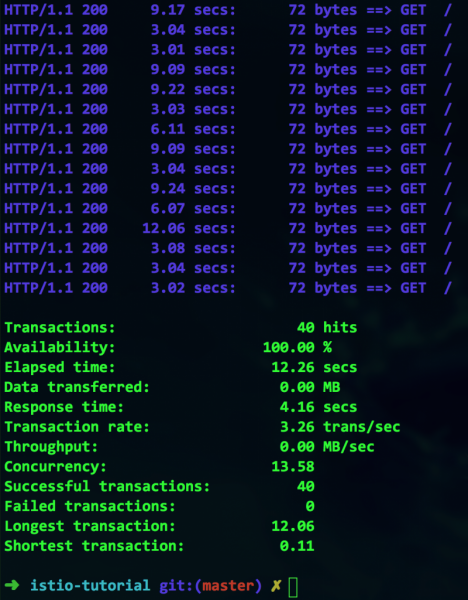
Vse se zdi, da deluje, ampak po kakšni ceni? Na prvi pogled imamo 100 % dostopnost, toda poglejte – največja dolžina transakcije je kar 12 sekund. To je očitna ožina in potrebno jo je razširiti.
Zato bomo s pomočjo Istio izključili dostop do počasnih kontejnerjev. Tako izgleda ustrezna konfiguracija z uporabo Circuit Breakerja:
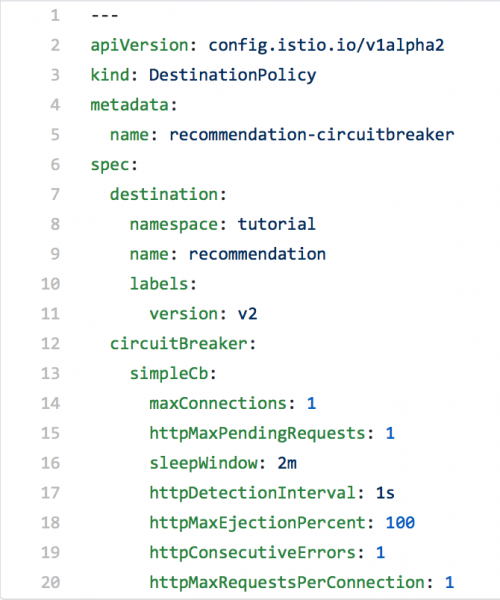
Zadnja vrstica s parametrom httpMaxRequestsPerConnection signalizira, da se mora povezava prekiniti, ko poskuša ustvariti še eno – drugo – povezavo poleg že obstoječe. Ker naš kontejner posnema počasno storitev, se bodo take situacije občasno pojavljale, in takrat bo Istio vrnil napako 503, kakor pa bo pokazal siege:
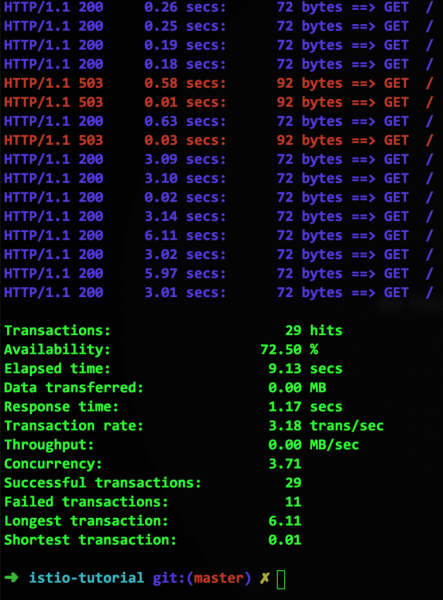
Dobro, imamo Circuit Breaker, kaj zdaj?
Torej, implementirali smo samodejno izklopitev, ne da bi se dotaknili izvorne kode storitev. Z uporabo Circuit Breakerja in zgoraj opisane procedure Pool Ejection lahko odstranimo počasne kontejnerje iz nabora virov, dokler se ne vrnejo v normalo, in preverimo njihovo stanje z določenim časovnim intervalom – v našem primeru je to dve minuti (parameter sleepWindow).
Upoštevajte, da sposobnost aplikacije, da reagira na napako 503, še vedno določa izvorna koda same aplikacije. Obstaja veliko strategij dela s Circuit Breakerjem, ki se uporabljajo glede na situacijo.
V naslednjem prispevku: bomo govorili o sledenju in izvajanju nadzora, ki sta že vgrajena ali jih je enostavno dodati v Istio, ter o tem, kako namerno vnašati napake v sistem.
Izvor: habr.com
