

Pozdravljeni, moje ime je Sergej Emeljančik. Sem vodja podjetja Audit-Telekom, glavni razvijalec in avtor sistema Veliam. Odločil sem se napisati članek o tem, kako sva s prijateljem ustvarila outsourcing podjetje, razvila programsko opremo za svoje potrebe in jo kasneje začela distribuirati vsem, ki so želeli, preko sistema SaaS. O tem, kako sem kategorično dvomil, da je to mogoče. V članku ne bo samo zgodbe, temveč tudi tehnični podrobnosti o tem, kako je bil izdelek Veliam ustvarjen. Vključeni bodo tudi nekateri kosi izvorne kode. Povedal bom, katere napake smo storili in kako smo jih kasneje popravili. Imeli smo pomisleke, ali naj tak članek objavimo. A sem pomislil, da je bolje to narediti, prejeti povratne informacije in se izboljšati, kot pa ne objaviti članka in razmišljati, kako bi bilo, če ...
Pozadina
Delal sem v neki IT podjetju kot zaposleni. Podjetje je bilo kar veliko s razvejeno mrežno strukturo. Ne bom se ustavljal pri svojih delovnih nalogah, samo povem, da med njimi zagotovo ni bila razvijanje česarkoli.
Imeli smo monitoring, a iz akademskega interesa sem želel poskusiti napisati svoj osnovni sistem. Ideja je bila taka: želel sem, da bi bilo to spletno, da bi se lahko enostavno brez nameščanja kakršnihkoli strank prijavil in pogledal, kaj se dogaja z mrežo z katerega koli naprave, vključno z mobilno napravo preko Wi-Fi, poleg tega pa sem želel hitro razumeti, v katerem prostoru se nahaja oprema, ki je „zatajila“, saj so bili zelo strogi zahtevki glede časa odziva na takšne težave. Na koncu se je v glavi porodila ideja, da napišem preprosto spletno stran, na kateri bo v ozadju jpeg s shemo mreže, izrezati moramo naprave s njihovimi IP naslovi z te slike, in nad sliko na pravilnih koordinatah prikazovati dinamično vsebino v obliki zelenega ali utripujočega rdečega IP naslova. Naloga je postavljena, začnimo.
Prej sem se ukvarjal s programiranjem v Delphiju, PHP, JS in zelo površinsko C++. Dobre obvladam delovanje mrež. VLAN, usmerjanje (OSPF, EIGRP, BGP), NAT. To je bilo dovolj, da sem sam napisal prototip preprostega monitoringa.
Napisal sem, kar sem imel v mislih, v PHP. Strežnik Apache in PHP je bil na sistemu Windows, ker je bil Linux zame takrat nekaj nejasnega in zelo zapletenega. Kot se je izkazalo kasneje, sem se močno motil, saj je v mnogih primerih Linux veliko lažji od Windows, vendar je to ločena tema, in vsi vemo, koliko polemik je na to temo. Načrtovalec opravil Windows je vsakih nekaj sekund (natančno se ne spomnim, ampak nekaj takega kot enkrat na tri sekunde) klical PHP skript, ki je pingo z vsemi objekti in shranjeval stanje v datoteko.
system(“ping -n 3 -w 100 {$ip_address}“);
Da-da, delo z bazo podatkov mi takrat tudi ni bilo znano. Nisem vedel, da lahko procesi delujejo paralelno, in prehod čez vse vozlišča v omrežju je trajal dolgo časa, ker je potekalo v enem toku. Še posebej so se težave pojavile, ko je bilo več vozlišč nedostopnih, saj je vsak od njih obdržal skript za 300 ms. Na strani odjemalca je bila preprosta funkcija v zanki, ki je vsakih nekaj sekund prenašala posodobljene informacije s strežnika preko Ajax poizvedb in posodabljala vmesnik. Po treh neuspelih pingih zapored pa je, če je bila na računalniku odprta spletna stran z nadzorom, zvenela vesela melodija.
Ko sem dosegel uspeh, sem bil zelo navdušen nad rezultatom in razmišljal, da bi lahko dodal še kaj (glede na svoje znanje in možnosti). Vendar pa mi nikoli niso bile všeč sisteme z milijonom grafikonov, ki so, kot sem takrat menil, in še danes menim, v večini primerov nepotrebni. Hotel sem dodati le tisto, kar bi mi dejansko pomagalo pri delu. Ta načelo še danes ostaja temeljno pri razvoju Veliam. Potem sem spoznal, da bi bilo zelo dobro, če ne bi bilo treba imeti odprtega nadzora in vedeti za težave, ampak ko se težava pojavi, jo preveriti in ugotoviti, kje je problematična točka omrežja in kaj storiti naprej. Elektronske pošte takrat nisem spremljal, preprosto je nisem uporabljal. Našel sem na spletu, da obstajajo SMS prehodi, na katere lahko pošljem GET ali POST zahtevo, in mi pošljejo SMS na mobilni telefon z besedilom, ki ga napišem. Takoj sem razumel, da si to zelo želim. In začel sem preučevati dokumentacijo. Po nekaj času sem to dosegel in zdaj sem prejemal SMS o težavah v omrežju na mobilnik z imenom „padajoče enote“. Čeprav je bil sistem primitiven, je bil napisan zame, in kar me je takrat najbolj motiviralo za njegov razvoj — je bila to aplikacija, ki mi dejansko pomaga pri delu.
In prišel je dan, ko je eden od internetnih kanalov na delu odpovedal, moj nadzor pa mi tega ni sporočil. Googleovi DNS so se še vedno odlično pingali. Prišel je čas, da pomislim, kako lahko spremljam, ali je komunikacijski kanal živ. Obstaja veliko idej, kako to doseči. Do vse opreme nimam dostopa. Moral sem najti način, kako lahko ugotovim, kateri kanali so aktivni, vendar brez možnosti, da to pogledam na omrežni opremi. Takrat mi je kolega dal idejo, da bi morda sledenje poti do javnih strežnikov lahko bilo drugačno, odvisno od tega, po katerem komunikacijskem kanalu se trenutno povezujem z internetom. Preveril sem in se izkazalo, da je tako. Ob obstajajo različne poti pri sledenju.
system(“tracert -d -w 500 8.8.8.8”);
Tako je nastao još jedan skript, odnosno, praćenje je iz nekog razloga dodato na kraj istog skripta koji je pingoovao sve uređaje u mreži. Jer, to je takođe bio dug proces koji se izvršavao u istom toku i usporavao rad celog skripta. Ali tada to nije bilo tako očigledno. No, tako ili onako, radio je svoj posao, u kodu je bilo strogo propisano kakvo je praćenje trebalo biti za svaki od kanala. Tako je počeo da funkcioniše sistem koji je već nadgledao (što je malo nategnuto, pošto nije bilo prikupljanja nekih metrika, već samo ping) mrežne uređaje (rutere, prekidače, wi-fi itd.) i komunikacione kanale sa spoljnim svetom. SMS-ovi su redovno stizali i na dijagramu je uvek bilo jasno vidljivo gde je problem.
Dalje, u svakodnevnom radu bilo je potrebno baviti se krosiranjima. I svaki put ulaziti u Cisco prekidače da bih video koji interfejs treba koristiti postalo je dosadno. Kako bi bilo sjajno da mogu kliknuti na monitoringu na objekt i videti listu njegovih interfejsa sa opisima. To bi mi uštedelo vreme. Osim toga, u ovoj shemi ne bi bilo potrebno pokretati Putty ili SecureCRT, unositi naloge i komande. Samo bih kliknuo na monitoringu, video šta mi treba i otišao da obavljam svoj posao. Počeo sam da tražim kako mogu da komuniciram sa prekidačima. Na brzinu su se pojavila dva rešenja: SNMP ili pristup prekidaču preko SSH, unositi potrebne komande i parsirati rezultat. SNMP sam odbacio zbog složenosti realizacije, žurio sam da dobijem rezultat. Sa SNMP bi trebalo dugo kopati u MIB, na osnovu tih podataka formirati informacije o interfejsima. Ima jedna sjajna komanda u CISCO
show interface statusPrikazuje točno ono što mi je potrebno za unakrsne analize. Zašto se mučiti s SNMP-om kada jednostavno želim vidjeti ishod ove komande, pomislio sam. Nakon nekog vremena, implementirao sam tu mogućnost. Kliknuo sam na objekt na web stranici. Aktivirala se akcija koja je putem AJAX-a obratila serveru, a on se spojio putem SSH-a na preklopnik koji mi treba (podaci za prijavu bili su u kodu, nisam imao želju da to obogaćujem, pravim posebne izbornike gdje bi se mogli mijenjati podaci o prijavi iz sučelja, bio je potreban rezultat i to brzo) unosio sam gore navedenu komandu i vraćao nazad u preglednik. Tako sam počeo vidjeti informacije o sučeljima jednim klikom miša. To je bilo izuzetno praktično, posebno kada je trebalo gledati te informacije na različitim preklopnicima odjednom.
Monitoring kanala temeljen na traciranju na kraju se pokazao kao ne najbolja ideja, jer su se ponekad izvodili radovi na mreži, i traciranje se moglo mijenjati, a monitoring bi počeo da mi vrišti da postoje problemi s kanalima. Ali, nakon što sam potrošio puno vremena na analizu, shvatio sam da svi kanali rade, a moj monitoring me vara. Na kraju sam zamolio kolege koji su upravljali preklopnicima koji oblikuju kanale da mi jednostavno šalju syslog kada se stanje vidljivosti susjeda (neighbor) promijeni. Stoga je to bilo mnogo jednostavnije, brže i istinitije nego traciranje. Došlo je do događaja tipa neighbor lost, i odmah šaljem obavijest o padu kanala.
Nakon toga, dodani su ispisi po kliku na objekt, još nekoliko komandi i dodat je SNMP za prikupljanje nekih metrika, a na tome je u suštini sve. Sustav se više nije razvijao. Radio je sve što mi je bilo potrebno, bio je dobar alat. Mnogi čitatelji će mi vjerojatno reći da već postoji hrpa softvera na internetu za rješavanje tih problema. Ali, zapravo, tada nisam mogao pronaći besplatne takve proizvode i želja za razvojem programerskih vještina bila je velika, a što može bolje motivirati od stvarnog primjenjivog zadatka. Na tome je prva verzija monitoringa završena i više se nije modificirala.
Osnivanje kompanije Audit-Telekom
S časom sem začel delati dodatno v drugih podjetjih, saj mi je delovni čas to omogočal. Ko delaš v različnih podjetjih, se hitro povečuje znanje na različnih področjih in dobro se razvijaš. Obstajajo podjetja, kjer si, kot se pogosto pravi, tudi krojač, tudi žetev in tudi igralec na harmoniki. Po eni strani je to težavno, po drugi strani, če ne lenariš, postaneš strokovnjak širokega profila, kar ti omogoča hitrejše in učinkovitejše reševanje nalog, ker veš, kako deluje povezano področje.
Moj prijatelj Pavel (tudi IT strokovnjak) me je nenehno poskušal prepričati, naj se lotim svojega posla. Bilo je nešteto idej z različnimi možnostmi za svoje podjetje. To se je razpravljalo več let. Na koncu pa se ni zgodilo nič, ker sem skeptik, Pavel je sanjač. Vsakič, ko je predlagal kakšno idejo, ji nikoli nisem verjel in sem zavrnil sodelovanje. A kljub temu sva si zelo želela odpreti svoje podjetje.
Nazadnje sva uspela najti rešitev, ki ustreza nama obema, in se ukvarjati s tistim, kar znava. Leta 2016 sva se odločila ustanoviti IT podjetje, ki bo pomagala podjetjem pri reševanju IT nalog. To vključuje uvajanje IT sistemov (1C, strežnik terminalov, poštni strežnik itd.), njihovo vzdrževanje, klasičen HelpDesk za uporabnike in upravljanje mreže.
Iskreno govoreći, kad smo osnivali kompaniju, nisam verovao u to otprilike 99,9%. Ali nekim čudom, Pavel je uspeo da me ubedi da pokušam, i unapred ću reći da je imao pravo. Pavel i ja smo se zajednički potrudili po 300.000 rubalja, registrovali novu LLC "Audit-Telekom", iznajmili mali ured, napravili sjajne vizitke, prosto kao što to rade mnogi neiskusni mladi preduzetnici i krenuli u potragu za klijentima. Potraga za klijentima je u stvari posebna priča. Možda ćemo napisati poseban članak u okviru korporativnog bloga, ako nekome to bude zanimljivo. Hladni pozivi, letci i slično. Nije davalo nikakve rezultate. Kao što sada čitam u mnogim poslovnim pričama, na kraju se ispostavlja da mnogo toga zavisi od sreće. Imali smo sreće, i bukvalno par nedelja nakon osnivanja firme, obratio nam se moj brat Vladimir, koji je doveo našeg prvog klijenta. Neću vas umarati detaljima rada sa klijentima, članak nije o tome, samo ću reći da smo otišli na audit, identifikovali kritična mesta i ta mesta su se pokvarila dok se donosila odluka da li će sarađivati s nama na stalnoj osnovi kao outsourceri. Nakon toga odmah je doneta pozitivna odluka.
Nakon toga, većinom putem preporuka preko poznanika, počeli su se pojavljivati i druge kompanije na usluzi. Helpdesk je bio u jednom sistemu. Povezivanja s mrežnom opremom i serverima u drugom, tačnije, kako ko. Neko je čuvao prečice, neko je koristio adresare RDP. Monitoring je bila još jedna posebna sistemska jedinica. Raditi timu u razdvojenim sistemima je vrlo nezgodno. Važne informacije su izgubljene iz vida. Na primer, ako je terminalni server kod klijenta postao nedostupan. Odmah stignu zahtevi od korisnika ovog klijenta. Specijalista podrške otvara zahtev (stigao je putem telefona). Da su incidenti i zahtevi registrovani u jednom sistemu, specijalista podrške bi odmah video u čemu je problem kod korisnika i obavestio ga o tome, dok se već povezuje potrebnim objektom za rešavanje situacije. Svi su u toku taktičke situacije i rade usklađeno. Nismo pronašli takav sistem gde je sve to objedinjeno. Pojavilo se razumevanje da je vreme da napravimo svoj proizvod.
Nastavak rada na svom sistemu za monitoring.
Bilo je jasno, da prejšnji sistem ni ustrezal trenutnim potrebam, ne glede na funkcionalnost in kakovost. Tako smo se odločili, da zgradimo sistem iz nič. Grafično bi to moralo izgledati popolnoma drugače. To mora biti hierarhični sistem, ki omogoča hitro in enostavno odpiranje potrebnih objektov za prave stranke. Shema iz prve različice v tem primeru ni bila smiselna, saj so stranke različne in ni bilo pomembno, v katerih prostorih se nahaja oprema. To je bilo že preneseno v dokumentacijo.
Tako, naloge:
- Hierarhična struktura;
- Nekakšna strežniška komponenta, ki jo lahko namestimo pri stranki v obliki virtualnega stroja za zbiranje potrebnih metrik in pošiljanje na centralni strežnik, ki bo vse to združil in nam prikazal;
- Obvestila. Takšna, ki jih ne smemo zamuditi, saj takrat ni bilo možnosti, da bi kdo sedel in samo gledal na monitor;
- Sistem zahtev. Začeli so se pojavljati kupci, ki smo jim servisirali ne samo strežniško in mrežno opremo, temveč tudi delovne postaje;
- Možnost hitrega povezovanja s strežniki in opremo iz sistema;
Naloge so postavljene, začnemo pisati. Hkrati obravnavamo zahteve strank. Takrat nas je bilo že 4. Takoj smo začeli razvijati obe komponenti, tako centralni strežnik kot strežnik za namestitev pri strankah. V tem trenutku Linux ni bil več nepoznan in sprejeli smo odločitev, da bodo virtualni stroji, ki bodo pri strankah, na Debianu. Ne bo nobenih namestitvenih programov, preprosto bomo projekt strežniške komponente zasnovali na enem določenem virtualnem stroju, nato pa ga preprosto klonirali k potrebni stranki. To je bila nova napaka. Kasneje se je izkazalo, da v takšni shemi mehanizem posodobitev ni bil ustrezno preučen. To pomeni, da smo dodali neko novo funkcijo, nato pa smo imeli težave pri njenem širjenju na vse strežnike strank, a se k temu vrnemo kasneje, vse po vrsti.
Ustvarili smo prvi prototip. Znal je pingati potrebne mrežne naprave strank in strežnike ter pošiljati te podatke na naš centralni strežnik. Ta pa je v zameno posodabljal te podatke v skupnih zbirkah na centralnem strežniku. Tukaj ne bom pisal le zgodbe o tem, kako in kaj smo dosegli, temveč tudi o napakah, ki smo jih storili in kako smo za to morali plačevati s časom. Tako je celotno drevo predmetov bilo shranjeno v eni sami datoteki kot seralizirani objekt. Dokler smo povezali nekaj strank s sistemom, je bilo več ali manj v redu, čeprav so se občasno pojavljali nekateri artefakti, ki so bili povsem nejasni. A ko smo sistemu dodali desetino strežnikov, so se začele dogajati čudeže. Včasih, ne glede na vzrok, so vsi objekti v sistemu preprosto izginili. Tukaj je pomembno poudariti, da so strežniki, ki so bili pri strankah, pošiljali podatke na centralni strežnik vsakih nekaj sekund preko POST zahteve. Pozoren bralec in izkušen programer je že uganil, da je prišlo do problema hkratnega dostopa do tiste datoteke, v kateri se je shranjeval seralizirani objekt iz različnih nitk hkrati. In prav takrat, ko se je to dogajalo, so se začeli kazati čudeži z izginjanjem objektov. Datoteka je preprosto postala prazna. A to se ni odkrilo takoj, ampak šele med obratovanjem s številnimi strežniki. V tem času je bila dodana funkcionalnost za skeniranje vrat (strežniki so centralnemu posredovali ne samo informacije o dostopnosti naprav, temveč tudi o odprtih vratih). To je bilo izvedeno z klicem ukaza:
$connection = @fsockopen($ip, $port, $errno, $errstr, 0.5);
rezultati so pogosto bili napačni in skeniranje je trajalo zelo dolgo. Popolnoma sem pozabil na ping, ki se je izvajal preko fping:
system("fping -r 3 -t 100 {$this->ip}");
Tudi to ni bilo razdeljeno in zato je bil proces zelo počasen. Kasneje je fping že prejemal celoten seznam IP naslovov, potrebnih za preverjanje, in nazaj prejel pripravljen seznam tistih, ki so se odzvali. Za razliko od nas, je fping znal vzporedno izvajati procese.
Jedna od čestih rutinskih aktivnosti bila je podešavanje raznih servisa putem WEB-a. Na primer, ECP od MS Exchange. U suštini, to je samo link. Odlučili smo da treba da omogućimo dodavanje takvih linkova direktno u sistem, kako bismo izbegli pretragu u dokumentaciji ili negde drugde kako da pristupimo ECP-u određenog klijenta. Tako je nastala ideja o resursnim linkovima za sistem, a njihova funkcionalnost je dostupna i danas i nije pretrpela velike promene, skoro.
Rad resursnih linkova u Veliamu
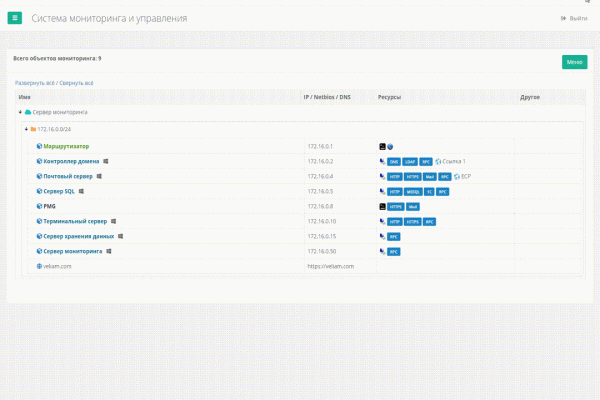
Daljinska povezivanja
Ovako to izgleda u praksi u trenutnoj verziji Veliam
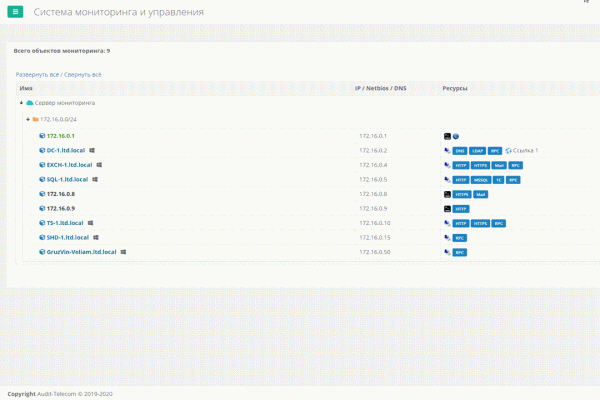
Jedan od zadataka bio je brzo i jednostavno povezivanje sa serverima, kojih je već postalo mnogo (nekoliko stotina) i pretraživanje miliona unapred sačuvanih RDP prečica bilo je izuzetno nezgodno. Trebalo nam je rešenje. Postoji softver na internetu koji funkcioniše kao adresar za takva RDP povezivanja, ali nisu integrisani sa sistemom za praćenje, a naloge nije moguće sačuvati. Svaki put unositi naloge za različite klijente je pravi pakao, kada se svakog dana povezuješ desetine puta na različite servere. Sa SSH se situacija malo bolje odvija, postoji mnogo dobrih softverskih rešenja koja omogućavaju organizovanje takvih povezanica u foldere i pamćenje naloga. No, postoje 2 problema. Prvi — nismo pronašli jedinstveni program za RDP i SSH povezivanja. Drugi — ako u nekom trenutku nisam za svojim računarom i treba brzo da se povežem, ili sam jednostavno ponovo instalirao sistem, moraću da gledam u dokumentaciju da bih pronašao nalog tog klijenta. To je nepraktično i gubitak vremena.
Već smo imali potrebnu hijerarhijsku strukturu po klijentskim serverima u našem internom proizvodu. Samo je trebalo smisliti kako brzo dodati povezivanja sa potrebnom opremom. Za početak, barem unutar svoje mreže.
Glede na to, da je imel naš sistem vlogo brskalnika, ki nima dostopa do lokalnih virov računalnika, da bi lahko preprosto z nekaj ukazom zagnal želeno aplikacijo, smo se odločili, da vse uredimo preko 'Windows custom URL scheme'. Tako je nastal nekakšen 'vtičnik' za naš sistem, ki preprosto vključuje Putty in Remote Desktop Plus ter ob namestitvi zgolj registrira URI shemo v Windows. Zdaj, ko smo želeli povezati z objektom preko RDP ali SSH, smo samo kliknili na to dejanje v našem sistemu in se je sprožila funkcionalnost Custom URI. Zagnala se je standardna mstsc.exe, vgrajena v Windows ali putty, ki je bila vključena v 'vtičnik'. Naj vzamem besedo vtičnik v narekovaje, ker to ni vtičnik brskalnika v klasičnem smislu.
To je bilo vsaj nekaj. Udobna imenik. Pri Puttyju je bilo vse še boljše, saj je kot vhodne parametre sprejemal tako IP povezave kot uporabniško ime in geslo. Torej, do Linux strežnikov v naši mreži smo se že lahko povezali z enim klikom brez vnosa gesel. A pri RDP ni vse tako preprosto. V standardni mstsc ni mogoče vnesti uporabniških podatkov kot parametrov. Na pomoč je priskočil Remote Desktop Plus. Ta je omogočil to. Zdaj smo že brez njega, a dolgo časa je bil zvest pomočnik v našem sistemu. S HTTP(S) spletnimi stranmi je bilo preprosto, ti objekti so se preprosto odprli v brskalniku in to je bilo to. Udobno in praktično. A to je bila sreča le znotraj lokalne mreže.
Ker smo večino težav reševali oddaljeno iz pisarne, je bilo najlažje vzpostaviti VPN do strank. Tako smo lahko iz našega sistema dostopali tudi do njih. A kljub temu je bilo nekoliko neprijetno. Za vsakega naročnika je bilo potrebno imeti na vsakem računalniku kup shranjenih VPN povezav in pred povezovanjem z katero koli, je bilo potrebno vključiti ustrezni VPN. Takšno rešitev smo uporabljali dovolj dolgo. A število strank se povečuje, število VPN-ov prav tako in vse to je začelo postajati obremenjujoče in bilo je potrebno narediti nekaj glede tega. Še posebej so prišle solze na oči po ponovni namestitvi sistema, ko je bilo potrebno znova vpisovati desetine VPN povezav v novem profilu Windows. Dovolj, da to prenašam, sem rekel in začel razmišljati, kaj lahko storim glede tega.
U strasti, da imaju svi klijenti kao rutere uređaje poznate firme Mikrotik. Oni su vrlo funkcionalni i praktični za obavljanje gotovo svih zadataka. Od mana – lako su „ukradeni“. Ovaj problem smo rešili jednostavno, zatvorivši sve pristupe spolja. Ali bilo je potrebno da nekako imamo pristup njima, ne dolazeći do klijenta na licu mesta, jer to traje. Jednostavno smo napravili tunele do svakog Mikrotika i izdvojili ih u poseban bazen, bez ikakve rutiranja, kako ne bi došlo do spajanja naše mreže sa mrežama klijenata i među njihovim mrežama.
Pojavila se ideja da kada pritisnem odgovarajući objekat u sistemu, centralni server za nadzor, znajući naloge za SSH svih klijentovih Mikrotika, se poveže s potrebnim, kreira pravilo za preusmeravanje do željenog hosta s potrebnim portom. Tu je odmah nekoliko trenutaka. Rešenje nije univerzalno – radiće samo za Mikrotik, jer je sintaksa komandi kod svih rutera različita. Takođe, takva preusmeravanja su kasnije trebala nekako da se uklone, a server deo našeg sistema suštinski nije mogao da prati kada sam završio svoj RDP sesiju. I takvo preusmeravanje predstavlja sigurnosnu rupu za klijenta. A mi nismo jurišali za univerzalnošću, jer je proizvod korišćen samo unutar naše kompanije, a o iznošenju u javnost nismo ni razmišljali.
Svaki od problema je rešen na svoj način. Kada je pravilo kreirano, to preusmeravanje je bilo dostupno samo za jednu određenu spoljašnju IP adresu (sa koje je inicirano povezivanje). Tako da su sigurnosne rupe uspešno izbegnute. Ali pri svakom takvom povezivanju, dodavalo se pravilo na Mikrotiku na stranicu NAT i nije se čistilo. Svima je poznato da što više pravila ima, tim jača opterećenje procesora rutera. U celini, nisam mogao da prihvatim da ću jednom ući u neki Mikrotik, a tamo će biti stotine mrtvih pravila koja nikome ne trebaju.
Če naš strežnik ne more spremljati stanja povezave, naj MikroTik spremlja sam. Napisal sem skript, ki nenehno spremlja vse pravila preusmeritve z določenim opisom (description) in preverja, ali obstaja TCP povezava, ki ustreza pravilom. Če te povezave ni bilo že nekaj časa, je verjetno, da je povezava že zaključena in te preusmeritve je mogoče odstraniti. Vse je uspelo, skript je deloval dobro.
Mimogrede, tukaj je:
global atmonrulecounter {"dontDelete"="dontDelete"}
:foreach i in=[/ip firewall nat find comment~"atmon_script_main"] do={
	local dstport [/ip firewall nat get value-name="dst-port" $i]
	local dstaddress [/ip firewall nat get value-name="dst-address" $i]
	local dstaddrport "$dstaddress:$dstport"
	#log warning message=$dstaddrport
	local thereIsCon [/ip firewall connection find dst-address~"$dstaddrport"]
	if ($thereIsCon = "") do={
		set ($atmonrulecounter->dstport) ($atmonrulecounter->dstport + 1)
		#:log warning message=($atmonrulecounter->dstport)
		if (($atmonrulecounter->dstport) > 5) do={
			#log warning message="Odstranjevanje nat pravil, dodanih samodejno z atmon_script"
			/ip firewall nat remove [/ip firewall nat find comment~"atmon_script_main_$dstport"]
			/ip firewall nat remove [/ip firewall nat find comment~"atmon_script_sub_$dstport"]
			set ($atmonrulecounter->dstport) 0
		}
	} else {
		set ($atmonrulecounter->dstport) 0
	}
}
Verjetno bi ga lahko naredil lepšega, hitrejšega itd., vendar je deloval, ni obremenjeval MikroTik-ov in je odlično opravljal nalogo. Končno smo se lahko povezovali s strežniki in omrežnimi napravami strank preprosto z enim klikom. Brez VPN in vnašanja gesel. S sistemom je postalo resnično zelo enostavno delati. Čas za vzdrževanje se je skrajšal, vsi pa smo lahko posvetili čas delu, namesto da bi se povezovali s potrebnimi objekti.
Varnostno kopiranje Mikrotik
Imeli smo nastavljeno varnostno kopiranje vseh MikroTik-ov na FTP. In na splošno je bilo vse v redu. Toda ko je bilo treba pridobiti varnostno kopijo, je bilo treba odpreti ta FTP in jo tam iskati. Imamo sistem, kjer so vsa usmerjevalnika vpisana, znamo komunicirati z napravami preko SSH. Zakaj ne bi naredili, da bi sistem sam vsak dan pobral varnostne kopije iz vseh MikroTik-ov, sem si mislil. In začel sem izvajati. Povezali smo se, naredili varnostno kopijo in jo prenesli v skladišče.
Koda skripta v PHP-ju za prenos varnostne kopije z MikroTik-a:
<?php

	$IP = '0.0.0.0';
	$LOGIN = 'admin';
	$PASSWORD = '';
	$BACKUP_NAME = 'test';

    $connection = ssh2_connect($IP, 22);

    if (!ssh2_auth_password($connection, $LOGIN, $PASSWORD)) exit;

    ssh2_exec($connection, '\/system backup save name="atmon" password="atmon"');
    stream_get_contents($connection);
    ssh2_exec($connection, '\/export file="atmon.rsc"');
    stream_get_contents($connection);
    sleep(40); \/\/ Waiting bakup makes

    $sftp = ssh2_sftp($connection);

    \/\/ Download backup file
    $size = filesize("ssh2.sftp:\/$sftp\/atmon.backup");
    $stream = fopen("ssh2.sftp:\/$sftp\/atmon.backup", 'r');
    $contents = '';
    $read = 0;
    $len = $size;
    while ($read < $len && ($buf = fread($stream, $len - $read))) {
        $read += strlen($buf);
        $contents .= $buf;
    }
    file_put_contents ($BACKUP_NAME . '.backup',$contents);
    @fclose($stream);

    sleep(3);
    \/\/ Download RSC file
    $size = filesize("ssh2.sftp:\/$sftp\/atmon.rsc");
    $stream = fopen("ssh2.sftp:\/$sftp\/atmon.rsc", 'r');
    $contents = '';
    $read = 0;
    $len = $size;
    while ($read
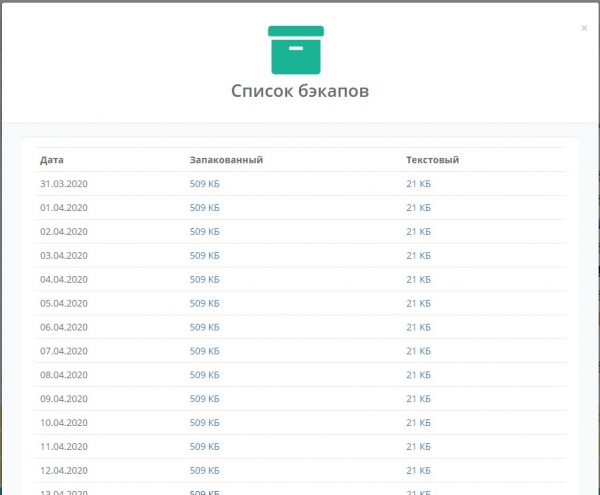
Бэкап снимается в двух видах — бинарник и текстовый конфиг. Бинарник помогает быстро восстановить нужный конфиг, а текстовый позволяет понять, какие действия предпринять в случае замены оборудования, когда бинарник невозможно восстановить. В результате мы получили ещё одно полезное функциональное решение в системе. Кроме того, при добавлении новых микротиков не нужно было ничего настраивать: просто добавить объект в систему и указать учетные данные для SSH. После этого система самостоятельно занималась созданием бэкапов. В текущей версии SaaS Veliam этого функционала пока нет, но мы вскоре его перенесем.
Скриншоты того, как это выглядело во внутренней системе
Переход на нормальное хранение в базе данных
Že sem že omenil, da so se pojavili artefakti. Včasih je preprosto izginil celoten seznam predmetov v sistemu, včasih pa je pri urejanju predmeta informacija ni bila shranjena in sem moral predmet preimenovati trikrat. To je vse zelo razburjalo. Izginjanje predmetov se je redko dogajalo in se je enostavno obnovilo s pomočjo vračanja datoteke, medtem ko je neuspeh pri urejanju predmetov točno to, kar se je dogajalo pogosto. Verjetno sprva nisem tega izvedel preko baze podatkov, ker si v mislih nisem predstavljal, kako bi lahko drevo z vsemi povezavami hranil v ploski tabeli. Ploska tabela je ploska, drevo pa hierarhično. Vendar pa je dobro rešitev večkratnega dostopa, kasneje pa (ob zapletanju sistema) tudi transakcijskega — to je SDB. Verjetno nisem prvi, ki se je srečal s to težavo. Začel sem googlati. Izkazalo se je, da je že vse pred mano izumljeno in obstaja več algoritmov, ki gradijo drevo iz ploske tabele. Po pregledu vsakega sem implementiral enega od njih. Toda to je že bila nova različica sistema, saj sem moral praktično veliko prepisovati. Rezultat je bil pričakovan, težave z nasumičnim obnašanjem sistema so izginile. Nekateri lahko rečejo, da so napake precej amaterske (enotne skripte, shranjevanje informacij, do katerih je prišlo do večkratnega sočasnega dostopa iz različnih niti v datoteki itd.) na področju razvoja programske opreme. Morda je tako, vendar je bilo moje glavno delo upravljanje, programiranje pa stranski hobi, zato nisem imel izkušenj z delom v ekipi programerjev, kjer bi mi starejši kolegi takoj pokazali te osnovne stvari. Tako sem vse te preglavice dobival sam, a zelo sem dobro usvojil snov. Poleg tega moje delo vključuje tudi sestanke s strankami, dejavnosti, usmerjene v poskus povečanja prepoznavnosti podjetja, kup administrativnih vprašanj znotraj podjetja in še mnoge druge stvari. Kakor koli že, to, kar je bilo, je bilo iskano. Fantje in sam sem izdelek uporabljal v vsakodnevnem delu. Bili so tudi odkrito neuspešni načrti in rešitve, za katere je bilo porabljenega časa, na koncu pa je postalo jasno, da to ni delovno orodje in ga nihče ni uporabljal, kar ni prišlo v Veliam.
Podpora — HelpDesk
Ni je ne bo bilo odveč omeniti, kako je nastal HelpDesk. To je vsekakor posebna zgodba, saj gre v Veliamu že za tretjo povsem novo verzijo, ki se razlikuje od vseh prejšnjih. Zdaj je to preprosta, intuitivna sistem brez nepotrebnih okraskov in dodatkov, z možnostjo integracije z domeno ter dostopa do istega uporabniškega profila z različnih mest prek povezave iz e-pošte. In kar je najpomembneje, omogoča povezovanje s prijaviteljem prek VNC kar neposredno iz napotitve, brez VPN ali posredovanja vrat. Povedal bom, kako smo prišli do tega, kaj je bilo prej in kakšne grozne rešitve so bile.
Povezovali smo se s korisnicima putem poznatog TeamViewer-a. Na svim računalima korisnika koje održavamo instaliran je TV. Prvo što nismo ispravno učinili, a kasnije smo to eliminirali — vezivanje svakog klijenta za hardver. Kako je korisnik ulazio u sustav HD kako bi podnio zahtjev? Na sva računala, osim TV-a, bila je instalirana posebna utiliteta napisana u Lazarus-u (mnogi će ovdje možda podignuti obrve i početi googlati što je to, ali najbolje što sam znao od kompajliranih jezika bio je Delphi, a Lazarus je gotovo isto, samo besplatno). U svakom slučaju, korisnik je pokretao posebni batch script koji je pokretao tu utilitu, koja je očitavala HWID sustava, a zatim se pokretao preglednik i događala se autorizacija. Zašto je ovo učinjeno? U nekim tvrtkama, broj održavanih korisnika broji se pojedinačno, a cijena održavanja za svaki mjesec formira se na temelju broja ljudi. To je razumljivo, reći ćete, ali zašto vezivanje za hardver? Vrlo jednostavno, neki pojedinci su dolazili kući i s kućnog laptopa slali zahtjev u stilu "napravite mi ovdje sve lijepo". Osim očitavanja HWID sustava, utilita je izvlačila trenutni ID TeamViewer-a iz registra i također ga prenosila nama. TeamViewer ima API za integraciju, i napravili smo tu integraciju. No, postojala je jedna prepreka. Kroz ovaj API nije moguće povezati se na korisničko računalo kada on izričito ne inicira tu sesiju, a nakon pokušaja spajanja, također mora pritisnuti "potvrdi". Tada nam se činilo logičnim da se bez znanja korisnika nitko ne bi trebao povezivati, a s obzirom da je osoba za računalom, ona inicira sesiju i pozitivno odgovara na zahtjev za daljinsko povezivanje. Ispostavilo se da to nije bilo tako. Podnositelji su zaboravljali pritisnuti inicijaciju sesije, a morali smo im to reći u telefonskom razgovoru. To je trošilo vrijeme i nerviralo obje strane procesa. Štoviše, nije rijetkost da se dogode trenuci kada osoba ostavlja zahtjev, ali dozvolu za povezivanje daje samo kada ide na pauzu za ručak. Jer problem nije kritičan i ne želi da mu se proces rada prekida. Stoga, on neće pritisnuti nikakve tipke za odobrenje povezivanja. Tako je nastala dodatna funkcionalnost prilikom autorizacije u HelpDesku — očitavanje ID TeamViewer-a. Znali smo stalnu lozinku koja se koristila prilikom instalacije TeamViewer-a. Točnije, samo je sustav znao tu lozinku, jer je bila ugrađena u instalaciju i u naš sustav. Stoga je postojala tipka za povezivanje iz zahtjeva na koju, kada se pritisne, nije bilo potrebno ništa čekati, već se odmah otvarao TeamViewer i događala se povezanost. Na kraju su postojala dva moguća načina povezivanja. Kroz službeni API TeamViewer-a i naš vlastiti. Na moje iznenađenje, prvi je gotovo odmah prestao slabiti, iako je bilo upute koristiti ga samo u posebnim slučajevima kada korisnik da odobrenje za to. Ipak, sigurnost je sada prioritet. No, ispostavilo se da podnositeljima to nije potrebno. Svi su apsolutno pristali da im se priključi bez tipke za potvrdu. A s obzirom na to, u budućnosti je funkcionalnost spajanja preko API-a ukinuta zbog nepotrebnosti.
Prehod na večnitno obdelavo v Linuxu
Že dolgo se zastavlja vprašanje, kako pospešiti skeniranje omrežja za odprtost vnaprej določenega seznama vrat in preprosto preverjanje dostopnosti omrežnih objektov. Prvo rešitev, ki se ponuja, je večnitnost. Osnovni čas, porabljen za ping, je namreč čakanje na odgovor paketa, naslednji ping pa se ne more začeti, dokler ne pride prejšnji paket nazaj. V podjetjih, kjer je več kot 20 strežnikov in dodatne omrežne opreme, je to delovalo precej počasi. Ko en paket izgine, sistemski administrator o tem takoj ne obvešča. Preprosto ne more več jemati takega spama resno. Zato je treba vsak objekt pingati večkrat, preden lahko potrdimo, da je nedostopen. Če ne bomo šli v podrobnosti, je potrebno paralelizirati, ker v nasprotnem primeru bo sistemski administrator o težavi izvedel od stranke, ne od sistema za nadzor.
PHP sam po sebi nima vgrajene večnitnosti. Ima pa večprocesnost, možno je izvajati forkanje. Imel sem že napisan mehanizem za ankete in želel sem, da enkrat preberem vse potrebne vozlišča iz Baze podatkov, pingam vse naenkrat, počakam na odgovor od vsakega in šele potem napišem podatke. To prihrani število bralnih poizvedb. Ideja je bila odlična za večnitnost. Za PHP obstaja modul PThreads, ki omogoča pravo večnitnost, a se je bilo potrebno malo potruditi, da sem to nastavitev uspešno izpeljal na PHP 7.2, vendar je bilo to izvedeno. Skeniranje vrat in pinganje sta postala hitra. Namesto recimo 15 sekund na cikel prej, je ta proces zdaj trajal 2 sekundi. To je bil dober rezultat.
Hiter pregled novih podjetij
Kako je nastala funkcionalnost za prikupljanje različitih metrika i karakteristika hardvera? Veoma jednostavno. Ponekad nam naruče samo reviziju trenutne IT infrastrukture. Takođe, to je neophodno za ubrzanje revizije novog klijenta. Potrebno je bilo nešto što bi omogućilo da se dođe u srednju ili veliku kompaniju i brzo se orijentiše šta uopšte imaju. Pinga unutar mreže blokiraju, po mom mišljenju, samo oni koji sami žele da sebi otežaju život, a takvih u našem iskustvu ima malo. Ali takvi se sreću. U tom smislu, može se brzo skenirati mreže za prisustvo uređaja jednostavnim pingom. Zatim ih možemo dodati i skenirati na otvorene portove koji su nama zanimljivi. U suštini, ova funkcionalnost je već postojala, samo je bilo potrebno dodati komandu sa centralnog servera na podređeni, kako bi skenirao zadate mreže i dodao u listu sve što pronađe. Zaboravio sam da napomenem, pretpostavljalo se da već imamo spremnu sliku sa podešenim sistemom (podređeni server za nadgledanje) koju smo mogli jednostavno implementirati kod klijenta tokom revizije i povezati je sa našim oblakom.
Ampak rezultat revizije običajno vključuje kup različnih informacij, ena izmed njih pa je - katera naprava sploh obstaja v omrežju. Najprej so nas zanimali Windows strežniki in delovne postaje Windows v domeni. Ker je v srednjih in velikih podjetjih odsotnost domene verjetno izjema. Da bi govorili en jezik, to je v mojem prepričanju povprečje 100+ ljudi. Trebalo je najti način, kako zbrati podatke z vseh Windows računalnikov in strežnikov, poznajoč njihov IP in račun domenskega skrbnika, vendar brez nameščanja kakršne koli programske opreme na njih. Tukaj pride v igro vmesnik WMI. Windows Management Instrumentation (WMI) se doslovno prevede kot orodja za upravljanje Windows. WMI je ena izmed osnovnih tehnologij za centralizirano upravljanje in spremljanje delovanja različnih delov računalniške infrastrukture pod nadzorom platforme Windows. Vzeto iz Wikipedije. Nato smo se morali ponovno potruditi, da smo zbrali wmic (to je WMI klient) za Debian. Potem ko je bilo vse pripravljeno, je ostalo le še, da smo preko wmic povprašali potrebne vozlišča o iskanih informacijah. Preko WMI je mogoče pridobiti skoraj vse informacije z Windows računalnika, več kot tega, preko njega lahko tudi upravljate računalnik, na primer, pošlete ga v ponovni zagon. Tako se je pojavilo zbiranje informacij o Windows postajah in strežnikih v našem sistemu. Poleg tega smo dobivali tudi trenutne informacije o trenutnih kazalnikih obremenitve sistema. Te povprašujemo pogosteje, informacije o strojni opremi pa redkeje. Po tem je bilo izvajanje revizij postalo nekoliko prijetnejše.
Odločitev o širjenju programske opreme
Sami dnevno uporabljamo sistem, in vedno je odprt pri vsakem tehničnem sodelavcu. In pomislili smo, da bi lahko delili tudi z drugimi to, kar že imamo. Sistem še ni bil povsem pripravljen za širjenje. Potrebno je bilo predelati zelo veliko, da je lokalna različica postala SaaS. To so spremembe različnih tehničnih vidikov delovanja sistema (odprte povezave, podporna služba), analiza modulov glede licenciranja, deljenje baz podatkov strank in skaliranje vsakega od storitev ter razvoj sistemov samodejnih posodobitev za vse dele. O tem bo govorila druga del članka.
Posodobi
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bosnian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish