

Hallo zusammen. In diesem Artikel werde ich erläutern, warum wir bei Avito vor neun Monaten Kafka ausgewählt haben und was diese Technologie ausmacht. Ich teile einen Anwendungsfall — den Nachrichtenaustausch. Und zum Schluss sprechen wir darüber, welche Vorteile wir durch den Einsatz von Kafka as a Service erhalten haben.
Težava
Zunächst etwas Kontext. Vor einiger Zeit haben wir begonnen, von einer monolithischen Architektur abzurücken, und jetzt gibt es bei Avito bereits mehrere Hundert verschiedene Services. Diese haben ihre eigenen Speicher, ihren eigenen Technologie-Stack und sind für ihren Teil der Geschäftlogik verantwortlich.
Eines der Probleme mit einer großen Anzahl von Services sind die Kommunikationen. Service A möchte oft Informationen von Service B erhalten. In diesem Fall wendet sich Service A über eine synchrone API an Service B. Service C möchte wissen, was bei den Services G und D passiert, während diese wiederum an den Services A und B interessiert sind. Wenn es viele solcher "neugierigen" Services gibt, verwandeln sich die Verbindungen zwischen ihnen in ein verworrenes Knäuel.
Gleichzeitig kann Service A jederzeit nicht verfügbar sein. Was sollen in diesem Fall Service B und alle anderen, die von ihm abhängen, tun? Und wenn für die Durchführung einer Geschäftsoperation eine Kette von aufeinanderfolgenden synchronen Aufrufen erforderlich ist, steigt die Wahrscheinlichkeit, dass die gesamte Operation fehlschlägt, noch weiter (und je länger diese Kette ist, desto höher ist die Wahrscheinlichkeit).
Technologiewahl
Okay, die Probleme sind klar. Man kann sie beheben, indem man ein zentrales Nachrichtenaustauschsystem zwischen den Services einrichtet. Jetzt reicht es aus, wenn jeder Service nur über dieses System Bescheid weiß. Zudem sollte das System ausfallsicher und horizontal skalierbar sein und im Falle eines Ausfalls einen Puffer für spätere Verarbeitung der Anfragen speichern.
Lassen Sie uns nun die Technologie auswählen, auf der die Nachrichtenübermittlung realisiert wird. Zunächst müssen wir verstehen, was wir von ihr erwarten:
- Nachrichten zwischen den Services dürfen nicht verloren gehen;
- Nachrichten dürfen dupliziert werden;
- Nachrichten können für mehrere Tage gespeichert und abgerufen werden (persistenter Puffer);
- Services können sich für die Daten, die sie interessieren, anmelden;
- Mehrere Services können dieselben Daten lesen;
- Nachrichten können einen detaillierten, umfangreichen Payload enthalten (event-carried state transfer);
- Manchmal ist eine Garantie für die Reihenfolge der Nachrichten erforderlich.
Prav tako nam je bilo izredno pomembno izbrati čim bolj skalabilen in zanesljiv sistem z visoko prepustnostjo (vsaj 100k sporočil pri nekaj kilobajtih na sekundo).
V tej fazi smo se poslovili od RabbitMQ (težko ga je ohranjati stabilnega pri visokih rps), PGQ od SkyTools (ni dovolj hiter in slabo skalabilen) in NSQ (ni pretočen). Vse te tehnologije imamo v podjetju, a niso ustrezale rešitvi, ki smo jo iskali.
Nato smo začeli raziskovati nove za nas tehnologije — Apache Kafka, Apache Pulsar in NATS Streaming.
Najprej smo odvrgli Pulsar. Odločili smo se, da sta Kafka in Pulsar precej podobni rešitvi. In čeprav je Pulsar preizkušen s strani velikih podjetij, je novejši in teoretično ponuja boljšo latenco, smo se odločili obdržati Kafko kot de facto standard za tovrstne naloge. Verjetno se bomo v prihodnosti vrnili na Apache Pulsar.
In tako sta ostala dva kandidata: NATS Streaming in Apache Kafka. Oba rešitve smo temeljito preučili in oboji so se izkazali za primerne za nalogo. A na koncu smo se balili relativne mladosti NATS Streaming (in dejstva, da je eden od glavnih razvijalcev, Tyler Treat, opustil projekt in začel svojega — Liftbridge). Hkrati način združevanja NATS Streaming ni omogočal močnega horizontalnega skaliranja (morda to ni več težava po dodajanju načina particioniranja leta 2017).
Kljub temu je NATS Streaming odlična tehnologija, napisana v Go in ima podporo Cloud Native Computing Foundation. Za razliko od Apache Kafke ne potrebuje Zookeeperja za delovanje (morda, ), saj znotraj implementira RAFT. Hkrati je NATS Streaming preprostejši za administracijo. Ne izključujemo možnosti, da se bomo v prihodnosti še vrnili k tej tehnologiji.
Kljub temu je na današnji dan naša zmagovalka Apache Kafka. V naših testih se je izkazala za dovolj hitro (več kot milijon sporočil na sekundo pri branju in pisanju pri velikosti sporočil 1 kilobajt), dovolj zanesljivo, dobro skalabilno in preizkušeno v praksi s strani velikih podjetij. Poleg tega Kafka podpira vsaj nekaj velikih komercialnih podjetij (na primer, mi uporabljamo različico Confluent), pa tudi Kafka ima razvit ekosistem.
Pregled Kafke
Preden začnete, takoj priporočam odlično knjigo — «Kafka: The Definitive Guide» (je tudi v ruščini, vendar termini nekoliko zmedejo). V njej lahko najdete informacije, potrebne za osnovno razumevanje Kafke in še malo več. Sama dokumentacija Apache in blog Confluent sta prav tako odlično napisani in enostavno berljivi.
Torej, poglejmo, kako izgleda Kafka z ptičje perspektive. Osnovna topologija Kafke sestavljajo producer, consumer, broker in zookeeper.
Broker
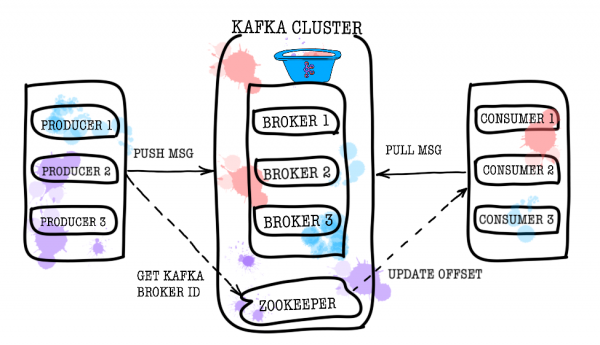
Za shranjevanje vaših podatkov je odgovoren broker. Vsi podatki so shranjeni v binarni obliki, broker pa malo ve o tem, kaj ti podatki predstavljajo in kakšna je njihova struktura.
Vsaka logična vrsta dogodkov se običajno nahaja v svojem ločenem topiku. Na primer, dogodek o ustvarjanju oglasa lahko pade v topik item.created, medtem ko dogodek o njegovi spremembi pride v item.changed. Topike lahko obravnavamo kot klasifikatorje dogodkov. Na ravni topika lahko nastavite takšne konfiguracijske parametre, kot so:
- količina shranjenih podatkov in/ali njihova starost (retention.bytes, retention.ms);
- faktor redundance podatkov (replication factor);
- največja velikost enega sporočila (max.message.bytes);
- najmanjše število usklajenih replik, pri katerih lahko v topik zapišete podatke (min.insync.replicas);
- možnost preklopa na nesinkrono šibko repliko s potencialno izgubo podatkov (unclean.leader.election.enable);
- in še mnoge druge ().
Po drugi strani pa se vsak topik razdeli na eno ali več particij. Prav v particijah končajo dogodki. Če v gruči obstaja več brokerjev, se bodo particije enakomerno porazdelile po vseh brokerjih (kolikor je to mogoče), kar bo omogočilo razširitev obremenitve pri pisanju in branju v en topik na več brokerjev hkrati.
Na disku so podatki za vsak del v obliki datotek segmentov, ki so po privzetku en gigabajt (to se nadzira s preko log.segment.bytes). Pomembna značilnost je, da se odstranitev podatkov iz particij (ko se sproži retention) zgodi prav v segmentih (ni mogoče odstraniti enega dogodka iz particije, lahko pa odstranite samo celoten segment, pri čemer le neaktiven).
Zookeeper
Zookeeper deluje kot shramba metapodatkov in koordinator. Prav on lahko pove, ali so brokerji živi (to si lahko ogledate z očmi zookeperja preko ukaza zookeeper-shell: ls /brokers/ids), kateri broker je kontroler (get /controller), ali ali particije v sinhronem stanju s svojimi replikami (get /brokers/topics/topic_name/partitions/partition_number/state). Prav tako se producer in consumer najprej povežeta z zookeeperjem, da ugotovita, kateri broker hrani katere teme in particije. V primerih, ko je za temo nastavljen faktor replikacije večji od 1, bo zookeeper navedel, katere particije so vodilne (v njih se bo izvajalo zapisovanje in iz njih bo potekalo branje). V primeru napake brokerja bo v zookeeperju zapisana informacija o novih vodilnih particijah (od različice 1.1.0 naprej asinhrono, ).
V starejših različicah Kafke je zookeeper odgovarjal tudi za shranjevanje offsetov, vendar se ti zdaj hranijo v posebni temi __consumer_offsets na brokerju (čeprav lahko še vedno uporabljate zookeeper za te namene).
Najlažji način, da spremenite svoje podatke v bučo, je pravzaprav izguba informacij z zookeeperjem. V takem scenariju bo zelo težko razumeti, kaj in od kje brati.
Producer
Producer je najpogosteje storitev, ki neposredno zapisuje podatke v Apache Kafka. Producer izbere temo, v kateri se bodo shranjevala njegova tematska sporočila, in začne v njej zapisovati informacije. Na primer, producer je lahko storitev za oglase. V takem primeru bo pošiljal v tematske teme dogodke, kot so 'oglas ustvarjen', 'oglas posodobljen', 'oglas izbrisan' itd. Vsak dogodek pri tem predstavlja par ključ-vrednost.
Privzeto so vse dogodke porazdeljene po particijah teme round-robin, če ključ ni določen (ob izgubi urejenosti), in preko MurmurHash (ključ), če je ključ prisoten (urejenost v okviru ene particije).
Tukaj je takoj treba omeniti, da Kafka zagotavlja red dogodkov samo v okviru ene particije. Vendar to pogosto ni problem. Na primer, lahko zagotovo dodajate vse spremembe istega oglasa v eno particijo (s tem ohranjate red teh sprememb v okviru oglasa). Prav tako lahko posredujete zaporedno številko v enem od polj dogodka.
Consumer
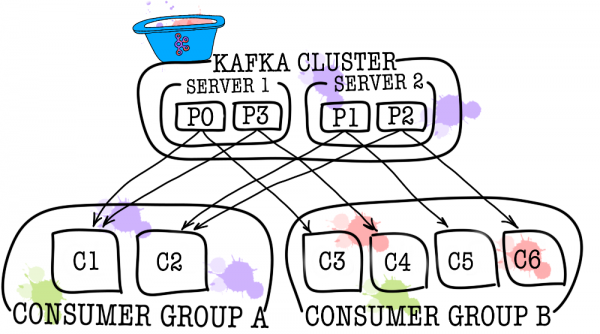
Consumer je odgovoren za preuzimanje podataka iz Apache Kafke. Ako se vratimo na prethodni primer, consumer može biti servis za moderiranje. Ovaj servis će biti prijavljen na temu servisa sa oglasima, i kada se pojavi nova objava, dobiće je i analizirati u skladu sa nekim postavljenim politikama.
Apache Kafka pamti koje su poslednje događaje primili consumeri (za to se koristi servisna tema __consumer__offsets), __consumer__offsetsčime se garantuje da pri uspešnom čitanju consumer ne dobije istu poruku dva puta. Ipak, ako se koristi opcija enable.auto.commit = true i potpuno poverite praćenje položaja consumera Kafki, može doći do gubitka podataka. . U proizvodnom kodu, položaj consumera se obično kontroliše ručno (programer upravlja trenutkom kada mora doći do commit-a pročitane poruke).
U onim slučajevima kada jedan consumer nije dovoljan (na primer, kada je protok novih događaja veoma veliki), može se dodati još nekoliko consumer-a, povezujući ih u consumer group. Consumer group logički predstavlja isti takav consumer, ali s raspodelom podataka među članovima grupe. Ovo omogućava svakom učesniku da uzme svoj deo poruka, čime se povećava brzina čitanja.
Výsledky testování
Neću pisati mnogo objašnjavajućeg teksta, samo ću podeliti dobijene rezultate. Testiranje je provedeno na 3 fizičke mašine (12 CPU, 384GB RAM, 15k SAS DISK, 10GBit/s Net), brokeri i zookeeper su raspoređeni u lxc.
Testiranje performansi
Tokom testiranja, dobijeni su sledeći rezultati.
- Brzina upisa poruka veličine 1KB istovremeno od 9 producer-a — 1300000 događaja u sekundi.
- Brzina čitanja poruka veličine 1KB istovremeno od 9 consumer-a — 1500000 događaja u sekundi.
Testiranje otpornosti na greške
Tokom testiranja, dobijeni su sledeći rezultati (3 brokera, 3 zookeeper-a).
- Neplanirano gašenje jednog od brokera ne dovodi do zaustavljanja ili nedostupnosti klastera. Rad se nastavlja u normalnom režimu, ali preostalim brokerima dolazi veće opterećenje.
- Nepričakovano zaključitev dveh posrednikov v primeru grozda treh posrednikov in min.isr = 2 pripelje do nedostopnosti grozda za pisanje, a dostopnosti za branje. V primeru, ko je min.isr = 1, grozd ostaja dostopen tako za branje kot tudi za pisanje. Kljub temu ta način nasprotuje zahtevam po visoki ohranjanju podatkov.
- Nepričakovano zaključitev enega od strežnikov Zookeeper ne privede do ustavitve ali nedostopnosti grozda. Delo se nadaljuje v običajnem režimu.
- Nepričakovano zaključitev dveh strežnikov Zookeeper vodi do nedostopnosti grozda do trenutka, ko se obnovi delovanje vsaj enega od strežnikov Zookeeper. To trditev velja za grozd Zookeeper s 3 strežniki. Kot rezultat po raziskavah je bilo odločeno, da se grozd Zookeeper poveča na 5 strežnikov za povečanje odpornosti na napake.
Kafka kot storitev
Prepričani smo, da je Kafka odlična tehnologija, ki nam omogoča reševanje naloge, ki smo si jo zastavili (implementacija posrednika sporočil). Kljub temu smo se odločili, da storitvam prepovemo neposreden dostop do Kafke in jo zaprli z zgornjo plastjo data-bus. Zakaj smo to storili? Dejansko je več razlogov.
Data-bus je prevzel vse naloge, povezane z integracijo s Kafko (implementacija in nastavitev potrošnikov in proizvajalcev, spremljanje, opozarjanje, beleženje, razširjanje itd.). Tako integracija s posrednikom sporočil poteka kar najpreprosteje.
Data-bus je omogočil odmik od konkretnega jezika ali knjižnice za delo s Kafko.
Data-bus je drugim storitvam omogočil odmik od sloja shranjevanja. Morda bomo v nekem trenutku zamenjali Kafko s Pulsarjem in pri tem nihče ne bo opazil (vse storitve vedo le za API data-bus).
Data-bus je prevzel validacijo shem dogodkov.
Z uporabo data-bus je bila omogočena avtentikacija.
Pod okriljem data-bus lahko brez izpadov, neopazno posodabljamo različice Kafke, centralizirano upravljamo konfiguracije proizvajalcev, potrošnikov, posrednikov itd.
Data-bus je omogočil dodajanje funkcij, ki jih Kafka nima (kot so revizija tem, nadzor anomalij v grozdu, ustvarjanje DLQ itd.).
Data-bus omogoča centralizirano izvajanje failover za vse storitve.
Trenutno je dovoljno povezati malu biblioteku u kod svog servisa za početak slanja događaja u brokersku poruku. To je to. Dobijate mogućnost pisanja, čitanja i skaliranja jednim redom koda. Cela implementacija je skrivena od vas, spolja izlaze samo nekoliko ručki poput veličine paketa. Ispod haube servis data-bus podiže potrebnu količinu instanci proizvođača i potrošača u Kubernetesu i pruža im potrebnu konfiguraciju, ali sve to je transparentno za vaš servis.
Naravno, ne postoji srebrna kugla, i ovaj pristup ima svoja ograničenja.
- Data-bus treba održavati vlastitim snagama, za razliku od spoljašnjih biblioteka.
- Data-bus povećava broj interakcija između servisa i brokerske poruke, što dovodi do smanjenja performansi u poređenju sa golim Kafka-om.
- Nije sve tako lako skloniti od servisa, ne želimo da dupliciramo funkcionalnost KSQL ili Kafka Streams u data-bus-u, pa ponekad moramo dopustiti servisima da idu direktno.
U našem slučaju prednosti su nadmašile nedostatke, i rešenje da se brokerska poruka sakrije kao poseban servis se isplatilo. Tokom godine eksploatacije nismo imali ozbiljnijih kvarova i problema.
P.S. Hvala mojoj devojci, Ekaterini Obalyaevoj, za sjajne slike u ovom članku. Ako su vam se svideli, naći će se još više ilustracija.
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish