

V tem članku bomo predstavili, kako in zakaj smo razvili – mehanizem, ki prenaša informacije med odjemalskimi aplikacijami in strežniki 1C:Podjetja – od postavitve naloge do načrtovanja arhitekture in podrobnosti izvedbe.
Sistem Interakcije (v nadaljevanju – SI) je porazdeljen, odporen na napake sistem za izmenjavo sporočil z zagotovljeno dostavo. SI je zasnovan kot visoko obremenjen servis z visoko razširljivostjo, na voljo pa je tako kot spletni servis (ponuja ga podjetje 1C) kot tudi kot izdelek, ki ga je mogoče namestiti na lastne strežniške zmogljivosti.
SI uporablja porazdeljeno shrambo in iskalni sistem . Poleg tega bomo govorili o Javi in o tem, kako horizontalno povečuje razširljivost PostgreSQL.
Definisanje zadatka
Da bi bilo jasno, zakaj smo ustvarili Sistem Interakcije, bom najprej povedal nekaj o tem, kako poteka razvoj poslovnih aplikacij v 1C.
Za začetek – nekaj o nas za tiste, ki še ne vedo, s čim se ukvarjamo :) Razvijamo tehnološko platformo „1C:Podjetje“. Platforma vključuje orodje za razvoj poslovnih aplikacij ter runtime, ki omogoča delovanje poslovnih aplikacij v večplatformskem okolju.
Paradigma odjemalec-strežnik
Poslovne aplikacije, ustvarjene na „1C:Podjetju“, delujejo v trih-slojni arhitekturi „DBMS – strežnik aplikacij – odjemalec“. Aplikacijska koda, napisana v , se lahko izvaja na strežniku aplikacij ali na odjemalcu. Vse delo z aplikacijskimi objekti (katalozi, dokumenti itd.), pa tudi branje in pisanje podatkovne baze, se izvaja izključno na strežniku. Funkcionalnost obrazcev in ukaznega vmesnika je prav tako реализirana на strežniku. Na odjemalcu se izvaja pridobivanje, odpiranje in prikazovanje obrazcev, „komunikacija“ z uporabnikom (opozorila, vprašanja…), majhni izračuni v obrazcih, ki zahtevajo hitro reakcijo (na primer, množenje cene s količino), delo z lokalnimi datotekami, delo z opremo.
V aplikacijski kodi je v naslovih postopkov in funkcij treba jasno navesti, kje se bo izvajala koda – s pomočjo direktiv &NaOdjemalcu / &NaStrežniku (&AtClient / &AtServer v angleški različici jezika). Razvijalci v 1C me sedaj popravijo, rekoč, da direktiv dejansko , ampak to trenutno ni pomembno zanj.
Iz klientskega kode lahko pokličemo strežniško kodo, medtem ko iz strežniške kode klientske ni mogoče poklicati. To je temeljna omejitev, ki smo jo postavili iz več razlogov. Med drugim zato, ker mora biti strežniška koda napisana tako, da se enako izvaja ne glede na to, od kje je poklicana – iz klienta ali strežnika. V primeru klica strežniške kode iz druge strežniške kode pa klient kot tak ne obstaja. In tudi zaradi tega, ker se lahko med izvajanjem strežniške kode klient, ki jo je poklical, zapre ali zapusti aplikacijo, in strežniku ne bo več nikogar poklicati.

Koda, ki obravnava pritisk gumba: klic strežniške procedure iz klienta bo deloval, klic klientske procedure iz strežnika pa ne.
To pomeni, da če želimo iz strežnika posredovati sporočilo v klientsko aplikacijo, na primer, da se je končalo oblikovanje "dolgotrajnega" poročila in da ga lahko pogledamo – nimamo načina za to. Moramo se zateči k pretkanim ukrepom, na primer, da klientska koda periodično preverja strežnik. Vendar tak pristop obremenjuje sistem z odvečnimi klici in na splošno ni najbolj eleganten.
Poleg tega obstaja potreba, na primer, da ob prejetem telefonskem -klicu obvestimo klientsko aplikacijo, da po številki klicatelja najde informacije o njem v bazi podatkov in prikaže uporabniku podatke o klicatelju. Ali pa, na primer, ob prejemu naročila na skladišče obvestiti o tem klientsko aplikacijo naročnika. Na splošno je kar nekaj primerov, kjer bi tak mehanizem prišel prav.
Dejansko postavitev
Ustvariti mehanizem za izmenjavo sporočil. Hiter, zanesljiv, z zagotovljeno dostavo, z možnostjo prilagodljivega iskanja sporočil. Na osnovi mehanizma razviti messenger (sporočila, video klici), ki deluje znotraj aplikacij 1C.
N oblikovati sistem, ki je horizontalno razširljiv. Naraščajoča obremenitev mora biti pokrita z povečanjem števila vozlišč.
Implementacija
Odložené delovne povezave smo se odločili ne vključiti neposredno v platformo 1C: Predstavitev, ampak jih uresničiti kot ločen izdelek, katerega API lahko pokličemo iz kode aplikacijskih rešitev 1C. To smo storili iz več razlogov, pri čemer je glavni razlog možnost izmenjave sporočil med različnimi aplikacijami 1C (na primer med Upravljanjem trgovine in Računovodstvom). Različne aplikacije 1C lahko delujejo na različnih različicah platforme 1C: Predstavitev, se nahajajo na različnih strežnikih itd. V takšnih razmerah je implementacija delovne povezave kot ločenega izdelka, ki je 'na strani' namestitev 1C – optimalna rešitev.
Torej smo se odločili, da delovno povezavo naredimo kot ločen izdelek. Manjšim podjetjem priporočamo, da uporabljajo delovno povezavo, ki smo jo namestili v našem oblaku (wss://1cdialog.com), da se izognejo stroškom, povezanih z lokalno namestitvijo in nastavitvijo strežnika. Veliki naročniki pa bodo morda menili, da je smiselno namestiti svoj strežnik delovne povezave na svojih zmogljivostih. Podoben pristop smo uporabili v našem oblaku SaaS izdelku. – izda se kot množični izdelek za namestitev pri strankah in je prav tako nameščen v našem oblaku. .
Aplikacija
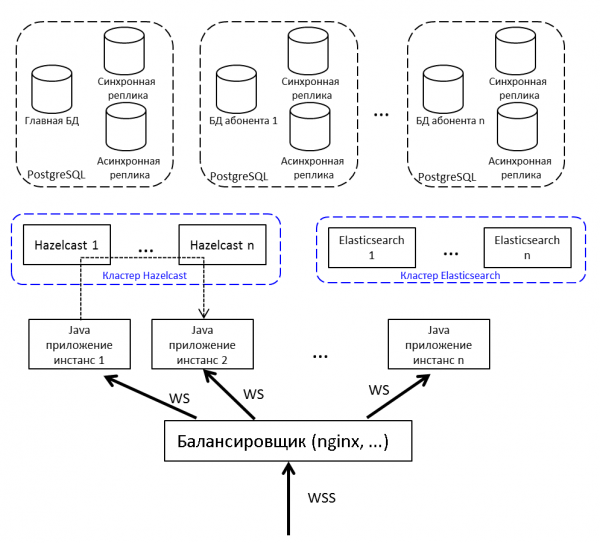
Za porazdelitev obremenitve in odpornosti na napake ne bomo razporedili enega, ampak več Java aplikacij in pred njimi postavili ravnotežnik obremenitve. Če je treba sporočilo prenesti z vozlišča na vozlišče – uporabljamo publish/subscribe v Hazelcastu.
Komunikacija med stranko in strežnikom poteka po websocketu. Ta je zelo primeren za sisteme v realnem času.
Porazdeljena predpomnilnik
Izbirali smo med Redisom, Hazelcastom in Ehcache. Leta 2015. Redis je pravkar izdal nov klaster (preveč nov, strašljivo), obstaja Sentinel z vrsto omejitev. Ehcache ne zna delovati v klastru (ta funkcionalnost se je pojavila kasneje). Odločili smo se, da poskusimo z Hazelcastom 3.4.
Hazelcast se sestavi v klaster 'iz škatle'. V načinu enega vozlišča ni preveč koristen in lahko služi le kot predpomnilnik – ne zna zapisovati podatkov na disk, če izgubimo edino vozlišče – izgubimo podatke. Namestili bomo več Hazelcast-ov, med katerimi varnostno kopiramo kritične podatke. Predpomnilnik ne varnostno kopiramo – ni nam žal.
Za nas je Hazelcast:
- Shranjevanje uporabniških sej. Vsakič hoditi po sejo v bazo – dolgotrajno, zato vse seje shranjujemo v Hazelcast.
- Keš. Iščete profil uporabnika – preverite v kešu. Ste napisali novo sporočilo – shranite v keš.
- Teme za komunikacijo instanc aplikacije. Vozlišče generira dogodek in ga postavi v temo Hazelcast. Druga vozlišča aplikacije, ki so naročena na to temo, prejemajo in obdelujejo dogodek.
- Klaster blokade. Na primer, ustvarimo diskusijo z edinstvenim ključem (diskusija-singlton v okviru baze 1C):
conversationKeyChecker.check("BENCINSKA ČRPALKA");

      doInClusterLock("BENCINSKA ČRPALKA", () -> {

          conversationKeyChecker.check("BENCINSKA ČRPALKA");

          createChannel("BENCINSKA ČRPALKA");
      });
Preverili smo, da kanala ni. Vzeli smo blokado, ponovno preverili, ustvarili. Če po prevzemu blokade ne preverite, obstaja možnost, da je drug tok v tem trenutku prav tako preveril in sedaj poskuša ustvariti enako diskusijo – in ta že obstaja. Blokade preko synchronized ali običajne java Lock ne moremo uporabiti. Preko baze – počasi, pa tudi baza je škoda, preko Hazelcast – to je to.
Izberemo SGBD
Imamo obsežno in uspešno izkušnjo z PostgreSQL in sodelovanjem z razvijalci te SGBD.
S klasterjem ima PostgreSQL svoje težave – obstajajo , , , vendar pa to ni noSQL, ki se razširjajo kar tako. NoSQL kot glavno skladišče nismo obravnavali, dovolj je bilo, da delamo z Hazelcast, s katerim prej nismo delali.
Ker je potrebno razširiti relacijsko bazo – to pomeni, . Kot veste, pri sharding-u delimo bazo podatkov na posamezne dele, tako da lahko vsak od njih prenesemo na ločen strežnik.
Prva možnost našega sharding-a je predvidevala možnost razporeditve vsake izmed tabel naše aplikacije po različnih strežnikih v različnih razmerjih. Veliko sporočil na strežniku A – prosim, prenesimo del te tabele na strežnik B. Takšna rešitev se je preprosto kričala o prezgodnji optimizaciji, zato smo se odločili omejiti na multi-tenant pristop.
O multi-tenantu lahko preberete, na primer, na spletni strani .
V SV obstajajo pojmi aplikacije in naročnika. Aplikacija je konkretna namestitev poslovne aplikacije, na primer ERP ali Računovodstva, s svojimi uporabniki in poslovnimi podatki. Naročnik je organizacija ali fizična oseba, v imenu katere se registrira aplikacija na strežniku SV. Naročnik ima lahko registrirane več aplikacij, te aplikacije pa si lahko izmenjajo sporočila med seboj. Naročnik je postal najemnik (tenant) v našem sistemu. Sporočila več naročnikov lahko obstajajo v eni fizični bazi; če opazimo, da nek naročnik začne generirati veliko prometa, ga premaknemo v ločeno fizično bazo (ali celo ločen strežnik BDP).
Imamo glavno BDP, kjer je shranjena usmerjevalna tabela z informacijami o lokaciji vseh naročniških baz podatkov.
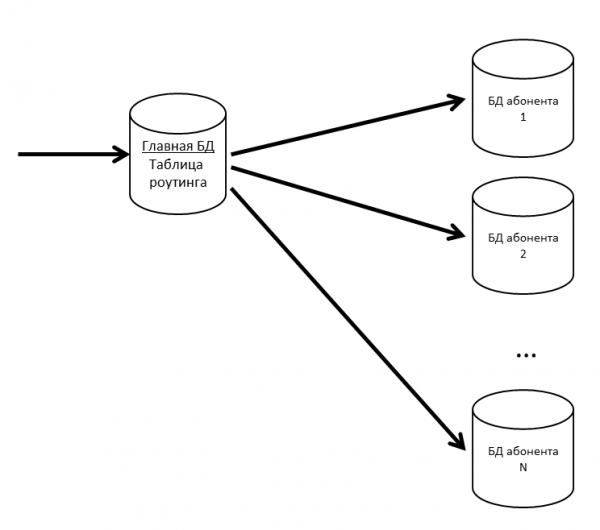
Da glavni BDP ne bi bila ozko grlo, usmerjevalno tabelo (in druge pogosto zahtevane podatke) hranimo v predpomnilniku.
Če bo BDP naročnika začela zavirati, bomo znotraj razdelili na particije. Na drugih projektih za particioniranje velikih tabel uporabljamo .
Ker je izguba sporočil uporabnikov slaba, vzdržujemo naše BDP z replikami. Kombinacija sinhronih in asinhronih replik omogoča zaščito v primeru izgube glavne BDP. Izguba sporočila se bo zgodila le v primeru hkratnega odklona glavne BDP in njene sinhrone replik.
Če izgine sinhrona replika, postane asinhrona replika sinhrona.
Če izgine glavna BDP, postane sinhrona replika glavna BDP, asinhrona replika pa sinhrona replika.
Elasticsearch za iskanje
Ker je, poleg vsega drugega, SV tudi sporočilni sistem, potrebujemo hitro, udobno in fleksibilno iskanje, ob upoštevanju morfologije, za nepopolne ujemanja. Odločili smo se, da ne bomo izumljali kolesa in uporabljali odprtokodni iskalni sistem Elasticsearch, ki temelji na knjižnici . Elasticsearch tudi postavljamo v grozdu (master – data – data), da preprečimo težave v primeru okvare vozlišč aplikacije.
Na githubu smo našli za Elasticsearch in ga uporabljamo. V indeksu Elasticsearch shranjujemo korenine besed (ki jih določa vtičnik) in N-grami. Ko uporabnik vnese besedilo za iskanje, iščemo vnašano besedilo med N-grami. Ob shranjevanju v indeks se beseda 'teksti' razdeli na naslednje N-grame:
[te, tek, teks, tekst, teksti, ek, eks, ekst, eksty, ks, kst, ksty, st, sty, ty],
Prav tako bo shranjen koren besede 'tekst'. Tak pristop omogoča iskanje po začetku, sredini in koncu besede.
Splošna slika
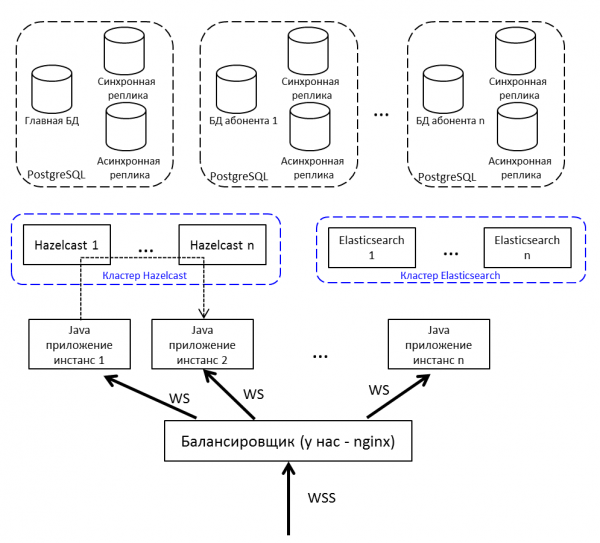
Ponovitev slike na začetku članka, vendar z razlagami:
- Balancer, postavljen v internet; pri nas – nginx, lahko pa je kateri koli.
- Instančna Java-aplikacija komunicira med seboj preko Hazelcast.
- Za delo z websockets uporabljamo .
- Java-aplikacija je napisana v Java 8, sestavljena iz paketov . Načrti vključujejo migracijo na Java 10 in prehod na module.
Razvoj in testiranje
Med razvojem in testiranjem SVis smo se srečali z vrsto zanimivih lastnosti produktov, ki jih uporabljamo.
Obremenitveno testiranje in puščanje pomnilnika
Izdaja vsakega releasa SVis je obremenitveno testiranje. Uspešno je, kadar:
- Test je deloval več dni in ni bilo izpadov storitev.
- Čas odziva pri ključnih operacijah ni preseglo udobnega praga.
- Poslabšanje zmogljivosti v primerjavi s prejšnjo različico ne presega 10%.
Testno bazo napolnimo z dati – za to pridobimo iz produkcijskega strežnika informacije o najbolj aktivnem naročniku, njegove številke pomnožimo s 5 (število sporočil, razprav, uporabnikov) in tako testiramo.
Obremenitveno testiranje sistema interakcije izvajamo v treh konfiguracijah:
- Stresno testiranje.
- Samo povezave.
- Registracija naročnikov.
Pri stresnem testiranju zagnamo nekaj sto niti, ki brez ustavljanja obremenjujejo sistem: pošiljajo sporočila, ustvarjajo razprave, prejemajo seznam sporočil. Imitiramo dejanja navadnih uporabnikov (prejeti seznam mojih neprebranih sporočil, nekomu napisati) ter programskih rešitev (poslati paket drugi konfiguraciji, obdelati obvestilo).
Na primer, tako izgleda del stresnega testiranja:
- V sistem vstopa uporabnik.
- Zahteva svoje neprebrane razprave.
- S 50% verjetnostjo prebere sporočila.
- S 50% verjetnostjo piše sporočila.
- Nadal uporabnik:
- S 20% verjetnostjo ustvari novo razpravo
- Naključno izbere katero od svojih razprav
- Vstopi notri
- Zahteva sporočila, profile uporabnikov
- Ustvari pet sporočil, naslovljenih naključnim uporabnikom iz te razprave
- Izhaja iz razprave
- Ponovi 20-krat
- Izhaja iz sistema, se vrne na začetek scenarija
- V sistem vstopi klepetalni bot (emulira izmenjavo sporočil iz kode aplikacijskih rešitev)
- S 50% verjetnostjo ustvari nov kanal za izmenjavo podatkov (posebna razprava)
- S 50% verjetnostjo napiše sporočilo v kateremkoli od obstoječih kanalov
Scenarij 'Samo povezave' se ni pojavil brez razloga. Pojavlja se situacija: uporabniki so povezali sistem, a se še niso vključili. Vsak uporabnik ob 09:00 zjutraj prižge računalnik, vzpostavi povezavo s strežnikom in molči. Ti fantje so nevarni, je jih veliko – iz paketov imajo samo PING/PONG, vendar povezavo do strežnika držijo (je ne morejo pustiti – kaj pa, če pride novo sporočilo). Test reproducira situacijo, ko v pol ure v sistemu poskuša avtentificirati veliko število takšnih uporabnikov. Podobno je stres testu, a fokus je prav na tem prvem vstopu – da ne bi bilo napak (človek ne uporablja sistema, ona pa se že odklopi – težko si je zamisliti kaj hujšega).
Scenarij registracije naročnikov se začne s prvim zagonom. Opravili smo stres test in bili prepričani, da sistem ne zaostaja pri sporočanju. A so prišli uporabniki in začela se je registracija odklapljati zaradi časovnega limita. Pri registraciji smo uporabili , ki je odvisen od entropije sistema. Strežnik ni uspel nabrati dovolj entropije in pri zahtevku novega SecureRandom je obstal na desetine sekund. Možnosti za rešitev te situacije je mnogo, na primer: preiti na manj varen /dev/urandom, namestiti posebno ploščo, ki ustvarja entropijo, generirati naključne številke vnaprej in jih hraniti v bazenu. Težavo smo začasno rešili z bazenom, a od takrat naprej izvajamo ločen test za registracijo novih naročnikov.
Kot generator obremenitve uporabljamo . Z delom z websockets ne obvlada, potreben je vtičnik. Prvi v iskalnem rezultatu za poizvedbo 'jmeter websocket' so , v katerih priporočajo .
S tega smo se odločili začeti.
Skoro nakon početka ozbiljnog testiranja, primetili smo da u JMeter-u počinju provale memorije.
Plugin je posebna velika priča, uz 176 zvezda ima 132 forkova na github-u. Sam autor nije ga ažurirao od 2015. godine (uzeli smo ga 2015. godine, tada to nije izazvalo sumnju), nekoliko github problema u vezi sa provalama memorije, 7 neodgovorenih pull request-ova.
Ako odlučite da vršite opterećujuće testiranje uz pomoć ovog plugina, obratite pažnju na sledeće diskusije:
- U višedretvenoj sredini korišćen je običan LinkedList, što je rezultiralo u runtime-u. Rešava se ili prelaskom na ConcurrentLinkedDeque, ili synchronized-blokovima. Izabrali smo prvu opciju ().
- Provala memorije, pri disconektu se ne brišu informacije o vezi ().
- U streaming režimu (kada websocket ne zatvara na kraju uzorka, već se koristi dalje u planu) ne funkcionišu Response pattern-i ().
To je ono što je na github-u. Šta smo uradili:
- Uzeli smo (@elyrank) – u njemu su ispravljeni problemi 1 i 3
- Rešili smo problem 2
- Ažurirali smo jetty sa 9.2.14 na 9.3.12
- Obavili smo SimpleDateFormat u ThreadLocal; SimpleDateFormat nije thread-safe, što je dovelo do NPE u runtime-u
- Rešili smo još jednu provalu memorije (veza nije ispravno zatvarana pri disconektu)
Ipak, on curi!
Memorija se više nije trošila za dan, već za dva. Nismo imali vremena, odlučili smo da pokrenemo manje niti, ali na četiri agenta. Ovo bi trebalo da bude dovoljno, barem na nedelju dana.
Prošlo je dva dana…
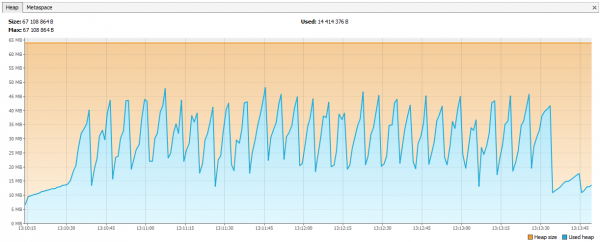
Sada se memorija troši kod Hazelcast-a. U logovima se videlo da nakon nekoliko dana testiranja, Hazelcast počinje da se žali na nedostatak memorije, a nakon nekog vremena klaster se raspada i nodovi nastavljaju da umiru pojedinačno. Povezali smo JVisualVM sa hazelcast-om i videli „uzlaznu pilu“ – redovno je pozivao GC, ali nije mogao da oslobodi memoriju.
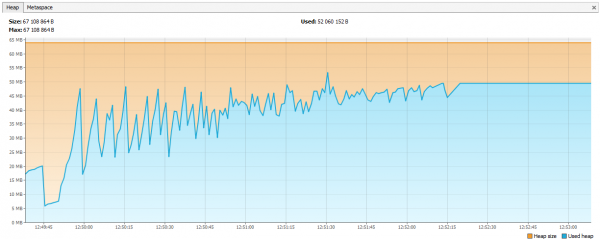
Ispostavilo se da u hazelcast 3.4 pri brisanju map / multiMap (map.destroy()) memorija se ne oslobodi potpuno:
Trenutno je greška ispravljena u 3.5, ali tada je to bio problem. Kreirali smo nove multiMap sa dinamičkim imenima i brisali ih prema našoj logici. Kod je izgledao otprilike ovako:
public void join(Authentication auth, String sub) {
    MultiMap sessions = instance.getMultiMap(sub);
    sessions.put(auth.getUserId(), auth);
}

public void leave(Authentication auth, String sub) {
    MultiMap sessions = instance.getMultiMap(sub);
    sessions.remove(auth.getUserId(), auth);

    if (sessions.size() == 0) {
        sessions.destroy();
    }
}
Запрос:
service.join(auth1, "NOVI_OBAVIJESTI_U_RASPRAVI_UUID1");
service.join(auth2, "NOVI_OBAVIJESTI_U_RASPRAVI_UUID1");
multiMap je kreiran za svaku pretplatu i uklonjen kada više nije bio potreban. Donijeli smo odluku da uvedemo Map, gdje će ključ biti naziv pretplate, a vrijednosti identifikatori sesija (koji se kasnije mogu koristiti za dobivanje identifikatora korisnika, ako je potrebno).
public void join(Authentication auth, String sub) {
    addValueToMap(sub, auth.getSessionId());
}

public void leave(Authentication auth, String sub) {
    removeValueFromMap(sub, auth.getSessionId());
}
Grafikon se stabilizovao.
Šta još znamo o testiranju opterećenja
- JSR223 treba pisati na groovy i uključiti compilation cache – to je značajno brže. .
- JMeter-Plugins grafikoni su lakši za razumevanje nego standardni. .
Naše iskustvo sa Hazelcast-om
Hazelcast je za nas bio novi proizvod, počeli smo raditi s njim od verzije 3.4.1, a sada se na našem produkcijskom serveru nalazi verzija 3.9.2 (u trenutku pisanja članka, poslednja verzija Hazelcast-a je 3.10).
Generisanje ID-a
Počeli smo s celobrojnim identifikatorima. Zamislimo da nam je potreban još jedan Long za novu entitet. Sekvenca u DB-u ne odgovara, tabele učestvuju u šardiranju – dobićemo da postoji poruka ID=1 u DB1 i poruka ID=1 u DB2, u Elasticsearch-u se takav ID ne može postaviti, ni u Hazelcast-u, ali najgore je ako želite da spojite podatke iz dve DB-e u jednu (na primer, odluka da jedna baza bude dovoljna za te pretplatnike). Možete kreirati nekoliko AtomicLong u Hazelcast-u i držati brojač tamo, tada će performanse dobijanja novog ID-a biti – incrementAndGet plus vreme za zahtev u Hazelcast. Ali u Hazelcast-u ima nešto optimizovanije – FlakeIdGenerator. Svakom klijentu se prilikom poziva dodeljuje opseg ID-a, na primer, prvom – od 1 do 10.000, drugom – od 10.001 do 20.000 i tako dalje. Sada klijent može samostalno generisati nove identifikatore dok ne iskoristi dodeljeni opseg. Radi brzo, ali prilikom ponovnog pokretanja aplikacije (i klijenta Hazelcast) započinje nova sekvenca – odatle promašaji itd. Pored toga, developerima nije baš jasno zašto su ID-ovi celobrojni, ali se toliko promašuju. Sve smo to razmotrili i prešli na UUID-ove.
Sa seconde, za onih koji žele biti poput Twittera, postoji biblioteka Snowcast – to je implementacija Snowflake preko Hazelcast. Možete je pogledati ovdje:
Ali mi nismo do nje stigli.
TransactionalMap.replace
Još jedno iznenađenje: TransactionalMap.replace ne radi. Evo testa:
@Test
public void replaceInMap_putsAndGetsInsideTransaction() {

    hazelcastInstance.executeTransaction(context -> {
        HazelcastTransactionContextHolder.setContext(context);
        try {
            context.getMap("map").put("key", "oldValue");
            context.getMap("map").replace("key", "oldValue", "newValue");

            String value = (String) context.getMap("map").get("key");
            assertEquals("newValue", value);

            return null;
        } finally {
            HazelcastTransactionContextHolder.clearContext();
        }
    });
}

Expected : newValue
Actual : oldValue
Morali smo napisati svoj replace, koristeći getForUpdate:
protected <K,V> boolean replaceInMap(String mapName, K key, V oldValue, V newValue) {
    TransactionalTaskContext context = HazelcastTransactionContextHolder.getContext();
    if (context != null) {
        log.trace("[CACHE] Zamjena vrijednosti u tranzakcionoj mapi");
        TransactionalMap<K, V> map = context.getMap(mapName);
        V value = map.getForUpdate(key);
        if (oldValue.equals(value)) {
            map.put(key, newValue);
            return true;
        }

        return false;
    }
    log.trace("[CACHE] Zamjena vrijednosti u ne tranzakcionoj mapi");
    IMap<K, V> map = hazelcastInstance.getMap(mapName);
    return map.replace(key, oldValue, newValue);
}
Testirajte ne samo obične strukture podataka, već i njihove tranzacione verzije. Desi se da IMap radi, dok TransactionalMap više ne.
Postaviti novu JAR bez zastoja
Prvo smo odlučili zapisivati objekte naših klasa u Hazelcast. Na primjer, imamo klasu Application, želimo je sačuvati i pročitati. Čuvamo:
IMap<UUID, Application> map = hazelcastInstance.getMap("application");
map.set(id, application);
Čitamo:
IMap<UUID, Application> map = hazelcastInstance.getMap("application");
return map.get(id);
Sve radi. Potom smo odlučili napraviti indeks u Hazelcastu, kako bismo pretraživali po njemu:
map.addIndex("subscriberId", false);I prilikom upisa nove entitete počeli smo dobijati ClassNotFoundException. Hazelcast je pokušavao nadograditi indeks, ali nije znao ništa o našoj klasi i tražio je da mu dostavimo JAR s tom klasom. Tako smo i uradili, sve je počelo raditi, ali se pojavio novi problem: kako nadograditi JAR bez potpunog gašenja klastera? Hazelcast ne prepoznaje novi JAR prilikom nadogradnje nodova. U tom trenutku smo odlučili da možemo živjeti bez pretraživanja po indeksu. Jer ako se koristi Hazelcast kao skladište tipa ključ-vrijednost, sve će raditi? Ne baš. Ovdje ponašanje IMap-a i TransactionalMap-a ponovo varira. Tamo gdje je IMap-u svejedno, TransactionalMap baca grešku.
IMap. Zapisujemo 5000 objektov, beremo. Vse po pričakovanju.
@Test
void get5000() {
    IMap map = hazelcastInstance.getMap("application");
    UUID subscriberId = UUID.randomUUID();

    for (int i = 0; i < 5000; i++) {
        UUID id = UUID.randomUUID();
        String title = RandomStringUtils.random(5);
        Application application = new Application(id, title, subscriberId);

        map.set(id, application);
        Application retrieved = map.get(id);
        assertEquals(id, retrieved.getId());
    }
}
V transakciji ne deluje, prejmemo ClassNotFoundException:
@Test
void get_transaction() {
    IMap map = hazelcastInstance.getMap("application_t");
    UUID subscriberId = UUID.randomUUID();
    UUID id = UUID.randomUUID();

    Application application = new Application(id, "qwer", subscriberId);
    map.set(id, application);

    Application retrievedOutside = map.get(id);
    assertEquals(id, retrievedOutside.getId());

    hazelcastInstance.executeTransaction(context -> {
        HazelcastTransactionContextHolder.setContext(context);
        try {
            TransactionalMap transactionalMap = context.getMap("application_t");
            Application retrievedInside = transactionalMap.get(id);

            assertEquals(id, retrievedInside.getId());
            return null;
        } finally {
            HazelcastTransactionContextHolder.clearContext();
        }
    });
}
V 3.8 se je pojavil mehanizem User Class Deployment. Lahko določite eno glavno vozlišče in posodabljate JAR datoteko na njem.
Zdaj smo popolnoma spremenili pristop: sami serializiramo v JSON in shranjujemo v Hazelcast. Hazelcast ne potrebuje poznati strukture naših razredov, mi pa se lahko posodabljamo brez izpadov. Različice domennih objektov upravlja aplikacija. Hkrati lahko delujejo različne različice aplikacije, in lahko se zgodi, da nova aplikacija zapisuje objekte z novimi polji, medtem ko stara o teh poljih še ne ve. Hkrati nova aplikacija prebere objekte, ki jih je zapisala stara aplikacija in ne vsebujejo novih polj. Takšne situacije obravnavamo znotraj aplikacije, vendar za enostavnost ne spreminjamo in ne brišemo polj, le razširjamo razrede z dodajanjem novih polj.
Kako zagotavljamo visoko zmogljivost
Štiri obiske v Hazelcast - dobro, dva v BDP - slabo
Zajemanje podatkov iz predpomnilnika je vedno boljše kot iz podatkovne baze, vendar ne želimo shranjevati neuporabljenih zapisov. Odločitev o tem, kaj predpomniti, prestavljamo na zadnjo fazo razvoja. Ko je nova funkcionalnost kodirana, v PostgreSQL vključimo beleženje vseh poizvedb (log_min_duration_statement na 0) in zaženemo obremenitveno testiranje za 20 minut. Na podlagi zbranih dnevnikov lahko orodja, kot sta pgFouine in pgBadger, ustvarjajo analitična poročila. V poročilih predvsem iščemo počasne in pogoste poizvedbe. Za počasne poizvedbe izdelujemo načrt izvajanja (EXPLAIN) in ocenjujemo, ali je mogoče to poizvedbo pospešiti. Pogoste poizvedbe z enakimi vhodnimi podatki se dobro shranijo v predpomnilniku. Poizvedbe poskušamo obdržati "ravne", po ena tabela na poizvedbo.
Obratovanje
SV kot spletna storitev je bila uvedena spomladi 2017, kot ločen izdelek pa je izšla novembra 2017 (takrat v beta različici).
Več kot eno leto delovanja resnih težav z delovanjem spletne storitve SV ni bilo. Spletno storitev spremljamo preko , zbiramo in uvajamo iz .
Distribucija strežnika SV je na voljo v obliki nativnih paketov: RPM, DEB, MSI. Poleg tega za Windows nudimo enoten namestitveni program v obliki enega EXE, ki namesti strežnik, Hazelcast in Elasticsearch na eno napravo. Sprva smo to različico namestitve imenovali "demonstracijska", vendar se je zdaj izkazalo, da je to najbolj priljubljena različica razporeditve.
Izvor: habr.com
