

Razvili smo oblikovanje podatkovnih centrov, ki omogoča postavitev računalniških grozdov, večjih od 100.000 strežnikov, s postopno pasovno širino (bisection bandwidth) več kot en petabajt na sekundo.
Iz poročila Dmitrija Afanajeva boste spoznali osnovna načela novega oblikovanja, razširjanje topologij, težave, ki se pri tem pojavljajo, možnosti reševanja le-teh, značilnosti usmerjanja in razširjanja funkcij forwarding plane sodobnih omrežnih naprav v 'gostih' (densely connected) topologijah z večjim številom ECMP-usmerjevalnikov. Poleg tega je Dima kratek govoril o organizaciji zunanje povezanosti, fizični ravni, sistemu kablov in načinih za nadaljnje povečanje zmogljivosti.
— Vsem dober dan! Ime mi je Dmitrij Afanajev, sem omrežni arhitekt podjetja Yandex in se predvsem ukvarjam z oblikovanjem omrežij podatkovnih centrov.
Moj govor bo o posodobljenem omrežju podatkovnih centrov Yandexa. To je v veliki meri evolucija prejšnjega oblikovanja, vendar vključuje tudi nekatere nove elemente. To je pregledna predstavitev, saj smo morali v omejenem času zajeti precej veliko informacij. Začeli bomo z izbiro logične topologije. Nato bo pregled control plane in težave z razširljivostjo data plane, izbira, kaj se bo dogajalo na fizični ravni, ter pogled na nekatere značilnosti naprav. Malce se bomo dotaknili tudi dogajanja v podatkovnem centru z MPLS-om, o katerem smo govorili pred kratkim.
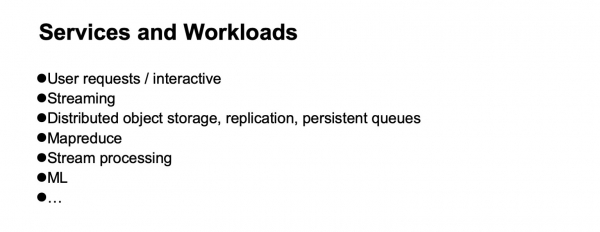
Torej, kaj je Yandex z vidika obremenitev in storitev? Yandex je tipičen hiperskalirnik. Če pogledamo z vidika uporabnikov, najprej obdelujemo uporabniške poizvedbe. Prav tako imamo različne streaming storitve in prenos podatkov, ker imamo tudi storage storitve. Če se usmerimo bližje zadnjemu delu, se pojavijo infrastrukturne obremenitve in storitve, kot so porazdeljene objektne shrambe, replikacija podatkov in seveda trajne vrste (persistent queues). Eden od glavnih tipov obremenitev je MapReduce in podobni sistemi, obdelava podatkov v toku, strojno učenje itd.
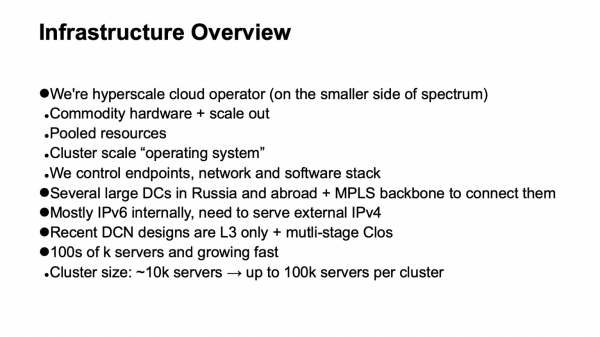
Kako je zasnovana infrastruktura na kateri se vse dogaja? Spet imamo povsem tipičnega hiperskalerja, čeprav smo morda nekoliko bliže strani spektra, kjer so manjši hiperskalerji. A imamo vse atribute. Uporabljamo navadne strežnike in horizontalno skaliranje povsod, kjer je to mogoče. Pri nas se v polni meri uporablja skupno upravljanje virov: ne delamo z ločenimi strežniki, ločenimi regali, temveč jih združujemo v velik skupni bazen zamenljivih virov ter nekaterimi dodatnimi storitvami, ki se ukvarjajo s planiranjem in dodeljevanjem, in delamo s celotnim tem bazenom.
Tako se nam pojavi naslednja raven — operacijski sistem na ravni računalniškega klasterja. Zelo pomembno je, da popolnoma obvladamo tehnološki sklad, ki ga uporabljamo. Obvladujemo končne točke (strežnike), omrežje in programski sklad.
Imamo več večjih podatkovnih centrov v Rusiji in tujini. Te združuje osrednja povezava, ki uporablja tehnologijo MPLS. Naša notranja infrastruktura je praktično povsem zgrajena na IPv6, vendar ker moramo obravnavati zunanji promet, ki še vedno prihaja predvsem skozi IPv4, moramo nekako dostaviti zahteve, ki prihajajo preko IPv4, do sprednjih -strežnikov, in še malo prečkati zunanji IPv4 internet — na primer, za indeksiranje.
Zadnje več iteracij oblikovanja omrežij podatkovnih centrov uporablja večstopenjske Clos topologije in uporablja samo L3. Pred časom smo se odpravili z L2 in si oddahnili. Naša infrastruktura vključuje na stotine tisoč računalniških (strežniških) instanc. Največja velikost klasterja je pred časom znašala približno 10 tisoč strežnikov. To je v veliki meri odvisno od tega, kako lahko delujejo tisti operacijski sistemi na ravni klasterja, planirniki, dodeljevanje virov itd. Ker se na strani infrastrukturne programske opreme pojavlja napredek, je zdaj ciljni velikost približno 100 tisoč strežnikov v enem računalniškem klasterju in imeli smo nalogo — znati zgraditi omrežne tovarne, ki omogočajo učinkovito izvajanje skupnega upravljanja virov v takem klasterju.
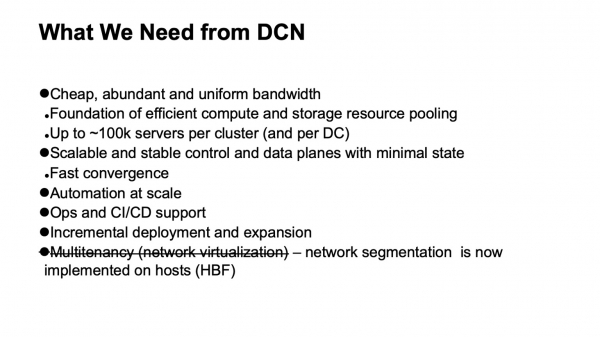
Kaj želimo od mreže podatkovnega centra? Najprej veliko poceni in dovolj enakomerno razporejene pasovne širine. Ker je mreža podlaga, s katero lahko izvajamo združevanje virov. Nova ciljna velikost je približno 100.000 strežnikov v enem klasterju.
Seveda pa si želimo tudi razširljivega in stabilnega kontrolnega plana, saj se na tako veliki infrastrukturi pojavijo številne težave, tudi zaradi naključnih dogodkov, in nočemo, da nam dodatne skrbi povzroča še kontrolni načrt. Pri tem želimo minimizirati stanje v njem. Manj ko je stanja, bolje in stabilneje vse deluje ter lažje je diagnosticirati.
Seveda potrebujemo avtomatizacijo, ker je nemogoče ročno upravljati tako infrastrukturo, to že dolgo ni več mogoče. Potrebujemo podporo operativnih dejavnosti in podporo CI/CD, kolikor je to mogoče zagotoviti.
Pri takšnih velikostih podatkovnih centrov in klastrov se je že zelo jasno izpostavila naloga zagotavljanja inkrementalnega uvajanja in širjenja brez prekinitve storitev. Če je bilo na klastrih velikosti tisoč naprav, morda blizu deset tisoč naprav, to še mogoče razširjati kot eno operacijo — torej načrtujemo širitve infrastrukture in dodajamo več tisoč naprav kot eno operacijo, se pa klaster velikosti pod sto tisoč naprav ne pojavi takoj, ampak se gradi v daljšem časovnem obdobju. In zaželeno je, da je vse to obdobje, kar je že bilo postavljeno, to infrastrukturno okolje, dostopno.
In ena zahteva, ki smo jo imeli in kasneje opustili: to je podpora večnajemništvu, torej virtualizaciji ali segmentaciji omrežja. Zdaj nam tega ni treba izvajati na ravni omrežne tovarne, ker se je segmentacija preselila na gostitelje, kar nam je zelo poenostavilo širitev. Zahvaljujoč IPv6 in velikem naslovnem prostoru nam ni bilo treba v notranji infrastrukturi uporabljati podvojenih naslovov, vsa naslovnost je bila že tako edinstvena. In ker smo filtracijo in segmentacijo omrežja prenesli na gostitelje, ni bilo treba ustvarjati nekih virtualnih omrežnih entitet v omrežjih podatkovnega centra.
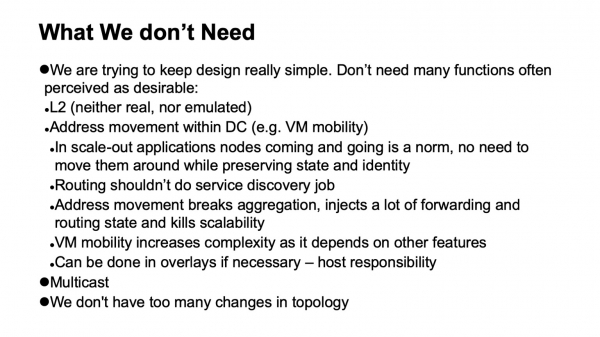
Zelo pomembna stvar je to, kar nam ni potrebno. Če lahko nekatere funkcije odstranimo iz omrežja, to močno olajša življenje in običajno razširi izbiro razpoložljive strojne in programske opreme ter poenostavi diagnostiko.
Torej, česa nam ni potrebno, česa smo se lahko odrekli, ne vedno z veseljem v trenutku, ko se je to dogajalo, ampak z velikim olajšanjem, ko je bil postopek končan?
Najprej, opustitev L2. L2 nam ni potreben, ne pravi, ne emuliran. Uporablja se v omejeni meri, ker nadzorujemo sklad aplikacij. Naše aplikacije se horizontalno skalirajo, delujejo z L3 naslovljanjem, ne skrbijo preveč, če kakšen posamezni instančni izklopi, kar pomeni, da preprosto uvedejo novega, ki se ne potrebuje zagnati na starem naslovu, ker obstaja ločen nivo za odkrivanje storitev in spremljanje strojev, ki so v klastru. Te naloge ne prenašamo na omrežje. Naloga omrežja je dostaviti pakete od točke A do točke B.
Prav tako nimamo situacij, kjer se naslovi premikajo znotraj omrežja in to je treba spremljati. V mnogih oblikah je to običajno potrebno za podporo mobilnosti VM. Ne uporabljamo mobilnosti virtualnih strojev v notranji infrastrukturi velikega Yandexa in menimo, da, tudi če to izvajamo, ne bi smelo potekati s podporo omrežja. Če je to zelo potrebno, je treba to izvesti na nivoju gostiteljev in prisiliti naslove, ki lahko migrirajo, v overlaye, da ne motimo in ne uvajamo preveč dinamičnih sprememb v sistem usmerjanja dejanskega underlaya (transportnega omrežja).
Še ena tehnologija, ki je ne uporabljamo — je multicast. Tistim, ki jih zanima, lahko natančneje razložim, zakaj. To močno olajša življenje, saj, če je imel kdo s tem opravka in gledal, kako izgleda natančno nadzorna ravnina multicaste — v vseh namestitvah, razen najpreprostejših, je to velika glavobol. In poleg tega je težko najti dobro delujočo odprtokodno implementacijo, na primer.
Na koncu oblikujemo svoja omrežja tako, da se v njih ne dogajajo prevelike spremembe. Lahko se zanesemo na to, da je tok zunanjih dogodkov v sistemu usmerjanja majhen.
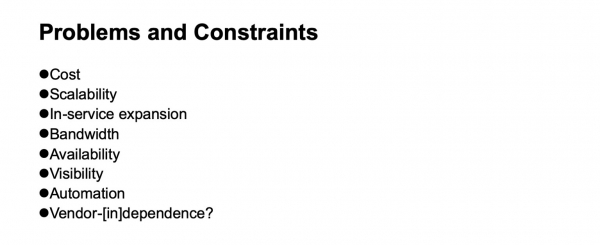
Kakva se vprašanja in kakšne omejitve je treba upoštevati, ko razvijamo omrežje podatkovnega centra? Seveda cena. Skalabilnost, do katere stopnje želimo rasti. Potreba po širjenju brez prekinitev storitev. Bandwidth, dostopnost. Vidnost tega, kar se dogaja v omrežju, za sisteme za spremljanje, za operativne ekipe. Podpora avtomatizaciji — znova, kolikor je mogoče, saj se različne naloge lahko rešujejo na različnih ravneh, vključno z uvajanjem dodatnih plasti. In ne-[vse-mogoče]-odvisnost od dobaviteljev. Čeprav so bila v različnih zgodovinskih obdobjih, odvisno od tega, na kakšen razrez gledamo, ta neodvisnost lažje ali težje dosegljiva. Če vzamemo razrez čipov omrežnih naprav, potem je bilo do nedavnega zelo pogojno govoriti o neodvisnosti od dobaviteljev, če smo želeli tudi čipe z visoko propustnostjo.
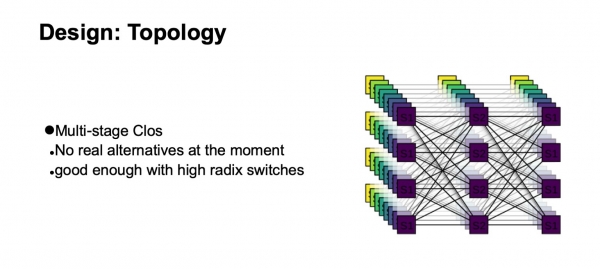
Po kateri logični topologiji bomo torej gradili naše omrežje? To bo večnivojski Clos. V resnici ni pravih alternativ v tem trenutku. In Clos-topologija je dovolj dobra, tudi če jo primerjamo z različnimi naprednimi topologijami, ki so trenutno bolj na področju akademskega interesa, kadar imamo stikala z velikim radiksom.
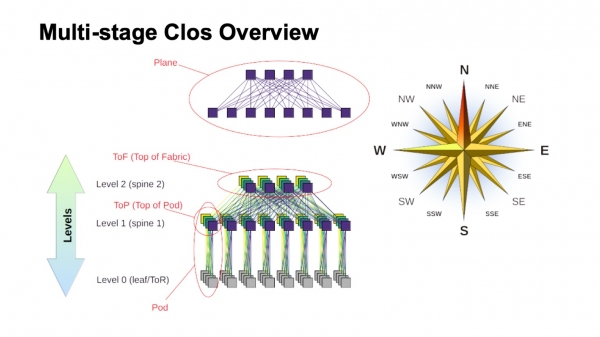
Kako je približno zasnovano večnivojsko Clos-omrežje in kako so poimenovani različni elementi? Najprej, roža vetrov, da se orientiramo, kjer je sever, kjer jug, kjer vzhod, kjer zahod. Takšne vrste omrežja običajno gradijo tisti, ki imajo zelo velik promet vzhod — zahod. Kar zadeva preostale elemente, je zgoraj prikazano virtualno stikalo, sestavljeno iz manjših stikal. To je osnovna ideja rekurzivnega grajenja Clos-omrežij. Vzamemo elemente z nekim radiksom in jih povežemo tako, da je to, kar smo dobili, mogoče obravnavati kot stikalo z večjim radiksom. Če potrebujemo še več, lahko postopek ponovimo.
V primerih, kot so dvojnivojski Clos, ko lahko jasno ločimo komponente, ki so na mojem diagramu vertikalne, jih običajno imenujemo ravnine. Če bi gradili Clos s tremi nivoji spine stikal (vsa, ki niso meji in niso ToR stikala ter se uporabljajo le za tranzit), bi ravnine izgledale bolj zapleteno, dvojnivojske pa izgledajo prav tako. Blok ToR ali leaf stikal in z njimi povezani prvi nivo spine stikali imenujemo Pod. Spine stikala prve ravni pod zgoraj Pod so top of Pod, vrh Pod. Stikala, ki se nahajajo na vrhu celotne fabrike, so zgornji sloj fabrike, Top of fabric.
Seveda se pojavi vprašanje: Clos omrežja se gradijo že nekaj časa, sama ideja izhaja iz časov klasične telefonije, TDM omrežij. Morda je nastalo kaj boljšega, morda bi lahko kaj bolje naredili? In da, in ne. Teoretično da, v praksi pa v bližnji prihodnosti zagotovo ne. Ker obstaja določeno število zanimivih topologij, del njih se celo uporablja v produkciji, na primer Dragonfly se uporablja v HPC aplikacijah; obstajajo tudi zanimive topologije, kot so Xpander, FatClique, Jellyfish. Če pogledamo poročila na konferencah, kot sta SIGCOMM ali NSDI v zadnjem času, lahko odkrijemo kar precej del na alternativnih topologijah, ki imajo boljše lastnosti (takšne ali drugačne) od Clos.
Ampak vse te topologije imajo eno zanimivo lastnost. Ta preprečuje njihovo uvedbo v podatkovnih centrih, ki jih poskušamo graditi na komoditni strojni opremi in ki stanejo dovolj razumne denarja. V vseh teh alternativnih topologijah je večina pasovne širine, na žalost, dostopna ne po najkrajših poteh. Zato takoj izgubimo možnost uporabe tradicionalne kontrolne ravni.
Teoretično je rešitev problema znana. To so na primer modifikacije link state z uporabo k-najkrajših poti, vendar spet, ne obstajajo taki protokoli, ki bi bili implementirani v produkciji in množično dostopni na opremi.
Poleg tega, ker je velika večina zmogljivosti na voljo ne po najkrajših poteh, moramo modificirati ne le kontrolno raven, da izbere vse te poti (mimogrede, to je bistveno večje stanje v kontrolni ravni). Prav tako moramo modificirati napajalno raven, pri čemer je običajno potrebno vsaj dve dodatni funkciji. To je zmožnost sprejemanja vseh odločitev o usmerjanju paketov hkrati, na primer na gostitelju. Pravzaprav gre za usmerjanje na izvoru, kar se v literaturi o medsebojnih omrežjih včasih imenuje odločitev o usmerjanju hkrati. In še adaptivno usmerjanje – to je funkcija, ki jo potrebujemo na omrežnih elementih, ki se nanaša na to, da izberemo naslednji skok glede na informacije o najmanjši obremenitvi čaka. Kot primer so možne druge možnosti.
Tako je smer zanimiva, vendar je žal trenutno ne moremo uporabiti.
Okej, ustavili smo se pri logični topologiji Clos. Kako jo bomo razširili? Poglejmo, kako je zasnovana in kaj lahko storimo.
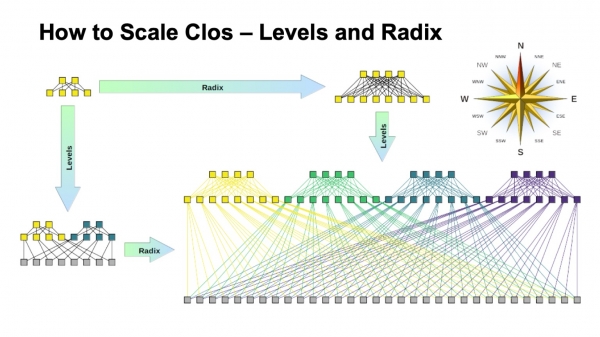
V Clos omrežju sta dva osnovna parametra, ki ju lahko nekako spreminjamo in dobimo različne rezultate: radix elementov in število ravni v omrežju. Imamo diagram, kako to vpliva na velikost. Idealen je, da kombiniramo oboje.
Vidno je, da je končna širina Clos omrežja produkt po vseh ravneh spine preklopnikov južnega radiksa, koliko povezav imamo navzdol, kako se veže. Tako razširimo velikost omrežja.
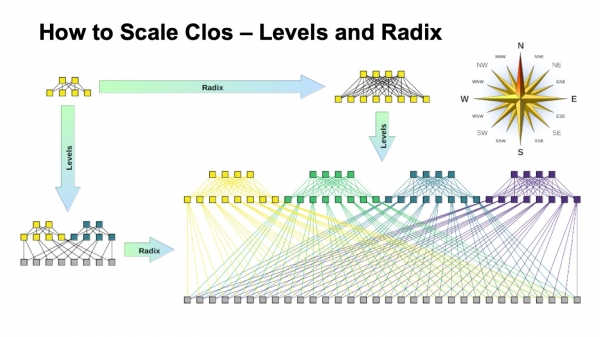
Kar zadeva kapaciteto, še posebej na ToR preklopnikih, obstajata dve možnosti razširitve. Bodisi lahko, ob ohranjanju skupne topologije, uporabljamo hitrejše povezave, bodisi lahko dodamo več ploskev.
Če pogledamo razširjeno različico Clos omrežja (v spodnjem desnem kotu) in se vrnemo k tej sliki z Clos omrežjem spodaj…
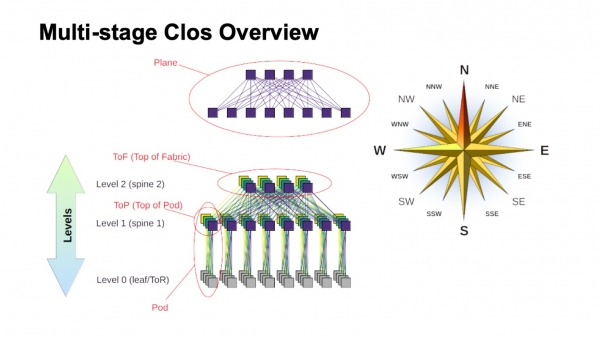
… je to pravzaprav ista topologija, vendar je na tej diapozitivu bolj kompaktno in so ravni tovarne naložene ena na drugo. To je isto.
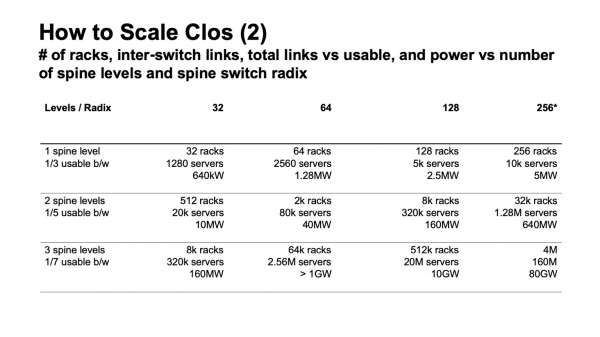
Kako izgleda razširitev Clos omrežja v številkah? Tukaj so predstavljeni podatki o maksimalni širini, ki jo lahko dosežemo v omrežju, koliko maksimalnih omaric, ToR preklopnikov ali leaf preklopnikov, če niso v omaricah, lahko dosežemo glede na to, kakšen je naš radix preklopnikov, uporabljenih za spine ravni, in koliko ravni uporabljamo.
Tuk je navedeno, koliko imamo lahko stojal, koliko strežnikov in koliko vse to lahko porabi na osnovi 20 kW na stojalo. Malo prej sem omenil, da ciljamo na velikost klasterja okoli 100 tisoč strežnikov.
Očitno sta v tej konstrukciji zanimiva dva in pol primera. Obstaja možnost z dvema plastema spine in 64-portnimi stikali, ki nekoliko zaostaja. Nato so odlične možnosti za 128-portna (z radixom 128) spine stikala z dvema nivojema, ali stikala z radixom 32 s tremi nivoji. In v vseh primerih, kjer je višji radix in več nivojev, lahko ustvarimo zelo veliko omrežje, vendar, če pogledate pričakovano porabo, ponavadi zadeva doseže gigavate. Kabli se lahko položijo, toda toliko električne energije na enem mestu verjetno ne bomo dobili. Če pogledamo statistiko, je javno dostopnih podatkov o podatkovnih centrih zelo malo, ki bi prikazovali načrtovano moč več kot 150 MW. Tisto, kar je več, so ponavadi kampusi podatkovnih centrov, kjer je več velikih podatkovnih centrov, lociranih dovolj blizu drug drugemu.
Obstaja še en pomemben parameter. Če pogledate levo kolono, je tam navedena uporabna pasovna širina. Ni težko opaziti, da v Clos-omrežju opazen del portov odide za povezovanje stikala med seboj. Uporabna pasovna širina, to je tista, ki jo lahko damo ven, v smeri strežnikov. Očitno govorim o hipotetičnih portih in o sami pasovni širini. Na splošno so povezave znotraj omrežja hitrejše od povezav v smeri strežnikov, toda za enoto pasovne širine, ki jo lahko damo ven na naše strežniške naprave, pride še nekaj pasovne širine znotraj samega omrežja. In čim več nivojev naredimo, tem večji so stroški prenašanja te pasovne širine navzven.
Poleg tega tudi ta dodatna pasovna širina ni povsem enaka. Dokler so razdalje kratke, lahko uporabljamo kaj takega kot DAC (direct attach copper, torej twinax kabli) ali multimode optiko, ki stane še bolj ali manj razumne denar. Ko preidemo na daljše razdalje — ponavadi je to enonamenska optika, in stroški te dodatne pasovne širine se znatno povečajo.
In the context of the previous slide, if we build a Clos network without oversubscription, it’s easy to look at the diagram and see how the network is constructed — adding each level of spine switches, we duplicate the entire bandwidth that was at the bottom. Plus one level means plus the same bandwidth again, with as many ports on the switches and the same number of transceivers. Therefore, minimizing the number of spine switch levels is highly desirable.
Based on this diagram, it’s clear that we would like to build on something like switches with a radix of 128.
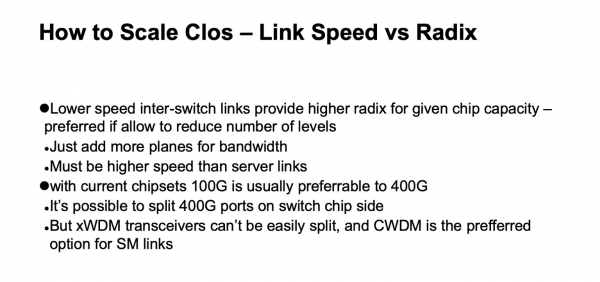
Essentially, this slide contains the same information I just shared; it's more for consideration later.
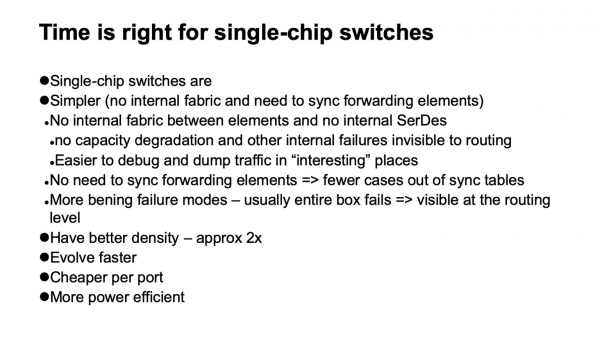
What options do we have for selecting such switches? The good news for us is that these networks can now finally be built on single-chip switches. This is great because they have many beneficial features. For instance, they almost lack an internal structure. This means they tend to break down more simply. They do break down, but fortunately, they tend to fail completely. Modular devices can have many failures (quite unpleasant) where, from the perspective of neighbors and the control plane, they seem to function, but for instance, part of the fabric has failed, and it does not operate at full capacity. Traffic is balanced based on the assumption that it is fully functional, which can lead to overload.
Alternatively, there may be problems with the backplane because inside a modular device, there are also high-speed SerDes — it is indeed complicated internally. There may be synchronization issues with the tables between forwarding elements. Generally, any high-performance modular device, consisting of many elements, tends to contain the same Clos network inside, but it is quite difficult to diagnose. Often, even the vendor finds it hard to diagnose.
In den meisten Ausfällen gibt es viele Szenarien, bei denen das Gerät degradiert, aber nicht vollständig aus der Topologie fällt. Da wir ein großes Netzwerk haben, das aktiv eine Lastverteilung zwischen identischen Elementen nutzt, und da das Netzwerk sehr regelmäßig ist, das heißt, ein Weg, auf dem alles in Ordnung ist, unterscheidet sich nicht von einem anderen Weg, ist es für uns vorteilhafter, einfach einen Teil der Geräte aus der Topologie zu verlieren, anstatt in eine Situation zu geraten, in der einige von ihnen anscheinend funktionieren, andere jedoch nicht.
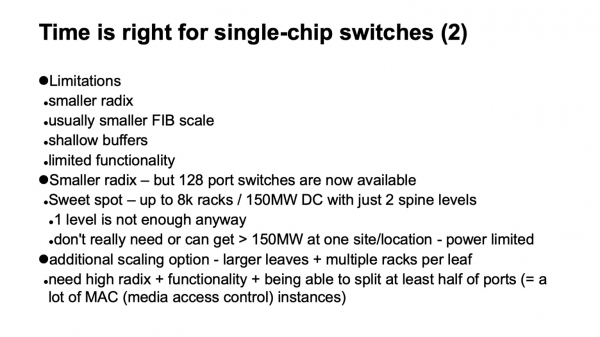
Ein weiterer angenehmer Aspekt von Single-Chip-Geräten ist, dass sie sich besser und schneller entwickeln. Zudem haben sie in der Regel eine bessere Kapazität. Wenn wir uns große Baukonstruktionen ansehen, die wir haben, ergibt sich pro Rack-Unit fast doppelt so viel Kapazität für Ports mit derselben Geschwindigkeit im Vergleich zu modularen Geräten. Geräte, die um einen einzelnen Chip herum gebaut sind, sind merklich günstiger als modulare und verbrauchen weniger Energie.
Aber natürlich ist nicht alles so einfach; es gibt auch Nachteile. Erstens haben sie praktisch immer einen kleineren Radix als modulare Geräte. Wenn wir ein Gerät, das um einen Chip gebaut ist, mit 128 Ports erhalten können, können wir modulare Geräte bereits problemlos mit mehreren Hunderten von Ports erhalten.
Es ist eine deutlich kleinere Größe der Forwarding-Tabellen und im Allgemeinen von allem, was mit der Skalierbarkeit der Datenebene zu tun hat. Flache Puffer. Und im Allgemeinen eine ziemlich eingeschränkte Funktionalität. Es stellt sich jedoch heraus, dass es nicht so erschreckend ist, wenn man diese Einschränkungen kennt und rechtzeitig darauf vorbereitet ist, sie zu umgehen oder einfach zu berücksichtigen. Das kleinere Radix ist bei neu eingeführten Geräten mit einem Radix von 128 kein Problem mehr, wir können uns in zwei Schichten von Spine-Geräten aufbauen. Mit nur einer Schicht ergeben sich sehr kleine Cluster. Selbst frühere Designs und Anforderungen übertrafen sie immer noch.
V resnici, če je rešitev nekje na robu, obstaja še en način za širjenje. Ker je zadnji (ali prvi), najnižji nivo, ki se povezuje s strežniki — ToR stikala ali leaf stikala, nismo dolžni povezniti enega racka. Zato, če rešitev nekje zaostaja za dva krat, lahko razmislimo, da bi preprosto uporabili stikalo z večjim radiksom na spodnjem nivoju in povezali, na primer, dve do tri racke v eno stikalo. To je tudi možnost, ima svoje stroške, vendar deluje in je lahko dobra rešitev, ko je potrebno podaljšati dimenzijo za dva krat.
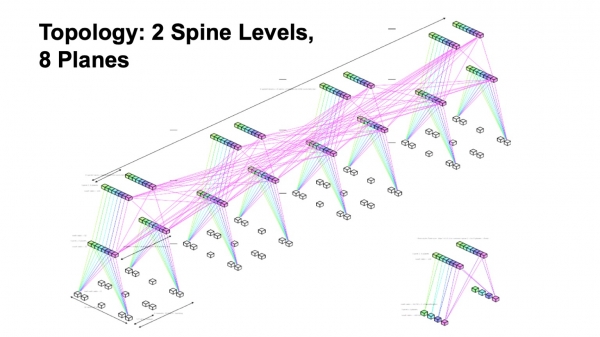
Na kratko, gradimo po topologiji z dvema nivojema spine, z osmimi plastmi tovarne.
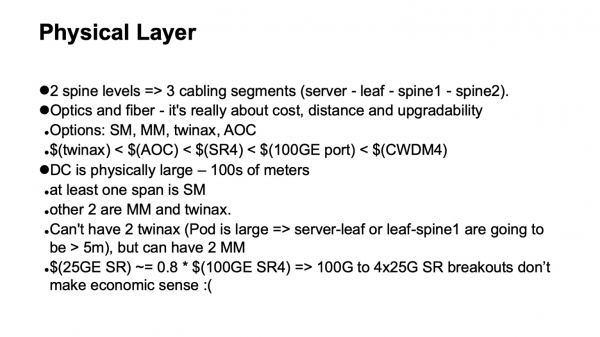
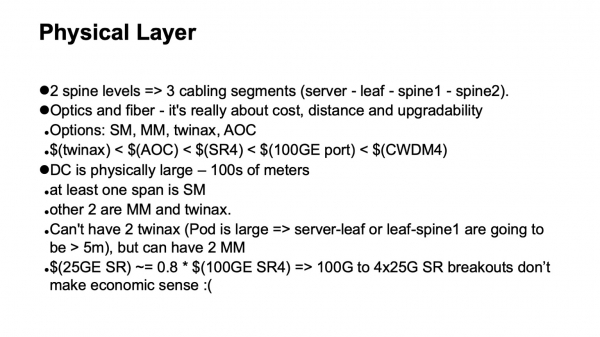
Kaj bo s fiziko? Zelo preprosti izračuni. Če imamo dva nivoja spine, imamo skupaj tri nivoje stikal in pričakujemo, da bodo v omrežju trije kabelski segmenti: od strežnikov do leaf stikal, do spine 1, do spine 2. Možnosti, ki jih lahko uporabimo — so twinax, multimode, single mode. In tukaj je treba upoštevati, kakšna je razpoložljiva širina, koliko bo to stalo, kakšne so fizične dimenzije, kakšne razdalje lahko pokrijemo in kako se bomo nadgradili.
Vse stroške lahko razporedimo v vrsto. Twinax-i so občutno cenejši od aktivne optike, cenejši od multimode transceiverjev, če gledamo na razdaljo na konec, nekoliko cenejši od 100-gigabitnega porta stikala. In, pozor, stane manj kot single mode optika, ker je na razdaljah, kjer je potrebna single mode, v podatkovnih centrih iz več razlogov smiselno uporabljati CWDM, z paralelnim single mode (PSM) ni zelo priročno, nastanejo zelo veliki paketi vlakna, in če se ustavimo na teh tehnologijah, dobimo približno takšno hierarhijo cen.
Še ena opomba: žal, ni zelo učinkovito uporabljati razstavljene 100 na 4x25 multimode porte. Zaradi posebnosti konstrukcije transceiverjev SFP28 ne stane dosti manj kot QSFP28 na 100 Gbit. In ta razstavljanje za multimode ne deluje prav dobro.
Še eno omejitev predstavljajo dimenzije računalniških gruč, saj so naši podatkovni centri fizično veliki. To pomeni, da bo potrebno izvesti vsaj en prehod s singlmodom. Glede na fizične velikosti Pods ne bo mogoče prečkati dveh prehodov twinax žic.
Na koncu, če optimiziramo ceno in upoštevamo geometrijo te konstrukcije, dobimo en prehod s twinaxom, en prehod z multimodom in en prehod s singlmodom z uporabo CWDM. To upošteva tudi morebitne načine nadgradnje.
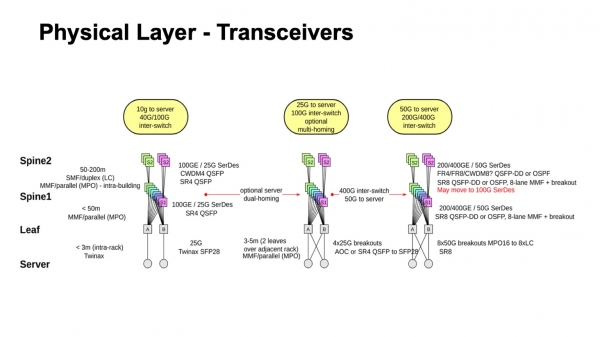
Približno tako izgleda, kaj je bilo pred kratkim, kam gremo in kaj je mogoče. Jasno je, vsaj kako napredovati proti 50-gigabitskim SerDes in za multimode ter singlmode. Poleg tega, če pogledamo zdajšnje singlmod transceiverje ter prihodnjost za 400G, je pogosto, da tudi, ko pridejo 50G SerDes z električne strani, lahko optika odide že pri 100 Gbps na vodilo. Zato je precej možno, da namesto prehoda na 50 pride prehod na 100-gigabitske SerDes in 100 Gbps na vodilo, ker mnogi ponudniki obljubljajo, da bo njihova razpoložljivost kmalu. Obdobje, ko so bili 50G SerDes najhitrejši, se zdi, da ne bo dolgo trajalo, saj bodo prvi primerki 100G SerDes na voljo že naslednje leto. In po nekem času po tem bi lahko bili dostopni po razumnih cenah.
Še en aspekt pri izbiri fizike. V osnovi že sedaj lahko uporabljamo 400- ali 200-gigabitne porte z 50G SerDes. Vendar se izkaže, da v tem ni posebnega smisla, ker, kot sem prej pripovedoval, si želimo dovolj velikega radixa na preklopnikih, seveda znotraj razumnih meja. Želimo 128. Če je kapaciteta čipa omejena in povečujemo hitrost povezave, se radix seveda zniža, čudesa ni.
Skupno kapaciteto lahko povečamo z dodatnimi ravnmi, pri čemer ni posebnih stroškov, lahko dodamo število ravni. Če izgubimo radix, pa bomo morali uvesti dodaten nivo, zato se ob trenutnih razmerah in ob največji razpoložljivi kapaciteti na en čip izkaže, da je učinkoviteje uporabljati 100-gigabitne porte, ker ti omogočajo večji radix.
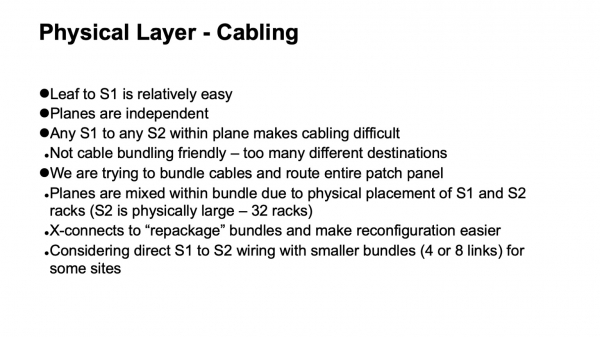
Naslednje vprašanje je, kako je organizirana fizika, a tokrat z vidika kablinske infrastrukture. Izkazalo se je, da je organizirana precej zabavno. Kabelstvo med leaf-stikali in prvim nivojem spine-ov – tam ni toliko povezav, vse se gradi razmeroma preprosto. Če pa vzamemo eno raven, tisto, kar se dogaja znotraj – tam je treba povezati vse spine prvega nivoja z vsemi spini drugega nivoja.
Poleg tega so običajno določena pričakovanja glede tega, kako bi to moralo izgledati znotraj podatkovnega centra. Na primer, zelo smo želeli združiti kable v svežnje in jih potegniti tako, da bi ena visoko gostota patch-panel šla v celoti v en patch-panel, da ne bi imel 'živalskega vrta' po dolžinah. Uspelo nam je rešiti to nalogo. Če na logično topologijo gledamo izvorno, je videti, da so ravni neodvisne, vsaka raven se lahko gradi sama po sebi. A ko dodamo takšno bundling in želimo potegniti celoten patch-panel v patch-panel, moramo znotraj enega svežnja mešati različne ravni in uvesti vmesno konstrukcijo v obliki optičnih križnih povezav, da jih ponovno pakiramo od načina, kako so bile sestavljene na enem segmentu, v to, kako bodo sestavljene na drugem segmentu. Zaradi tega dobimo prijetno značilnost: vsa kompleksna komunikacija ne presega meja stojal. Ko je treba zelo močno preplesti, 'odstraniti ravni', kot to včasih imenujejo v Clos-omrežjih, se vse osredišči znotraj enega stojala. Nimamo močno razpršenih komunikacij, do posameznih povezav, med stojali.
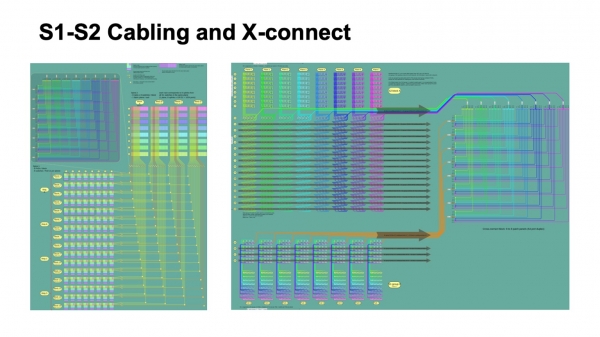
Tako to izgleda z vidika logične organizacije kablinske infrastrukture. Na sliki levo večbarvni bloki predstavljajo bloke spine-stikal prvega nivoja, po osem kosov, in od njih gredo štiri svežnji kablov, ki gredo in prečkajo svežnje, ki gredo od blokov spine-2-stikal.
Mali kvadrati predstavljaju preseke. U gornjem levom uglu je prikazana razrada svakog preseka, zapravo je to modul cross-connecta sa 512 na 512 portova, koji prepakuje kablove tako da se svi dolaze u jedan ormar, u kojem postoji samo jedna ravna površina spine-2. A desno je razrada ove slike koja je malo detaljnija u odnosu na nekoliko Pods na nivou spine-1, i kako se to upakuje u cross-connect, kako dolazi na nivo spine-2.
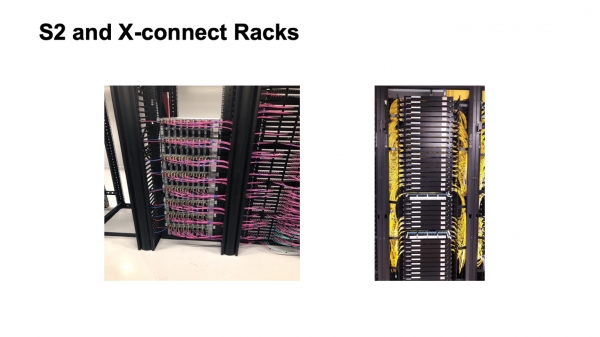
Ovako to izgleda. Još uvek nije potpuno sastavljen ormar spine-2 (levo) i ormar za cross-connect. Nažalost, tu nije mnogo vidljivo. Cela ova konstrukcija se trenutno razvija u jednom od naših velikih data centara koji se proširuje. To je rad u toku, izgledaće lepše, biće bolje popunjeno.
Važno pitanje: izabrali smo logičku topologiju, izgradili fizičku. Šta će biti sa control plane-om? Dobro je poznato iz iskustva eksploatacije, postoji određeni broj izlaganja da su link state protokoli dobri, lako se rade s njima, ali, nažalost, u gusto povezanim topologijama loše se skaliraju. I postoji jedan glavni faktor koji to sprečava — to je način na koji flood radi u link state protokolima. Ako jednostavno uzmemo algoritam floodinga, pogledamo kako je uređena naša mreža, biće vidljivo da će na svakom koraku postojati vrlo veliki fanout, i jednostavno će preplaviti control plane ažuriranjima. Konkretno takve topologije sa tradicionalnim algoritmom floodinga u link state protokolima se vrlo loše mešaju.
Izbor — koristiti BGP. Kako ga pravilno pripremiti, opisano je u RFC 7938 o korišćenju BGP u velikim data centrima. Osnovne ideje su jednostavne: minimalan broj prefiksa po hostu i uopšte minimalan broj prefiksa u mreži, koristiti agregaciju ako je to moguće, i suprimirati path hunting. Želimo vrlo pažljivo, vrlo kontrolisano širenje ažuriranja, ono što se naziva valley free. Želimo da ažuriranja, prolazeći kroz mrežu, budu razvijena tačno jedanput. Ako se originišu na dnu, idu na vrh, i razvijaju se ne više od jednom. Ne bi trebalo da bude zig-zagova. Zig-zagovi su vrlo loši.
Da bi to postigli, koristimo prilično jednostavnu shemu za korišćenje osnovnih mehanizama BGP. Odnosno, koristimo eBGP koji radi na link local, a autonomne sisteme dodeljujemo na sledeći način: autonomni sistem na ToR-u, autonomni sistem za ceo blok spine-1 prekidača jednog Poda i zajednički autonomni sistem za ceo Top of Fabric. Nije teško pogledati i uveriti se da čak i normalno ponašanje BGP-a daje širenje ažuriranja koje želimo.
Naravno, moramo dizajnirati adresaciju i agregaciju adresa tako da bude kompatibilna sa načinom na koji je izgrađena rutiranje, kako bi se obezbedila stabilnost kontrolne ravni. L3 adresacija u transportu je vezana za topologiju, jer bez toga ne možemo postići agregaciju, inače će pojedinačne adrese proći u sistem rutiranja. I još jedna stvar — agregacija se, nažalost, ne meša dobro sa multi-path, jer kada imamo multi-path i agregaciju, sve je u redu kada je cela mreža operativna i nema kvarova. Nažalost, čim se u mreži pojave kvarovi i simetrija topologije izgubi, možemo doći do tačke iz koje je oglašena agregacija, iz koje se ne može dalje proći tamo gde nam treba. Stoga je najbolje agregirati tamo gde dalje nema multi-path, u našem slučaju ToR prekidači.
Zapravo, agregacija je moguća, ali s oprezom. Ako možemo ostvariti kontrolisanu deagregaciju u slučaju kvarova u mreži. Ali to je prilično složen zadatak, čak smo razmatrali da li je moguće dodati dodatnu automatizaciju i konačne automate koji će pravilno aktivirati BGP za postizanje željenog ponašanja. Nažalost, obrada corner cases je veoma nejasna i složena, a dodavanjem spoljne opreme za BGP ova operacija se ne rešava dobro.
U ovom smislu, urađen je veoma zanimljiv rad u okviru protokola RIFT, o kojem će biti reči u sledećem izlaganju.
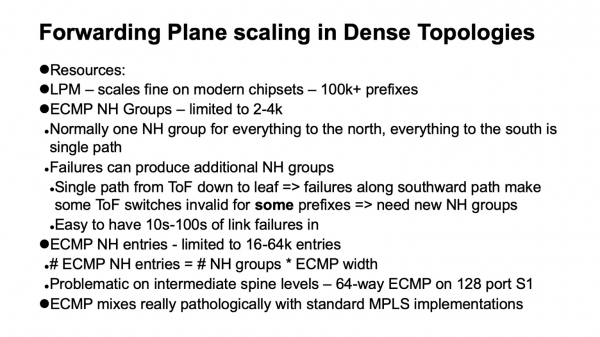
Još jedna važna stvar je kako se skaliraju data plane u gustim topologijama, gde imamo veliki broj alternativnih puteva. U tom smislu koriste se nekoliko dodatnih struktura podataka: ECMP grupe, koje opisuju sledeće grupe slanja.
V normalno delujoči mreži, brez okvar, ko se povzpnemo po Clos-topologiji navzgor, zadostuje uporabiti samo eno skupino, saj se vse, kar ni lokalno, opisuje z privzeto vrednostjo, lahko greš navzgor. Ko gremo od zgoraj navzdol proti jugu, so vse poti brez ECMP, to so enopoti. Vse je v redu. Težava je v tem, in posebnost klasične Clos-topologije je, da če pogledamo vrh tkanine, ima vsak element do katerega koli elementa spodaj eno pot. Če na tej poti pride do okvar, potem ta specifični element na vrhu tkanine postane neveljaven ravno za tiste prefikse, ki ležijo za pokvarjeno potjo. Za ostale pa ostaja veljaven, in moramo razčleniti ECMP skupine in vnesti nov status.
Kako izgleda skalabilnost podatkovne ravni na sodobnih napravah? Če izvajamo LPM (najdaljši prefiksni ujemanje), je vse dovolj dobro, nad 100 tisoč prefiksov. Če govorimo o skupinah Next Hop, je vse slabše, od 2 do 4 tisoč. Če govorimo o tabeli, ki vsebuje opis Next Hops (ali sosedstev), je to nekje od 16 tisoč do 64 tisoč. In to lahko postane težava. In tu pridemo do zanimivega odklona: kaj se je zgodilo z MPLS v podatkovnih centrih? V bistvu, želeli smo ga uvesti.
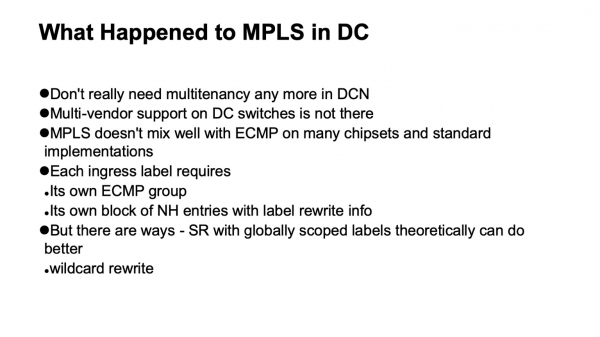
Zgodili sta se dve stvari. Uvedli smo mikrosementacijo na gostiteljih, zato nam ni bilo treba tega izvajati na omrežju. Ni bilo zelo dobro z podporo različnih dobaviteljev in še bolj z odprtimi implementacijami na belih škatlah z MPLS. In MPLS, vsaj njegove tradicionalne izvedbe, se žal zelo slabo povezujejo z ECMP. In zato.
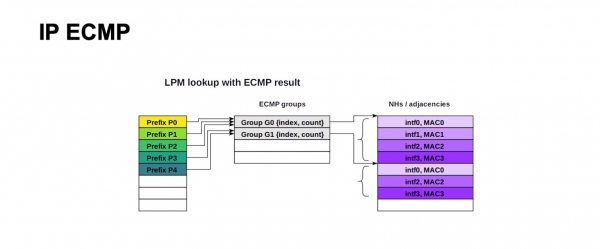
Tako izgleda struktura ECMP usmerjanja za IP. Veliko število prefiksov lahko uporablja isto skupino in isti blok Next Hops (ali sosedstev, v razni dokumentaciji za različne naprave se to lahko imenuje različno). Pomeni, da je to opisano kot izhodna vrata in na kaj prepisati MAC naslov, da pridemo do pravega Next Hopa. Za IP vse izgleda preprosto, lahko uporabite zelo veliko število prefiksov na isto skupino, en in isti blok Next Hops.
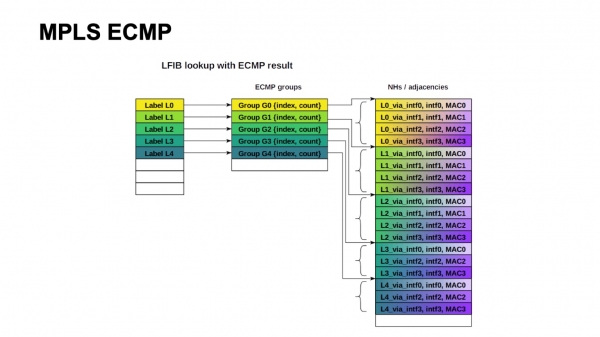
Klasična arhitektura MPLS predvideva – odvisno od izhodnega vmesnika, se oznaka lahko prepisuje na različne vrednosti. Zato moramo imeti po skupini in po bloku Next Hops za vsak vhodni oznako. In to se, žal, ne skalira.
Ni je jednostavno primetiti da nam je u našoj konstrukciji bilo potrebno oko 4000 ToR prekidača, maksimalna širina — 64 puta ECMP, ako se pređemo sa spajna-1 na spajna-2. Jedva smo se uklopili, na granici, u jednu tabelu ECMP grupa, ako jedan prefiks sa ToR odlazi, i uopšte se ne uklapamo u tabelu Next Hops.
Nije sve beznadežno, jer arhitekture tipa Segment Routing podrazumevaju globalne oznake. Formalno, moglo bi se opet sklopiti sve te blokove Next Hops. Za to je potrebna operacija tipa wild card: uzeti oznaku i prepisati na istu bez konkretne vrednosti. Ali nažalost, u dostupnim implementacijama to nije baš prisutno.
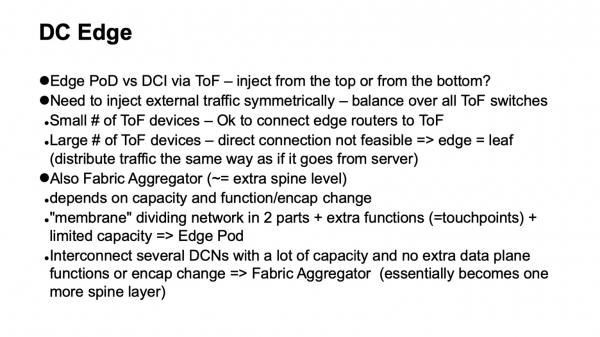
I konačno, potrebno je doneti spoljašnji saobraćaj u data centar. Kako to uraditi? Nekada se saobraćaj uvodio u Clos mreže sa vrha. Drugim rečima, postojali su granični ruteri koji su se povezivali sa svim uređajima na Top of fabric. Ovo rešenje funkcioniše prilično dobro na malim i srednjim dimenzijama. Nažalost, da bi se saobraćaj na takav način simetrično uvodio u celu mrežu, potrebno je obezbediti pristup svim elementima Top of fabric istovremeno, a kada ih ima više od stotinu, ispostavlja se da je potrebna velika radiks i na graničnim ruterima. U suštini, ovo košta novca, pošto su granični ruteri funkcionalniji, a portovi na njima će biti skuplji, što stvara ne baš lepu konstrukciju.
Druga opcija je uvoditi takav saobraćaj sa dna. Nije teško uveriti se da je Clos topologija izgrađena tako da se saobraćaj koji ulazi sa dna, odnosno sa strane ToR, ravnomerno raspodeljuje po nivoima na ceo Top of fabric u dve iteracije, opterećujući celu mrežu. Zato uvodimo poseban tip Pod, Edge Pod, koji obezbeđuje spoljašnju povezanost.
Obstaja še ena možnost. Na primer, tako deluje Facebook. To imenujejo Fabric Aggregator ali HGRID. Uveden je dodaten spine-nivoj, da poveže več podatkovnih centrov. Takšna konstrukcija je mogoča, če na stikih nimamo dodatnih funkcij ali spremembe enkapsulacije. Če so, so to dodatne touch points, kar je kompleksno. Običajno se pojavijo več funkcij in neka vrsta membrane, ki ločuje različne dele podatkovnega centra. Takšne membrane ni smiselno delati velike, in če je res potrebna, se splača razmisliti o njeni premestitvi in povečanju širine ter prenosu na gostitelje. Tako delajo na primer številni oblačni operaterji. Imajo overlays, ki se začnejo pri gostiteljih.
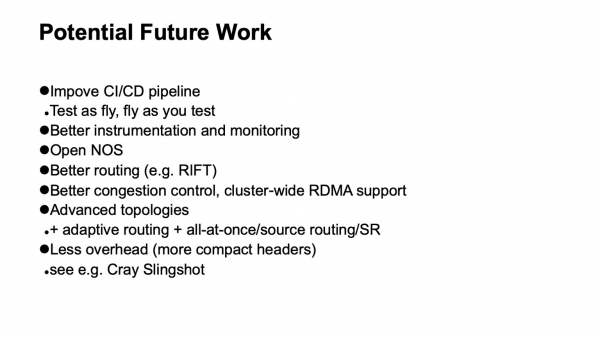
Katere možnosti razvoja vidimo? Predvsem izboljšanje podpore CI/CD pipeline-u. Želimo leteti tako, kot testiramo, in testirati tako, kot letimo. To ne gre najbolje, ker je infrastruktura velika in obnoviti je ni mogoče za teste. Treba je razumeti, kako vnesti elemente testiranja v delovno infrastrukturo, pri tem pa je ne podrasti.
Bolje instrumentiranje, boljše spremljanje skoraj nikoli ni odveč. Vsa vprašanja so v ravnotežju trudov in donosov. Če je mogoče z razumskimi sredstvi dodati — zelo dobro.
Odprti operacijski sistemi za omrežne naprave. Najboljni protokoli in najboljši usmerjevalni sistemi, na primer RIFT. Potrebna so tudi raziskovanja o uporabi najboljših shem za obvladovanje zastojev ter morda uvedba, vsaj na nekaterih točkah, podpore RDMA znotraj klasterja.
Če gledamo z daljnosežnim pogledom, so potrebne napredne topologije in morda omrežja, ki uporabljajo manjšo overhead. Iz svežih stvari — nedavno so bile objave o tehnologiji tovarn za HPC Cray Slingshot, ki temelji na komoditetnem Ethernetu, vendar z možnostjo uporabe veliko krajših naslovov. Posledično se overhead zmanjšuje.
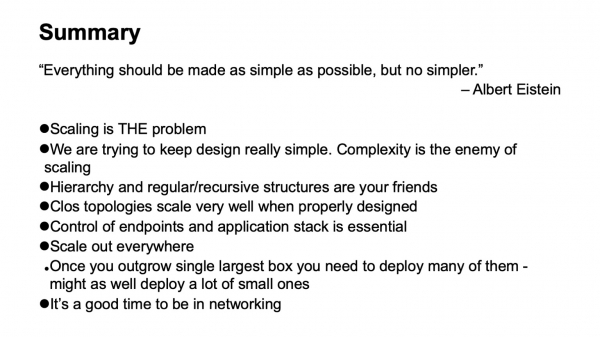
Vse je treba delati tako preprosto, kot je mogoče, a ne preprosteje. Kompleksnost je sovražnik skalabilnosti. Enostavnost in redne strukture so naši prijatelji. Če je mogoče nekje širiti — delajte to. In na splošno, zdaj je odlično ukvarjati se z omrežnimi tehnologijami. Dogaja se veliko zanimivega. Hvala.
Izvor: habr.com
