

Pozdravljeni, člani Habr. Danes se začnejo predavanja v prvi skupini tečaja. . V skladu s tem vam želimo predstaviti, kako je potekal odprti spletni seminar o tem tečaju.
V smo se pogovarjali o izzivih, s katerimi se srečujejo SQL baze v dobi oblakov in Kubernetes. Ob tem smo obravnavali, kako se SQL baze prilagajajo in mutirajo pod vplivom teh izzivov.
Spletni seminar je vodil , vodja izvedbe Googlovih rešitev v EPAM Systems.
Ko so bila drevesa majhna...
Najprej se spomnimo, kako se je začela izbira DBMS na koncu prejšnjega stoletja. Vendar to ne bo težko, saj je bila izbira DBMS v tistih časih enostavna in se je zaključevala Oracle.
Konec 90-ih in začetek 2000-ih ni dejansko ponujal posebne izbire, če govorimo o industrijskih razširljivih bazah podatkov. Da, obstajali so IBM DB2, Sybase in še nekatere druge baze podatkov, ki so se pojavljale in izginjale, a na splošno so bile manj opazne ob ozadju Oracle. Zato so bile veščine inženirjev tistega časa nekako odvisne od edine izbire, ki je bila na voljo.
Oracle DBA je moral znati:
- namestiti Oracle Server iz distribucijskega paketa;
- konfigurirati Oracle Server:
- init.ora;
- listener.ora;
— ustvarjati:
- tabele prostorov;
- sheme;
- uporabnike;
— izvajati varnostno kopiranje in obnovo;
— izvajati spremljanje;
— se boriti proti neoptimalnim poizvedbam.
Pri tem ni bilo posebej zahtevano od Oracle DBA:
- da bi znal izbrati optimalni DBMS ali druge tehnologije za shranjevanje in obdelavo podatkov;
- da bi zagotovil visoko razpoložljivost in horizontalno razširljivost (to ni vedno bila naloga DBA);
- dobro poznati predmetno področje, infrastrukturo, aplikativno arhitekturo, operacijski sistem;
- izvajanju nalaganja in nalaganja podatkov, migraciji podatkov med različnimi DBMS.
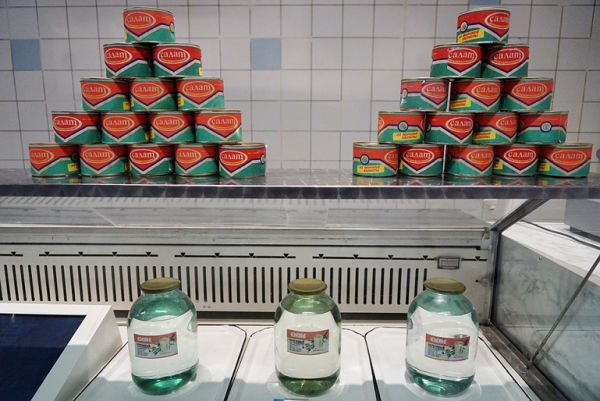
Na splošno, če govorimo o izbiri v tistih časih, je ta spominjala na izbiro v sovjetski trgovini konec 80-ih:
Naše vreme
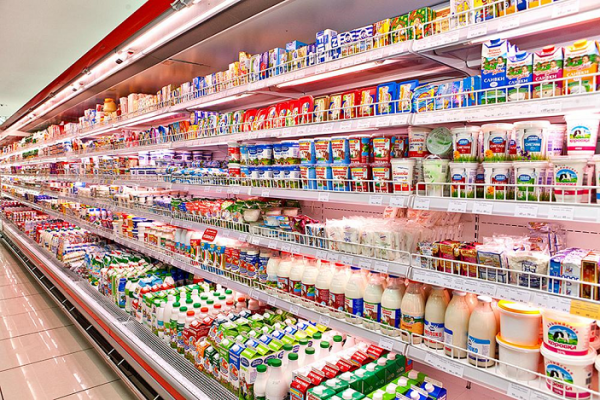
Od takrat so se seveda drevesa povečala, svet se je spremenil in sedaj je stanje takšno:
Spremeni se je tudi trg DBMS, kar je jasno razvidno iz nedavne poročila podjetja Gartner:
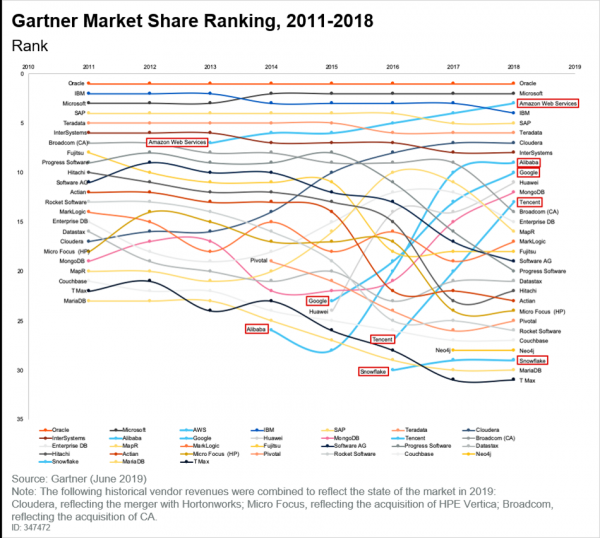
In tukaj ne moremo spregledati, da so svojo nišo zasedli oblaki, katerih priljubljenost narašča. Če preberemo isto poročilo podjetja Gartner, bomo videli naslednje zaključke:
- Mnogi naročniki so na poti k prenosi aplikacij v oblak.
- Nove tehnologije se najpre pojavljuju u oblaku, a nije sigurno da će se ikada preseliti u neoblačnu infrastrukturu.
- Model formiranja cena prema principu pay-as-you-go postao je uobičajen. Svi žele da plaćaju samo za ono što koriste, i to više nije trend, već jednostavna konstatacija.
Kaj zdaj?
Danas smo svi u oblaku. Pitanja koja se postavljaju odnose se na izbor. A izbor je ogroman, čak i kada govorimo samo o odabiru tehnologija DBMS u On-premises formatu. Pored toga, tu su i managed services i SaaS. Dakle, izbor postaje sve složeniji.
Pored pitanja izbora, postoje i ograničavajući faktori:
- cena. Mnoge tehnologije i dalje koštaju novac;
- veštine. Kada govorimo o slobodnom softveru, postavlja se pitanje veština, jer besplatan softver zahteva od ljudi koji ga implementiraju i koriste dovoljnu kompetenciju;
- funkcionalnosti. Nisu sve usluge koje su dostupne u oblaku, čak i one koje su možda zasnovane na Postgresu, opremljene istim funkcijama kao Postgres On-premises. To je suštinski faktor koji je potrebno znati i razumeti. Štaviše, ovaj faktor postaje još važniji od poznavanja nekih skrivene mogućnosti određenog DBMS-a.
Šta se sada očekuje od DA/DE:
- dobrog razumevanja tematske oblasti i primenjene arhitekture;
- sposobnosti ispravnog odabira prikladne DBMS tehnologije u skladu s postavljenim zadatkom;
- sposobnosti odabira optimalne metode implementacije odabrane tehnologije u kontekstu postojećih ograničenja;
- sposobnosti izvođenja prenosa i migracije podataka;
- sposobnosti implementacije i eksploatacije odabranih rešenja.
Sledeći primer na bazi GCP demonstrira kako izgleda izbor određene tehnologije rada s podacima u zavisnosti od njihove strukture:
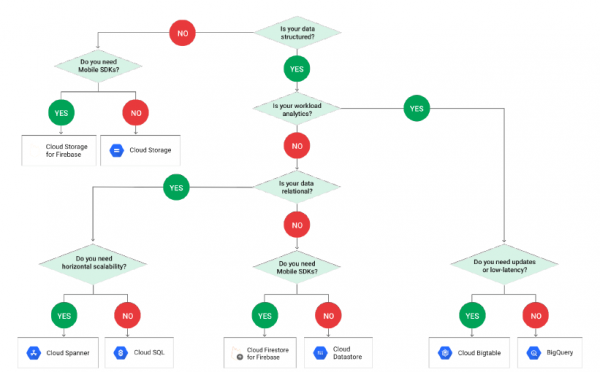
Obratite pažnju da shema ne sadrži PostgreSQL, jer se on krije iza terminologije Oblačna SQL. I kada uđemo u Cloud SQL, opet moramo doneti odluku:
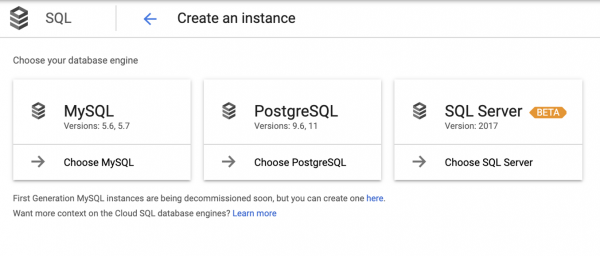
Treba napomenuti da ova odluka nije uvek jasna, pa se programeri aplikacija često vode intuicijom.
Skupaj:
- Čim dalje, to je pitanje izbora sve aktuelnije. I čak i ako se fokusiramo samo na GCP, upravljane usluge i SaaS, neki pomen RDBMS-a pojavljuje se tek na 4. koraku (a tu je i Spanner). Plus, izbor PostgreSQL-a se pojavljuje tek na 5. koraku, a pored njega su još MySQL i SQL Server, što znači da je svega mnogo, a treba izabrati.
- Ne treba zaboraviti ni na ograničenja u svetlu iskušenja. Uglavnom, svi žele Spanner, ali on je skup. Na kraju, tipični zahtev izgleda otprilike ovako: „Molimo vas da nam napravite Spanner, ali po ceni Cloud SQL-a, pa vi ste profesionalci!”
A šta raditi?
Ne pretendujući na istinu u poslednjoj instanci, recimo sledeće:
Potrebno je promeniti pristup obuci:
- učiti kao što su nekada učili DBA, nema smisla;
- znanje jednog proizvoda više nije dovoljno;
- a poznavati desetine na nivou jednog — nemoguće je.
Treba znati ne samo i ne koliko proizvod, već:
- use case njegove primene;
- različite metode implementacije;
- prednosti i nedostaci svake od metoda;
- slične i alternativne proizvode, kako bi se donela svesna i optimalna odluka, a ne uvek u korist poznatog proizvoda.
A još treba umeti migrirati podatke i razumeti osnovne principe integracije s ETL.
Stvarni slučaj
U nedavnoj prošlosti bilo je potrebno napraviti backend za mobilnu aplikaciju. U trenutku početka rada na njoj, backend je već bio razvijen i spreman za implementaciju, a tim programera je na ovom projektu proveo oko dve godine. U međuvremenu, postavljeni su sledeći zadaci:
- izgraditi CI/CD;
- napraviti reviziju arhitekture;
- pokrenuti sve to u eksploataciju.
Sama aplikacija bila je mikroservisana, a kod na Python/Django-u bio je razvijen od nule i odmah u GCP. Što se tiče ciljne publike, pretpostavljalo se da će biti dva regiona — Sjedinjene Države i EU, a saobraćaj se raspoređivao putem Global Load balancera. Svi Workloads i računska opterećenja radila su u Google Kubernetes Engine.
Što se tiče podataka, postojale su 3 strukture:
- Cloud Storage;
- Datastore;
- Cloud SQL (PostgreSQL).
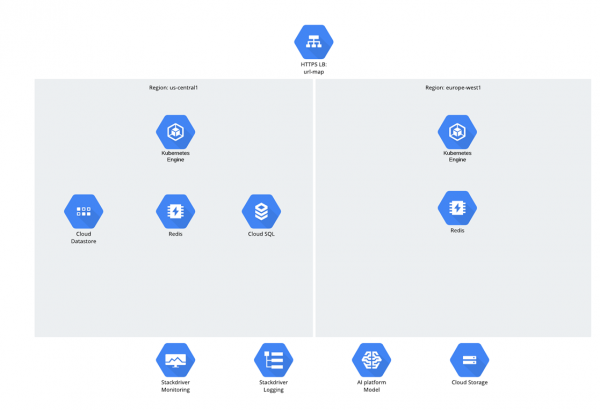
Može se postaviti pitanje zašto je izabran Cloud SQL? Iskreno, takvo pitanje u poslednjim godinama izaziva neku neprijatnu pauzu — stiče se utisak da su ljudi počeli da se stide relacijskih baza, ali, uprkos svemu, i dalje ih aktivno koriste ;-).
Što se tiče našeg slučaja, Cloud SQL je izabran iz sledećih razloga:
- Kot je bilo omenjeno, je bila aplikacija razvita s pomočjo Django, v kateri je model za prikaz stalnih podatkov iz SQL baze v Python objektih (Django ORM).
- Sami okvirji so podpirali precej omejen seznam DBMS:
- PostgreSQL;
- MariaDB;
- MySQL;
- Oracle;
- SQLite.
Zato smo PostgreSQL izbrali iz tega seznama bolj intuitivno (saj ne bomo izbrali Oracle, res je).
Česar je manjkalo:
- aplikacija je bila nameščena le v dveh regijah, tretja v načrtu pa je bila Azija;
- Baza podatkov se je nahajala v severnoameriški regiji (Iowa);
- stranka je imela pomisleke glede morebitnih zakasnitev pri dostopu iz Evrope in Azije ter motenj v storitvah v primeru izpada DBMS.
Čeprav lahko sam Django deluje z več DB hkrati in jih deli glede na branje in pisanje, v aplikaciji ni bilo toliko zapisov (več kot 90 % — branje). Na splošno, če bi bilo mogoče ustvariti read-repliko glavne baze v Evropi in Aziji, bi to bila kompromisna rešitev. Kaj je tukaj zapletenega?
Zahtevnost je bila v tem, da stranka ni želela odstopiti od uporabe upravljanih storitev in Cloud SQL. Zmožnosti Cloud SQL so trenutno omejene. Cloud SQL podpira visoko razpoložljivost (HA) in read repliko (RR), toda RR se podpira le v eni regiji. Ustvarjanje DB v ameriški regiji ne omogoča ustvarjanja read-replike v evropski regiji s sredstvi Cloud SQL, čeprav sam PostgreSQL to dovoljuje. Dopisovanje z zaposlenimi Googlea ni prineslo rezultatov in se je končalo z obljubami v slogu: "poznamo težavo in delamo na njej, vprašanji bosta nekoč rešena."
Če na kratko naštejem možnosti Cloud SQL, bo to videti približno tako:
1. Visoka razpoložljivost (HA):
- v okviru ene regije;
- s pomočjo replikacije diskov;
- se mehanizmi PostgreSQL ne uporabljajo;
- možno je avtomatsko in ročno upravljanje — failover/failback;
- med preklopom DBMS ni dostopna nekaj minut.
2. Read Replica (RR):
- v okviru ene regije;
- hot standby;
- PostgreSQL streaming replication.
Poleg tega, kot je običajno, pri izbiri tehnologije vedno naletiš na kakšne omejitve,:
- stranka ni želela množiti entitet in uporabljati IaaS, razen preko GKE;
- stranka ne bi želela namestiti self service PostgreSQL/MySQL;
- In general, Google Spanner would be quite suitable if it weren't for its price. However, Django ORM cannot work with it; otherwise, it's a good tool.
Considering the situation, we received a tricky question from the client: “Can you create something similar so that it works like Google Spanner but also with Django ORM?”
Solution Option #0
The first thought that came to mind was:
- to stay within the confines of CloudSQL;
- there won't be internal replication between regions in any form;
- to try to connect a replica to the existing Cloud SQL by PostgreSQL;
- somewhere and somehow to launch a PostgreSQL instance, but at least not to touch the master.
Unfortunately, it turned out that this couldn't be done because there is no access to the host (it is generally in another project) — pg_hba and so on, and there is also no superuser access.
Solution Option #1
After further reflection and taking previous circumstances into account, the thought process changed somewhat:
- we are still trying to stay within the confines of CloudSQL, but we transition to MySQL, as Cloud SQL by MySQL has an external master which:
— acts as a proxy for the external MySQL;
— appears as a MySQL instance;
— is designed for migrating data from other clouds or on-premises.
Since setting up MySQL replication doesn't require access to the host, everything basically worked, but it was very unstable and inconvenient. And as we pushed further, it became downright scary because we were deploying the entire structure with Terraform, and suddenly it turned out that the external master is not supported by Terraform. Yes, Google has a CLI, but for some reason, everything worked intermittently — sometimes it creates, sometimes it doesn't. Perhaps because the CLI was designed for migrating data externally, not for replicas.
In fact, it became clear that Cloud SQL is absolutely unsuitable. As they say, we did everything we could.
Solution Option #2
Since staying within Cloud SQL didn't work out, we tried to formulate the requirements for a compromise solution. The requirements turned out to be as follows:
- operating in Kubernetes with maximum utilization of resources and capabilities of Kubernetes (DCS, …) and GCP (LB, …);
- absence of ballast from a bunch of unnecessary cloud things like HA proxy;
- the ability to run HA PostgreSQL or MySQL in the main region; in other regions — HA from the main region RR plus its copy (for reliability);
- multi-master (we didn't want to connect to it, but it wasn't very critical)
.
As a result of these requirements, a solution finally appeared on the horizon.primerne možnosti DBMS in vmesnega sloja:
- MySQL Galera;
- CockroachDB;
- Orodja PostgreSQL
:
— pgpool-II;
— Patroni.
MySQL Galera
Tehnologija MySQL Galera je bila razvita s strani podjetja Codership in predstavlja vtičnik za InnoDB. Značilnosti:
- multi master;
- sinhrona replikacija;
- branje z vsakega vozlišča;
- zapisi na katerem koli vozlišču;
- vgrajen mehanizem HA;
- obstaja Helm chart od Bitnami.
CockroachDB
Po opisu je stvar popolnoma neverjetna in predstavlja open source projekt, napisan v Go. Glavni udeleženec je Cockroach Labs (ustanovljena s strani nekdanjih zaposlenih pri Googlu). Ta relacijska DBMS je bila sprva zasnovana kot distributivna (s horizontalno skalabilnostjo »iz škatle«) in odporna na napake. Njeni avtorji so si zadali cilj »združiti bogastvo SQL funkcionalnosti z horizontalno dostopnostjo, značilno za rešitve NoSQL«.
Kot prijeten dodatek — podpora za postgresni protokol povezovanja.
Pgpool
To je nadgradnja nad PostgreSQL, v resnici nova entiteta, ki prevzema vse povezave in jih obdeluje. Ima svoj balansirnik obremenitve in parser, licencira se po BSD licenci. Ponuja široke možnosti, vendar izgleda nekoliko zastrašujoče, ker je nova entiteta lahko vir nekaterih dodatnih dogodivščin.
Patroni
To je zadnji pogled, ki sva ga ujela in, kot se je izkazalo, ni bilo zaman. Patroni je open source orodje, ki v bistvu predstavlja demon na Pythonu, ki omogoča avtomatsko upravljanje PostgreSQL grozdov z različnimi vrstami replikacije in samodejnim preklapljanjem vlog. Zadeva se je izkazala za zelo zanimivo, saj se dobro integrira s Kubernetesom in ne prinaša nobenih novih entitet.
Kaj smo na koncu izbrali
Izbira ni bila enostavna:
- CockroachDB — ognjeno, a skrb vzbujajoče;
- MySQL Galera — tudi kar dobra, uporablja se na mnogih mestih, a MySQL;
- Pgpool — preveč nepotrebnih entitet, slaba integracija z oblakom in K8s;
- Patroni — odlična integracija z K8s, brez nepotrebnih entitet, dobro se integrira z GCP LB.
Tako je izbira padla na Patroni.
Zaključki
Prišel je čas za kratke zaključke. Da, svet IT infrastrukture se je bistveno spremenil in to je šele začetek. Če so bili prej oblaki le drug tip infrastrukture, je zdaj vse drugače. Poleg tega se inovacije v oblakih nenehno pojavljajo, še naprej se bodo pojavljale in morda se bodo pojavljale le v oblakih in šele nato, s pomočjo start-upov, se bodo prenašale v On-premises.
Kar se tiče SQL, SQL bo še naprej živel. To pomeni, da se je treba naučiti PostgreSQL in MySQL ter z njimi znati delati, še bolj pomembno pa je, kako jih pravilno uporabljati.
Izvor: habr.com
