

Pravijo, da je vse v življenju vredno poskusiti vsaj enkrat. In če ste navajeni delati z relacijskimi podatkovnimi bazami, je spoznavanje NoSQL v praksi vredno, predvsem zaradi splošne kulture. Sedaj, ob hitrem razvoju te tehnologije, obstaja veliko nasprotujočih si mnenj in vročih razprav na to temo, kar še dodatno povečuje zanimanje.
Če se poglobimo v bistvo vseh teh razprav, lahko opazimo, da nastajajo zaradi napačnega pristopa. Tisti, ki uporabljajo NoSQL baze ravno tam, kjer so potrebne, so zadovoljni in izkoristijo vse prednosti te rešitve. Eksperimentatorji, ki se zanašajo na to tehnologijo kot na rešitev za vse težave v situacijah, kjer ni primerna, doživljajo razočaranje, saj izgubijo močne strani relacijskih baz brez pridobivanja pomembnih koristi.
Povedal bom o našem izkustvu pri uvajanju rešitve, ki temelji na podatkovni bazi Cassandra: s čim smo se srečali, kako smo se znašli v težkih situacijah, ali smo uspeli pridobiti podporo od uporabe NoSQL in kje smo morali vložiti dodatne napore/sredstva.
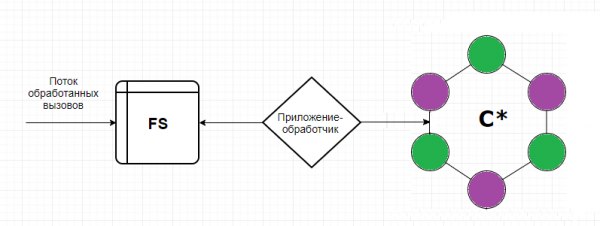
Izhodiščna naloga je bila zgraditi sistem, ki beleži klice v neko shrambo.
Načelo delovanja sistema je naslednje. Na vhod prihajajo datoteke z določenimi strukturami, ki opisujejo potek klica. Nato aplikacija zagotavlja shranjevanje te strukture v ustrezne stolpce. V nadaljevanju se shranjeni klici uporabljajo za prikaz informacij o porabi prometa za naročnike (obračuni, klici, zgodovina stanja).
Zakaj smo izbrali Cassandro, je povsem razumljivo — piše kot mitraljez, enostavno se skalira, je odporna na napake.
Torej, to je, kar nam je prineslo izkušnje.
Da, izpadla vozlišča ni tragedija. V tem je bistvo odpornosti Cassandre. Ampak vozlišče je lahko aktivno in hkrati začne znižovati svojo učinkovitost.. Kot se je izkazalo, to takoj vpliva na učinkovitost celotnega skladišča.
Cassandra ne zaščiti tam, kjer je Oracle rešil s svojimi omejitvami.. In če avtor aplikacije tega vnaprej ni razumel, je prišel podvojeni vnos za Cassandro enako sprejemljiv kot izvirnik. Ko pride, ga vstavimo.
Brezplačna Cassandra 'iz škatle' ni bila posebej dobro sprejeta s strani varnostnih strokovnjakov: ni beleženja dejanj uporabnikov, pravice dostopa niso razmejene.. Informacije o pozivima se odnose na lične podatke, što znači da sve pokušaje da ih zatražimo ili promenimo, treba evidentirati s mogućnošću kasnijeg audita. Takođe, treba biti svestan potrebe da se prava razdvoje na različite nivoe za različite korisnike. Obični inženjer operacija i superadmin, koji slobodno može da obriše čitav keyspace – to su različite uloge, različita odgovornost, kompetencije. Bez takvog razdvajanja prava pristupa, vrednost i celovitost podataka brzo će biti dovedena u pitanje, brže nego kod nivoa konzistentnosti ANY.
Nismo uzeli u obzir da su potrebne ozbiljne analize poziva, kao i periodične probe pod raznim uslovima. Kako se izabrani zapisi kasnije planiraju da se brišu i ponovo pišu (u okviru zadatka moramo podržati proces ažuriranja podataka kada su izvorno netačno stigli u naš sistem), Cassandra nam ovde nije prijatelj. Cassandra, kao pohranitelj – zgodno je tu ostaviti, ali se ne može lako računati.
Susreli smo se s problemom prenosa podataka u testne zone. (5 čvorova u testu naspram 20 u produkciji). Dump u ovom slučaju neće biti moguć.
Problem ažuriranja sheme podataka aplikacije koja zapisuje u Cassandru. Povratak će stvoriti mnoge nadgrobne spomenike, što može nepredvidivo da utiče na performanse.. Cassandra je optimizovana za zapisivanje i pre nego što zapisuje, ne razmišlja previše. Svaka operacija s postojećim podacima u njoj je takođe zapisivanje. Tj. brišući suvišne, samo ćemo stvoriti još više zapisa, i samo će deo njih biti označen nadgrobnim spomenicima.
Timeout-i prilikom umetanja. Cassandra je odlična u zapisivanju, ali ponekad ulazni tok može značajno da je zbuni.. To se dešava kada aplikacija počne da kruži oko nekoliko zapisa koje ne može da umetne iz nekog razloga. I trebat će nam pravi DBA koji će nadgledati gc.log, system i debug logove radi sporih upita, metrike o compaction pending.
Nekoliko data centara u klasteru. Odakle čitati i gde pisati?
Je mogoče ločiti branje in pisanje? In če ja, mora biti DC za pisanje ali branje bliže aplikaciji? In ali lahko pridemo do pravega split brain, če napačno izberemo raven doslednosti? Veliko vprašanj, veliko neodkritih nastavitev, možnosti, ki bi jih radi preizkusili.
Kako smo se odločili
Da node ne bi padal, smo onemogočili SWAP. In zdaj, ko zmanjka pomnilnika, naj bi se node sesedel, ne pa da bi povzročal dolge gc premore.
Torej, na logiko v bazi podatkov se več ne zanašamo. Razvijalci aplikacije se ponovno učijo in začnejo aktivno zaščititi svoj kodo. Popolna, jasna ločitev shranjevanja in obdelave podatkov.
Kupili smo podporo od DataStax. Škatlasta Cassandra se je prenehala razvijati (zadnji commit februarja 2018). Hkrati pa Datastax ponuja odlično storitev in veliko število izboljšanih in prilagojenih rešitev za obstoječe IS.
Še želim opozoriti, da Cassandra ni najboljša za poizvedbe za izbiro. Seveda, CQL je velik korak naproti uporabnikom (v primerjavi s Trift). Ampak, če imate cele oddelke, ki so navajeni na tako priročne povezave, svobodno filtriranje po katerem koli polju in možnosti optimizacije poizvedbe, in ti oddelki delajo na tem, da bi zaprli pritožbe in nezgode, potem rešitev na Cassandri zanje izgleda sovražna in glupa. In začeli smo reševati vprašanje, kako naj naši kolegi izvajajo izbire.
Raziskovali smo dve možnosti. V prvi možnosti pišemo klice ne samo v C*, temveč tudi v arhivsko bazo podatkov Oracle. V nasprotju z C* se v tej bazi podatkov hrani le klice za trenutni mesec (kar je dovolj globoko za primere pretarifikacije). Takoj pa se je pojavila naslednja težava: če pišemo sinhrono, izgubimo vse prednosti C*, povezane s hitro vstavitvijo; če pa asinhrono – ni zagotovila, da so vsi potrebni klici sploh prišli v Oracle. Edina prednost, a zelo velika, je ta, da za obratovanje ostaja enak znani PL/SQL Developer, torej praktično uresničujemo vzorec „Fasada“. Alternativna možnost. Uresničimo mehanizem, ki izvozi klice iz C*, potegne določene podatke za obogatitev iz ustreznih tabel v Oracle, povezuje pridobljene izbrane podatke in nam izda rezultat, ki ga nato nekako uporabimo (vrnemo, ponovimo, analiziramo, občudujemo). Slabosti: postopek je precej večstadijski, poleg tega pa ni vmesnika za zaposlene v obratovanju.
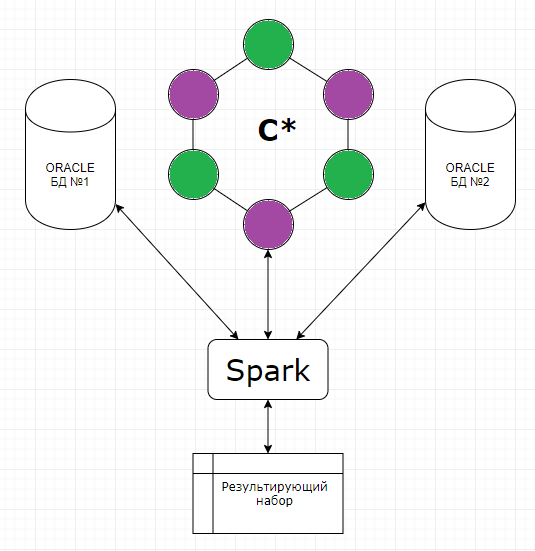
Na koncu smo se vendarle odločili za drugo možnost. Za poizvedbe iz različnih bank smo uporabili Apache Spark. Bistvo mehanizma je bilo v Java kodi, ki na podlagi navedenih ključev (abonent, čas klica – ključi razdelka) pridobiva podatke iz C* ter potrebne podatke za obogatitev iz katere koli druge baze podatkov. Nato jih poveže v svoji pomnilniku in izpiše rezultat v rezultate tabelo. Nad Sparkom smo narisali spletno vmesnik in tako je postalo povsem uporabno za obratovanje.
При решении задачи по обновлению данных пром-тест снова рассматривались несколько способов решения. Как перенос через Sstloader, так и вариант с разбиением кластера в тестовой зоне на две части, каждая из которых поочередно соединяется с одним кластером с промовским, получая таким образом питание от него. При обновлении теста планировалось менять их местами: та часть, которая работала в тесте, очищается и вводится в пром, а другая начинает работать с данными отдельно. Однако, рассмотрев ещё раз, мы более рационально оценили те данные, которые стоит переносить, и поняли, что сами по себе вызовы – это неконсистентная сущность для тестов, быстро генерируемая в случае необходимости, и именно промовский набор данных не имеет ценности для переноса в тест. Есть несколько объектов-накопителей, которые стоит переносить, но это буквально пара таблиц, причем, не сильно тяжелых. Поэтому нам в качестве решения снова пришел на помощь Spark, с помощью которого мы написали и стали активно использовать скрипт переноса данных между таблицами пром-тест.
Наша текущая политика деплоя позволяет нам работать без откатов. Перед промом происходит обязательный накат на тест, где ошибка не так дорога. В случае неудачи всегда можно дропнуть кейспейс и накатить всю схему с начала.
Для обеспечения непрерывной доступности Кассандры нужен дба и не только он. Все, кто работает с приложением, должны понимать, где и как смотреть текущую ситуацию и как своевременно диагностировать проблемы. Для этого мы активно используем DataStax OpsCenter (Администрирование и мониторинг рабочих нагрузок), системные метрики Cassandra Driver (количество таймаутов на запись в C*, количество таймаутов на чтение из C*, максимальная latency и т. д.), мониторим работу самого приложения, работающего с Кассандрой.
Ko smo razmišljali o prejšnjem vprašanju, smo spoznali, kje se lahko skriva naš glavni rizik. To so oblike prikaza podatkov, ki pridobivajo podatke iz več neodvisnih poizvedb v skladišču. Tako lahko pridobimo precej neskladne informacije. Vendar bi bil ta problem prav tako aktualen, tudi če bi delali samo z enim podatkovnim centrom. Tako da je najbolj smiselno, da naredimo batch funkcijo za branje podatkov v zunanji aplikaciji, ki zagotavlja, da pridobimo podatke v istem časovnem obdobju. Kar zadeva ločevanje med branjem in pisanjem z vidika zmogljivosti, nas je tu ustavil rizik, da bi ob morebitnem izgubljanju povezave med DC-ji lahko pridobili dva popolnoma neskladna klasterja.
Na koncu, v tem trenutku smo se odločili za raven skladnosti pri pisanju EACH_QUORUM in za branje LOCAL_QUORUM.
Kratki vtisi in zaključki
Da bi ocenili doseženo rešitev z vidika operativne podpore in potencialov nadaljnjega razvoja, smo se odločili razmisliti, kje drugje bi lahko uporabili tovrstni razvoj.
Če na hitro, potem ocenjevanje podatkov za programe tipa "Plačaj, ko ti ustreza" (naložimo v S* informacije, izračun na skriptah Spark), obravnavanje reklamacij z agregacijo po smereh, shranjevanje vlog in izračun po vlogi matrice dostopnih pravic uporabnikov.
Kot vidimo, je repertoar širok in raznolik. In če bi se morali opredeliti med podporniki in nasprotniki NoSQL, bi se pridružili podpornikom, saj smo pridobili svoje prednosti, in prav tam, kjer smo jih pričakovali.
Tudi različica Cassandre iz škatle omogoča horizontalno skaliranje v realnem času, brez bolečin reševanja vprašanja povečanja podatkov v sistemu. Uspešno smo izvedli zelo obremenitven mehanizem za izračun agregatov po klicih, ter ločili shemo in logiko aplikacije, in se znebili slabe prakse pisanja prilagojenih opravil in objektov v sami BAZI PODATKOV. Dobili smo možnost, da izberemo in nastavimo, za pospešitev, na katerih DC-jih bomo izvajali izračun, in na katerih zapisovanje podatkov, ter se zavarovali pred padci posameznih nod in celotnega DC-ja.
Ko novim projektima uporabljamo našo arhitekturo, pri čemer si želimo, da bi že z nekaterimi izkušnjami takoj upoštevali zgoraj opisane podrobnosti in preprečili nekatere napake ter omilili nekatere ostre kote, katerih se sprva nismo mogli izogniti.
Na primer, pravočasno spremljati posodobitve same Kassandra, ker je bilo kar nekaj težav, ki smo jih imeli, že znanih in popravljenih.
Ne namestiti tako baze podatkov kot Sparka na iste node (ali strogo ločiti glede na dovoljeno porabo virov), saj lahko Spark porabi več RAM-a, kot je predvideno, in hitro bomo naleteli na težavo številka 1 z našega seznama.
Izboljšati nadzor in znanje o obratovanju že v fazi testiranja projekta. Prvotno upoštevati čim več potencialnih uporabnikov naše rešitve, ker bo od tega na koncu odvisna struktura baze podatkov.
Večkrat pregledati prejeto shemo z vidika potencialne optimizacije. Določiti, katera polja je mogoče serializirati. Razumeti, katere dodatne tabele moramo ustvariti, da bi čim bolj pravilno in optimalno upoštevali in nato posredovali zahtevane informacije (na primer, ob upoštevanju, da iste podatke lahko shranjujemo v več tabelah, ob upoštevanju različnih razdelitev po različnih kriterijih, lahko znatno prihranimo procesorski čas pri poizvedbah za branje).
Ni slabo takoj predvideti namestitev TTL in čiščenje zastarelih podatkov.
Pri izvozu podatkov iz Kassandra logika aplikacije mora delovati po načelu FETCH, da se ne naložijo vse vrstice v pomnilnik naenkrat, ampak se izbirajo po paketih.
Želeno je pred prenosom projekta na opisano rešitev preveriti odpornost sistema, s serijo crash testov, kot so izguba podatkov v enem podatkovnem centru, obnova poškodovanih podatkov v nekem obdobju, padci omrežja med podatkovnimi centri. Takšni testi ne samo, da omogočajo oceno prednosti in slabosti predlagane arhitekture, temveč tudi dajo dobro ogrevalno prakso inženirjem, ki jih izvajajo, pridobljena veščina pa ne bo odveč, če se bodo napake sistema ponovile v praksi.
če se ukvarjamo s kritičnimi informacijami (kot so podatki za obračunavanje, izračun dolgov naročnikov), je pomembno, da posvetimo pozornost orodjem, ki omogočajo zmanjšanje tveganj, ki izhajajo iz značilnosti SGBD. Na primer, uporabite orodje nodesync (Datastax) in razvijte optimalno strategijo njegove uporabe, da za zagotovitev doslednosti ne ustvarimo prekomernega obremenitve na Cassandri in jo uporabljamo samo za določene tabele v določenem obdobju.
No, po šestih mesecih življenja s Cassandro? Na splošno ni nerešenih težav. Tudi resnih napak in izgube podatkov nismo dopustili. Da, morali smo razmisliti o kompenzaciji nekaterih težav, ki prej niso nastale, vendar to na koncu ni bistveno vplivalo na našo arhitekturno rešitev. Če želite in se ne bojite preizkusiti nekaj novega, hkrati pa se ne želite preveč razočarati, se pripravite na to, da brezplačno ni nič. Raziskovati, preučevati dokumentacijo in zbirati svoje individualne izkušnje bo treba več kot v stari dediščini, in nobena teorija ne more vnaprej povedati, katere izkušnje čakajo prav vas.
Izvor: habr.com
