

Rad bi opisal zanimiv mehanizem dela s konfiguracijo razdeljene sistem. Konfiguracija je predstavljena neposredno v kompiliranem jeziku (Scala) z uporabo varnih tipov. V tem prispevku je obravnavan primer take konfiguracije in različni vidiki uvajanja kompilirane konfiguracije v celoten proces razvoja.
()
Uvod
Zgraditi zanesljiv razdeljen sistem pomeni, da mora biti na vseh vozliščih pravilna konfiguracija, sinhronizirana z drugimi vozlišči. Običajno se uporabljajo DevOps tehnologije (terraform, ansible ali kaj podobnega) za samodejno generacijo konfiguracijskih datotek (pogosto svojstvenih za vsako vozlišče). Prav tako bi želeli biti prepričani, da na vseh interakcijskih vozliščih uporabljamo identične protokole (vključno z enako različico). V nasprotnem primeru bo v našem razdeljenem sistemu prisotna neskladnost. V svetu JVM je eden od posledic tega zahtevka potreba po uporabi iste različice knjižnice, ki vsebuje sporočila protokola povsod.
Kaj pa testiranje razdeljenega sistema? Seveda predpostavljamo, da so za vse komponente zagotovljeni enotni testi, preden preidemo na integracijsko testiranje. (Da bi lahko ekstrapolirali rezultate testiranja na runtime, moramo zagotoviti tudi identičen nabor knjižnic v fazi testiranja in v runtime.)
Pri delu z integracijskimi testi je pogosto lažje uporabljati enoten classpath na vseh vozliščih. Samo poskrbeti moramo, da bo isti classpath uporabljen tudi v runtime. (Čeprav je povsem možno zagnati različna vozlišča z različnimi classpathi, to vodi v zapletenost celotne konfiguracije in težave z uvajanjem ter integracijskimi testi.) V okviru tega prispevka izhajamo iz predpostavke, da bo na vseh vozliščih uporabljen enak classpath.
Konfiguracija se razvija zajedno s aplikacijom. Za identifikaciju različitih faza evolucije softvera koristimo verzije. Očigledno je logično identifikovati i različite verzije konfiguracija. A samu konfiguraciju smjestiti u sustav kontrole verzija. Ako u produkciji postoji jedinstvena konfiguracija, možemo koristiti jednostavno broj verzije. Ako se koriste brojne instancije produkcije, trebat će nam nekoliko
grana konfiguracije i dodatna oznaka osim verzije (na primjer, naziv grane). Na taj način možemo jednoznačno identificirati tačnu konfiguraciju. Svaki identifikator konfiguracije jednoznačno odgovara određenoj kombinaciji distribuiranih čvorova, portova, vanjskih resursa, verzija biblioteka. U okviru ovog posta polazimo od pretpostavke da postoji samo jedna grana, i možemo identifikovati konfiguraciju na uobičajen način koristeći tri broja odvojena tačkom (1.2.3).
U savremenim okruženjima konfiguracione datoteke se ručno kreiraju prilično rijetko. Česće se generiraju tokom implementacije i više se ne dodiruju (da ). Postavlja se logičan pitanje, zašto i dalje koristimo tekstualni format za pohranu konfiguracije? Sasvim održiva alternativa izgleda opcija korištenja običnog koda za konfiguraciju i dobijanje prednosti kroz provjere tokom kompilacije.
U ovom postu istražujemo ideju predstavljanja konfiguracije unutar kompiliranog artefakta.
Kompilirana konfiguracija
U ovom odjeljku prikazan je primjer statične kompilirane konfiguracije. Realizovana su dva jednostavna servisa — echo servis i klijent echo servisa. Na osnovu ova dva servisa prikupljena su dva varijante sistema. U jednoj varijanti oba servisa se nalaze na jednom čvoru, dok su u drugoj varijanti — na različitim čvorovima.
Obično distribuirani sistem sadržava nekoliko čvorova. Čvorovi se mogu identifikovati pomoću vrijednosti nekog tipa NodeId:
sealed trait NodeId
case object Backend extends NodeId
case object Frontend extends NodeId
ili
case class NodeId(hostName: String)ali celo
object Singleton
type NodeId = Singleton.type
Čvorovi igraju različite uloge, na njima su pokrenuti servisi i između njih mogu biti uspostavljene TCP/HTTP veze.
Za opis TCP povezave potrebujemo vsaj številko vrat. Radi bi tudi odražali protokol, ki ga podpira to vrata, da zagotovimo, da tako stranka kot strežnik uporabljata isti protokol. Opisovali bomo povezavo s pomočjo takega razreda:
case class TcpEndPoint[Protocol](node: NodeId, port: Port[Protocol])kjer Priključek — preprosta cela številka Int z navedbo dovoljene vrednosti:
type PortNumber = Refined[Int, Closed[_0, W.`65535`.T]]Določeni tipi
Glej knjižnico in . Na kratko, knjižnica omogoča dodajanje omejitev tipom, ki se preverjajo v času prevajanja. V tem primeru so dovoljene vrednosti številke vrat cela 16-bitna števila. Za prevedeno konfiguracijo uporaba razreda refined ni obvezna, vendar izboljšuje zmožnosti prevajalnika za preverjanje konfiguracije.
Za protokole HTTP (REST) poleg številke vrat potrebujemo tudi pot do storitve:
type UrlPathPrefix = Refined[String, MatchesRegex[W.`"[a-zA-Z_0-9\/]*"`.T]]
case class PortWithPrefix[Protocol](portNumber: PortNumber, pathPrefix: UrlPathPrefix)
Fantomski tipi
Za identifikacijo protokola v času prevajanja uporabljamo parameter tipa, ki se ne uporablja znotraj razreda. Ta rešitev je povezana s tem, da pri izvajanju ne uporabljamo primerka protokola, vendar želimo, da prevajalnik preveri združljivost protokolov. Z navedbo protokola ne moremo prenesti neustrezne storitve kot odvisnosti.
Eden od pogostih protokolov je REST API z Json-serializacijo:
sealed trait JsonHttpRestProtocol[RequestMessage, ResponseMessage]kjer RequestMessage — tip zahtevka, ResponseMessage — tip odgovora.
Seveda lahko uporabimo tudi druge opise protokolov, ki zagotavljajo potrebno natančnost opisa.
Za potrebe tega zapisa bomo uporabili poenostavljeno različico protokola:
sealed trait SimpleHttpGetRest[RequestMessage, ResponseMessage]Tukaj zahteva predstavlja niz, dodan k url, odgovor pa je vrnjeni niz v telesu HTTP odgovora.
Konfiguracija storitve je opisana z imenom storitve, vrati in odvisnostmi. Te elemente lahko predstavimo v Scali na več načinov (na primer, HList-i, algebrične podatkovne tipe). Za potrebe tega zapisa bomo uporabili Cake Pattern in predstavili module s pomočjo trait‘ov. (Cake Pattern ni obvezni del opisane metode. To je le ena od možnih implementacij.)
Odvisnosti med storitvami lahko predstavimo v obliki metod, ki vračajo vrati EndPoint‘e drugih vozlišč:
  type EchoProtocol[A] = SimpleHttpGetRest[A, A]

  trait EchoConfig[A] extends ServiceConfig {
    def portNumber: PortNumber = 8081
    def echoPort: PortWithPrefix[EchoProtocol[A]] = PortWithPrefix[EchoProtocol[A]](portNumber, "echo")
    def echoService: HttpSimpleGetEndPoint[NodeId, EchoProtocol[A]] = providedSimpleService(echoPort)
  }
Za ustvarjanje echo storitve potrebujemo le številko vrat in določitev, da ta vrata podpirajo echo protokol. Lahko tudi ne bi navedli določenih vrat, saj trait-i omogočajo razglašanje metod brez implementacije (abstraktne metode). V tem primeru bi ob ustvarjanju konkretne konfiguracije prevajalec od nas zahteval, da zagotovimo implementacijo abstraktne metode in navedemo številko vrat. Ker smo metodo implementirali, ob ustvarjanju konkretne konfiguracije ne potrebujemo navajati drugih vrat. Uporabljena bo privzeta vrednost.
V konfiguraciji odjemalca razglašamo odvisnost od echo storitve:
  trait EchoClientConfig[A] {
    def testMessage: String = "test"
    def pollInterval: FiniteDuration
    def echoServiceDependency: HttpSimpleGetEndPoint[_, EchoProtocol[A]]
  }
Odvisnost ima enako vrsto kot izvožena storitev echoService. Še posebej, v echo odjemalcu zahtevamo isti protokol. Zato, ko povežemo dve storitvi, lahko z gotovostjo trdimo, da bo vse delovalo pravilno.
Implementacija storitev
Za zagon in zaustavitev storitve potrebujemo funkcijo. (Možnost ustavitve storitve je kritično pomembna za testiranje.) Spet imamo več možnosti za implementacijo take funkcije (na primer, lahko uporabimo razrede tipov na podlagi tipa konfiguracije). V ta namen bomo uporabili Cake Pattern. Storitev bomo predstavljali s pomočjo razreda cats.Resource, saj ta razred že predvideva sredstva za varno in zanesljivo osvoboditev virov v primeru težav. Za pridobitev vira moramo zagotoviti konfiguracijo in pripravljen runtime kontekst. Funkcija za zagon storitve ima lahko naslednjo obliko:
  type ResourceReader[F[_], Config, A] = Reader[Config, Resource[F, A]]

  trait ServiceImpl[F[_]] {
    type Config
    def resource(
      implicit
      resolver: AddressResolver[F],
      timer: Timer[F],
      contextShift: ContextShift[F],
      ec: ExecutionContext,
      applicative: Applicative[F]
    ): ResourceReader[F, Config, Unit]
  }
kjer
Konfiguracija— tip konfiguracije za to storitevAddressResolver— objekt obratnega časa, ki omogoča poznavanje naslovov drugih vozlišč (glej nadalje)
in druge vrste iz knjižnice cats:
F[_]— tip učinka (v najpreprostejšem primeruF[A]je lahko preprosto funkcija() => A. V tem prispevku bomo uporabljalicats.IO.)Reader[A,B]— bolj ali manj sinonim za funkcijoA => Bcats.Resource— vir, ki ga je mogoče pridobiti in osvoboditiTimer— timer (omogoča spanje za določeno obdobje in merjenje časovnih intervalov)ContextShift— analogExecutionContextApplicative— razred tipa učinka, ki omogoča združevanje posameznih učinkov (skoraj monada). V bolj zapletenih aplikacijah je verjetno bolje uporabitiMonad/ConcurrentEffect.
Z uporabo te podpisa funkcije lahko implementiramo več storitev. Na primer, storitev, ki ne naredi ničesar:
  trait ZeroServiceImpl[F[_]] extends ServiceImpl[F] {
    type Config  Resource.pure[F, Unit](()))
  }
(Glej. , v katerem so implementirane druge storitve — ,
in .)
Nod predstavlja objekt, ki lahko zažene več storitev (zagon verige virov je omogočen s Cake Patternom):
object SingleNodeImpl extends ZeroServiceImpl[IO]
  with EchoServiceService
  with EchoClientService
  with FiniteDurationLifecycleServiceImpl
{
  type Config = EchoConfig[String] with EchoClientConfig[String] with FiniteDurationLifecycleConfig
}
Upoštevajte, da natančno navedemo tip konfiguracije, ki je potrebna za ta nod. Če pozabimo navesti katerikoli od tipov konfiguracije, ki jih zahteva posamezna storitev, bo prišlo do napake pri prevajanju. Prav tako ne bomo mogli zagnati noda, če ne bomo zagotovili objekte, ki imajo ustrezen tip z vsemi potrebnimi podatki.
Določanje imen nodov
Za povezovanje z oddaljenim nodom potrebujemo dejanski IP naslov. Možno je, da bo naslov znan kasneje kot ostali deli konfiguracije. Zato potrebujemo funkcijo, ki preslika identifikator noda v naslov:
case class NodeAddress[NodeId](host: Uri.Host)
trait AddressResolver[F[_]] {
  def resolve[NodeId](nodeId: NodeId): F[NodeAddress[NodeId]]
}
Obstaja več načinov za implementacijo take funkcije:
- Če so nam naslovi znani pred namestitvijo, lahko generiramo Scala kodo z
naslovi in nato zaženemo sestavljanje. Pri tem bo izvedena prevajanje in testi.
V tem primeru bo funkcija znana statično in jo lahko predstavimo v kodi kot preslikavoMap[NodeId, NodeAddress]. - V nekaterih primerih se veljavni naslov izve šele po zagonu noda.
V tem primeru lahko implementiramo "odkrivalno storitev" (discovery), ki se zažene pred ostalimi nodi, in vsi nodi se registrirajo v tej storitvi ter zahtevajo naslove drugih nodov. - Če lahko spremenimo
/etc/hosts, lahko uporabimo vnaprej določena imena gostiteljev (kot somy-project-main-nodeinecho-backend) in preprosto povežemo ta imena
z IP naslovi med izvajanjem.
V okviru tega prispevka ne bomo podrobno obravnavali teh primerov. Za našo
igrajočo primer bomo imeli vsi nodi en sam IP naslov — 127.0.0.1.
Nato bomo obravnavali dve različici distribuiranega sistema:
- Namestitev vseh storitev na enem nodu.
- In postavitev echo storitve in echo odjemalca na različnih nodih.
Konfiguracija za :
Konfiguracija za en nod
objekt SingleNodeConfig extends EchoConfig[String]
  with EchoClientConfig[String] with FiniteDurationLifecycleConfig
{
  case object Singleton \/\/ identifikator enega vozla
  \/\/ konfiguracija strežnika
  tip NodeId = Singleton.type
  def nodeId = Singleton

  \/** Specifikacija varne storitvene luknje. *\/
  override def portNumber: PortNumber = 8088

  \/\/ konfiguracija odjemalca

  \/** Uporabili bomo storitev, ki jo nudi isti gostitelj. *\/
  def echoServiceDependency = echoService

  override def testMessage: UrlPathElement = "hello"

  def pollInterval: FiniteDuration = 1.second

  \/\/ konfiguracija kontrolerja življenjskega cikla
  def lifetime: FiniteDuration = 10500.milliseconds \/\/ dodatna 0.5 sekunde, tako da so 10 zahtevkov, ne 9.
}
Objekt implementira konfiguracijo tako odjemalca kot strežnika. Prav tako se uporablja konfiguracija življenjske dobe, da po preteku intervala življenjski dobi zaključi delovanje programa. (Ctrl-C prav tako deluje in pravilno sprosti vse vire.)
Enako zbirka trait-ov konfiguracije in implementacij se lahko uporabi za ustvarjanje sistema, ki ga sestavljata :
Konfiguracija za dve vozlišči
  objekt NodeServerConfig extends EchoConfig[String] with SigTermLifecycleConfig
  {
    tip NodeId = NodeIdImpl

    def nodeId = NodeServer

    override def portNumber: PortNumber = 8080
  }

  objekt NodeClientConfig extends EchoClientConfig[String] with FiniteDurationLifecycleConfig
  {
    \/\/ UPOZORILO! specifikacija odvisnosti
    def echoServiceDependency = NodeServerConfig.echoService

    def pollInterval: FiniteDuration = 1.second

    def lifetime: FiniteDuration = 10500.milliseconds \/\/ dodatna 0.5 sekunde, tako da so 10 zahtevkov, ne 9.

    def testMessage: String = "dolly"
  }
Pomembno! Bodite pozorni, kako se izvaja povezovanje storitev. Navedemo storitev, ki jo implementira eno vozlišče, kot implementacijo metode-odvisnosti drugega vozlišča. Vrsta odvisnosti se preveri s kompilatorjem, saj vsebuje vrsto protokola. Med izvajanjem bo odvisnost vsebovala pravilni identifikator ciljnega vozlišča. Z zahvaljujoč temu načrtu navedemo številko vrata le enkrat in vedno zagotovo sklicujemo na pravilna vrata.
Implementacija dveh vozlišč sistema
Za to konfiguracijo uporabljamo iste implementacije storitev brez sprememb. Edina razlika je, da zdaj imamo dve objekti, ki implementirata različne sklope storitev:
  objekt TwoJvmNodeServerImpl extends ZeroServiceImpl[IO] with EchoServiceService with SigIntLifecycleServiceImpl {
    tip Config = EchoConfig[String] with SigTermLifecycleConfig
  }

  objekt TwoJvmNodeClientImpl extends ZeroServiceImpl[IO] with EchoClientService with FiniteDurationLifecycleServiceImpl {
    tip Config = EchoClientConfig[String] with FiniteDurationLifecycleConfig
  }
Prvo vozlišče implementira strežnik in potrebuje le strežniško konfiguracijo. Drugo vozlišče implementira odjemalca in uporablja drugo del konfiguracije. Prav tako potrebujeta oba vozlišča upravljanje življenjske dobe. Strežniško vozlišče deluje neomejeno dolgo, dokler ni ustavljeno SIGTERMin odjemalsko vozlišče se zaključi po določenem času. Glej .
Skupni proces razvoja
Oglejmo si, kako ta pristop k konfiguraciji vpliva na celoten proces razvoja.
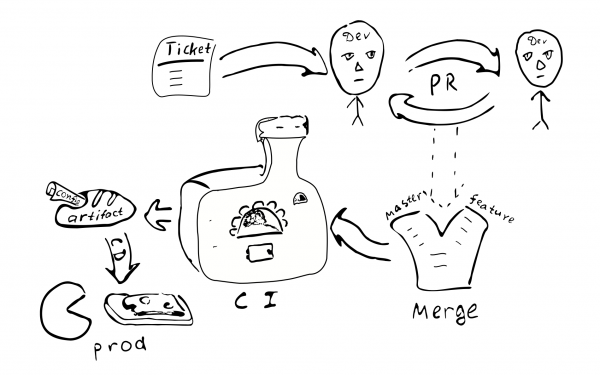
Konfiguracija bo skompajlirana skupaj z ostalo kodo in generirani bodo artefakti (.jar). Verjetno ima smisel postaviti konfiguracijo v ločen artefakt. To je zato, ker imamo lahko več konfiguracij na osnovi iste kode. Spet je mogoče generirati artefakte, ki ustrezajo različnim vejam konfiguracije. Skupaj s konfiguracijo se shranijo odvisnosti od specifičnih različic knjižnic, te različice pa se trajno shranijo, kadar koli se odločimo za razporeditev te različice konfiguracije.
Vsaka sprememba konfiguracije se prevede v spremembo kode. Zato bo vsaka taka
sprememba zajeta v običajnem postopku zagotavljanja kakovosti:
Naloga v sistemu za sledenje napakam -> PR -> pregled -> združitev z ustreznimi vejami ->
integracija -> razporeditev
Glavne posledice uvedbe kompilirane konfiguracije:
Konfiguracija bo usklajena na vseh vozliščih porazdeljenega sistema. Ker vsa vozlišča prejemajo isto konfiguracijo iz enega samega vira.
Težko je spremeniti konfiguracijo le na enem od vozlišč. Zato je »razhajanje konfiguracije« (configuration drift) malo verjetno.
Postaja težje uvajati majhne spremembe v konfiguracijo.
Večina sprememb konfiguracije bo potekala v okviru skupnega procesa razvoja in bo podvržena pregledu.
Ali potrebujemo ločeno skladišče za shranjevanje produkcijske konfiguracije? Takšna konfiguracija lahko vsebuje gesla in druge tajne informacije, do katerih bi želeli omejiti dostop. Glede na to se zdi smiselno shraniti končno konfiguracijo v ločenem skladišču. Konfiguracijo lahko razdelimo na dva dela — enega, ki vsebuje javne konfiguracijske parametre, in drugega, ki vsebuje parametre z omejenim dostopom. To bo omogočilo večini razvijalcev dostop do skupnih parametrov. Takšne razdelitve ni težko doseči s pomočjo vmesnih trait-ov, ki vsebujejo privzete vrednosti.
Možne variacije
Poskusimo primerjati kompilirano konfiguracijo z nekaterimi pogostimi alternativami:
- Besedilna datoteka na ciljni napravi.
- Centralizirana shramba ključ-vrednost (
etcd/zookeeper). - Komponente procesa, ki jih je mogoče rekonfigurirati/ponovno zagnati brez ponovnega zagona procesa.
- Shranjevanje konfiguracije zunaj artefakta in nadzora različic.
Besedilne datoteke ponujajo veliko svobode pri majhnih spremembah. Sistemski administrator lahko dostopa do oddaljenega vozlišča, izvede spremembe v ustreznih datotekah in znova zažene storitev. Vendar pa lahko taka svoboda pri velikih sistemih ni zaželena. Sledi spremembam v drugih sistemih ne ostanejo. Nihče ne izvaja pregleda sprememb. Težko je določiti, kdo je dejansko izvedel spremembe in zakaj. Spremembe niso preizkušene. Če je sistem porazdeljen, se lahko administrator pozabi na ustrezno spremembo na drugih vozliščih.
(Prav tako je treba opozoriti, da uporaba prevedene konfiguracije ne izključuje možnosti uporabe besedilnih datotek v prihodnosti. Dovolj bo dodati parser in validator, ki bosta na izhodu dala isti tip Konfiguracija, in lahko uporabljamo besedilne datoteke. Odslej neposredno sledi, da je zapletenost sistema s prevedeno konfiguracijo nekoliko manjša od zapletenosti sistema, ki uporablja besedilne datoteke, saj za besedilne datoteke potrebujemo dodatno kodo.)
Centralizirana shramba ključ-vrednost je dober mehanizem za distribucijo meta-parametrov porazdeljene aplikacije. Določiti moramo, kateri so konfiguracijski parametri, in kateri so preprosto podatki. Recimo, da imamo funkcijo C => A => B, pri čemer parametri C redko spreminjajo, podatki A — pogosto. V tem primeru lahko rečemo, da C — konfiguracijski parametri, podatki A — so podatki. Zdi se, da se konfiguracijski parametri razlikujejo od podatkov v tem, da se običajno spreminjajo redkeje kot podatki. Poleg tega podatki običajno prihajajo iz enega vira (od uporabnika), konfiguracijski parametri pa iz drugega (od skrbnika sistema).
Če je treba redko spreminjajoče parametre posodobiti brez ponovnega zagona programa, lahko to pogosto privede do zapletanja programa, saj bomo morali nekako dostaviti parametre, jih hraniti, razčleniti in preveriti ter obdelati napačne vrednosti. Zato ima smisel z vidika zmanjšanja kompleksnosti programa zmanjšati število parametrov, ki se lahko med delovanjem programa spreminjajo (ali pa teh parametrov sploh ne podpirati).
Z vidika tega prispevka bomo razlikovali med statičnimi in dinamičnimi parametri. Če logika delovanja storitve zahteva spremembo parametrov med izvajanjem programa, jih bomo imenovali dinamični parametri. V nasprotnem primeru so parametri statični in jih je mogoče konfigurirati z uporabo prevodljive konfiguracije. Za dinamično rekofniguracijo bi lahko potrebovali mehanizem ponovnega zagonjenja delov programa z novimi parametri, podobno kot se procesi operacijskega sistema ponovno zaženejo. (Po našem mnenju je priporočljivo, da se izogibamo rekofniguraciji v realnem času, saj to povečuje kompleksnost sistema. Če je mogoče, je bolje koristiti standardne možnosti OS za ponovno zagon procesov.)
En od pomembnih vidikov uporabe statične konfiguracije, ki ljudi spodbuja k razmisleku o dinamični rekofniguraciji, je čas, potreben za ponovno nalaganje sistema po posodobitvi konfiguracije (downtime). V resnici, če moramo spremeniti statično konfiguracijo, bomo morali ponovno zagnati sistem, da bodo novi parametri začeli veljati. Problem downtime'а ima različno resnost za različne sisteme. V nekaterih primerih je mogoče načrtovati ponovno nalaganje za čas, ko je obremenitev minimalna. V primeru, da je potrebno zagotoviti neprekinjeno storitev, je mogoče izvesti . Tako, ko moramo ponovno zagnati sistem, zaženemo paralelno različico tega sistema, preklopimo uravnoteževalnik na njega in čakamo, dokler se ne zaključijo vse stare povezave. Ko so vse stare povezave zaključene, ugasnemo staro različico sistema.
Zdaj razmislimo o vprašanju shranjevanja konfiguracije znotraj artefakta ali zunaj njega. Če shranjujemo konfiguracijo znotraj artefakta, imamo vsaj možnost preveriti pravilnost konfiguracije med gradnjo artefakta. V primeru, da se konfiguracija nahaja zunaj nadzorovanega artefakta, je težko slediti, kdo in zakaj je spreminjal ta dokument. Kako pomembno je to? Po našem mnenju je za mnoge proizvodne sisteme pomembno imeti stabilno in visokokakovostno konfiguracijo.
Verzija artefakta omogoča določitev, kdaj je bil ustvarjen, katere vrednosti vsebuje, katere funkcije so vključene/izključene in kdo je odgovoren za kakršne koli spremembe v konfiguraciji. Seveda hranjenje konfiguracije znotraj artefakta zahteva določene napore, zato je treba sprejeti premišljeno odločitev.
Za in proti
Želel bi se osredotočiti na prednosti in slabosti predlagane tehnologije.
Prednosti
Spodaj je seznam glavnih možnosti kompilirane konfiguracije razdeljenega sistema:
- Statična preverba konfiguracije. Omogoča, da smo prepričani, da
je konfiguracija pravilna. - Bogat jezik konfiguracije. Običajno so drugi načini konfiguriranja omejeni maksimalno na zamenjavo nizov spremenljivk. Ob uporabi ScaLe postane na voljo širok spekter možnosti jezika za izboljšanje konfiguracije. Na primer, lahko uporabimo
trait-e za privzete vrednosti, s pomočjo objektov grupiramo parametre, lahko se sklicujemo na val-e, ki so bili enkrat razglašeni (DRY) v obsežni vidnosti. Lahko neposredno znotraj konfiguracije instanciramo katerikoli razred (Seq,Map, uporabniške razrede). - DSL. V Scali obstaja vrsta jezikovnih možnosti, ki olajšajo ustvarjanje DSL. Te možnosti lahko izkoristimo za implementacijo programskega jezika, ki bi bil bolj prijazen za ciljno skupino uporabnikov, tako da bi bila konfiguracija vsaj berljiva za strokovnjake s področja. Strokovnjaki lahko na primer sodelujejo v procesu pregleda konfiguracije.
- Celovitost in sinhronizacija med vozli. Ena od prednosti, da je konfiguracija celotnega razdeljenega sistema shranjena na enem mestu, je ta, da se vse vrednosti razglašajo natanko enkrat in se nato ponovno uporabljajo povsod, kjer so potrebne. Uporaba fantomskih tipov za razglašenje vrat omogoča zagotovitev, da v vseh pravilnih konfiguracijah sistema vozli uporabljajo združljive protokole. Prisotnost jasnih obveznih odvisnosti med vozli zagotavlja, da bodo vse storitve medsebojno povezane.
- Visoka kvaliteta promjena. Promjene u konfiguraciji uz korištenje zajedničkog razvojnog procesa omogućavaju visoke standarde kvalitete i za konfiguraciju.
- Istovremeno ažuriranje konfiguracije. Automatsko raspoređivanje sistema nakon promjena u konfiguraciji garantuje da će svi čvorovi biti ažurirani.
- Pojednostavljenje aplikacije. Aplikacija ne zahtijeva parsiranje, provjeru konfiguracije i obradu neispravnih vrijednosti. Tako se smanjuje složenost aplikacije. (Neki nivo kompleksnosti konfiguracije koja se primjećuje u našem primjeru nije atribut kompajlirane konfiguracije, već samo svjesna odluka uzrokovana željom za većom tipnom sigurnošću.) Lakše je vratiti se na uobičajenu konfiguraciju — jednostavno implementirati nedostajuće dijelove. Stoga se može, primjerice, započeti s kompajliranom konfiguracijom, odlažući implementaciju suvišnih dijelova do trenutka kada su stvarno potrebni.
- Verzionisana konfiguracija. Kako promjene u konfiguraciji slijede uobičajenu sudbinu svih drugih promjena, na izlazu dobijamo artefakt s jedinstvenom verzijom. Ovo nam omogućava, primjerice, povratak na prethodnu verziju konfiguracije po potrebi. Čak možemo koristiti konfiguraciju staru godinu dana i sistem će raditi jednako tako. Stabilna konfiguracija poboljšava predvidljivost i pouzdanost distribuiranog sistema. Budući da je konfiguracija fiksirana u fazi kompajliranja, prilično je teško krivotvoriti je u produkciji.
- Modularnost. Predloženi okvir je modularan, a moduli se mogu kombinovati u različitim varijantama za stvaranje različitih sistema. Konkretno, moguće je u jednoj varijanti konfigurirati sistem da radi na jednom čvoru, a u drugoj — na više čvorova. Moguće je stvoriti nekoliko konfiguracija za produkcijske instance sistema.
- Testiranje. Zamjenom pojedinačnih servisa sa mock-objektima, moguće je dobiti nekoliko verzija sistema pogodnih za testiranje.
- Integracijsko testiranje. Prisustvo jedinstvene konfiguracije celog distribuiranog sistema omogućava pokretanje svih komponenti u kontrolisanom okruženju tokom integracijskog testiranja. Lako je emulirati, na primer, situaciju u kojoj neki čvorovi postaju nedostupni.
Nedostaci i ograničenja
Kompilovana konfiguracija se razlikuje od drugih pristupa konfiguraciji i možda neće odgovarati nekim aplikacijama. U nastavku su navedeni neki nedostaci:
- Statička konfiguracija. Ponekad je potrebno brzo ispraviti konfiguraciju u produkciji, zaobilazeći sve zaštitne mehanizme. U okviru ovog pristupa to može biti složenije. U svakom slučaju, kompilacija i automatsko implementiranje će biti potrebni. Ovo je istovremeno i korisna karakteristika pristupa i nedostatak u nekim slučajevima.
- Generisanje konfiguracije. U slučaju da se konfiguracijska datoteka generiše automatskim alatom, mogu biti potrebni dodatni napori za integraciju skripte za izgradnju.
- Alati. Trenutno, alati i metode koje su namenjene za rad sa konfiguracijama zasnovane su na tekstualnim datotekama. Neće svi takvi alati/metode biti dostupni u slučaju kompilovane konfiguracije.
- Potrebna su promena gledišta. Programeri i DevOps su navikli na tekstualne datoteke. Sama ideja kompilacije konfiguracije može biti pomalo iznenađujuća i neobična i izazvati odbacivanje.
- Potreban je visokokvalitetan razvojni proces. Da biste se komfortno koristili kompilovanom konfiguracijom, potrebna je potpuna automatizacija procesa izgradnje i implementacije aplikacije (CI/CD). U suprotnom, biće prilično nezgodno.
Takođe ćemo se osvrnuti na niz ograničenja razmatranog primera koja nisu povezana sa idejom kompilovane konfiguracije:
- Ako pružamo suvišne konfiguracijske informacije koje se ne koriste od strane čvora, onda nam prevodilac neće pomoći da otkrijemo odsustvo implementacije. Ovaj problem se može rešiti ako se odrekne Cake Pattern-a i koristi strože tipove, na primer,
HListili algebraičke tipove podataka (case class) za predstavljanje konfiguracije. - U datoteci sa konfiguracijom postoje redovi koji se ne odnose isključivo na konfiguraciju: (
package,uvoz, deklaracije objekata;prekliči defPri parametrov, ki imajo privzete vrednosti. Delno se temu lahko izognemo, če implementiramo svoj DSL. Poleg tega druge oblike konfiguracije (na primer XML) tudi nalagajo določene omejitve na strukturo datoteke. - V okviru tega prispevka ne obravnavamo dinamične rekonfiguracije klasterja podobnih vozlišč.
Zaključek
V tem prispevku smo obravnavali idejo predstavljanja konfiguracije v izvorni kodi z uporabo naprednih možnosti sistema tipov Scala. Tak pristop se lahko uporabi v različnih aplikacijah kot zamenjava tradicionalnim načinih konfiguiranja, ki temeljijo na xml- ali besedilnih datotekah. Kljub temu, da je naš primer implementiran v Scali, se iste ideje lahko prenesejo na druge prevajane jezike (kot so Kotlin, C#, Swift, …). Ta pristop lahko preizkusimo v enem od naslednjih projektov, in če ne bo ustrezal, preidemo k besedilnim datotekam, dodamo manjkajoče podrobnosti.
Seveda kompilirana konfiguracija zahteva visokokakovosten proces razvoja. V zameno zagotavlja visoko kakovost in zanesljivost konfiguracij.
Obravnavan pristop je mogoče razširiti:
- Lahko uporabimo makre za izvajanje preverjanj med prevajanjem.
- Lahko implementiramo DSL za predstavitev konfiguracije v dostopni obliki za končne uporabnike.
- Lahko implementiramo dinamično upravljanje virov z avtomatskim prilagajanjem konfiguracije. Na primer, ob spremembi števila vozlišč v klasterju je potrebno, da (1) vsako vozlišče prejme nekoliko drugačno konfiguracijo; (2) upravitelj klasterja dobi informacije o novih vozliščih.
Poděkování
Rad bi se zahvalil Andreyju Saksonovu, Pavlu Popovu in Antonu Nehaevu za konstruktivno kritiko osnutka članka.
Izvor: habr.com
