

S coraz bolj se odjemalci pojavijo takšni zahtevki: „Želimo kot Amazon RDS, vendar ceneje“; „Želimo kot RDS, vendar povsod, v kateri koli infrastrukturi“. Da bi uresničili tovrstno upravljano rešitev na Kubernetes, smo pregledali trenutno stanje najbolj priljubljenih operaterjev za PostgreSQL (Stolon, operaterji podjetij Crunchy Data in Zalando) in naredili svoj izbor.
Ta članek je naš pridobljen izkušnji z teoretičnega vidika (pregled rešitev) in s praktične strani (kaj je bilo izbrano in kakšni so bili rezultati). Toda najprej določimo, katere zahteve se načeloma postavljajo za potencialno zamenjavo RDS…
Kaj je RDS
Ko ljudje govorijo o RDS, po našem mnenju mislijo na upravljano storitev DBMS, ki:
- se enostavno nastavi;
- ima možnost dela s posnetki in se iz njih obnovi (najbolje — s podporo );
- omogoča ustvarjanje topologij master-slave;
- ima obsežen seznam razširitev;
- nudi revizijo in upravljanje uporabnikov/dostopov.
Če govorimo splošno, so lahko pristopi k reševanju naloge precej različni, vendar nam pot z Ansible ni blizu. (Do podobnega zaključka so prišli tudi kolegi iz 2GIS v svojem poskusu Operaterji so namreč splošno sprejet pristop za reševanje tovrstnih nalog v ekosistemu Kubernetes. O njih v zvezi z bazami podatkov, ki se izvajajo znotraj Kubernetes, je direktor „Flante“ že predaval
v enem od svojih predavanj , v .
NB. Z njegovo pomočjo lahko to dosežete brez znanja Go, na bolj običajne načine za sistemske administratorje: v Bashu, Pythonu itd. Za PostgreSQL obstaja več priljubljenih K8s operaterjev:
Stolon;
- Crunchy Data PostgreSQL Operator;
- Zalando Postgres Operator.
- Poglejmo jih podrobneje.
Izbor operaterja
Poleg pomembnih možnosti, ki so bile že omenjene, smo mi — kot inženirji za upravljanje infrastrukture v Kubernetes — prav tako pričakovali od operaterjev naslednje:
deploj iz Git in s
- Custom Resources ;
- namestitev node affinity ali node selector;
- namestitev tolerations;
- možnosti tuning;
- jasne tehnologije in celo ukazi.
- понятные технологии и даже команды.
Ne dajuci se u detalje o svakom od stavki (pitajte u komentarima ako imate pitanja nakon čitanja celog članka), istakao bih da su ovi parametri potrebni za preciznije opisivanje specijalizacije čvorova klastera kako bismo ih naručili za konkretne aplikacije. Tako možemo postići optimalnu ravnotežu između performansi i troškova.
Sada, prelazimo na same operatore PostgreSQL.
1. Stolon
iz italijanske kompanije Sorint.lab u razmatran je kao svojevrsni standard među operatorima za DBMS. To je prilično star projekt: prva javna verzija objavljena je još u novembru 2015. godine (sic!), a GitHub repozitorij može se pohvaliti sa skoro 3000 zvezdica i 40+ doprinositelja.
I zaista, Stolon je odličan primer promišljene arhitekture:
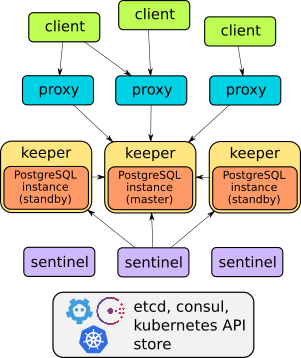
O radu ovog operatora se možete detaljno upoznati u izveštaju ili . U celini, dovoljno je reći da može sve navedeno: failover, proxy za transparentan pristup klijentima, backup... Pri čemu proxy pruža pristup preko jednog servisa endpoint — za razliku od druga dva rešenja koja će biti diskutovana (za njih postoji po dva servisa za pristup bazi).
Međutim, Stolon , zbog čega ga nije moguće postaviti tako da jednostavno i brzo — „kao sveže peciva“ — kreira instance DBMS u Kubernetesu. Upravljanje se vrši putem alata stolonctl, postavljanje preko Helm šema, a korisnički se definišu u ConfigMap.
S jedne strane, ispostavlja se da operator nije baš operator (jer ne koristi CRD). Ali s druge strane — to je fleksibilan sistem koji omogućava prilagođavanje resursa u K8s kako vam odgovara.
U zaključku, za nas se nije pokazao optimalnim put da pravimo poseban chart za svaku bazu podataka. Zato smo počeli da tražimo alternative.
2. Crunchy Data PostgreSQL Operator
, mladog američkog startapa, izgledao je kao logična alternativa. Njegova javna istorija počinje s prvim izdanjem u martu 2017. godine, od tada GitHub repozitorij je dobio nešto manje od 1300 zvezdica i 50+ doprinositelja. Poslednje izdanje iz septembra je testirano za rad sa Kubernetes 1.15—1.18, OpenShift 3.11+ i 4.4+, GKE i VMware Enterprise PKS 1.3+.
Arhitektura Crunchy Data PostgreSQL Operator takođe odgovara navedenim zahtevima:
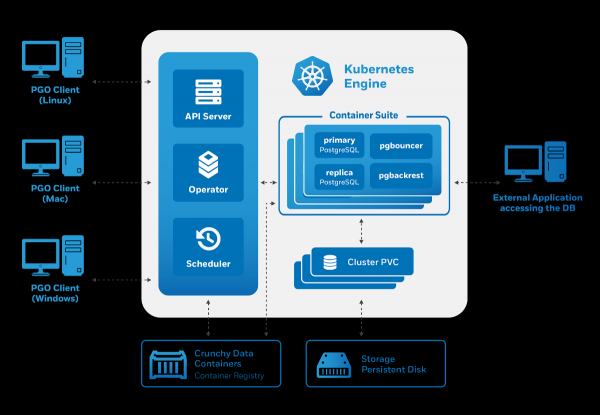
Upravljanje se odvija putem alata pgo, no on, s druge strane, generira prilagođene resurse za Kubernetes. Stoga nas je kao potencijalne korisnike operator obradovao:
- postoje upravljanje putem CRD-a;
- prikladno upravljanje korisnicima (također putem CRD-a);
- integracija s drugim komponentama — specijalizirana kolekcija kontejnerskih slika za PostgreSQL i alate za rad s njom (uključujući pgBackRest, pgAudit, proširenja iz contrib itd.).
Međutim, pokušaji započinjanja korištenja Crunchy Data operatora otkrili su nekoliko problema:
- Nije bila moguća toleracija — predviđen je samo nodeSelector.
- Stvoreni podovi bili su dio Deployment-a, unatoč tome što smo implementirali stateful aplikaciju. Za razliku od StatefulSet-a, Deployment-i ne mogu stvoriti diske.
Zadnji nedostatak dovodi do zabavnih trenutaka: na testnom okruženju uspjelo se pokrenuti 3 replike s jednim diskom local storage, zbog čega je operator izvijestio da 3 replike rade (iako to nije bilo slučaj).
Još jedna karakteristika ovog operatora je njegova gotova integracija s raznim pomoćnim sustavima. Na primjer, lako je instalirati pgAdmin i pgBounce, a u razmatranju su unaprijed konfigurirani Grafana i Prometheus. U nedavnom posebno se ističe poboljšana integracija s projektom , zahvaljujući čemu operator nudi jasnu vizualizaciju metrika za PgSQL "iz kutije".
Ipak, čudan izbor generiranih Kubernetes resursa doveo je do potrebe da pronađemo drugo rješenje.
3. Zalando Postgres Operator
Proizvodi Zalando su nam poznati već dugo: imamo iskustva s korištenjem Zaleniuma i, naravno, pokušali smo — njihovo popularno HA rješenje za PostgreSQL. O pristupu tvrtke u stvaranju govorio je jedan od njegovih autora — Aleksej Kljukin — u eteru , i dopao nam se.
Ovo je najmlađe rješenje od razmatranih u članku: prvo izdanje održano je u kolovozu 2018. godine. Međutim, čak i unatoč malom broju formalnih izdanja, projekt je prošao veliki put, već premašivši popularnost rješenja od Crunchy Data s više od 1300 zvjezdica na GitHubu i maksimalnim brojem suradnika (preko 70).
"Ispod haube" ovog operatora koriste se rješenja koja su se pokazala dugotrajnima:
- Patroni i za upravljanje,
- — za backupove,
- — kao pool veza.
Evo kako je predstavljena arhitektura operatora iz Zalanda:
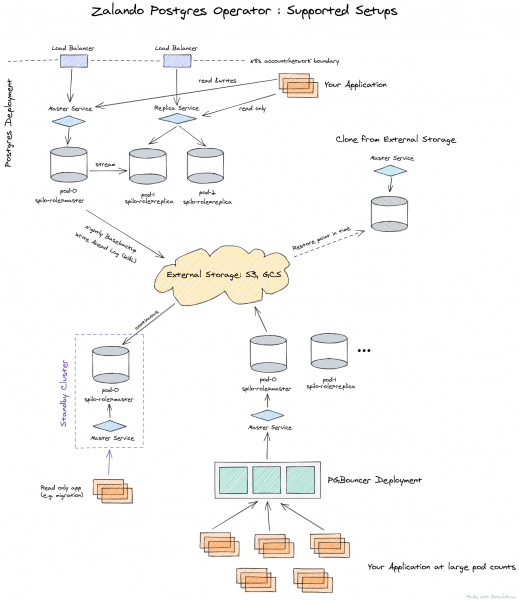
Operater se popolnoma upravlja prek Custom Resources, samodejno ustvari StatefulSet iz kontejnerjev, ki jih je mogoče prilagoditi s dodajanjem različnih sidecar-ov v pod. To je izjemna prednost v primerjavi z operaterjem podjetja Crunchy Data.
Ker smo se odločili za rešitev podjetja Zalando med tremi obravnavanimi možnostmi, bomo spodaj predstavili njene zmožnosti skupaj s praktično uporabo.
Praksa z Postgres Operatorjem od Zalanda
Namestitev operaterja je zelo preprosta: dovolj je, da prenesete aktualno različico s GitHub-a in uporabite YAML datoteke iz imenika . Kot možnost lahko tudi uporabite .
Po namestitvi je potrebno poskrbeti za nastavitev . Ta se izvede prek ConfigMap postgres-operator v imenskem prostoru, kjer ste namestili operaterja. Ko je shranjevanje nastavljeno, lahko razporedite prvi cluster PostgreSQL.
Na primer, standardna namestitev izgleda takole:
apiVersion: acid.zalan.do/v1
kind: postgresql
metadata:
 name: staging-db
spec:
 numberOfInstances: 3
 patroni:
   synchronous_mode: true
 postgresql:
   version: "12"
 resources:
   limits:
     cpu: 100m
     memory: 1Gi
   requests:
     cpu: 100m
     memory: 1Gi
 sidecars:
 - env:
   - name: DATA_SOURCE_URI
     value: 127.0.0.1:5432
   - name: DATA_SOURCE_PASS
     valueFrom:
       secretKeyRef:
         key: password
         name: postgres.staging-db.credentials
   - name: DATA_SOURCE_USER
     value: postgres
   image: wrouesnel/postgres_exporter
   name: prometheus-exporter
   resources:
     limits:
       cpu: 500m
       memory: 100Mi
     requests:
       cpu: 100m
       memory: 100Mi
 teamId: staging
 volume:
   size: 2Gi
Ta manifest razporedi cluster s 3 primeri in sidecar-om v obliki , s katerim zbiramo metrike aplikacije. Kot vidite, je vse zelo preprosto in po želji lahko ustvarite dobesedno neomejeno število clusterjev.
Pozorno je treba gledati tudi na spletno ploščo za upravljanje — . Ta pride skupaj z operaterjem in omogoča ustvarjanje in brisanje clusterjev ter delo z varnostnimi kopijami, ki jih izvaja operater.
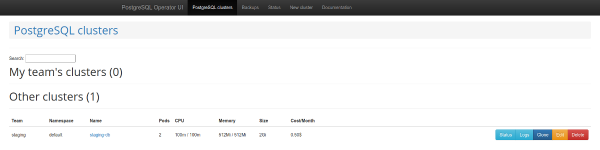
Seznam clusterjev PostgreSQL
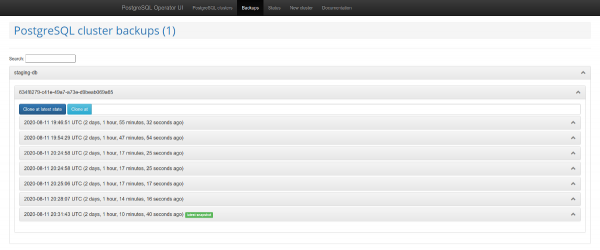
Upravljanje varnostnih kopij
Druga zanimiva značilnost je podpora . Ta mehanizem samodejno ustvari vloge v PostgreSQL, glede na prejet seznam imen uporabnikov. Po tem API omogoča vrnitev seznama uporabnikov, za katere se samodejno ustvarjajo vloge.
Težave in njihovo reševanje
Vendar pa je uporaba operaterja kmalu razkrila nekaj pomembnih pomanjkljivosti:
- pomanjkanje podpore za nodeSelector;
- nemogočnost izključiti varnostne kopije;
- pri uporabi funkcije ustvarjanja baz se ne pojavijo privzete pravice;
- občasno primanjkuje dokumentacije ali pa je ta zastarela.
Na srečo je veliko od teh težav mogoče odpraviti. Začnimo z zadnjim — težave s dokumentacijo.
Verjetno se boste srečali s tem, da ni vedno jasno, kako zapisati varnostno kopijo in kako povezati varnostno kopijo s Operator UI. O tem se v dokumentaciji omenjajo na kratko, realen opis pa je v :
- potrebno je ustvariti skrivnost;
- predati jo operatorju v parametru
pod_environment_secret_namev CRD z nastavitvami operatorja ali v ConfigMap (odvisno od tega, kako ste se odločili namestiti operator).
Vendar, kot se je izkazalo, trenutno to ni mogoče. Zato smo zbrali z nekaterimi dodatnimi zunanjimi razvoji. Več informacij o njem — glejte spodaj.
Če operatorju predamo parametre za varnostno kopijo, natančneje — wal_s3_bucket in ključe za dostop do AWS S3, bo varnostno kopiral vse: ne samo baze v production, ampak tudi staging. To nas ni zadovoljilo.
V opisu parametrov za Spilo, ki je osnovna Docker-ovitek za PgSQL pri uporabi operatorja, se je izkazalo: parameter WAL_S3_BUCKET lahko pustimo prazen, s tem pa izključimo varnostne kopije. Poleg tega je bilo našemu velikemu veselju najdeno tudi , ki smo ga takoj sprejeli v svoj fork. Zdaj je dovolj, da preprosto dodamo enableWALArchiving: false v vir klasterja PostgreSQL.
Da, obstajala je možnost, da to naredimo drugače, z zagonom dveh operatorjev: enega za staging (brez varnostnih kopij), in drugega — za production. A tako smo lahko obvladali z enim.
V redu, naučili smo se predati dostop do S3 bazam in varnostne kopije so začele priti v shrambo. Kako spraviti strani varnostnih kopij v Operator UI, da delujejo?
V Operator UI bo potrebno dodati 3 spremenljivke:
-
SPILO_S3_BACKUP_BUCKET -
AWS_ACCESS_KEY_ID -
AWS_SECRET_ACCESS_KEY
Po tem bo upravljanje z varnostnimi kopijami postalo dostopno, kar bo v našem primeru poenostavilo delo s stagingom, saj bo omogočilo dostavo rezin z productiona brez dodatnih skript.
Kot še en plus so omenjeni delo z Teams API in široke možnosti za ustvarjanje baz in vlog s pomočjo operatorja. Vendar ustvarjene vloge niso imele privzetih pravic. Zato uporabnik s pravicami za branje ni mogel brati novih tabel.
Zakaj tako? Kljub temu, da je v kodi potrebno GRANT, se ne uporabljajo vedno. Obstajata 2 metode: syncPreparedDatabases in syncDatabases. U syncPreparedDatabases — kljub temu, da v razdelku preparedDatabases je pogoj defaultRoles in defaultUsers za ustvarjanje vlog, — privzete pravice se ne uporabljajo. Trenutno pripravljamo popravke, da bodo te pravice samodejno uporabljene.
In zadnja točka v naših aktualnih izboljšavah — , ki dodaja Node Affinity v ustvarjeni StatefulSet. Naši naročniki pogosto raje zmanjšajo stroške z uporabo spot-instances, kar pomeni, da jih ni smiselno uporabljati za baze podatkov. To težavo bi bilo mogoče rešiti tudi z toleracijami, vendar prisotnost Node Affinity zagotavlja večjo varnost.
Kaj smo dosegli?
Kot rezultat rešitve naštetih težav smo forkali Postgres Operator od Zalanda v , kjer se zbira s tako uporabnimi popravki. Za še večje udobje smo zbrali tudi .
Seznam PR, sprejetih v fork:
- ;
- ;
- ;
- .
Bilo bi super, če bi skupnost podprla te PR, da bi prišli v upstream z naslednjo različico operaterja (1.6).
Bonus! Zgodba o uspehu pri migraciji produkcije
Če uporabljate Patroni, lahko na operater migrirate živo produkcijo z minimalnim izpadom.
Spilo omogoča ustvarjanje standby-klasterjev preko S3 skladišč z , ko se binarni log PgSQL najprej shrani v S3, nato pa ga prenese replika. Kaj pa, če imate ne uporabo Wal-E v stari infrastrukturi? Rešitev tega problema je že na Habré.
Na pomoč prihaja logična replikacija PostgreSQL. Vendar se ne bomo poglobili v podrobnosti, kako ustvariti publikacije in naročnine, ker… naš načrt je propadel.
Gre za to, da je bilo v DB več obremenjenih tabel z milijoni vrstic, ki so se nenehno dodajale in odstranjevale. z copy_data, pri kateri nova replika kopira celotno vsebino z glavne baze, ni uspela temu slediti. Kopiranje vsebine je trajalo teden dni, vendar je le-to ni ujelo glavne baze. Na koncu je rešitev prišla od kolegov iz Avita: podatke je mogoče prenesti z uporabo pg_dump. Opisal bom naš (malce dopolnjen) variant tega algoritma.
Ideja je, da lahko ustvarimo izklopljeno naročnino, povezano s specifičnim repliko, in nato popravimo številko transakcije. Na voljo so bile replike za delovanje produkcije. To je pomembno, ker bo replikacija pomagala ustvariti dosleden izpis in nadaljevati z obravnavo sprememb iz glavnega strežnika.
V nadaljnjih ukazih, ki opisujejo postopek migracije, bodo uporabljene naslednje oznake za gostitelje:
- master — izvorni strežnik;
- replica1 — tokovna replikacija na starem produkcijskem strežniku;
- replica2 — nova logična replikacija.
Migračni načrt
1. Na glavnem strežniku bomo ustvarili naročnino za vse tabele v shemi public baze dbname:
psql -h master -d dbname -c "CREATE PUBLICATION dbname FOR ALL TABLES;"
2. Ustvarimo repliko na glavnem strežniku:
psql -h master -c "select pg_create_logical_replication_slot('repl', 'pgoutput');"
3. Ustavimo replikacijo na stari repliki:
psql -h replica1 -c "select pg_wal_replay_pause();"
4. Pridobimo številko transakcije z glavnega strežnika:
psql -h master -c "select replay_lsn from pg_stat_replication where client_addr = 'replica1';"
5. Izvedemo izpis iz stare replikacije. To bomo naredili v več tokovih, kar bo pospešilo postopek:
pg_dump -h replica1 --no-publications --no-subscriptions -O -C -F d -j 8 -f dump/ dbname
6. Naložimo izpis na nov strežnik:
pg_restore -h replica2 -F d -j 8 -d dbname dump/
7. Po nalaganju izpisa lahko zaženemo replikacijo na tokovni repliki:
psql -h replica1 -c "select pg_wal_replay_resume();"
7. Ustvarimo naročnino na novi logični repliki:
psql -h replica2 -c "create subscription oldprod connection 'host=replica1 port=5432 user=postgres password=secret dbname=dbname' publication dbname with (enabled = false, create_slot = false, copy_data = false, slot_name='repl');"
8. Pridobimo oid naročnine:
psql -h replica2 -d dbname -c "select oid, * from pg_subscription;"
9. Predpostavimo, da smo pridobili oid=1000. Uporabimo številko transakcije za naročnino:
psql -h replica2 -d dbname -c "select pg_replication_origin_advance('pg_1000', 'AA/AAAAAAAA');"
10. Začnemo replikacijo:
psql -h replica2 -d dbname -c "alter subscription oldprod enable;"
11. Preverimo status naročnine, replikacija bi morala delovati:
psql -h replica2 -d dbname -c "select * from pg_replication_origin_status;"
psql -h master -d dbname -c "select slot_name, restart_lsn, confirmed_flush_lsn from pg_replication_slots;"
12. Po zagonu replikacije in sinhronizaciji baz se lahko izvrši preklop.
13. Po izklopu replikacije moramo popraviti sekvence. To je dobro opisano .
Zaradi takšnega načrta je preklop potekal z minimalnimi zakasnitvami.
Zaključek
Kubernetes operaterji omogočajo poenostavljanje različnih dejanj tako, da jih znižajo na ustvarjanje K8s virov. Vendar, ko dosežete izjemno avtomatizacijo z njihovo pomočjo, ne pozabite, da lahko prinese tudi vrsto nepričakovanih zapletov, zato previdno izbirajte operaterje.
Po pregledu treh najbolj priljubljenih Kubernetes operaterjev za PostgreSQL smo se odločili za projekt podjetja Zalando. Kljub nekaterim izzivom, s katerimi smo se soočili, smo bili resnično navdušeni nad rezultati, zato načrtujemo širitev tega znanja na nekatere druge namestitve PgSQL. Če imate izkušnje z uporabo podobnih rešitev, bomo veseli vaših podrobnosti v komentarjih!
P.S.
Preberite tudi na našem blogu:
- «»;
- «»;
- «».
Izvor: habr.com
