

Zdravo ponovno! Naslov članka govori sam za sebe. Uoči početka kursa predlažemo da razjasnimo ko su to u stvari inženjeri podataka. U članku se nalazi mnogo korisnih linkova. Uživajte u čitanju.
Jednostavan vodič o tome kako uhvatiti talas Data Engineering-a i ne dopustiti da vas povuče u dubine.
Stiče se utisak da svako želi postati data scientist. A šta je sa Data Engineering-om? Suštinski, to je neka vrsta hibrida između analitičara podataka i data scientist-a; inženjer podataka obično je odgovoran za upravljanje radnim procesima, tokovima podataka i ETL procesima.Zbog važnosti ovih funkcija, trenutno je to još jedan popularni profesionalni žargon koji aktivno dobija na značaju.
Visoka plata i ogroman potražnja su samo mali deo onoga što ovu profesiju čini izuzetno privlačnom! Ako želite da postanete deo ovog sveta, nikad nije kasno da počnete učiti. U ovom postu sam sakupio sve potrebne informacije kako bih vam pomogao da napravite prve korake.
Torej, začnimo!
Šta je Data Engineering?
Iskreno, ne postoji bolje objašnjenje od ovog:
«Naučnik može otkriti novu zvezdu, ali je ne može stvoriti. Moraće da zamoli inženjera da to uradi umesto njega.»
– Gordon Lindsay Glegg
Tako da je uloga inženjera podataka prilično značajna.
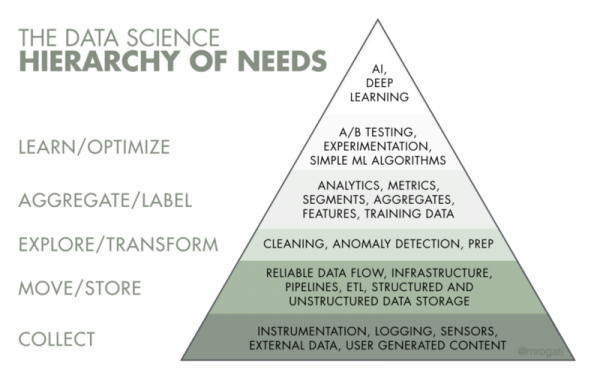
Iz imena se može naslutiti da se inženjerija podataka bavi podacima, posebno njihovim isporučivanjem, skladištenjem i obradom. Prema tome, osnovni zadatak inženjera je da obezbedi pouzdanu infrastrukturu podataka. Ako pogledamo hijerarhiju potreba veštačke inteligencije, inženjerija podataka zauzima prva 2–3 nivoa: prikupljanje, prenos i skladištenje, priprema podataka.
Čime se bavi inženjer podataka?
Sa pojavom velikih podataka, domen odgovornosti se drastično promenio. Dok su prethodno ovi stručnjaci pisali velike SQL upite i prenosili podatke koristeći alate kao što su Informatica ETL, Pentaho ETL, Talend, sada su zahtevi prema inženjerima podataka porasli.
Većina kompanija koje imaju otvorene pozicije za inženjera podataka postavljaju sledeće zahteve:
- Odlično poznavanje SQL-a i Pythona.
- Iskustvo sa oblacima, posebno Amazon Web Services.
- Poželjno poznavanje Jave/Scala.
- Dobro razumevanje SQL i NoSQL baza podataka (modelovanje podataka, skladištenje podataka).
Upoštevajte, da gre le za osnovno. Iz tega se lahko domneva, da so podatkovni inženirji strokovnjaki na področju razvoja programske opreme in backend-a.
Na primer, če podjetje začne ustvarjati velike količine podatkov iz različnih virov, je vaša naloga kot podatkovni inženir organizirati zbiranje informacij, njihovo obdelavo in shranjevanje.
Seznam orodij, ki se uporabljajo v tem primeru, se lahko razlikuje, vse je odvisno od obsega teh podatkov, hitrosti njihovega prihoda in heterogenosti. Večina podjetij se na splošno ne srečuje z velikimi podatki, zato lahko kot centralizirano shranjevanje, tako imenovano skladišče podatkov, uporabimo SQL bazo podatkov (PostgreSQL, MySQL itd.) z manjšim nizom skript, ki usmerjajo podatke v shranjevanje.
IT-giganti, kot so Google, Amazon, Facebook ali Dropbox, postavljajo višje zahteve: znanje Python, Java ali Scala.
- Izkušnje z velikimi podatki: Hadoop, Spark, Kafka.
- Poznavanje algoritmov in struktur podatkov.
- Razumevanje osnov razdeljenih sistemov.
- Izkušnje z orodji za vizualizacijo podatkov, kot sta Tableau ali ElasticSearch, bodo velik plus.
To pomeni, da se opazi očitno preusmeritev proti velikim podatkom, zlasti v njihovem obdelovanju pri visokih obremenitvah. Ta podjetja postavljajo višje zahteve glede odpornosti sistema.
Podatkovni inženirji Vs. podatkovni znanstveniki
Prav, to je bilo preprosto in zabavno primerjanje (ni osebno), toda resnično je vse veliko bolj zapleteno.
Najprej morate vedeti, da obstaja precejšnja nejasnost pri ločevanju vlog in znanj podatkovnega znanstvenika in podatkovnega inženirja. To pomeni, da vas lahko zlahka zmede, katere veščine so potrebne za uspešnega podatkovnega inženirja. Seveda obstajajo določene veščine, ki se prekrivajo med obema vlogama. Toda obstaja tudi cela vrsta diametralno nasprotnih veščin.
Podatkovna znanost je resna zadeva, vendar se pomikamo proti svetu funkcionalne podatkovne znanosti, kjer so praktiki sposobni izvajati lastno analitiko. Da bi aktivirali podatkovne pipeline in integrirane podatkovne strukture, potrebujete podatkovne inženirje, ne znanstvenike.
Ali je podatkovni inženir bolj iskana oseba kot podatkovni znanstvenik?
— Da, ker preden lahko spečete korenčkovo torto, morate najprej nabrati, očistiti in shraniti korenje!
Podatkovni inženir se bolje spozna na programiranje kot katerikoli podatkovni znanstvenik, toda ko pride do statistike, je vse ravno obratno.
Toda prednost podatkovnega inženirja je:
brez njega/nje vrednost prototipnega modela, ki pogosto vključuje fragment nevarno slabega kode v Python datoteki, pridobljenem od podatkovnega znanstvenika in nekako prinaša rezultat, teži proti nič.
Brez podatkovnega inženirja ta koda nikoli ne bo postala projekt in nobena poslovna težava ne bo učinkovito rešena. Podatkovni inženir poskuša vse to spremeniti v izdelek.
Osnovna znanja, ki jih mora poznati podatkovni inženir
Torej, če vas to delo osvetljuje in ste polni navdušenja — sposobni ste se tega naučiti, lahko obvladate vse potrebne spretnosti in postanete prava rock zvezda na področju podatkovne znanosti. In ja, to lahko dosežete tudi brez programerskih veščin ali drugih tehničnih znanj. To je težko, a mogoče!
Kakšni so prvi koraki?
Morate imeti splošno predstavo o tem, kaj je kaj.
Najprej, podatkovno inženirstvo se nanaša na informatik. Konkretno — morate razumeti učinkovite algoritme in strukture podatkov. Drugič, ker podatkovni inženirji delajo s podatki, je potrebna razumevanje načel delovanja baz podatkov in struktur, ki jih podpirajo.
Na primer, običajne SQL baze podatkov B-strah so osnovane na strukturi podatkov B-Tree, pa tudi v sodobnih razdeljenih skladiščih, na LSM-Tree in drugih različicah hash tabel.
* Ti koraki temeljijo na izjemnem članku . Torej, če znate rusko, podprite tega avtorja in preberite .
1. Algoritmi in strukture podatkov
Uporaba pravilne strukture podatkov lahko znatno izboljša zmogljivost algoritma. Idealno bi bilo, da bi vsi morali študirati strukture podatkov in algoritme v naših šolah, vendar to redko kdaj pride do izraza. V vsakem primeru nikoli ni prepozno, da se seznanite.
Torej, tukaj so moji najljubši brezplačni tečaji za učenje struktur podatkov in algoritmov:
Poleg tega ne pozabite na klasično delo o algoritmih Thomas Cormen-a — . To je popoln priročnik, ko potrebujete osvežitev spomina.
- Da izboljšate svoje veščine, uporabite .
Lahko se tudi potopite v svet podatkovnih baz s čudovitimi videi Univerze Carnegie Mellon na YouTube:
- .
- .
2. Učenje SQL-a
Vse naše življenje so podatki. In da bi te podatke pridobili iz podatkovne baze, se morate 'pogovarjati' z njimi v istem jeziku.
SQL (Structured Query Language — jezik strukturiranih poizvedb) je jezik za komunikacijo na področju podatkov. Ne glede na to, kaj kdo pravi, SQL je obstajal, obstaja in bo še dolgo obstajal.
Če ste dolgo časa delali v razvoju, ste verjetno opazili, da se govorice o kmalu smrti SQL-a občasno pojavljajo. Jezik je bil razvit v zgodnjih 70-ih in še vedno je izjemno priljubljen med analitiki, razvijalci in preprosto navdušenci.
Brez znanja SQL-a v podatkovnem inženirstvu ne morete napredovati, saj boste neizbežno morali ustvarjati poizvedbe za pridobivanje podatkov. Vse sodobne shrambe velikih podatkov podpirajo SQL:
- Amazon Redshift
- HP Vertica
- Oracle
- SQL Server
… in še mnoge druge.
Za analizo velikega sloja podatkov, shranjenih v distribuiranih sistemih, kot je HDFS, so bili izumljeni mehanizmi SQL: Apache Hive, Impala itd. Vidite, ne bo nikamor odšel.
Kako se naučiti SQL-a? Enostavno ga uporabljajte v praksi.
Za to bi priporočil, da se seznanite z odličnim učbenikom, ki je občasno brezplačen, od .
Izjemna značilnost teh tečajev je interaktivno okolje, v katerem lahko pišete in izvajate SQL poizvedbe neposredno v brskalniku. Vir ne bo odveč. In te znanje lahko uporabite v v razdelku Podatkovne baze.
3. Programiranje v Pythonu in Java/Scala
Zakaj se je smiselno učiti programskega jezika Python, sem že pisal v članku . Kar zadeva Javo in Scalo, je večina orodij za shranjevanje in obdelavo ogromnih količin podatkov napisanih v teh jezikih. Na primer:
- Apache Kafka (Scala)
- Hadoop, HDFS (Java)
- Apache Spark (Scala)
- Apache Cassandra (Java)
- HBase (Java)
- Apache Hive (Java)
Da bi razumeli kako ovi alati funkcionišu, morate poznavati jezike na kojima su napisani. Funkcionalni pristup Scalа omogućava efikasno rešavanje zadataka paralelne obrade podataka. Python, nažalost, ne može se pohvaliti brzinom i paralelnom obradom. U celini, poznavanje više jezika i programskih paradigmi pozitivno utiče na širinu pristupa rešavanju problema.
Da biste se uronili u jezik Scala, možete pročitati autora jezika. Takođe, kompanija Twitter je objavila dobro uvodno priručnik — .
Što se tiče Pythona, smatram najboljom knjigom srednjeg nivoa.
4. Alati za rad sa velikim podacima
Evo liste najpopularnijih alata u svetu velikih podataka:
- Apache Spark
- Apache Kafka
- Apache Hadoop (HDFS, HBase, Hive)
- Apache Cassandra
Više informacija o izgradnji velikih oblika podataka možete naći u ovom neverovatnom . Najpopularniji alati su Spark i Kafka. Definitivno ih vredi proučiti, po mogućstvu razumeti kako funkcionišu iznutra. Jay Kreps (koautor Kafke) je 2013. godine objavio monumentalno delo , inače, osnovne ideje iz ovog Talmuda korišćene su za kreiranje Apache Kafke.
- Uvedeni u Hadoop može poslužiti .
- Najpotpuniji vodič za Apache Spark za mene je — .
5. Oblak platforme
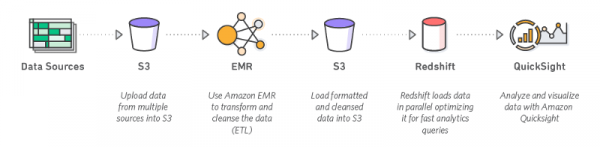
Poznavanje barem jedne oblačne platforme je na spisku osnovnih zahteva za kandidate za posao inženjera podataka. Poslodavci preferiraju Amazon Web Services, na drugom mestu je oblačna platforma Google, a treće mesto zauzima Microsoft Azure.
Treba da imate dobro razumevanje Amazon EC2, AWS Lambda, Amazon S3, DynamoDB.
6. Distribuirani sistemi
Rad sa velikim podacima podrazumeva prisustvo klastera nezavisno operativnih računara, čija komunikacija se ostvaruje putem mreže. Što je klaster veći, veća je verovatnoća kvara njegovih članova. Da biste postali vrhunski ekspert u oblasti podataka, potrebno je da se uronite u probleme i postojeća rešenja za distribuirane sisteme. Ova oblast je stara i složena.
Andrew Tanenbaum je pionir na ovom polju. Za one koji se ne boje teorije, preporučujem njegovu knjigu , za početnike može izgledati složeno, ali će vam zaista pomoći da usavršite svoje veštine.
Smatram najboljom uvodnom knjigom. Usput, Martin ima odličan . Njegov rad će vam pomoći da sistematizujete znanje o izgradnji moderne infrastrukture za skladištenje i obradu velikih podataka.
Za one koji vole da gledaju video, na YouTube-u postoji kurs .
7. Tokovi podataka
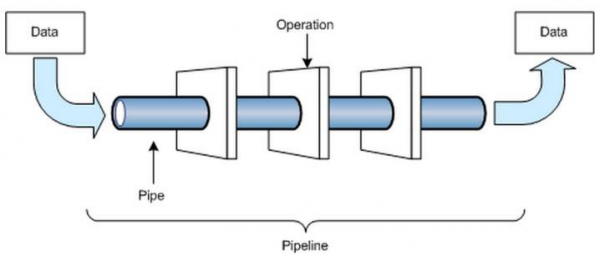
Tokovi podataka su nešto bez čega ne možete živeti kao inženjer podataka.
Većinu vremena inženjer podataka gradi takozvani tok podataka, tj. kreira proces isporuke podataka iz jednog mesta u drugo. To mogu biti korisnički scenariji koji idu ka API externih usluga ili vrše SQL upite, dopunjavaju podatke i smeštaju ih u centralizovano skladište (data warehouse) ili skladište nestrukturiranih podataka (data lakes).
Ukratko: osnovna kontrolna lista inženjera podataka
Zaključimo — potrebno je dobro razumevanje sledećeg:
- Informacione sisteme;
- Razvoj softvera (Agile, DevOps, dizajnerske tehnike, SOA);
- Distribuirane sisteme i paralelno programiranje;
- Osnove baza podataka — planiranje, dizajniranje, operacije i otklanjanje grešaka;
- Dizajniranje eksperimenata — A/B testovi za dokazivanje koncepata, određivanje pouzdanosti, performansi sistema, kao i za razvoj pouzdanih puteva za brz pristup dobrim rešenjima.
Ovo su samo neki zahtevi za postajanje inženjerom podataka, tako da proučite i razumite podatkovne sisteme, informacione sisteme, kontinuiranu isporuku/initijalizaciju/integraciju, programske jezike i druge teme o računarstvu (ne u svim predmetnim oblastima).
I, na kraju, poslednje, ali veoma važno što želim da kažem.
Pot ukrevanja v Data Engineering ni tako preprost, kot se zdi. Ne odpusti, frustrira in pripraviti se morate na to. Nekateri trenutki na tej poti vas lahko spodbudijo, da vse opustite. A to je resnično delo in učni proces.
Enostavno ga ne prikrajšajte že od začetka. Celotna ideja potovanja je v tem, da se naučite čim več in ste pripravljeni na nove izzive.
Tukaj je odlična slika, s katero sem se srečal in ki dobro ponazarja ta trenutek:
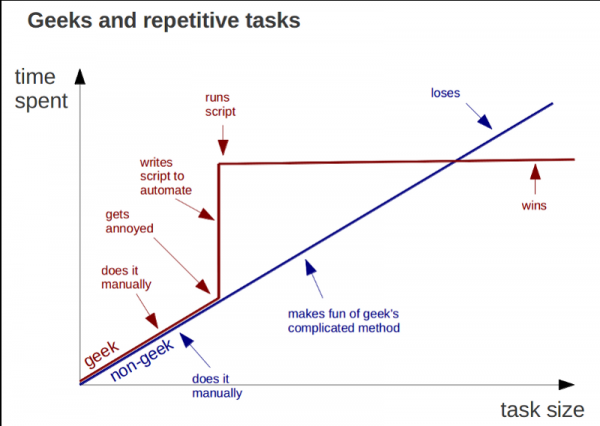
In da, ne pozabite se izogniti izgorelosti in si privoščiti počitek. To je prav tako zelo pomembno. Srečno!
Kaj menite o članku, prijatelji? Vabimo vas na , ki bo danes ob 20.00. V okviru spletnega seminarja bomo razpravljali o tem, kako zgraditi učinkovite in razširljive podatkovne sisteme za majhna podjetja ali startupe z minimalnimi stroški. V praksi se bomo seznanili z orodji za obdelavo podatkov Google Cloud. Se vidimo!
Izvor: habr.com
