

Moje ime je Viktor Jagofarov, in sem odgovoren za razvoj platforme Kubernetes v podjetju DomKlik kot tehnični vodja razvoja v ekipi Ops (obratovanje). Rad bi spregovoril o delovanju naših procesov Dev Ops, o značilnostih obratovanja enega največjih k8s grozdov v Rusiji ter o DevOps/SRE praksah, ki jih uporablja naša ekipa.
Ekipa Ops
V ekipi Ops trenutno dela 15 ljudi. Trije od njih skrbijo za pisarno, dva delata v drugem časovnem pasu in sta na voljo tudi ponoči. Tako je vedno nekdo iz ekipe Ops pred zaslonom in pripravljen reagirati na incident katere koli kompleksnosti. Nimamo nočnih izmen, kar ohranja naše duševno zdravje in omogoča vsem, da se naspijo in preživijo prosti čas ne samo za računalnikom.
Vsak ima različne kompetence: omrežni inženirji, DBA, strokovnjaki za ELK sklad, Kubernetes skrbniki/razvijalci, specialisti za spremljanje, virtualizacijo, strojno opremo itd. Vse nas povezuje eno - vsak lahko nekako nadomesti katerega od nas: na primer, dodati nove vozlišča v k8s grozd, posodobiti PostgreSQL, napisati CI/CD pipeline + Ansible, avtomatizirati kaj v Python/Bash/Go, povezati strojno opremo v podatkovnem centru. Močne kompetence na določenem področju ne ovirajo prehoda na drugo področje in začetek izpopolnjevanja v novi disciplini. Na primer, v podjetje sem se zaposlil kot specialist za PostgreSQL, zdaj pa je moja glavna odgovornost k8s grozdi. V ekipi je vsak rast zelo dobrodošla in imamo močno čut za medsebojno podporo.
Sicer, iščemo nove sodelavce. Zahteve do kandidatov so precej standardne. Osebno mi je pomembno, da se oseba vklopi v ekipo, da je nenaporna in hkrati sposobna zagovarjati svoje stališče, da si želi napredovati in se ne boji novosti ter predlaga svoje ideje. Prav tako so obvezne veščine programiranja v skriptnih jezikih, poznavanje osnov Linuxa in znanje angleščine. Angleščina je potrebna preprosto zato, da lahko v primeru težav oseba poišče rešitev na spletu v 10 sekundah in ne v 10 minutah. S strokovnjaki z globokim znanjem Linuxa je danes zelo težko: smešno je, a dva od treh kandidatov ne moreta odgovoriti na vprašanje „Kaj je Load Average? Iz česa je sestavljen?“, medtem ko vprašanje „Kako zbrati core dump iz C-programa“ obravnavajo kot nekaj iz sveta superjunakov… ali dinozavrov. S tem se moramo sprijazniti, saj imajo ljudje običajno zelo razvite druge kompetence, „linuksa“ pa jih bomo naučili. Odgovor na vprašanje „zakaj vse to mora vedeti DevOps inženir v sodobnem svetu oblakov“ bomo pustili zunaj tega članka, a v treh besedah: vse to je potrebno.
Ekipa Orodja
Ekipa Orodja igra pomembno vlogo v avtomatizaciji. Njihova glavna naloga je ustvarjanje priročnih grafičnih in CLI orodij za razvijalce. Na primer, naša interna rešitev Confer omogoča, da v le nekaj klikih miške uvedemo aplikacijo v Kubernetes, nastavimo vire, ključe iz vault itd. Prej smo imeli Jenkins + Helm 2, a smo morali razviti svoj lastni instrument, da bi izključili kopiranje in lepljenje ter prinesli doslednost v življenjski cikel programske opreme.
Ekipa Ops ne piše pipelines za razvijalce, vendar lahko svetuje glede vseh vprašanj pri njihovem pisanju (nekaterim je še ostal Helm 3).
DevOps
Kar se tiče DevOps, ga vidimo takole:
Ekipa Dev piše kodo in jo uvede preko Confer v dev -> qa/stage -> prod. Odgovornost za to, da koda ne povzroča zastojev in napak, leži na ekipah Dev in Ops. Čez dan mora na incident s svojo aplikacijo najprej reagirati dežurni iz ekipe Ops, ponoči pa mora dežurni skrbnik (Ops) zbuditi dežurnega razvijalca, če je prepričan, da težava ni v infrastrukturi. Vse metrike in alarmi v monitoringu se pojavijo samodejno ali polavtomatsko.
Odgovornost Ops-a počinje s trenutkom kada se aplikacija postavi u produkciju, ali odgovornost Dev-a tu ne prestaje — radimo zajedno i u istom čamcu.
Programeri savetuju administratore ako im je potrebna pomoć pri pisanju administratorskog mikrosluga (na primer, Go backend + HTML5), dok administratori savetuju programere o svim infrastrukturnim pitanjima, ili pitanjima vezanim za k8s.
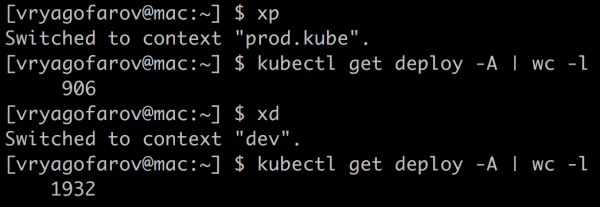
Usput, nemamo monolit, samo mikroslužbe. Njihov broj trenutno se kreće između 900 i 1000 u prod k8s klasteru, kada merimo po količini. deploymentsBroj podova varira između 1700 i 2000. Podova u prod klasteru sada je oko 2000.
Ne mogu dati tačne brojke, jer pratimo nepotrebne mikroslužbe i uklanjamo ih poluautomatski. Pratiti nepotrebne entitete u k8s pomaže nam , što uveliko štedi resurse i novac.
Upravljanje z viri
Nadzor
Ključna tačka u eksploataciji velikog klastera postaje pravilno uspostavljen i informativan monitoring. Još nismo pronašli univerzalno rešenje koje bi pokrilo 100% svih zahteva za monitoringom, pa povremeno pravimo različita prilagođena rešenja u ovom prostoru.
- Zabbix. Stari dobri monitoring, koji je prvenstveno namenjen praćenju opšteg stanja infrastrukture. On nam govori kada node umire zbog CPU-a, memorije, diskova, mreže i tako dalje. Ništa natprirodno, ali takođe imamo posebni DaemonSet agenata, pomoću kojih, na primer, pratimo stanje DNS-a u klasteru: tražimo usporene podove coredns, proveravamo dostupnost spoljašnjih hostova. Činilo bi se da nema potrebe zamarati se oko toga, ali na velikim proticima ovaj komponent postaje ozbiljna tačka kvara. Već sam ranije , kako sam se borio protiv performansi DNS-a u klasteru.
- Prometheus Operator. Skup različitih eksportera daje dobar pregled svih komponenti klastera. Zatim to vizualizujemo na velikim dashboard-ima u Grafani, a za obaveštenja koristimo alertmanager.
Još jedan koristan alat za nas postao je . Skrbeli smo to po tem, ko smo se večkrat srečali s situacijo, kjer ena ekipa prekriva svoj Ingress s potmi druge ekipe, kar je povzročilo napake 50x. Zdaj pred prenosom na produkcijo razvijalci preverijo, da ne bodo nikogar prizadeli, za mojo ekipo pa je to dober instrument za začetno diagnostiko težav z Ingressi. Zabavno je, da je bil sprva napisan za skrbnike in je izgledal precej 'nepregledno', a po tem, ko je orodje postalo priljubljeno med dev ekipami, se je močno preoblikovalo in ne izgleda več kot 'skrbnik je naredil spletno vmesnik za skrbnike'. Kmalu se bomo tega orodja znebili in podobne situacije bodo veljavne še pred izidom pipeline.
Viri ekip v 'Kubu'
Preden se lotimo primerov, je smiselno razložiti, kako pri nas poteka dodeljevanje virov za mikrostoritev.
Da bi razumeli, katere ekipe in v kakšnih količinah uporabljajo svoje virov (procesor, pomnilnik, lokalni SSD), dodelimo vsaki ekipi svoje namespace v 'Kubu' in omejimo njegove maksimalne zmogljivosti po procesorju, pomnilniku in disku, prej pa se dogovorimo o potrebah ekip. Posledično ena ekipa, na splošno, ne bo blokirala celotnega klustra za prenos, ko si bo dodelila tisoče jeder in terabajte pomnilnika. Dostopi v namespaces se podelijo preko AD (uporabljamo RBAC). Namespace-i in njihovi limiti se dodajajo preko pull requesta v GIT repozitorij, nato pa se preko Ansible pipeline-a vse avtomatsko razporedi.
Primer dodelitve virov za ekipo:
namespaces:

  chat-team:
    pods: 23
    limits:
      cpu: 11
      memory: 20Gi
    requests:
      cpu: 11
      memory: 20Gi
Zahteve in limiti
V 'Kubu' Request — to je količina zagotovljenih rezerviranih virov za pod (eno ali več docker kontejnerjev) v klastru. Limit — to je nezagotovljen maksimum. Pogosto je mogoče videti na grafih, kako je neka ekipa postavila preveč zahtev na vseh svojih aplikacijah in ne more prenesti aplikacije v 'Kub', ker so vsi request-i pod njihovim namespace-om že 'porabljeni'.
Pravi izhod iz takšne situacije: gledati pravo porabo virov in jo primerjati z zahtevano količino (Request).
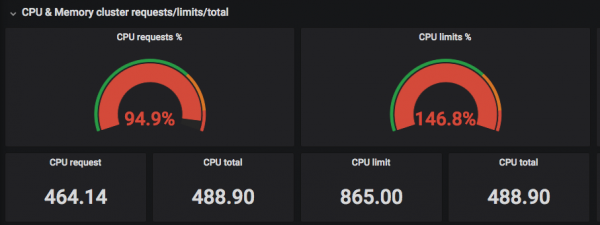
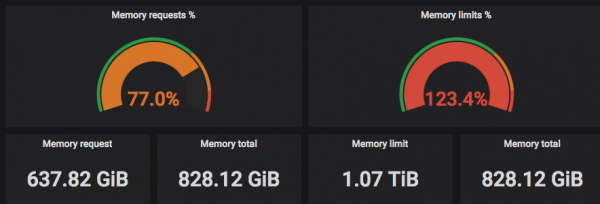
Na zgoraj prikazanih posnetkih zaslona je vidno, da se 'zahtevani' (Requested) CPU prilagajajo realnemu številu niti, medtem ko lahko Limits presegajo realno število procesorskih jeder =)
Zdajmo se natančno osredotočimo na nek namespace (izbral sem namespace kube-system — sistemski namespace za komponente samega 'Kuba') in poglejmo razmerje med dejansko porabljenim procesorskim časom in spominom ter zahtevanjem:
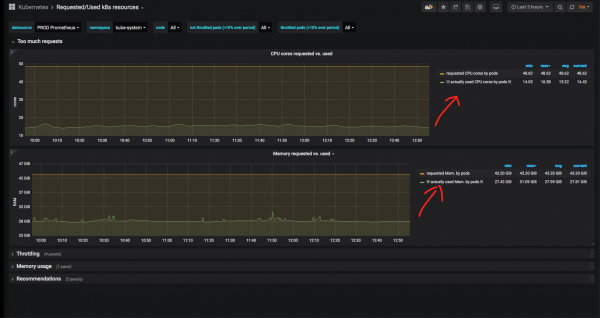
Očitno je, da je spomina in CPU rezerviranega za sistemske storitve precej več, kot se dejansko uporablja. V primeru kube-system je to upravičeno: zgodilo se je, da sta nginx ingress controller ali nodelocaldns na vrhuncu padla na CPU in porabila zelo veliko RAM-a, zato je takšna rezerva upravičena. Poleg tega se ne moremo zanašati na grafikone zadnjih 3 ur: bolje bi bilo videti zgodovinske metrike za daljše časovno obdobje.
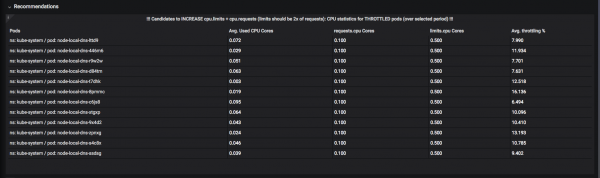
Razvit je bil sistem 'priporočil'. Na primer, tukaj lahko vidite, katerim virom bi bilo bolje povečati 'meje' (zgornja dovoljena meja), da ne bi prišlo do 'trotlinanja' (throttling): trenutka, ko je CPU ali spomin že porabljen za dodeljeni časovni kvant in čaka, da ga 'odmrznejo':
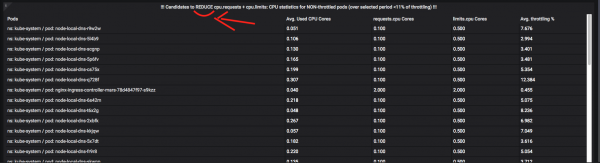
In tukaj so podi, ki bi morali omejiti svoje apetite:
O trotlinanje + o spremljanju virov lahko napišemo več člankov, zato postavljajte vprašanja v komentarjih. Na kratko lahko rečem, da je naloga avtomatizacije takšnih metrik precej zapletena in zahteva veliko časa ter akrobatike z 'okenskimi' funkcijami in 'CTE' Prometheus / VictoriaMetrics (ti izrazi so v narekovajih, ker v PromQL skoraj ni nič podobnega, in moramo sestaviti strašne poizvedbe na več zaslonih besedila in se ukvarjati z njihovo optimizacijo).
Na koncu imajo razvijalci orodja za spremljanje svojih namespaces v 'Kubu', in sami lahko izberejo, kje in kdaj katere aplikacije lahko 'režejo' vire, ter katerim podom lahko za celo noč dodelijo cel CPU.
Metodologije
V podjetju, kot je zdaj moderno, se držimo DevOps- in SRE-praks. Ko ima podjetje 1000 mikrostoritev, približno 350 razvijalcev in 15 administratorjev za celotno infrastrukturo, je potrebno biti 'moderen': za vsemi temi 'buzzwordi' se skriva ostra potreba po avtomatizaciji vsega in vsakega, administratorji pa ne smejo biti zamašek v procesih.
Kot Ops zagotavljamo različne metrike in nadzorne plošče za razvijalce, povezane s hitrostjo odziva storitev in njihovimi napakami.
Uporabljamo takšne metodologije, kot so: , in , kombiniranjem zajedno. Pokušavamo minimizirati broj kontrolnih ploča tako da na prvi pogled bude jasno koji servis trenutno ima problema (na primjer, kodovi odgovora u sekundi, vreme odgovora u 99-percentilu) itd. Čim postanu potrebne neke nove metrike za sveobuhvatne kontrolne ploče, odmah ih kreiramo i dodajemo.
Nisam pravio grafike već mesec dana. Verovatno je to dobar znak: to znači da su većina 'želja' realizovane. Dešavalo se da tokom nedelje bar jednom dnevno pravim neki novi graf.
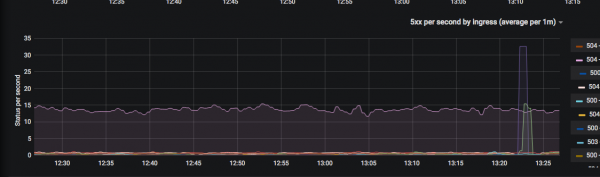
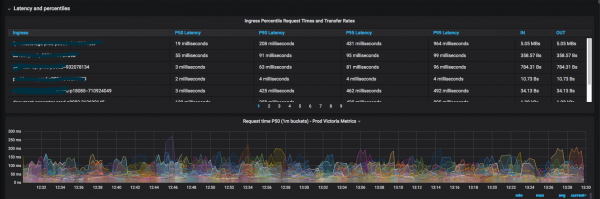
Dobijeni rezultat je vredan time što sada programeri retko dolaze do administratora sa pitanjima 'gde mogu da pogledam neku metriku'.
Implementacija Service Mesh nije daleko i trebalo bi svima olakšati život, kolege iz Tools su već blizu implementacije apstraktnog 'Istio zdravog čoveka': životni ciklus svakog HTTP(s) zahteva biće vidljiv u monitoring sistemu, i uvek će moći da se razume 'na kojoj tački je sve pošlo po zlu' u međuservisnoj (i ne samo) interakciji. Pretplatite se na vesti kompanije DomKlik. =)
Podrška za Kubernetes infrastrukturu
Istorijski gledano, koristimo patch-ovanu verziju Kubespray — Ansible uloga za postavljanje, proširenje i ažuriranje Kubernetesa. U jednom trenutku iz glavne grane je izbačena podrška za non-kubeadm instalacije, a proces prelaska na kubeadm nije bio predložen. Na kraju, kompanija Southbridge je napravila svoj fork (s podrškom za kubeadm i brzim rešenjem kritičnih problema).
Proces ažuriranja svih k8s klastera izgleda ovako:
- Uzmemo Kubespray od Southbridge, uporedimo sa našom granom, merge-ujemo.
- Postavljamo ažuriranje u Stress- 'Kub'.
- Postavljamo ažuriranje po jednoj nodi (u Ansible-u je to 'serial: 1') u Dev- 'Kub'.
- Ažuriramo Prod subotom uveče po jednoj nodi.
U budućnosti imamo planove da zamenimo Kubespray nečim bržim i pređemo na kubeadm.
Ukupno imamo tri 'Kuba': Stress, Dev i Prod. Planiramo da pokrenemo još jedan (hot standby) Prod 'Kub' u drugom datacentru. Stress in Dev žive u 'virtuelnim mašinama' (oVirt za Stress i VMWare cloud za Dev). Prod- 'Kub' živi na 'golem železu' (bare metal): to su jednake nodi sa 32 CPU niti, 64-128 GB RAM-a i 300 GB SSD RAID 10 — ukupno ih ima 50. Tri 'tanke' nodi su izdvojene za 'master' Prod-'Kuba': 16 GB RAM-a, 12 CPU niti.
Za produkciju preferiramo da koristimo 'golo željezo' i izbegavamo dodatne slojeve poput OpenStack: ne trebaju nam 'bučni susedi' i CPU steal time. In-house OpenStack management complexity roughly doubles.
For CI/CD of microservices and other infrastructure components, we use a separate GIT server, Helm 3 (we transitioned from Helm 2 rather painfully, but are very pleased with this option, atomic), Jenkins, Ansible, and Docker. We love feature branches and deploying to different environments from a single repository.
Zaključek
This is generally how the DevOps process appears from the perspective of an operations engineer at DomClick. The article turned out to be less technical than I expected: therefore, keep an eye on DomClick's news on Habrahabr: there will be more 'hardcore' articles about Kubernetes and beyond.
Izvor: habr.com
