

Izvor:
Linearno regresijo lahko štejemo za enega od osnovnih algoritmov v mnogih področjih, povezanih z analizo podatkov. Razlog za to je očiten. To je zelo preprost in razumljiv algoritem, kar spodbuja njegovo široko uporabo že desetletja, če ne stoletja. Ideja je enostavna; predpostavljamo linearno odvisnost ene spremenljivke od niza drugih spremenljivk, nato pa poskušamo to odvisnost obnoviti.
Vendar pa v tem članku ne bomo obravnavali uporabe linearne regresije za reševanje praktičnih težav. Obravnavali bomo zanimive značilnosti izvajanja porazdeljenih algoritmov za njeno obnovitev, s katerimi smo se srečali pri pisanju modula za strojno učenje v . Nekaj osnovne matematike, temelj strojnega učenja in porazdeljenega računalništva bo pomagalo razumeti, kako obnoviti linearno regresijo, tudi če so podatki razpršeni med tisoči vozlišč.
O čem govorimo?
Pred nami je naloga obnove linearne odvisnosti. Kot vhodni podatki imamo množico vektorjev domnevno neodvisnih spremenljivk, katerim je pripojeno določeno vrednost odvisne spremenljivke. Te podatke lahko predstavimo v obliki dveh matrik:

Zdaj, saj predpostavljamo odvisnost, in še to linearno, zapišimo naše predpostavke v obliki produkta matrik (za poenostavitev zapisa se bo tukaj in naprej domnevalo, da je prosti člen enačbe skrit za  , zadnji stolpec matrike
 vsebuje enice):

Zelo podobno kot sistem linearnih enačb, a ne? Zdi se, vendar rešitve za tak sistem enačb verjetno ne bo. Razlog je šum, ki je prisoten v skoraj vseh realnih podatkih. Prav tako lahko razlog za to pomanjkanje linearne odvisnosti, s katero se lahko borimo z uvedbo dodatnih spremenljivk, ki so nelinearno odvisne od izvirnih. Oglejmo si naslednji primer:
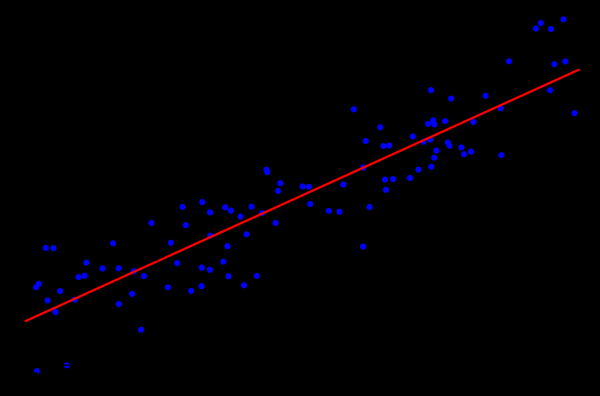
Izvor:
To je preprost primer linearne regresije, ki prikazuje odvisnost ene spremenljivke (na osi  ) od druge spremenljivke (na osi
 ). Da bi sistem linearnih jednačina imao rešenje, sve tačke moraju ležati tačno na jednoj pravoj. Međutim, to nije slučaj. A ne leže na jednoj pravoj upravo zbog šuma (ili zato što je pretpostavka o postojanju linearne zavisnosti bila pogrešna). Tako da je, kako bismo rekonstruisali linearnu zavisnost prema stvarnim podacima, obično potrebno uvesti još jednu pretpostavku: ulazni podaci sadrže šum i taj šum ima . Mogu se praviti pretpostavke i o drugim tipovima raspodela šuma, ali u pretežnoj većini slučajeva se razmatra baš normalna raspodela, o kojoj će biti reči u nastavku.
Metod maksimalne verovatnoće
. Dakle, pretpostavili smo prisustvo slučajnog normalno raspoređenog šuma. Šta učiniti u takvoj situaciji? Za ovaj slučaj u matematici postoji i široko se koristi . Ukratko, suština je u odabiru i njenoj kasnijoj maksimalizaciji.
Vraćamo se rekonstrukciji linearne zavisnosti prema podacima sa normalnim šumom. Primećujemo da predložena linearna zavisnost predstavlja matematičko očekivanje  postojećeg normalnog rasporeda. U isto vreme, verovatnoća da
 uzima određenu vrednost, pod uslovom da su prisutni posmatrani
 , izgleda ovako:

Sada ćemo umesto  in
 ubaciti potrebne varijable:

Preostaje samo da pronađemo vektor  , pri kojem je ova verovatnoća maksimizovana. Da bismo maksimalizovali takvu funkciju, zgodno je prvo je prilogarifmovati (logaritam funkcije će dostići maksimum u istoj tački kao i sama funkcija):

Što, zauzvrat, svodi na minimizaciju sledeće funkcije:

Usput, ovo se naziva metodom . Često se sve navedene rasprave preskoče i koristi se samo ova metoda.
QR razlaganje
Minimum navedene funkcije može se naći ako se pronađe tačka u kojoj je gradijent ove funkcije jednak nuli. A gradijent će biti zapisan na sledeći način:

je matrična metoda rešavanja problema minimizacije koja se koristi u metodu najmanjih kvadrata. U tom svetlu, prepisujemo jednačinu u matričnom obliku:

Dakle, raspoređujemo matricu  na matrice
 in
 in izvajamo vrsto transformacij (sam algoritem QR razcepitve tukaj ne bo obravnavan, le njegova uporaba v zvezi z zastavljeno nalogo):

Matrika  je ortogonalna. To nam omogoča, da se znebimo produkta
 :

Če zamenjamo  na
 , dobimo
 . Glede na to, da
 je zgornja trikotna matrika, to izgleda takole:

To lahko rešimo z metodo substitucije. Element  se izračuna kot
 , prejšnji element
 se izračuna kot
 in tako naprej.
Tukaj je treba omeniti, da je kompleksnost nastalega algoritma zaradi uporabe QR razcepitve enaka  . Kljub temu, da se množenje matric dobro paralelizira, se učinkovita razpršena različica tega algoritma ne zdi mogoča.
Gradientni spust
Ko govorimo o minimizaciji neke funkcije, se vedno spomnimo na metodo (stohastičnega) gradientnega spuščanja. To je preprosta in učinkovita metoda minimizacije, ki temelji na iterativnem izračunu gradienta funkcije v točki in njenem kasnejšem premikanju v nasprotno smer od gradienta. Vsak tak korak približa rešitev k minimumu. Gradient je pri tem videti enako:

Ta metoda se dobro paralelizira in razporeja zaradi linearnih lastnosti gradientnega operatorja. Opažamo, da so v zgoraj navedeni formuli pod znakom seštevka neodvisni člani. Z drugimi besedami, gradient lahko izračunamo neodvisno za vse indekse  od prvega do
 , hkrati pa izračunamo gradient za indekse od
 do
 . Nato se seštejejo pridobljeni gradienti. Rezultat seštevanja bo enak, kot če bi neposredno izračunali gradient za indekse od prvega do
 . Tako, če so podatki razdeljeni med več delov podatkov, se gradient lahko izračuna neodvisno na vsaki delu, nato pa se rezultati teh izračunov lahko seštejejo za pridobitev končnega rezultata:

Z vidika implementacije to sledi paradigmi . Na vsakem koraku gradientnega spuščanja se vsakemu podatkovnemu vozlišču pošlje naloga za izračun gradienta, nato se izračunani gradienti zberejo skupaj, in rezultat njihovega seštevanja se uporablja za izboljšanje rezultata.
Kljub svoji preprostosti pri implementaciji in možnosti izvajanja v paradigmi MapReduce ima gradientni spust tudi svoje pomanjkljivosti. Zlasti je število korakov, potrebnih za dosego konvergence, znatno večje v primerjavi z drugimi bolj specializiranimi metodami.
LSQR
je še ena metoda za reševanje zastavljenega problema, ki je primerna tako za obnovo linearne regresije kot za reševanje sistemov linearnih enačb. Njegova glavna značilnost je, da združuje prednosti matričnih metod in iterativnega pristopa. Implementacije te metode so na voljo tako v knjižnicah , kot tudi v . Opis te metode ne bo podan (lahko ga najdete v članku ). Namesto tega bo prikazan pristop, ki omogoča prilagajanje LSQR za izvajanje v distribuiranem okolju.
Osnova metode LSQR je . To je iterativni postopek, vsaka iteracija pa obsega naslednje korake:
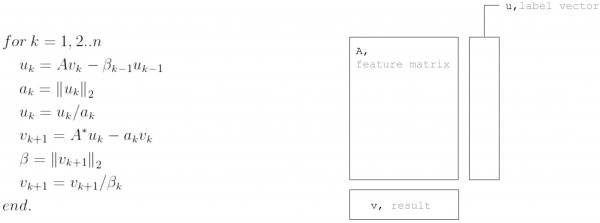
Vendar, če predpostavimo, da je matrica  horizontalno razdeljena, lahko vsako iteracijo predstavimo kot dva koraka MapReduce. Tako se zmanjša prenosi podatkov med posameznimi iteracijami (samo vektorji dolžine, enake številu neznank):
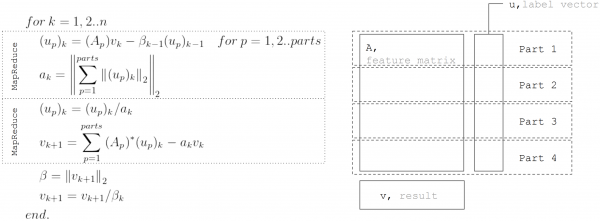
Ta pristop se uporablja pri implementaciji linearne regresije v .
Zaključek
Obstaja veliko algoritmov za obnovo linearne regresije, vendar vsi ne morejo biti uporabljeni v vseh pogojih. Na primer, QR razcepitev je odlična za natančno rešitev na majhnih podatkovnih množicah. Gradientni spust se preprosto implementira in hitro najde približno rešitev. LSQR pa združuje najboljše lastnosti prejšnjih dveh algoritmov, saj ga je mogoče distribuirati, hitreje konvergira v primerjavi z gradientnim spustom in omogoča zgodnje ustavljanje algoritma v nasprotju z QR razcepitvijo za iskanje približne rešitve.
Izvor: habr.com
