

Leta 2019 še nismo imeli standardne rešitve za agregacijo logov v Kubernetesu. V tem članku bi radi delili svoje iskanje, težave in rešitve, s katerimi smo se srečevali, ob uporabi primerov iz prakse.
Vendar pa najprej dodam, da različni naročniki različno razumejo zbiranje logov:
- nekateri želijo videti varnostne in revizijske loge;
- nekateri – centralizirano beleženje celotne infrastrukture;
- nekaterim zadostuje zbiranje le logov aplikacij, izključujoč, na primer, balansirnike.
O tem, kako smo uresničevali različne želje in s katerimi težavami smo se srečali, – pod nadaljevanjem.
Teorija: o orodjih za loge
Ozadje o komponentah sistema za beleženje
Beleženje logov je prešlo dolgo pot, pri čemer so se razvile metodologije zbiranja in analize logov, ki jih uporabljamo danes. Že v 50-ih letih prejšnjega stoletja je v Fortranu nastala podobna standardnim tokovom vhodov-izhodov, ki so programerjem pomagali pri odpravljanju napak v njihovih programih. To so bili prvi računalniški logi, ki so olajševali življenje programerjem tiste dobe. Danes v njih vidimo prvi komponent sistema za beleženje – vir ali "proizvajalec" (producer) logov.
Računalniška znanost ni obstala: pojavile so se računalniške mreže, prvi klasterji… Začele so delovati kompleksne sisteme, sestavljene iz več računalnikov. Zdaj so sistemski administratorji morali zbirati loge z več strojev, v posebnih primerih pa so lahko dodali tudi sporočila jedra operacijskega sistema za primer, da bi raziskali sistemski zlom. Da bi opisali sisteme centraliziranega zbiranja logov, je na začetku 2000-ih izšel , ki je standardiziral remote_syslog. Tako se je pojavil še en pomemben komponent: zbiralec (collector) logov in njihovo skladišče.
Z naraščanjem obsega logov in širjenjem spletnih tehnologij se je postavilo vprašanje o tem, kako loge enostavno prikazati uporabnikom. Na mesto preprostih konzolnih orodij (awk/sed/grep) so prišli bolj napredni ogledovalniki logov – tretji komponent.
S povečanjem obsega logov je postalo jasno še nekaj: logi so potrebni, vendar ne vsi. Poleg tega različni logi zahtevajo različno stopnjo ohranjenosti: nekatere lahko izgubimo že po dnevu, druge pa je treba hraniti 5 let. Tako se je sistemu za logiranje dodala komponenta za filtriranje in usmerjanje podatkovnih tokov — poimenujmo jo filter.
Shranjevanja so prav tako doživela resen napredek: z običajnih datotek so prešli na relacijske baze podatkov, nato pa na dokumentno usmerjena shranjevanja (na primer, Elasticsearch). Tako se je shranjevanje ločilo od zbiralnika.
Na koncu se je sama definicija loga razširila na nekakšen abstrakten tok dogodkov, ki jih želimo shranjevati za zgodovino. Natančneje — v primeru, ko bo potrebno izvesti preiskavo ali pripraviti analitično poročilo…
Zato se je v dosti kratkem času zbiranje logov razvilo v pomemben podsistem, ki ga lahko upravičeno imenujemo kot enega od podsektorjev v Big Data.
Če so bili nekoč običajni printi dovolj za »sistem logiranja«, se je zdaj situacija močno spremenila.
Kubernetes in logi
Ko je v infrastrukturo prišel Kubernetes, je obstoječa težava zbiranja logov obstajala tudi pri njem. V nekem smislu je postala še bolj boleča: upravljanje infrastrukturne platforme je bilo ne samo poenostavljeno, ampak hkrati tudi zapleteno. Mnogi stari servisi so začeli migracijo na mikroservisne poti. V kontekstu logov se je to izrazilo v rastočem številu virov logov, njihovem posebnem življenjskem ciklu in potrebi po sledenju medsebojnim povezavam vseh komponent sistema preko logov…
Če se vrnemo naprej, lahko ugotovim, da trenutno, na žalost, ne obstaja standardizirana različica logiranja za Kubernetes, ki bi se ugodno razlikovala od vseh ostalih. Najbolj priljubljene sheme v skupnosti so:
- nekateri postavljajo sklad EFK (Elasticsearch, Fluentd, Kibana);
- neki — preizkuša nedavno izdano ali uporablja ;
- nas (morda pa ne samo nas?..) v mnogih pogledih zadostuje lastna rešitev — …
Ponavadi uporabljamo takšne povezave v K8s grozdih (za self-hosted rešitve):
- ;
- .
Vendar se ne bom osredotočil na navodila za njihovo namestitev in konfiguracijo. Namesto tega se bom osredotočil na njihove pomanjkljivosti in širše zaključke o situaciji z logi na splošno.
Praksa z logi v K8s
»Vsakodnevni logi«, koliko vas je?..
Centralizirano zbiranje logov z dovolj obsežno infrastrukturo zahteva precejšnje vire, ki se porabijo za zbiranje, shranjevanje in obdelavo logov. Med izvajanjem različnih projektov smo se srečali z različnimi zahtevami in težavami, ki so iz tega izhajale.
Poskusimo ClickHouse
Oglejmo si centralizirano shrambo na projektu z aplikacijo, ki precej aktivno generira loge: več kot 5000 vrstic na sekundo. Začnemo z njegovimi logi, ki jih shranjujemo v ClickHouse.
Ko bo potrebna maksimalna realnost, bo 4-jedrni strežnik s ClickHouse že preobremenjen zaradi disčne podkapacitete:
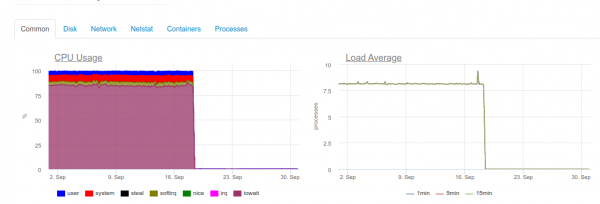
Takšna vrsta obremenitve je povezana s tem, da poskušamo čim hitreje zapisovati v ClickHouse. In na to baza podatkov reagira z večjo obremenitvijo diska, zaradi česar lahko pride do takšnih napak:
DB::Exception: Preveč delov (300). Spajanja potekajo bistveno počasneje kot vstavljanja
Gre za to, da v ClickHouse (v njih ležijo podatki logov) imajo svoje zapletenosti pri operacijah zapisa. Vstavljeni podatki generirajo začasno particijo, ki se nato zlije z glavno tabelo. Posledično je zapis zelo zahteven za disk, na to pa se razteza tudi omejitev, o kateri smo bili obveščeni zgoraj: v 1 sekundi se lahko zlije ne več kot 300 sub-particij (dejansko to pomeni 300 insertov na sekundo).
Da bi se izognili takšnemu vedenju, kar se da velikimi količinami in ne pogosteje kot 1-krat na 2 sekundi. Vendar pa zapisovanje velikimi količinami pomeni, da bomo morali redkeje pisati v ClickHouse. To lahko povzroči preobremenitev predpomnilnika in izgubo logov. Rešitev je povečati predpomnilnik Fluentd, vendar se bo posledično povečala tudi poraba pomnilnika.
Napomena: Druga problematična stran naše rešitve s ClickHouse je bila povezana s tem, da je particioniranje v našem primeru (loghouse) izvedeno preko zunanjih tabel, povezanih . To je razlog, da pri poizvedbah za dolga časovna obdobja potrebuje preveč pomnilnika, saj metatabla preiskuje vse particije - tudi tiste, za katere je očitno, da ne vsebujejo potrebnih podatkov. Vendar pa lahko zdaj tak pristop brez zadržkov razglasimo za zastarel v aktualnih različicah ClickHouse (c ).
Zato postane jasno, da za zbiranje dnevnikov v realnem času ClickHouse ne zadostuje sredstev za vsak projekt (natančneje, njihova porazdelitev ne bo smiselna). Poleg tega bo potrebno uporabiti akumulator, h kateremu se še vrnemo. Opišemo primer — to je resničen. In v tistem trenutku nismo mogli ponuditi zanesljivega in stabilnega rešitve, ki bi ustrezala naročniku in omogočila zbiranje dnevnikov z minimalno zamudo …
Kaj pa Elasticsearch?
Znano je, da se Elasticsearch spopada z velikimi obremenitvami. Poskusimo ga v istem projektu. Sedaj obremenitev izgleda takole:
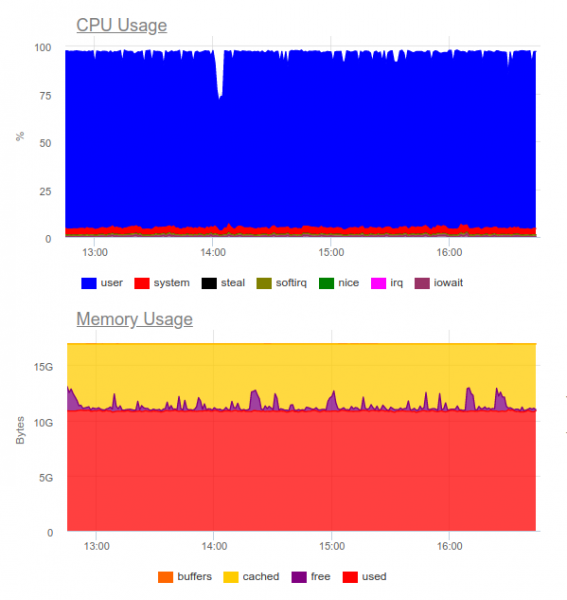
Elasticsearch je zmogel predelati tok podatkov, vendar zapisovanje takšnih količin vanj močno obremenjuje CPU. To se reši z organizacijo klasterja. Čisto tehnično to ni problem, a izkaže se, da samo za delovanje sistema zbiranja dnevnikov že uporabljamo približno 8 jeder in imamo dodatno močno obremenjen komponent v sistemu …
Zaključek: ta možnost je lahko opravičena, vendar le, če je projekt velik in je njegovo vodstvo pripravljeno porabiti bistvena sredstva za sistem centraliziranega dnevničnega beleženja.
Takrat se pojavi logično vprašanje:
Kateri dnevniki so dejansko potrebni?
 Poskusimo spremeniti sam pristop: dnevniki morajo biti hkrati informativni in ne pokrivati vsak dogodek v sistemu.
Recimo, da imamo uspešno spletno trgovino. Kateri dnevniki so pomembni? Zbirati največ informacij, na primer, z plačilnega prehoda - odlična ideja. Toda za storitev za obrezovanje slik v katalogu izdelkov so nam kritični le nekateri dnevniki: dovolj so le napake in razširjeno spremljanje (na primer, odstotek 500-ih napak, ki jih generira ta komponenta).
Tako smo prišli do tega, da centralizirano dnevniško beleženje ni vedno opravičeno. Zelo pogosto želi stranka zbrati vse dnevnike na enem mestu, medtem ko v resnici iz vseh dnevnikov potrebujemo le približno 5 % sporočil, ki so kritična za poslovanje:
- Včasih je dovolj, da nastavite, recimo, samo velikost dnevnika kontejnerja in zbiratelj napak (na primer, Sentry).
- Za preiskovanje incidentov je pogosto dovolj obvestilo o napaki in seveda velik lokalni dnevnik.
- Imeli smo projekte, ki so se povsem zanašali izključno na funkcionalne teste in sisteme za zbiranje napak. Razvijalcu dnevniki niso bili potrebni — vse je videl po sledih napak.
Ilustracija iz običajnega življenja
Dober primer je lahko druga zgodba. Prejeli smo zahtevo od ekipe varnostnikov enega od strank, ki je že uporabljala komercialno rešitev, razvito dolgo pred uvedbo Kubernetes.
Bilo je potrebno 'prijateljsko povezo' sistema centraliziranega zbiranja dnevnikov s podjetniškim senzorjem za odkrivanje težav — QRadar. Ta sistem zna sprejemati dnevnike preko protokola syslog in jemati preko FTP. Vendar pa ga takoj ni bilo mogoče integrirati s vtičnikom remote_syslog za fluentd. (kot se je izkazalo, ). Težave z nastavitvijo QRadar so bile na strani ekipe varnostnikov stranke.
Zaradi tega je del dnevnikov, kritičnih za poslovanje, nalagal na FTP QRadar, drugi del pa je bil preusmerjen preko remote syslog neposredno z vozlišč. Za to smo celo napisali — morda bo pomagal nekomu rešiti podoben problem... Zasnova je stranki omogočila, da je prejemala in analizirala kritične dnevnike (s pomočjo svojega priljubljenega orodja), mi pa smo lahko zmanjšali stroške sistema za beleženje, obdržali pa le zadnji mesec.
Še en primer je precej poučen v tem, kako ne ravnati. Eden od naših strank je za obdelavo svaki dogodka, ki ga prejme od uporabnika, ustvaril večvrstni nestructuriran izpis informacij v dnevniku. Koliko lahko domnevamo, da je bilo take dnevnike izjemno neprijetno brati in shranjevati.
Kriteriji za dnevnike
Takšni primeri nas pripeljejo do zaključka, da poleg izbire sistema za zbiranje dnevnikov moramo načrtovati tudi same dnevnike! Kakšni so tu zahteve?
- Dnevniki morajo biti v strojno berljivem formatu (na primer, JSON).
- Dnevniki morajo biti kompaktni in omogočiti spreminjanje stopnje beleženja, da se odpravijo morebitne težave. Pri tem je treba v proizvodnih okoljih zagnati sisteme z nivojem beleženja, kot je Opozorilo ili Napaka.
- Dnevi morajo biti normalizirani, kar pomeni, da morajo imeti vse vrstice v dnevniku enako vrsto polja.
Nestrukturirani dnevi lahko povzročijo težave pri nalaganju dnevnikov v skladišče in popolno zaustavitev njihove obdelave. Kot primer navedimo to napako 400, s katero so se mnogi srečali v dnevnikih fluentd:
2019-10-29 13:10:43 +0000 [warn]: dump an error event: error_class=Fluent::Plugin::ElasticsearchErrorHandler::ElasticsearchError error="400 - Rejected by Elasticsearch"
Napaka pomeni, da pošiljate v indeks z že pripravljenim mappingom polje, katerega tip ni stabilen. Najlažji primer je polje v dnevniku nginx z spremenljivko $upstream_status. V njem je lahko tako številka kot tudi niz. Na primer:
{ "ip": "1.2.3.4", "http_user": "-", "request_id": "17ee8a579e833b5ab9843a0aca10b941", "time": "29\/Oct\/2019:16:18:57 +0300", "method": "GET", "uri": "\/staffs\/265.png", "protocol": "HTTP\/1.1", "status": "200", "body_size": "906", "referrer": "https:\/\/example.com\/staff", "user_agent": "Mozilla\/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit\/537.36 (KHTML, like Gecko) Chrome\/78.0.3904.70 Safari\/537.36", "request_time": "0.001", "cache_status": "-", "upstream_response_time": "0.001, 0.007", "upstream_addr": "127.0.0.1:9000", "upstream_status": "200", "upstream_response_length": "906", "location": "staff"}
 { "ip": "1.2.3.4", "http_user": "-", "request_id": "47fe42807f2a7d8d5467511d7d553a1b", "time": "29\/Oct\/2019:16:18:57 +0300", "method": "GET", "uri": "\/staff", "protocol": "HTTP\/1.1", "status": "200", "body_size": "2984", "referrer": "-", "user_agent": "Mozilla\/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit\/537.36 (KHTML, like Gecko) Chrome\/78.0.3904.70 Safari\/537.36", "request_time": "0.010", "cache_status": "-", "upstream_response_time": "0.001, 0.007", "upstream_addr": "10.100.0.10:9000, 10.100.0.11:9000", "upstream_status": "404, 200", "upstream_response_length": "0, 2984", "location": "staff"}
V dnevnikih je vidno, da je strežnik 10.100.0.10 odgovoril z napako 404, zahteva pa je bila poslana na drug vsebinski skladišče. Kot posledica se je v dnevnikih vrednost spremenila v to:
"upstream_response_time": "0.001, 0.007"
To situacijo je toliko pogosto, da si je zaslužila celo posebno .
Kaj pa z zanesljivostjo?
Obstajajo primeri, ko so vsi dnevi brez izjem življenjsko pomembni. In s tem imajo tipične sheme zbiranja dnevnikov za K8s, ki so bile predlagane/pregledane zgoraj, težave.
Na primer, fluentd ne more zbrati dnevnikov iz kratkotrajnim kontejnerjev. V enem od naših projektov je kontejner za migracijo podatkov živel manj kot 4 sekunde, nato pa je bil izbrisan — v skladu z ustrezno oznako:
"helm.sh/hook-delete-policy": hook-succeeded
Zaradi tega dnevnik izvedbe migracije ni prišel v skladišče. V tem primeru lahko pomaga politika before-hook-creation.
Drug primer je rotacija dnevnikov Dockerja. Recimo, da obstaja aplikacija, ki aktivno piše v dnevnike. V normalnih razmerah uspevamo obdelati vse dneve, ampak takoj ko se pojavi težava — na primer, kot je bila opisana zgoraj s nepravilnim formatom — se obdelava ustavi, Docker pa rotira datoteko. Rezultat — lahko izgubimo kritične dnevniške podatke za poslovanje.
Zato pomembno je ločevati tokove dnevnikov, tako da vgradimo pošiljanje najbolj dragocenih podatkov neposredno v aplikacijo, da zagotovimo njihovo varnost. Poleg tega ne bo odveč ustvariti neke vrste »akumulatorja« dnevnikov, ki lahko preživi kratko nedostopnost skladišča pri ohranjanju kritičnih sporočil.
Nazadnje, ne smemo pozabiti, da je pomembno kakovostno nadzorovati vsak podsistem. Drugače se lahko enostavno soočimo s situacijo, v kateri je fluentd v stanju CrashLoopBackOff in nič ne pošilja, kar pomeni izgubo pomembnih informacij.
Zaključki
V tem članku ne obravnavamo SaaS rešitev, kot je Datadog. Mnoge od tukaj opisanih težav so že rešene s strani komercialnih podjetij, specializiranih za zbiranje dnevnikov, toda vsi ne morejo uporabljati SaaS iz različnih razlogov. (glavna sta cena in skladnost s 152-FZ).
Centralizirano zbiranje dnevnikov se sprva zdi enostavna naloga, a temu ni tako. Pomembno je upoštevati, da:
- Podrobno beležiti je treba le kritične komponente, ostale sisteme pa lahko nastavite za spremljanje in zbiranje napak.
- Dnevniški zapisi v produkciji naj bodo minimalni, da ne obremenjujejo pretirano.
- Dnevniški zapisi morajo biti strojno berljivi, normalizirani in imeti strogo obliko.
- Zelo kritične dnevnike je treba pošiljati v ločenem toku, ki mora biti ločen od glavnih.
- Predvideti je treba akumulator dnevnikov, ki lahko reši pred naletom visoke obremenitve in poskrbi za bolj enakomerno obremenitev shranjevanja.
Ta preprosta pravila bi, če bi jih uporabili povsod, omogočila delovanje tudi zgoraj opisanim shemam — četudi jim manjka pomembne komponente (akumulator). Če se teh načel ne držite, vas naloga lahko zlahka pripelje in infrastrukturo do še enega visoko obremenjenega (in hkrati slabo učinkovit) komponenta sistema.
P.S.
Preberite tudi na našem blogu:
- «»;
- «»;
- «».
Izvor: habr.com
