

Pomemben vidik pri delovanju razdeljenih sistemov je obravnava napak. Kubernetes pri tem pomaga z uporabo kontrolerjev, ki spremljajo stanje vašega sistema in ponovno zaženejo storitve, ki niso več aktivne. Vendar pa lahko Kubernetes prisilno ustavi vaše aplikacije, da zagotoviti splošno življenjsko sposobnost sistema. V tej seriji bomo preučili, kako lahko pomagate Kubernetesu, da svoje delo opravlja učinkoviteje in zmanjša čas nedelovanja aplikacij.
Pred začetkom uporabe kontejnerjev so večina aplikacij delovale na virtualnih ali fizičnih strojih. Ko je aplikacija odpovedala ali zamrznila, je bilo potrebno veliko časa, da se je opravilo nalogo in znova naložilo program. V najslabšem primeru je nekdo moral to težavo reševati ročno ponoči, ob neprimernem času. Če je pomembno nalogo izvajalo le 1-2 delovne naprave, je bila taka napaka povsem neprimerna.
Zato so namesto ročnega ponovnega zagonitve začeli uporabljati spremljanje na ravni procesov za samodejni ponovni zagon aplikacije v primeru njenega nepričakovanega konca. Če je program odpovedal, proces spremljanja zajame exit-kodo in ponovno zažene strežnik. Z pojavom takih sistemov, kot je Kubernetes, je ta način odzivanja na napake sistema enostavno integriran v infrastrukturo.
Kubernetes uporablja zanko dogodkov »opazovanje – beleženje razlik – izvajanje dejanj«, da zagotovi, da sredstva ohranjajo delovanje na poti iz kontejnerjev do samih vozlišč.
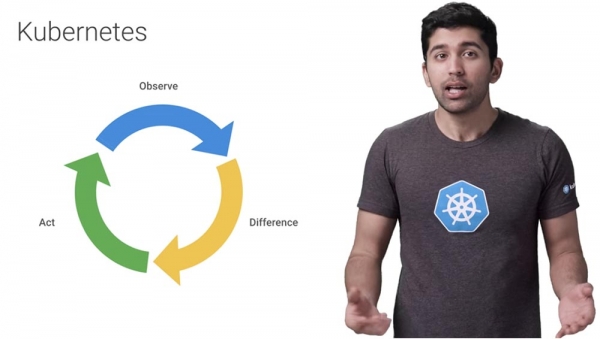
To pomeni, da vam več ni treba ročno zagnati spremljanja procesov. Če vir ne opravi Health Check preverjanja, Kubernetes preprosto samodejno zagotovi zamenjavo. Pri tem Kubernetes počne veliko več, kot le spremlja napake vaših aplikacij. Lahko ustvari več kopij aplikacije za delovanje na več strojih, posodobi aplikacijo ali hkrati zažene več različic vaše aplikacije.
Obstaja več razlogov, zakaj lahko Kubernetes prekine delovanje popolnoma zdravega kontejnerja. Na primer, če posodabljate svoje razporejanje, Kubernetes počasi ustavi stare poda in hkrati zažene nove. Če izklopite vozlišče, Kubernetes prekine delovanje vseh podov v tem vozlišču. Na koncu, če na vozlišču zmanjka virov, Kubernetes izklopi vse pode, da sprosti te vire.
Zato je zelo pomembno, da vaše aplikacije prenehajo delovati z minimalnim vplivom na končnega uporabnika in minimalnim časom obnove. To pomeni, da mora ob izklopu shraniti vse podatke, ki jih je treba shraniti, zapreti vse omrežne povezave, zaključiti preostala dela in imeti čas za opravljanje drugih nujnih nalog.
V praksi to pomeni, da mora vaša aplikacija znati obdelati sporočilo SIGTERM - signal za prekinitev procesa, ki je privzeti signal za ukaz kill v Unix družini operacijskih sistemov. Ko prejme to sporočilo, se mora aplikacija izklopiti.
Ko se Kubernetes odloči za zaključitev poda, se izvede cela vrsta dogodkov. Poglejmo vsak korak, ki ga podjetje Kubernetes izvede ob zaključku delovanja kontejnerja ali poda.
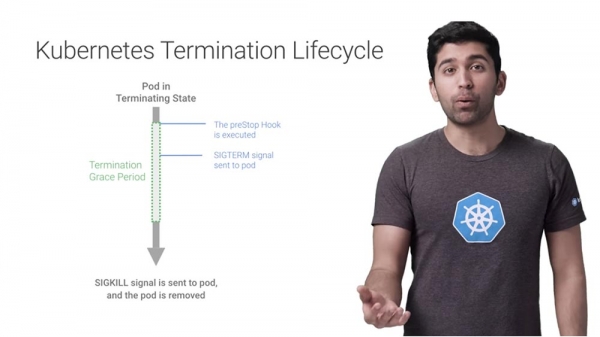
Predpostavimo, da želimo zaključiti enega od podov. V tem trenutku ne bo več prejemal novega prometa - delujoči kontejnerji v podu ne bodo prizadeti, vendar bo ves nov promet blokiran.
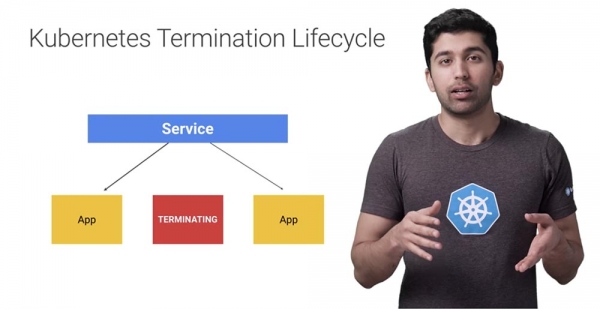
Poglejmo hiter hrošč preStop - to je posebna ukazna ali HTTP zahteva, ki se pošlje kontejnerjem v podu. Če se vaša aplikacija ob prejemu SIGTERM ne izklopi pravilno, lahko uporabite preStop za pravilno zaključitev delovanja.
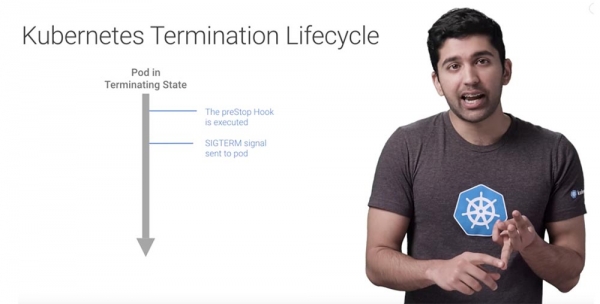
Večina programov se ob prejemu signala SIGTERM pravilno izklopi, vendar če uporabljate tujo kodo ali kakšen sistem, ki ga ne morete popolnoma nadzorovati, je hrošč preStop odličen način za izvedbo elegantnega izklopa brez spreminjanja aplikacije.
Po izvedbi tega hooka bo Kubernetes poslal signal SIGTERM kontejnerjem v podu, kar jih bo obvestilo, da bodo kmalu izklopljeni. Ko prejme ta signal, se bo vaš koda preusmerila na postopek izklopa. Ta postopek lahko vključuje ustavitev dolgoročnih povezav, kot so povezave z zbirko podatkov ali WebSocket tokovi, ter shranjevanje trenutnega stanja in podobno.
Tudi če uporabljate preStop hook, je zelo pomembno preveriti, kaj se dogaja z vašo aplikacijo, ko ji pošljete signal SIGTERM, kako se obnaša, da dogodki ali spremembe v delovanju sistema, ki jih povzroči izklop poda, ne postanejo nepričakovani.
V tem trenutku, preden sprejme nadaljnje ukrepe, bo Kubernetes čakal v okviru navedenega časa, imenovanega terminationGracePeriodSecond, ali obdobje za pravilno izklop ob prejemu signala SIGTERM.
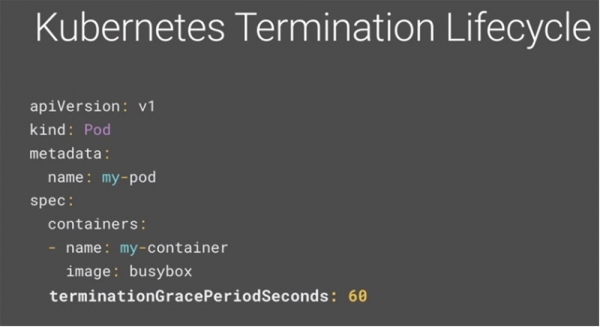
Privzeto to obdobje traja 30 sekund. Pomembno je omeniti, da poteka vzporedno s preStop hook in signalom SIGTERM. Kubernetes ne bo čakal, dokler se ne zaključi preStop hook in SIGTERM — če vaša aplikacija konča delovanje pred iztekom obdobja TerminationGracePeriod, bo Kubernetes takoj prešel na naslednji korak. Zato preverite, da vrednost tega obdobja v sekundah ni manjša od časa, potrebnega za pravilen izklop poda, in če presega 30s, povečajte obdobje na potrebno vrednost v YAML. V tem primeru znaša 60s.
In končno, zadnji korak — če kontejnerji še vedno delujejo po izteku terminationGracePeriod, bodo poslali signal SIGKILL in bodo prisilno odstranjeni. V tem trenutku bo Kubernetes prav tako izbrisal vse druge objekte poda.
Kubernetes ustavlja pode iz mnogih razlogov, zato se prepričajte, da bo vaša aplikacija vedno pravilno zaključena, da zagotovite stabilno delovanje storitve.
Malo reklame 🙂
Hvala što ostajete s nama. Da li vam se sviđaju naši članci? Želite li videti više zanimljivih materijala? Podržite nas tako što ćete naručiti ili preporučiti prijateljima, , jedinstveni ekvivalent entry-level servera koji smo stvorili za vas: (options available with RAID1 and RAID10, up to 24 cores and up to 40GB DDR4).
Dell R730xd je dvostruko jeftiniji u Equinix Tier IV data centru u Amsterdamu? Only with us in the Netherlands! Dell R420 — 2x E5-2430 2.2GHz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — from $99! Read about how
Izvor: habr.com
