

Hello, Habr! Vabimo Data Engineerje in strokovnjake za Machine Learning na brezplačno demo lekcijo . Prav tako objavljamo članek Luca Monno – vodje finančne analitike pri CDP SpA.
Eden najbolj uporabnih in preprostih metod strojnega učenja je Ensemble Learning. Ensemble Learning je metoda, na kateri temeljijo XGBoost, Bagging, Random Forest in mnogi drugi algoritmi.
Na Towards Data Science je veliko odličnih člankov, vendar sem izbral dve zgodbi ( in ), ki sta mi bili najbolj všeč. Zakaj torej napisati še en članek o EL? Ker vam želim pokazati, kako to deluje na preprostem primeru, ki me je prepričal, da tu ni nobene magije.
Ko sem prvič videl EL v akciji (pri delu z dvema zelo preprostima regresijskima modeloma), nisem mogel verjeti svojim očem in se še vedno spominjam profesorja, ki me je naučil te metode.
Imel sem dva različna modela (dva šibka učna algoritma) z vrednostmi out-of-sample R² enakima 0,90 in 0,93. Preden sem pogledal rezultate, sem mislil, da bom dobil R² nekje med dvema izvirnima vrednostma. Z drugimi besedami, menil sem, da se EL lahko uporabi, da model deluje ne tako slabo kot najslabši, ampak ne tako dobro kot bi lahko deloval najboljši model.
Moji največji presenečenju so rezultati preprostega povprečenja napovedi dali R² 0,95.
Sprva sem začel iskati napako, nato pa pomislil, da se morda skriva kakšna magija!
Kaj je Ensemble Learning
Z EL lahko združimo napovedi dveh ali več modelov za dosego bolj zanesljivega in zmogljivega modela. Obstaja veliko metodologij za delo z ansambli modelov. Tu bom obravnaval dve najbolj uporabni, da dam splošen pregled.
S pomočjo regresije lahko povprečimo rezultate obstoječih modelov.
S pomočjo kategorizacije lahko omogočimo modelom, da izberejo oznake. Oznaka, ki je bila najpogosteje izbrana – bo tista, ki jo bo izbrala nova model.
Zakaj EL deluje bolje
Glavna razlog, zakaj EL deluje bolje, je ta, da vsaka napoved vsebuje napako (kar vemo iz teorije verjetnosti); združitev dveh napovedi lahko pomaga zmanjšati napako in tako izboljša delovanje (RMSE, R² itd.).
Na naslednjem diagramu je prikazano, kako dva šibka algoritma delujeta z nizom podatkov. Prvi algoritem ima večji naklon, kot bi bilo potrebno, medtem ko je pri drugem skoraj enak nič (morda zaradi prekomerne regularizacije). Ampak ensemble prikazuje precej boljše rezultate.
Če pogledamo kazalnik R², bo pri prvem in drugem učnem algoritmu ta -0.01¹ in 0.22, medtem ko bo pri ansamblu znašal 0.73.
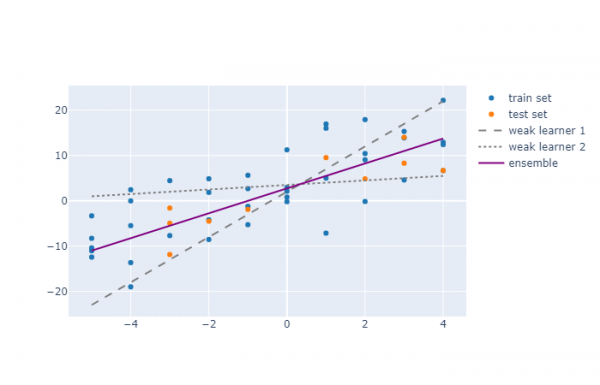
Obstaja veliko razlogov, zakaj algoritem morda ne bi bil dober model, celo pri tako osnovnem primeru, kot je ta: morda ste se odločili za uporabo regularizacije, da bi se izognili preoblikovanju, morda niste izključili nekaterih anomalij, ali pa ste morda uporabili polinomialno regresijo in izbrali napačno stopnjo (na primer, uporabili polinom druge stopnje, medtem ko je bila na testnih podatkih očitna asimetrija, za katero bi bolje ustrezala tretja stopnja).
Ko EL deluje bolje
Poglejmo dva učna algoritma, ki delujeta z enakimi podatki.
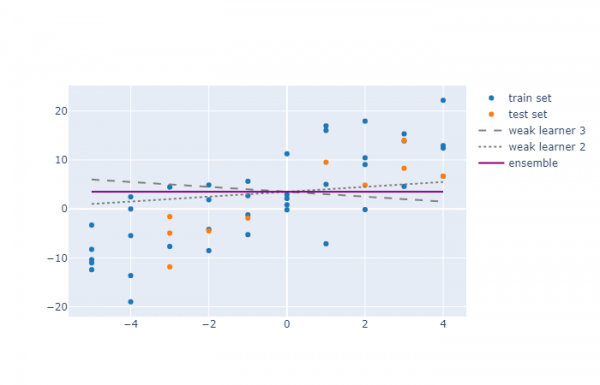
Tukaj je vidno, da združitev dveh modelov ni bistveno izboljšala delovanja. Prvotno so bili kazalniki R² za dva učna algoritma -0,37 in 0,22, medtem ko je za ansambel znašal -0,04. To pomeni, da je model EL pridobil povprečne kazalnike.
Vendar pa je med tema dvema primeroma velika razlika: v prvem primeru so bile napake modelov negativno korelirane, v drugem pa pozitivno (koeficienti treh modelov niso bili ocenjeni, ampak so bili preprosto izbrani s strani avtorja kot primer).
Zato se lahko Ensemble Learning uporablja za izboljšanje ravnotežja pristranskosti/variance v vseh primerih, toda, ko napake modelov niso pozitivno korelirane, lahko uporaba EL privede do povečanja zmogljivosti.
Homogene in heterogene modele
Zelo pogosto se EL uporablja na homogeni modeli (kot v tem primeru ali v naključnem gozdu), vendar pravzaprav lahko kombinirate različne modele (linearno regresijo + nevronsko mrežo + XGBoost) z različnimi nizi razlagalnih spremenljivk. Verjetno bo to privedlo do nekoreliranih napak in izboljšane učinkovitosti.
Primerjava z diverzifikacijo portfelja
EL deluje po analogiji z diverzifikacijo v teoriji portfelja, kar je za nas dobro.
Pri diverzifikaciji poskušate zmanjšati disperzijo vaših kazalnikov, tako da vlagate v nekorelirane delnice. Dobro diverzificiran portfelj delnic bo imel boljši kazalnik kot najslabša posamezna delnica, a nikoli ne bo boljši od najboljše.
Citirajoč Warrena Buffetta:
„Diverzifikacija je zaščita pred nevednostjo, za tiste, ki ne vedo, kaj delajo, ima [diverzifikacija] zelo malo smisla.“
V strojnem učenju EL pomaga zmanjšati disperzijo vašega modela, kar lahko privede do ustvarjanja modela z splošno učinkovitostjo boljšo od najboljše začetne model.
Sklenimo
Kombinacija več modelov v enega je razmeroma preprost način, ki lahko reši problem napake disperzije in poveča učinkovitost.
Če imate dva ali več modelov, ki dobro delujejo, ne izbirajte med njimi: uporabite jih vse (a previdno)!
Vas zanima razvoj na tem področju? Prijavite se na brezplačno Demo-uro in se udeležite — Strokovnjak za strojno učenje v Mail.ru Group.
Izvor: habr.com
