

V poročilu so predstavljeni nekateri pristopi, ki omogočajo sledenje zmogljivosti SQL poizvedb, ko jih dnevno obravnavamo milijone, nadzorovanih strežnikov PostgreSQL pa je na stotine.
Katere tehnične rešitve nam omogočajo učinkovito obdelavo take količine informacij in kako to olajša življenje običajnemu razvijalcu.
Komu je zanimiv razčlenitev konkretnih problemov in različne tehnike optimizacij SQL poizvedb ter rešitve tipičnih DBA nalog v PostgreSQL — prav tako si lahko na to temo.
Moje ime je Kirill Borovikov, predstavljam . Konkretno se specializiram za delo z bazami podatkov v našem podjetju.
Danes vam bom pripovedoval, kako se ukvarjamo z optimizacijo poizvedb, ko morate ne 'razkopati' zmogljivost posamezne poizvedbe, ampak rešiti problem množično. Ko imamo milijone poizvedb in morate najti nekatere pristope k reševanju te velike težave.
Dejansko 'Tensor' za milijon naših strank predstavlja : korporativna socialna mreža, rešitve za videokonference, za notranji in zunanji pretok dokumentov, računovodske in skladiščne sisteme,… Torej nekakšen 'mega kombinator' za celostno upravljanje poslovanja, v katerem je več kot 100 različnih notranjih projektov.
Da vse te dobro delujejo in se razvijajo — imamo 10 razvojnih centrov po vsej državi, v njih pa več kot 1000 razvijalcev.
S PostgreSQL delamo od leta 2008 in smo nabrali veliko količino obdelanih podatkov — to so podatki strank, statistični, analitični, podatki iz zunanjih informacijskih sistemov — več kot 400TB. V 'proizvodnji' je približno 250 strežnikov, skupno pa spremljamo okoli 1000 strežnikov podatkov.
SQL je deklarativni jezik. Opisujete ne 'kako' naj bi nekaj delovalo, temveč 'kaj' želite pridobiti. DBMS najbolje ve, kako izvesti JOIN — kako povezati vaše tabele, katere pogoje uveljaviti, kaj bo šlo po indeksu, kaj ne...
Nekateri DBMS sprejemajo namige: 'Ne, te dve tabeli poveži v takšnem vrstnem redu', a PostgreSQL tega ne zna. To je zavestna odločitev vodilnih razvijalcev: 'Raje bomo izboljšali optimizator poizvedb, kot pa pustili razvijalcem, da se uporabljajo kakšne namige.'
A vendar, kljub temu, da PostgreSQL ne omogoča upravljanja nase „zunaj“, odlično dovoljuje videti, kaj se dogaja znotraj njega, ko izvedete svojo poizvedbo, in kje nastanejo težave.
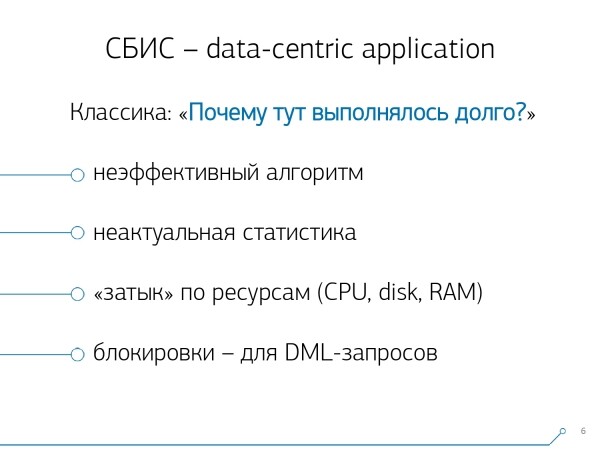
Na splošno, s katerimi klasičnimi težavami se razvijalec [k DBA] običajno obrača? „Tukaj smo izvedli poizvedbo in vse je počasno, vse se je zataknilo, nekaj se dogaja … Kakšna katastrofa!“
Razlogi so skoraj vedno isti:
- neučinkovit algoritem poizvedbe
Razvijalec: „Trenutno imam v SQL 10 tabel prek JOIN …“ — in pričakuje, da se bodo njegovi pogoji čudežno učinkovito „razvozili“, in da bo vse dobil hitro. A čarovnij ni, in kakršna koli sistemska variabilnost (10 tabel v enem izmed FROM) vedno povzroči določeno napako. [] - neaktuální statistiky
Ta trenutek je posebej aktualen za PostgreSQL, ko ste na strežnik naložili velik nabor podatkov, izvajate poizvedbo — in on „sekvencira“ po tabeli. Ker je v njej včeraj ležalo 10 zapisov, danes pa 10 milijonov, vendar PostgreSQL o tem še ne ve, in mu je treba to povedati. [] - zablokování zdrojů
Postavili ste obsežno in obremenitveno bazo na šibek strežnik, ki mu primanjkuje diska, pomnilnika, zmogljivosti samega procesorja. In to je to ... Nekje je omejitev zmogljivosti, ki je ne morete preseči. - blokad
Zapleten trenutek, vendar so najbolj aktualni za različne spremembe poizvedb (INSERT, UPDATE, DELETE) — to je posebej velika tema.
Pridobitev načrta
… A za vse ostalo potrebujemo načrt! Potrebujemo videti, kaj se dogaja znotraj strežnika.
Načrt izvrševanja poizvedbe za PostgreSQL je drevesna struktura algoritma izvrševanja poizvedbe v besedilni obliki. Prav tistega algoritma, ki ga je po analizi načrtovalnik prepoznal kot najprimernejšega.
Vsaka vozlišče drevesa predstavlja operacijo: pridobivanje podatkov iz tabele ali indeksa, izgradnjo bitne karte, združevanje dveh tabel, unijo, presečišče ali razliko med izbirami. Izvrševanje poizvedbe poteka skozi vozlišča tega drevesa.
Da pridobite načrt poizvedbe, je najlažji način izvršiti ukaz EXPLAIN. Da pridobite vse resnične atribute, torej dejansko izvesti poizvedbo na bazi — EXPLAIN (ANALYZE, BUFFERS) SELECT ....
Slab trenutek: ko ga izvajate, se to zgodi 'tukaj in zdaj', zato je primerno le za lokalno odpravljanje napak. Če pa imate visoko obremenjeno strežnik, ki ga obremenjuje močan pretok sprememb podatkov, in vidite: 'Oj! Tukaj imamo počasno izvajanje poizvedbe.'Se vsak was pol ure, eno uro nazaj — medtem ko ste iskali to poizvedbo v dnevnikih, jo spet prenašali na strežnik, se je celotna zbirka podatkov in statistika spremenila. Izvajate jo za odpravljanje napak — in se hitro izvaja! In ne morete razumeti 'zakaj', zakaj
počasno. modul auto_explain
. Na voljo je praktično v vseh najbolj razširjenih distribucijah PostgreSQL in ga je mogoče enostavno aktivirati v konfiguracijski datoteki. Če zazna, da se neka poizvedba izvaja dlje, kot je določena meja, naredi.
'posnetek' načrta te poizvedbe in zapiše to skupaj v dnevnik.
Zdi se, da je vse v redu, gremo v dnevnik in vidimo tam... [portjanka besedila]. Vendar o njem ne moremo reči nič, razen dejstva, da je to odlična načrt, ker se je izvajal 11 ms.
Zdi se, da je vse v redu — vendar ni jasno, kaj se je dejansko dogajalo. Poleg splošnega časa ne vidimo nič posebnega. Ker gledanje na tako 'latuko' plain text je povsem neuporabno.
- Toda tudi če je neuporabno, neudobno, vendar obstajajo bolj resne težave: V vozlišču je navedena vsota virov celotnega poddrevesa
- pod njim. To pomeni, da preprosto ne moremo izvedeti, kako dolgo je bilo zapravljeno časa na tem Index Scan, če pod njim obstaja kakšna vgrajena pogoj. Moramo dinamično preveriti, ali so znotraj 'otroci' in pogojne spremenljivke, CTE — in vse to 'v mislih' odšteti. Druga težava: čas, ki je naveden na vozlišču, ječas enkratnega izvajanja vozlišča. Če se je to vozlišče izvajalo na primer v rezultatu cikla po zapisih v tabeli, večkrat, se v načrtu povečuje število zank — ciklov tega vozlišča. Vendar pa je sam čas atomske izvedbe ostal v načrtu enak. Torej, da bi razumeli, koliko časa je to vozlišče skupno trajalo, moramo eno pomnožiti z drugim — spet 'v mislih'.
V takih razmerih je praktično nemogoče razumeti, kdo je "najšibkejša povezava". Zato celo sami razvijalci v "priročniku" pišejo, da "Razumevanje načrta je umetnost, ki se je treba naučiti, izkušnje...".
Ampak imamo 1000 razvijalcev, in te izkušnje vsakemu ne moreš prenesti v glavo. Jaz, ti, on - vedo, nekdo tam daleč - pa že ne. Morda se bo naučil, morda ne, ampak delati mora zdaj - in kje naj bi dobil te izkušnje?
Vizualizacija načrta
Zato smo ugotovili, da za reševanje teh težav potrebujemo dobro vizualizacijo načrta.
Začeli smo "po trgu" - poglejmo, kaj na splošno obstaja na internetu.
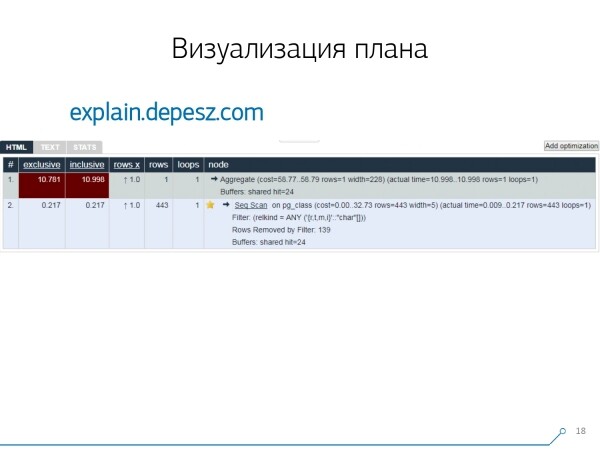
Vendar se je izkazalo, da je glede "živih" rešitev, ki se nekako razvijajo, zelo malo - dobesedno, ena: od Hubert Lubaczewski. V vhodno polje "naložiš" besedilno predstavitev načrta, pokaže ti tabelo z razčlenjenimi podatki:
- lastni čas obdelave vozlišča
- skupni čas po celotnem poddrevesu
- število zapisov, ki so bili pridobljeni in ki so bili statistično pričakovani
- telo vozlišča
Ta storitev omogoča tudi deljenje arhiva povezav. Pošlješ svoj načrt in rečeš: "Hej, Vaša, tukaj imaš povezavo, tam je nekaj narobe."
Toda obstajajo tudi majhne težave.
Prvič, ogromna količina "kopipejsta". Vzameš kos dnevnika, ga tam zmešaš, in znova, in znova.
Drugič, brez analize količine prebranih podatkov - tistih buffers, ki jih izda EXPLAIN (ANALYZE, BUFFERS), tukaj ne vidimo. Preprosto ne zna razbrati, razumeti in delati z njimi. Ko bereš veliko podatkov in spoznaš, da se morda nepravilno "razporediš" po disku in v predpomnilniku, so te informacije zelo pomembne.
Tretja negativna točka - zelo šibka razvojna stopnja te projekte. Commiti so zelo majhni, dobro, če enkrat na pol leta, in koda je napisana v Perl.
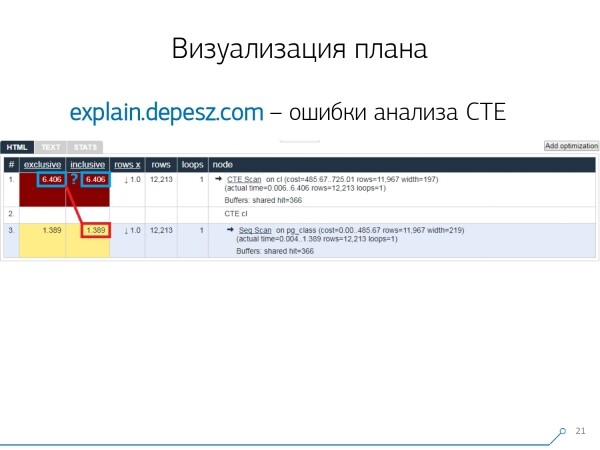
Vse to so "lirike", s tem bi se bilo mogoče nekako spoprijeti, vendar je ena stvar, ki nas je res močno odvrnila od te storitve. To so napake pri analizi skupne tabelarne izraze (CTE) in različnih dinamičnih vozlišč, kot sta InitPlan/SubPlan.
Če verjamemo tej sliki, imamo skupni čas izvajanja vsakega posameznega vozlišča večji od skupnega časa izvajanja celotnega poizvedovanja. Vse je preprosto - iz vozlišča CTE Scan ni bilo odšteto časa za generiranje tega CTE.. Zato zdaj ne vemo pravega odgovora, koliko časa je trajalo samo skeniranje CTE.
Tukaj smo razumeli, da je čas, da napišemo svoje — hura! Vsak razvijalec pravi: „Zdaj bomo napisali svoje, super enostavno bo!“
Vzeli smo tipični spletni servisni sklad: jedro na Node.js + Express, nataknili Bootstrap in za lepe diagrame — D3.js. In naša pričakovanja so se povsem izpolnila — prvi prototip smo dobili v 2 tednih:
- lastni parser načrta
To pomeni, da lahko zdaj analiziramo kateri koli načrt iz tistih, ki jih generira PostgreSQL. - pravilna analiza dinamičnih vozlišč — CTE Scan, InitPlan, SubPlan
- analiza razporeditve buffers — kje se podatkovne strani berejo iz pomnilnika, kje iz lokalnega predpomnilnika, kje z diska
- dobili smo preglednost
Da ne kopamo vsega tega v dnevniku, ampak takoj vidimo „najšibkejšo točko“ na sliki.
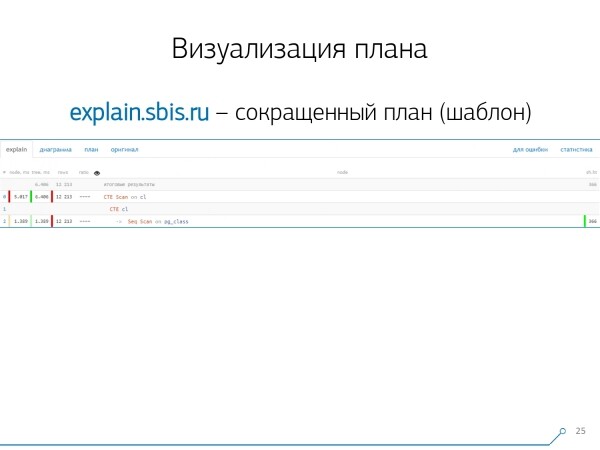
Pridobili smo približno takšno sliko — takoj z označevanjem sintakse. Običajno naši razvijalci delajo z bistveno krajšo predstavitvijo načrta. Saj smo vse številke že razčlenili in jih vrgli na levo in desno, na sredini pa pustili samo prvo vrstico, kaj je to za vozlišče: CTE Scan, generacija CTE ali Seq Scan po neki tabeli.
To skrajšano predstavitev imenujemo predloga načrta.
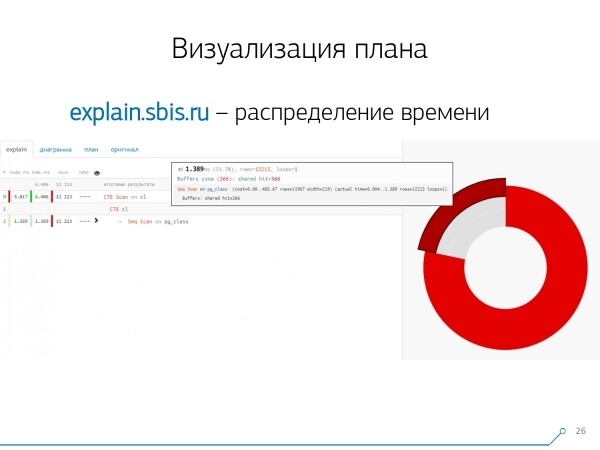
Kaj bi še bilo priročno? Bilo bi priročno videti, kateri delež katerega vozlišča od skupnega časa nam pripada — in preprosto „priključili“ na stran pie chart.
Nadenemo se na vozlišče in vidimo — izkaže se, da je Seq Scan od vsega časa vzel manj kot četrtino, ostalih 3/4 pa je vzelo CTE Scan. Oh ne! To je majhna opomba o „hitrosti“ CTE Scan, če jih aktivno uporabljate v svojih poizvedbah. Niso ravno hitri — celo običajnemu tabelarnemu skeniranju so slabši.
Toda običajno so taki diagrami bolj zanimivi, bolj zapleteni, ko se takoj nanesemo na segment in vidimo, na primer, da je več kot polovico celotnega časa „požrla“ neka Seq Scan. In znotraj je bil nek Filter, ogromno zapisov je bilo zavrženih ... To sliko lahko kar pošljemo razvijalcu in rečemo: „Vanja, tukaj imaš sploh vse slabo! Uredi to, poglej — nekaj ni v redu!“
Seveda pa ni šlo brez „preprek“.
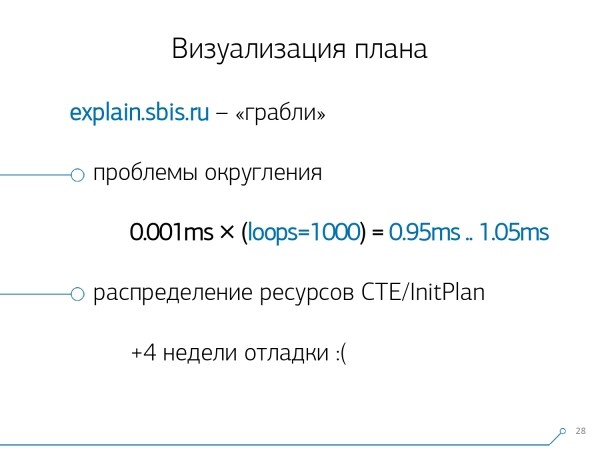
Prvo na što smo "naleteli" je problem zaokruživanja. Vreme čvora svakog pojedinačnog u planu navodi se sa preciznošću do 1μs. I kada broj ciklusa čvora prelazi, na primer, 1000 — nakon izvršenja PostgreSQL deli "sa preciznošću do", tada pri obratnom izračunavanju dobijamo ukupno vreme "negde između 0.95ms i 1.05ms". Kada se radi o mikrosekundama — još je u redu, ali kada je već na [milisekundi] — mora se pri "raščišćavanju" resursa po čvorovima plana "ko koliko je iskoristio" tu informaciju uzeti u obzir.
Drugi, složeniji aspekt je raspodela resursa (onih poznatih buffera) po dinamičkim čvorovima. To nam je oduzelo dodatnih 4 nedelje u prvim 2 nedeljama prototipa.
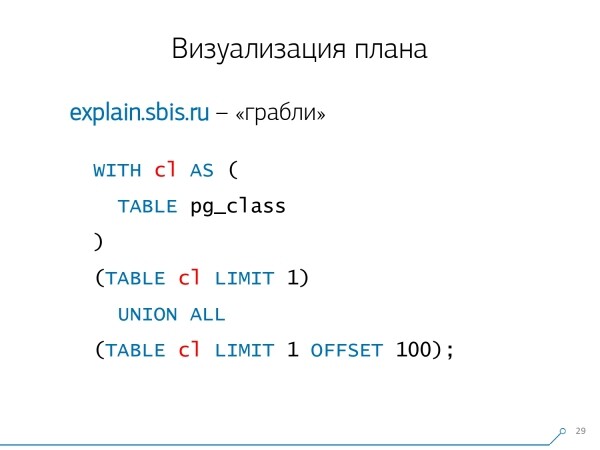
Problemu je lako pristupiti — pravimo CTE i u njemu nešto navodno čitamo. U stvarnosti, PostgreSQL je "pametan" i neće direktno ništa čitati tamo. Zatim uzimamo prvu stavku iz njega, a njoj pridružujemo sto prvu iz istog CTE-a.
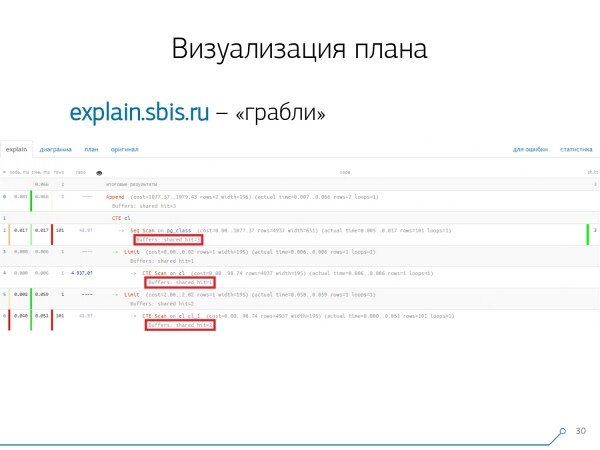
Gledamo plan i shvatamo — čudno, imali smo 3 buffera (stranice podataka) koje su "iskorišćene" u Seq Scan, još 1 u CTE Scan, i još 2 u drugom CTE Scan. Dakle, ukoliko sve jednostavno saberemo, dobijamo 6, ali iz tabelice smo pročitali samo 3! CTE Scan zapravo ne čita ništa odatle, već radi direktno sa memorijom procesa. To znači da očigledno nešto nije u redu!
Ustvari se ispostavilo da su ta 3 strana podataka koja su zatražena u Seq Scanu najpre tražila 1. CTE Scan, a zatim 2. i njemu je još 2 dodatno učitana. Dakle, ukupno je pročitano 3 strane podataka, a ne 6.
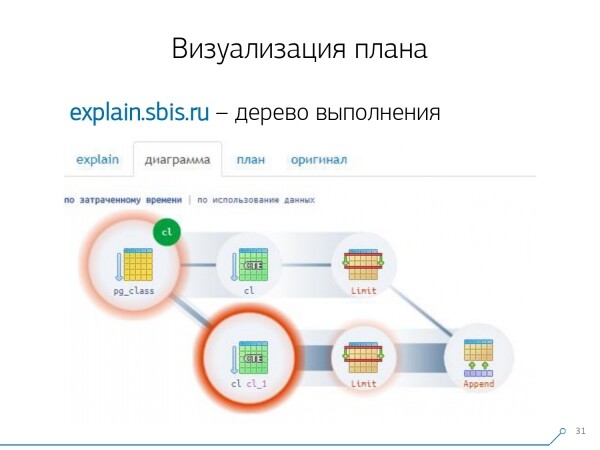
Ova slika nas je dovela do razumevanja da je izvršenje plana sada više aciklična grafika nego stablo. Tako smo dobili otprilike ovakvu dijagramu, kako bismo shvatili "odakle šta uopšte dolazi". Dakle, ovde smo stvorili CTE iz pg_class i tražili je dva puta, a gotovo svu vreme smo proveli u grani kada smo je tražili drugi put. Jasno je da pročitati 101. stavku je mnogo skuplje nego samo 1. iz tabelice.

Na trenutak smo odahnuli. Rekli smo: "Sada, Neo, znaš kung-fu! Sada je naše iskustvo direktno na ekranu. Sada možeš to koristiti."
Konsolidacija logova
Naši 1000 razvijalcev je oddahnilo. A mi smo vedeli, da imamo le stotine »bojevnih« strežnikov in da je vse to »kopiranje in lepljenje« s strani razvijalcev zelo nepraktično. Ugotovili smo, da moramo to zgraditi sami.
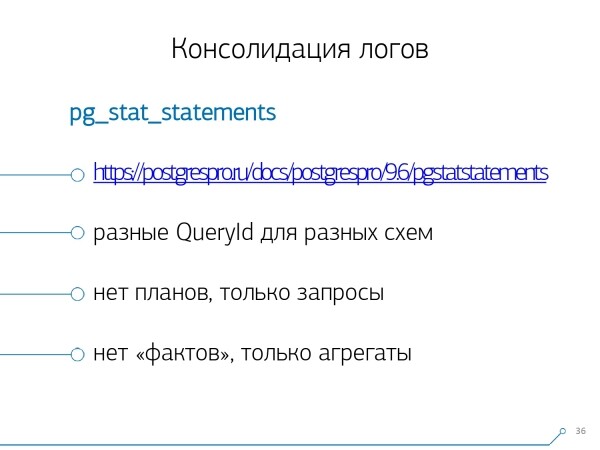
Dejansko obstaja standardni modul, ki zna zbirati statistiko, toda tudi ta je treba aktivirati v konfiguraciji — to je . A nas ta ni prepričal.
Prvič, istim poizvedbam v različnih shemah znotraj enega podatkovnega skladišča dodeljuje različne QueryId. To pomeni, da če najprej izvedemo SET search_path = '01'; SELECT * FROM user LIMIT 1;, nato pa SET search_path = '02'; in enako poizvedbo, bo v statistiki tega modula zapisana različna podatka, kar pomeni, da ne bom mogel zbrati celotne statistike prav v okviru te vrste poizvedbe, brez upoštevanja shem.
Druga težava, ki nam je preprečila njegovo uporabo — pomanjkanje načrtov. To pomeni, da načrta ni, imamo samo samo poizvedbo. Vidimo, kaj je upočasnilo, a ne razumemo, zakaj. In tu se vračamo k problemu hitro spreminjajoče se podatkovne zbirke.
In zadnja težava — pomanjkanje »dejstev«. To pomeni, da se ne moremo sklicevati na konkreten primer izvajanja poizvedbe — tega ni, je le agregirana statistika. S tem se lahko delno dela, a je zelo težko.
Zato smo se odločili, da se bomo borili proti »kopiranju in lepljenju« in začeli pisati korektor.
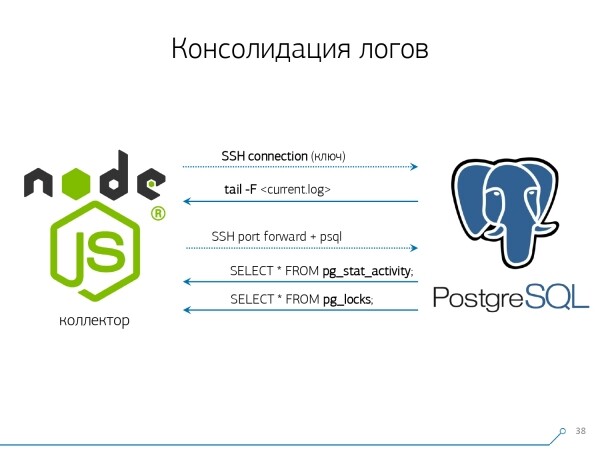
Korektor se poveže preko SSH, z uporabo certifikata vzpostavi zaščiteno povezavo do strežnika z bazo in tail -F se poveže na log datoteko. Tako v tej seji dobimo popolno »zrcalo« vsega log-fajla, ki ga generira strežnik. Obremenitev samega strežnika je pri tem minimalna, saj tam nič ne obdelujemo, le zrcalimo promet.
Ker smo že začeli pisati vmesnik v Node.js, smo na njem nadaljevali tudi s pisanjem korektorja. In ta tehnologija se je obrestovala, ker je za delo z slabo formatiranimi besedilnimi podatki, kar so logi, zelo priročno uporabljati JavaScript. In sama infrastruktura Node.js kot backend platforma omogoča enostavno in priročno delo s spletnimi povezavami in sploh z nekaterimi tokovi podatkov.
Upoštevajoč to, 'napenjamo' dve povezavi: prvo, da 'poslušamo' sam log in ga prenašamo k sebi, drugo — da občasno sprašujemo bazo. 'In log je prikazal, da je blokiran tabelo z oid 123', vendar to razvijalcu ne pove nič, in dobro bi bilo vprašati bazo: 'Kaj pravzaprav pomeni OID = 123?' Tako občasno sprašujemo bazo o tem, česar še ne vemo.
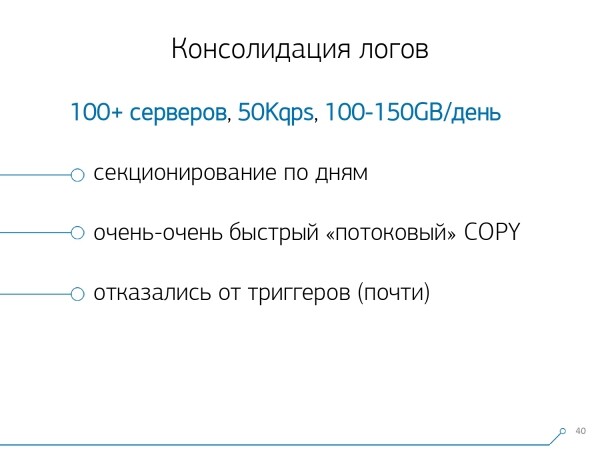
'Le enega nisi upošteval, obstaja vrsta slonastih čebel!..' Začeli smo razvijati ta sistem, ko smo želeli spremljati 10 strežnikov. Najbolj kritične v našem razumevanju, na katerih so nastajale težave, s katerimi je bilo težko ravnati. Toda v prvem četrtletju smo na spremljanje dobili sto — ker se je sistem 'uspel', vsi so želeli, vsem je bilo priročno.
Vse to je treba zbirati, podatkovni tok je velik in aktiven. Dejansko spremljamo tisto, kar znamo obvladovati — to tudi uporabljamo. Uporabljamo tudi PostgreSQL kot podatkovno skladišče. Nič hitrejšega, da 'nalijemo' podatke v to, kot je operator COPY ni še.
Toda samo 'naliti' podatke — ni čisto naša tehnologija. Ker če imate na sto strežnikih približno 50k poizvedb na sekundo, to generira 100-150GB logov na dan. Zato smo morali bazo previdno 'rezati'.
Prvič, naredili smo sekcioniranje po dnevih, ker po resnici nikogar ne zanima korelacija med dnevi. Kakšna je razlika, kaj se je zgodilo včeraj, če ste ponoči izdali novo različico aplikacije — in že imate novo statistiko.
Drugič, naučili smo se (bili prisiljeni) zelo, zelo hitro pisati s pomočjo COPY. Torej ne samo COPY, ker je hitrejši od INSERT, ampak še hitreje.
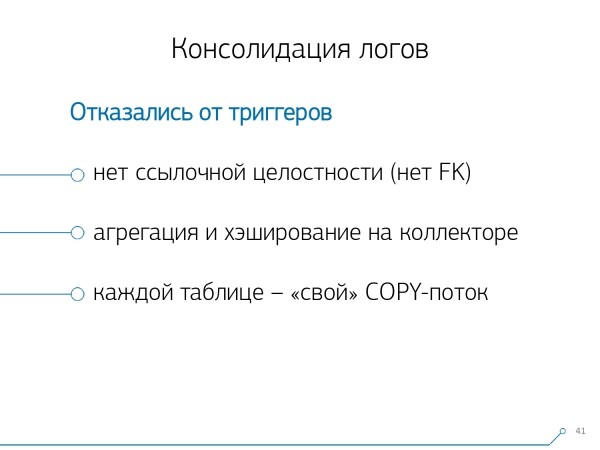
Tretja točka — morali smo opustiti sprožilce in torej tudi tuje ključe. Torej nimamo nobene referenčne celovitosti. Ker če imate tabelo, na kateri je nekaj FK, in v strukturi DB rečete, da 'ta zapis iz loga nanaša na skupino zapisov po FK', potem ko ga vstavite, PostgreSQL ni prisiljen, da spoštuje SELECT 1 FROM master_fk1_table WHERE ... s tem identifikatorjem, ki ga poskušate vnesti — samo, da preverite, da ta zapis tam obstaja, da ne 'unčujete' tega tujega ključa s svojim vstavljanjem.
Namesto da dobimo en zapis v ciljni tabeli in njene indekse, dobimo še branje iz vseh tabel, na katere se sklicuje. In to nam sploh ni potrebno — naša naloga je zapisati čim več in čim hitreje z najmanjšo obremenitvijo. Tako da FK — proč!
Naslednji trenutek — agregacija in hashing. Sprva smo jih imeli implementirane v Bazi — konec koncev je priročno, da se ob vnosu zapisa v neki tabeli »plus ena« neposredno v triggerju. V redu, priročno, a slabo v tem, da ob vnosu enega zapisa morate še prebrati in zapisati kaj iz druge tabele. Poleg tega, da morate prebrati in zapisati — morate to storiti vsakič.
Zdaj si predstavljajte, da imate tabelo, v kateri preprosto štejete število zahtevkov, ki so šli preko določenega gostitelja: +1, +1, +1, ..., +1. In to vam v bistvu ni potrebno — to se lahko sešteje v pomnilniku na kolektorju in pošlje v bazo naenkrat +10.
Ja, v primeru morebitnih težav lahko »razpade« logična celovitost, a to je praktično nerealna situacija — ker imate normalen strežnik, v njem baterijo v krmilniku, imate dnevnik transakcij, dnevnik v datotečnem sistemu… Na splošno, ni vredno truda. Ni vredna tiste izgube zmogljivosti, ki jo prinašate s trgijalniki/FK, tistih stroškov, ki jih imate pri tem.
Enako velja za hashing. Pride vam neka zahteva, iz nje v Bazi izračunate neki identifikator, zapišete v bazo in vsem zatem poveste ta identifikator. Vse je v redu, dokler v trenutku vnosa ne pride drugi, ki želi vnašati prav tega — in dočakate blokado, kar pa je slabo. Zato če lahko generacijo nekih ID-jev prenesete na stranko (v razmerju do baze), je bolje, da to storite.
Nam je odlično ustrezalo, da uporabimo MD5 od besedila — zahteve, načrta, predloge,… Izračunamo ga na strani kolektorja in »vlijemo« v bazo že pripravljen ID. Dolžina MD5 in dnevno sekcioniranje nam omogočata, da se ne skrbimo o morebitnih kolizijah.
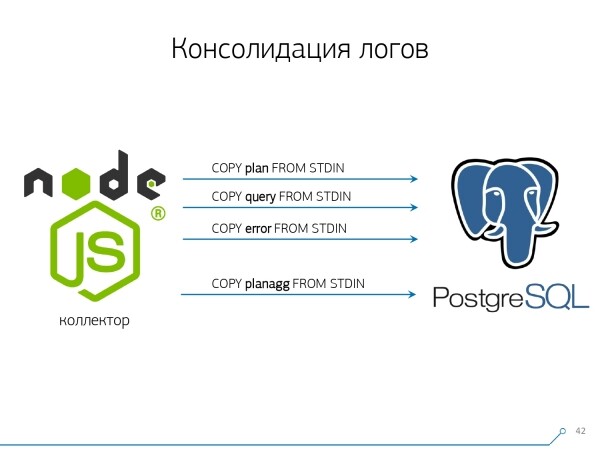
Toda da bi to vse zapisali hitro, smo potrebovali spremeniti samo postopek vnosa.
Kako običajno pišemo podatke? Imamo neki nabor podatkov, razdelimo ga na več tabel in nato uporabimo COPY — najprej v prvo, nato v drugo, v tretjo… Ni priročno, ker se zdi, da imamo en sistem podatkov, ki ga vpisujemo v treh zaporednih korakih. Ni prijetno. Ali lahko naredimo hitreje? Lahko!
Zadostuje, da svoje tokove razporedimo vzporedno drug ob drugem. Tako da dobimo ločene tokove napak, zahtevkov, predlog in zaklenitev,… — in vse to pišemo vzporedno. Zadostuje, da ohranjamo COPY kanal vedno odprt za vsak posamezen cilj tabelo.
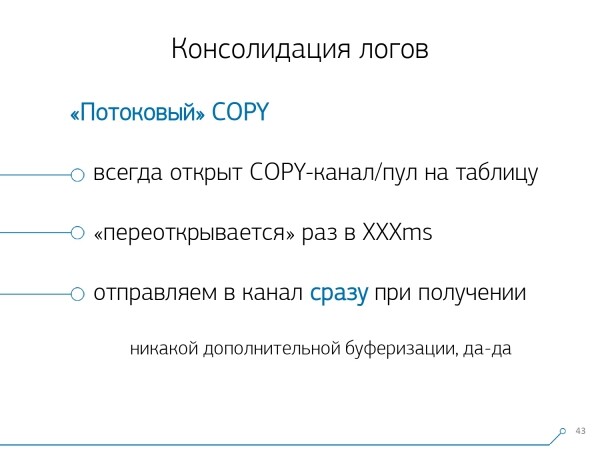
Torej ima zbiralnik vedno tok, v katerega lahko zapišem potrebne podatke. Da pa jih baza vidi in da kdo ne visi v zaklepanju, medtem ko čakamo, da se ti podatki zabeležijo, je treba COPY prekiniti z določeno periodičnostjo. Za nas je bila najbolj učinkovita obdobje približno 100 ms — zapremo in takoj ponovno odpiramo to isto tabelo. In če pri nekaterih vrhuncih en tok ni dovolj, potem izvajamo poizvedovanje do določenega praga.
Dodatno smo ugotovili, da za tovrstne obremenitve vsaka agregacija, ko se zapisi zbirajo v pakete — to je zlo. Klasično zlo je INSERT ... VALUES in nato 1000 zapisov. Ker v tem trenutku pride do vrha zapisa v napravah za shranjevanje, in vsi drugi, ki poskušajo nekaj zabeležiti na disk, bodo čakali.
Da bi se znebili takih anomalij, preprosto ne agregirajte ničesar, ne shranjujte podatkov sploh. In če kljub temu pride do shranjevanja na disk (na srečo, Stream API v Node.js to omogoča), — odložite to povezavo. Ko prejmete dogodek, da je spet prost — pišite vanj iz nakupljene vrste. Dokler je zaseden — vzemite naslednjo prosto in pišite vanjo.
Pred uvedbo tega pristopa k vpisu podatkov smo imeli približno 4K zapisov, s to metodo pa smo obremenitev zmanjšali za 4-krat. Zdaj smo še 6-krat povečali zahvaljujoč novim opazovanim bazam — do 100 MB/s. Sedaj hranimo dnevnik za zadnja 3 meseca v obsegu približno 10-15 TB, v upanju, da bo kateri koli problem lahko rešil kateri koli razvijalec v treh mesecih.
Razumemo težave
Samo prikupljanje svih tih podataka je dobro, korisno, prikladno, ali malo — potrebno ih je razumeti. Jer to su milioni različitih planova dnevno.
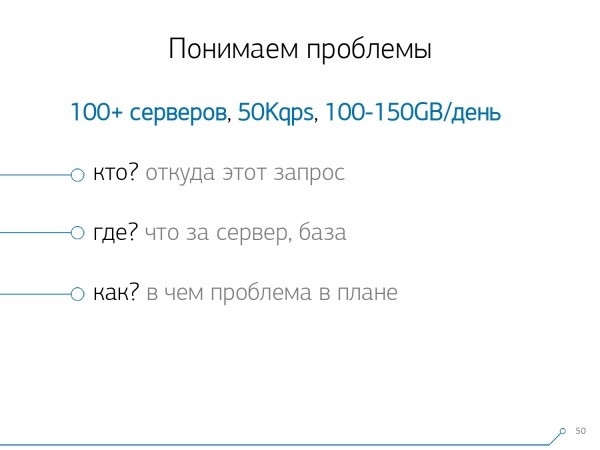
Ali milioni — to je neukrotivo, prvo treba da se napravi 'manje'. I, pre svega, morate odlučiti kako ćete organizovati to 'manje'.
Istakli smo tri ključne tačke:
- uporabnik (ali napadalec) poskuša narediti, ampak tudi ovaj zahtev je poslao
To jest, iz koje aplikacije je "došao": web interfejs, backend, sistem plaćanja ili nešto drugo. - kjer to se dogodilo
Na kojem konkretnom serveru. Jer ako imate više servera za jednu aplikaciju, i iznenada jedan 'zastane' (zbog 'otkačenog diska', 'curenja memorije', još neke nesreće), morate se konkretno obratiti serveru. - kako problem se javljao u tom ili onom planu
Da bismo razumeli 'ko' nam je poslao zahtev, koristimo standardno sredstvo — postavljanje sesijske promenljive: SET application_name = '{bl-host}:{bl-method}'; — pridobijamo ime hosta poslovne logike sa kojeg dolazi zahtev i ime metode ili aplikacije koja ga je inicirala.
Nakon što smo preneli 'domaćina' zahteva, potrebno ga je zabeležiti u log — za to konfigurišemo promenljivu log_line_prefix = ' %m [%p:%v] [%d] %r %a'. Kome je zanimljivo, može , šta to sve znači. U logu vidimo:
- vreme
- identifikatore procesa i transakcije
- ime baze
- IP onoga ko je poslao ovaj zahtev
- i ime metode
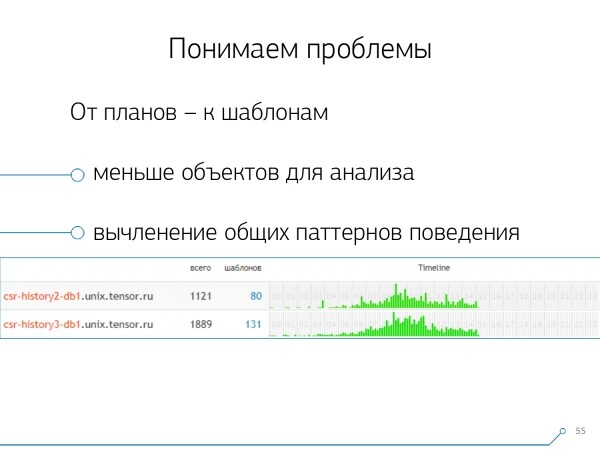
Dalje smo shvatili da nije baš zanimljivo gledati korelaciju po jednom zahtevu između različitih servera. Nije često da dobijete situaciju kada vam je ista aplikacija podjednako 'nepravilna' ovde i tamo. Ali čak i ako je tako — pogledajte bilo koji od ovih servera.
Dakle, rezanje 'jedan server — jedan dan' nam se pokazalo dovoljno za bilo koju analizu.
Prvo analitičko sečenje — to je onaj 'šablon' — skraćeni oblik predstavljanja plana, očišćen od svih numeričkih pokazatelja. Drugo sečenje — aplikacija ili metoda, a treće — to je konkretni čvor plana koji nam je napravio probleme.
Kada smo prešli sa konkretnih instanci na šablone, odmah smo dobili dve prednosti:
- drastično smanjenje broja objekata za analizu
Sada se problem razmatra ne po hiljadama zahteva ili planova, već po desetinama šablona. - vremenska linija
To summarize the "facts" within a certain context, one can display their occurrence throughout the day. Here you can understand that if a certain pattern occurs, for example, once an hour when it should be once a day, it's worth considering what went wrong — who triggered it and why; maybe it shouldn't be there at all. This is another non-numeric, purely visual way of analysis.
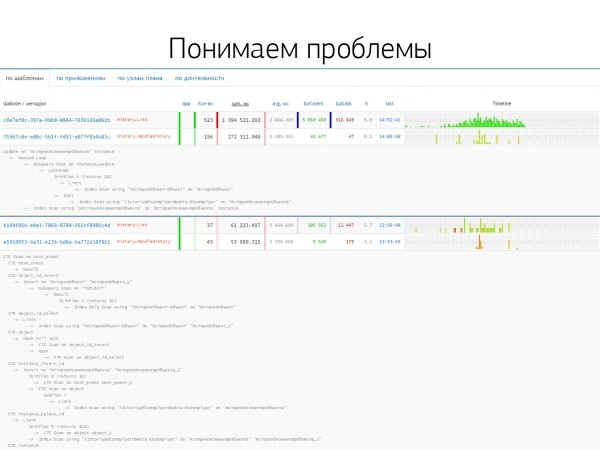
The other methods are based on the metrics we extract from the plan: how many times such a pattern occurred, the total and average time, how much data was read from the disk, and how much from memory...
For example, you go to the analytics page for the host, and you see — something has started reading too much from the disk. The disk on the server can't handle it — but who's reading from it?
And you can sort by any column and decide what you're going to tackle right now — whether it's the CPU load, disk load, or the total number of requests... You sorted it, looked at the "top items", fixed them — and rolled out a new version of the application.
And immediately you can see different applications that share the same pattern from a request type SELECT * FROM users WHERE login = 'Vasya'. Frontend, backend, processing... And you start wondering why processing would read a user if it's not interacting with them.
The reverse method — to see right away what the application is doing. For example, frontend — this, this, and this, plus this happens once an hour (the timeline helps here). And immediately the question arises — it seems to be unusual for the frontend to do something once an hour...
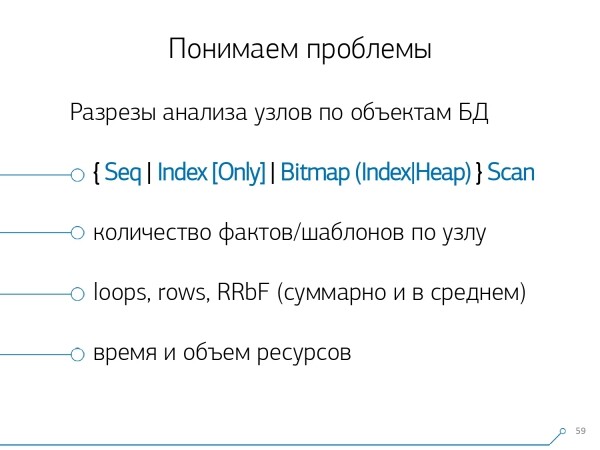
After some time, we realized that we were lacking aggregated statistics by plan nodes. We isolated from the plans only those nodes that do something with the data of the tables themselves (whether they read/write them by index or not). Essentially, compared to the previous picture, only one aspect is added — how many rows this node brought us, and how many it discarded (Rows Removed by Filter).
You don't have an appropriate index on the table; you make a query to it, and it bypasses the index, falls into a Seq Scan... filtering out all records except one. Why do you need 100M filtered records in a day? Wouldn't it be better to create an index?
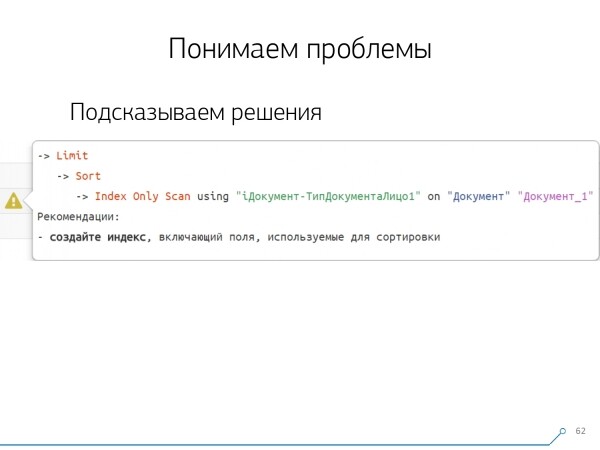
Potem ko smo preučili vse načrte po vozliščih, smo ugotovili, da obstajajo nekateri tipični vzorci v načrtih, ki se verjetno zdijo sumljivi. In razvijalcu ne bi škodilo, da bi mu rekli: „Prijatelj, tukaj najprej bereš po indeksu, potem sortiraš in nato odrežeš“ — ponavadi je tam samo en zapis.
Vsi, ki so pisali poizvedbe s takšnim vzorcem, so se gotovo srečali: „Daj mi zadnji naročilo za Vaso, njegovo datum“ In če nimate indeksa po datumu, ali v uporabljenem indeksu ni datuma, potem ravno na takšne „grablje“ boste stopili.
Toda vemo, da so to „grablje“ — zakaj torej takoj ne svetovati razvijalcu, kaj naj naredi. Tako da, ko odpre načrt, naš razvijalec takoj vidi lepo sliko s namigi, kjer mu takoj povedo: „Tukaj in tukaj imaš težave, rešitve so takšne in takšne.“
Zaradi tega se je količina izkušenj, ki je bila potrebna za reševanje problemov na začetku in zdaj, zmanjšala za večkrat. Tak instrument imamo zdaj.
Izvor: habr.com
