

Дзииииииинь! В 3 часа ночи вы смотрите чудесный сон, и вдруг — звонок. На этой неделе вы дежурите, и, похоже, что-то случилось. Автоматизированная система зовет разобраться в проблеме. Это важный аспект управления современными компьютерными системами, но давайте посмотрим, как сделать уведомления более удобными для людей.
Познакомьтесь с философией мониторинга, возникшей за несколько десятилетий моих дежурств в различных командах по мониторингу. Она во многом была сформирована настоящей библией от Роба Еващука. (включенная в книгу по , и книга Джона Олспо Келли Данн
, in Что такое CASE?
Я решил придумать красивую аббревиатуру, как у
метода USE Брендана Грегга ili метод CASE. Он описывает четыре момента, на которые нужно обратить внимание при работе с автоматическим мониторингом:связанность с контекстом
- действие
- основываясь на симптомах
- оценка
- Если вы используете CASE, вы относитесь к уведомлениям с дозой здорового пофигизма и не будите людей по ночам. Нужно регулярно оценивать мониторинг на полезность и эффективность. Когда человек получит уведомление, у него будут лучшие ментальные модели и больше уверенности.
Чтобы легче запомнилось, представьте, что вам нужен CASE [то есть кейс, причина —
прим. переводчика ], чтобы оправдать каждое оповещение. :sunglasses:И зачем это все?
Дежурство может быть мучением.
Прелесть методов RED и USE в том, что с их помощью мы не только знаем, как работать, но и говорим друг с другом на одном языке. Я надеюсь, что с методом CASE будет проще обсуждать уведомления, которые защищают наши системы, но не дают покоя коллегам.
Čar metod RED in USE je v tem, da ne samo da vemo, kako delovati, ampak tudi, da se znamo pogovarjati v istem jeziku. Upam, da bo z metodo CASE lažje razpravljati o obvestilih, ki ščitijo naše sisteme, a našim kolegom ne dajo miru.
Bistvo je v tem, da je treba v organizaciji ustvariti kulturo, v kateri se obvestilom pristopa z zdravo indiferentnostjo. Obvestila se lahko ustvarjajo upravičeno, a ni nujno, da kasneje ne izgubijo vrednosti. Zakaj smo nastavili to obvestilo? Ali so bila njegova merila kdaj prej pregledana? Na ta vprašanja lahko najdemo odgovore s CASE.
Povezano s kontekstom
3 ure zjutraj ni najboljši čas za branje sporočil, v katerih je veliko pametnih besed. Da bi učinkovito reagirali, potrebujemo informacije. Idealno naj bi to bile informacije o posebnem problemu, glede katerega je takoj razumljiv kontekst, in obvestila je treba nastaviti tako, da je to mogoče. To je 'opazovanje' in 'usmerjanje' iz . Na to nastavitev ne škodi porabiti časa, ker nenehno odvajanje človeka stane še več. Spoštujmo se.
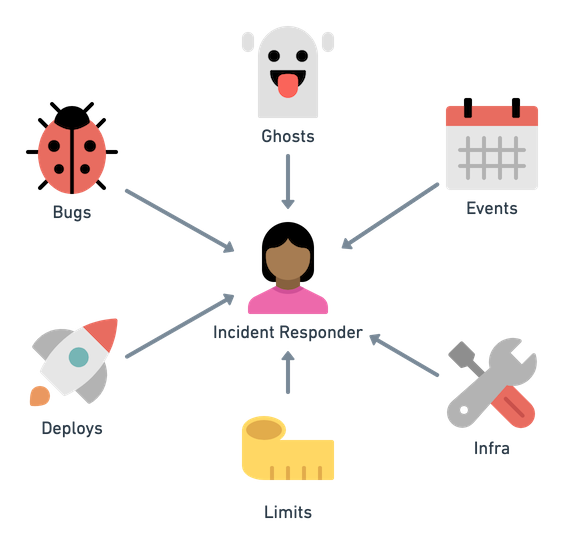
Problemi imajo številne vire. Še posebej duhovi.
Kako pomagati dežurnemu? Najprej dežurni vidi obvestilo, zato vse hipoteze gradi na njegovi osnovi. Potem pogleda navodila in nadzorne plošče, vendar so tam vedno podatki o določenem obvestilu, ne le splošne informacije? Olspo svetuje 'premisliti, kako lahko obvestilo interpretiramo ali na njega reagiramo' (slajd 29). Dobro obvestilo je usmerjeno na dežurnega, ne pa zgolj nastavljeno po pragovni vrednosti.
Zato je tukaj nekaj idej, kako izboljšati kontekst obvestil:
- Prikažite uporabniku nekaj koristnega in posebej ustvarjenega, ne pa le običajnih navodil ali nadzorne plošče. Pred časom smo s sodelavci uporabljali nadzorne plošče za raziskavo, nastavljene na določena obvestila. To bo pomagalo, če je problem znan, in v drugih primerih le zmedlo. Tu je treba najti ravnovesje.
- Povejte zgodbo obvestila: je novo? Pogosto se sproži? Je sezonsko?
- Prikažite nedavne spremembe v stanju sistema. Se je pred kratkim kaj spremenilo? (Na primer, uvedba ali vklop/izklop funkcionalnosti.)
- Prikažite odnose in zagotovite informacije za mentalni model: odvisnosti sistema morajo biti jasno prikazane, zaželeno je z označbami delovanja.
- Takojšnje povezovanje uporabnika s ekipo: ali vidi trenutne incidente ali lahko izve, kdo drug v podjetju je prejel obvestilo? Program je aktivirana?
Ideálně by program pro správu incidentů měl nabízet rady, jak zlepšit kontext upozornění při vyšetřování incidentů. Vždy je co zlepšovat!
Akční — praktická hodnota
Má se pohotovostní pracovník na upozornění nějakým způsobem reagovat? Pokud není potřeba jednat nebo není jasné, co dělat, proč byli probuzeni? Je třeba se vyhnout upozorněním, která obtěžují pohotovostní pracovníky a nevyžadují žádné akce.
Co mám dělat? Co je potřeba?
Dříve, když byly systémy jednoduché a týmy malé, jsme nastavovali monitoring, abychom byli informováni o aktuálním stavu. Upozornění na zvýšení zatížení haldy nám poskytne kontext, pokud služba začne mít problémy. Ve velkém měřítku taková upozornění jen zmatou, protože naše systémy vždy fungují ve stavu degradačních variant. To rychle vede k a, samozřejmě, k ztrátě citlivosti. Proto pohotovostní pracovník ignoruje nebo dokonce filtruje taková upozornění a ne vždy na ně reaguje tak, jak by měl. Nenechte se chytit do této pasti! Nenastavujte všechna upozornění za sebou, abyste je pak posílali na e-mail do nějaké zapomenuté složky.
Takto vypadá upozornění s praktickou hodnotou:
- Upozornění vyžaduje akci, nikoli pouze informuje o novinkách.
- Tuto akci je obtížné nebo riskantní automatizovat. Pokud je akci možné automatizovat, tak ji prostě automatizujte, přestaňte obtěžovat lidi!
- Upozornění obsahuje naléhavá doporučení ve formě (SLA) nebo (RTO). Poté může pohotovostní pracovník zapojit program pro správu incidentů ve firmě.
Chci upřesnit: neříkám, že upozornění by měla přicházet pouze pro ty nejdůležitější SLO (cíle úrovně služeb) pro API. Monitoring SLO je neustále rozdělován a vyžaduje stejný přístup ke všem službám. Je jasné, že budete sledovat nejdůležitější SLO pro zákazníky, kteří vám platí. Ale SLO infrastruktury, například databáze, je také třeba sledovat. Brzy se budete muset zabývat interními zákazníky a podporovat je. A tak dál do nekonečna.
Symptomatický — důraz na symptomy
Ne glede na to, ali se vam to zdi všeč ali ne, delate v razdeljeni sistem (Kavadh). Zaradi tega uporabljate različne taktike za izolacijo storitev in zaščito pred napakami (Trainor et al.)3. In čeprav dolgotrajno zbiranje smeti ali zataknjena poizvedba v bazi podatkov nakazujeta na težave, jih ni treba takoj odpraviti, če uporabnikom to ne povzroča težav v bližnji prihodnosti.
To so pomembni signali in lahko imajo praktično vrednost, vendar če ne ovirajo uporabnikov, to ni tako nujno, da bi dalo pozornost dežurnemu. Obvestila, ki temeljijo na vzrokih, so posnetki naših mentalnih modelov o sistemski okvari. Raje spremljajte pomembne simptome, kot pa da poskušate naštevati vse možne vzroke okvare.
Da bi imela obvestila praktično vrednost, se osredotočite na , ki so pomembni za uporabnike. Evashchuk to imenuje "monitoring za uporabnike". Zapomnite si, da je to filozofijo treba uveljaviti v celotnem podjetju. Če se v storitvi globoko znotraj infrastrukture pojavijo nujne težave, se bo z njimi ukvarjala ustrezna ekipa. Zaščita sistemov pred takimi napakami je povsem druga vprašanje (Trainor et al., razdelek o strategijah za zmanjšanje kritičnih odvisnosti).
Simptomi niso tako spremenljivi
Richard Cook opozarja, da ima v zapletenih sistemih kup napak, pomanjkljivosti in težav. Poskušanje naštevanja vseh možnih vzrokov je Sizifovo delo. Poskušate opisati težave, medtem ko se te neprestano spreminjajo. Cindy Shridharan meni, da "sistemi ne morejo vedno biti v idealnem stanju vsako sekundo" in je bolje uporabiti bolj človeški pristop ( ("Distributed Systems Observability"), 7).
Izogibajte se obvestilom ob incidentu
Običajno so za odpravo incidentov nastavljena obvestila o vzrokih. In ta omejena obvestila o dejstvu dogodka ustvarjajo lažen občutek zaupanja, saj sistem vsakokrat najde nove načine, kako se sesedeti.
Ne zavajajte se z obvestili o vzrokih. Rajši razmislite:
- Zakaj obvestilo, ki temelji na simptomih, ni opazilo težave?
- Bo koristno izboljšati kontekst za uporabnika?
- Kako izboljšati orodja za spremljanje, da hitreje postavimo diagnozo in ne kopičimo obvestil o preteklih dogodkih?
Orodja za spremljanje za diagnostiko bodo pomagala le, če jih boste obravnavali kot način prehoda od simptomov do rešitev. Brez povratnih informacij vas bodo preplavila zamujena obvestila in grafi preteklih napak – in nič o prihodnjih. Za organizacijo je to odlična priložnost, da preide iz obrambne v napadalno strategijo. Tudi razvijalci in vodje produktov bodo imeli enaka pričakovanja in jasne cilje. Primer - CASE (:wink:) - za vsako obvestilo je jasen.
Obvestila na podlagi vzroka so sprejemljiva v zmernih količinah.
Včasih naš sistem skorajda ne pusti možnosti za obvestila na podlagi vzroka. Drugič pa kipeči dobro razumejo, da bo simptom nujno vodil do napake, kar pomeni, da ima praktično vrednost. Morda preprosto niste prepričani, kaj se dogaja, in nastavite obvestila za vsak slučaj. Upajmo, da je to dejanje začasno, dokler ne prilagodimo sistema, da rešimo vprašanje zmanjšane zmogljivosti.
Ne pozabite na druge komponente CASE, ko se srečujete s takšnimi situacijami. Če je to začasno, ne pomeni, da ne smete razmišljati.
Evaluated — ocenjeno
Vsaka sprememba v sistemu (nov kod, nova infrastruktura, karkoli novega) povečuje vrsto napak (Cook, 3). Ali to obvestilo še vedno deluje, kot je bilo pričakovano? Jasni in aktualni mentalni modeli sistemov ter izkušnje pri odzivanju na nekatera obvestila podpirajo so ključne značilnosti Napake v sistemih se nenehno razvijajo in mi se moramo prilagajati.
Nenehno je treba ocenjevati kakovost vsakega obvestila, da delujejo, kot je bilo pričakovano. Spoštovani voditelji! Vašim ekipam bo veliko lažje, če jim pomagate vzpostaviti ta proces! Tukaj je nekaj idej za ocenjevanje:
- Iskoristite , ali druge metode testiranja obvestil. Ekipa to lahko izvede sama, brez angažiranja težkega sistema za upravljanje incidentov!
- Vključite zbir podatkov o vseh obvestilih, povezanih z incidenti, v program za upravljanje incidentov. Oznake naj bodo koristne, škodljive, neprimerne, nejasne itd. Uporabite jih kot povratne informacije.
- Pravilna obvestila se redko sprožijo in so temeljito preverjena. Prepričajte se, da vsi povezave delujejo in kažejo na ustrezen kontekst itd.
- Če obvestilo nikoli ni sproženo ali se sproži prepogosto, to pomeni, da je nekaj narobe. Popravite ga ali izbrišite. Pazite na pretirano pasivnost ali aktivnost!
- Nastavite časovne oznake za obvestila z rokom trajanja. Ko rok poteče, ovrednotite obvestilo po metodi CASE in posodobite časovno oznako. Redno preverjajte rok trajanja, kot pri hrani.
- Poenostavite postopek izboljšanja obvestil. Uporabite spremljanje v obliki kode in shranite obvestila v Git repozitorij. Pull-requesti pomagajo vključiti ekipo in imeli boste zgodovino prejšnjih obvestil. Tako se ne boste več bali spreminjati obvestil ali prositi za dovoljenje tistih, ki so za njih odgovorni.
- Uvedite povratne informacije za obvestila, tudi če je to preprosta , da dežurni označijo obvestila kot neuporabna ali vsiljiva. Vključite v samo obvestilo povezavo ali poziv k dejanju in redno pregledujte povratne informacije.
- Uvedite pravilo v ekipi — naj dežurni delajo na poenostavitvi dežurstva, ko je dela malo. Naj po vas ostane vsaj malo bolje, kot je bilo prej.
Zaključek
Menim, da metoda CASE pomaga razvijalcem in organizacijam razpravljati o nastavitvi in pošiljanju avtomatiziranih obvestil. En razvijalec lahko začne vrednotiti obvestila po metodi CASE, nato pa se mu pridruži cela organizacija z drugimi razvijalci, vodstvom in programi za upravljanje incidentov, da bi obdržali obvestila v dobrem stanju. Za to niso potrebna nobena posebna orodja ali zapleteni postopki.
Vsa industrija bi morala razmisliti o človeškem faktorju med dežurstvom brez žrtvovanja odlične storitve za stranke. Vsa ta orodja in prakse je mogoče in potrebno izboljšati. Upam, da bo metoda CASE v tem pomagala.
Uživajte v izboljšanih obvestilih!
Izvor: habr.com
