

Pozdrav.
Odlučio sam podijeliti svoje otkriće — plod razmišljanja, pokušaja i pogrešaka.
U suštini: ovo nije nikakvo otkriće, naravno — sve to bi trebalo biti dobro poznato onima koji se bave obrada podataka i optimizacijom bilo kojih sustava, ne nužno samo baza podataka.
I: da, znaju, pišu zanimljive članke o svojim istraživanjima, (UPD: u komentarima su naveli na vrlo zanimljiv projekt: )
S druge strane: na brzinu ne primjećujem široku upotrebu ovog pristupa u internetu, među IT stručnjacima, DBA-ima.
Dakle, na suštini.
Pretpostavimo da imamo zadatak: postaviti neki servisni sustav za obavljanje određenog posla.
O tom poslu — poznato je: kakav je, kako se mjeri kvaliteta tog posla i koji su kriteriji mjerenja te kvalitete.
Također, pretpostavimo da je više-manje poznato: kako se rad obavlja u (ili s) ovim servisnim sustavom.
"Više-manje" — to znači da postoji mogućnost pripreme (ili negdje nabavke) nekog alata, usluge ili servisa s kojim se može sintetizirati i podnijeti testna opterećenja dovoljno adekvatna onome što će biti u produkciji, u adekvatnim uvjetima rada u produkciji.
I, pretpostavimo da su poznati setovi parametara koje možemo prilagoditi u ovom servisnom sustavu, radi povećanja produktivnosti njegovog rada.
I, u čemu je problem — nema dovoljno potpunog razumijevanja ovog servisnog sustava, takvog koje bi omogućilo stručno postavljanje konfiguracije sustava za buduće opterećenje na ovoj platformi i postizanje potrebne produktivnosti rada sustava.
Pa. Tako gotovo uvijek biva.
Što se ovdje može učiniti.
Pa, prvo što pada na pamet: zaviriti u dokumentaciju ovog sustava. Shvatiti — koji su prihvatljivi opsezi za vrijednosti podešavanja parametara. I, na primjer, metodom koordinatnog spuštanja, odabrati vrijednosti za parametre sustava u testovima.
T.j. odrediti sustavu neku konfiguraciju u obliku konkretnog skupa vrijednosti njezinih podešenih parametara.
Podnijeti mu testno opterećenje, ovim alatom—uslugom, load-generatorom.
In view of the response time — or the quality metric of the system's performance.
A second thought might be the conclusion that — this takes a long time.
So, i.e.: if there are many configurable parameters, if the ranges of their values are large, if each individual load test takes a lot of time to execute, then: yes, this can take an unacceptably long time.
And here, one can understand and remember what can be understood.
You can find out the set of configurable parameter values of the service system — a vector, as a sequence of some values.
To each such vector, with all other things being equal (in that it is not affected by this vector), there corresponds a well-defined metric value — a quality indicator of the system's performance under test load.
That is,
Let’s denote the configuration vector of the system as  , gde
 ; where
 — the number of configuration parameters of the system, how many of them, these parameters.
And the metric value corresponding to this  let's denote as
 , then we have a function:

Well, then everything immediately comes down to, in my case: almost forgotten from my student days, algorithms for finding the extrema of a function.
Okay, but here arises an organizational-practical question: which specific algorithm to use.
- In the sense — to code as little as possible by hand.
- And to ensure it works, i.e., to find the extremum (if it exists), at least — faster than coordinate descent.
The first point hints that we need to look towards some environments where such algorithms — are already implemented, and there are, in some form, ready to be used in code.
Well, I know about python in cran-r
The second point indicates that we need to read about the algorithms themselves, what they are, their requirements, peculiarities in operation.
And what they provide, there can be useful side effects/results, either directly, from the algorithm itself.
Or they can be obtained from the results of the algorithm's work.
Much depends on the input conditions.
For example, if for some reason, you need to get a result faster, well, you need to look towards gradient descent algorithms, choosing one of them.
Or, if time is not that critical, you can, for example, use stochastic optimization methods, like genetic algorithms.
Predlagam, da razmislite o delovanju takega pristopa k izbiri konfiguracije sistema z uporabo genetskega algoritma pri naslednjem laboratorijskem delu.
Izvorni:
- Naj bo kot servisni sistem:
oracle xe 18c - Naj opravlja transakcijsko aktivnost in cilj je doseči čim večjo propustnost DBMS-a po transakcijah / sek.
- Transakcije so lahko zelo različne v svojem načinu dela z podatki in kontekstu delovanja.
Dogovorimo se, da gre za transakcije, ki ne obdelujejo velike količine tabelaričnih podatkov.
V tem smislu ne generirajo več uundo podatkov kot redo in ne obdelujejo velikih odstotkov vrstic velikih tabel.
To so transakcije, ki spreminjajo eno vrstico v razmeroma veliki tabeli z majhnim številom indeksov nad to tabelo.
V takem okviru bo produktivnost DBMS-a pri obdelavi transakcij, s predpostavko, določena s kakovostjo obdelave baz redo podatkov.
Predpostavka — če govorimo točno o nastavitvah DBMS-a.
Ker so v splošnem lahko na voljo transakcijske blokade med SQL sejami zaradi zasnove spletne uporabniške interakcije s tabelaričnimi podatki in/ali tabelaričnim modelom.
Te bodo seveda negativno vplivale na metriko TPS, to bo eksogen, glede na DBMS, dejavnik: tako je bil zasnovan tabelarični model in delo s podatki, da pride do blokad.
Zato bomo za čistočo eksperimenta izključili ta dejavnik, spodaj bom natančneje pojasnil kako.
- Predpostavimo, da je za določnost 100% SQL ukazov, podanih v DBMS: to DML ukazi.
Naj bodo značilnosti uporabniškega dela z DBMS: enake v testih.
In sicer: število SQL sej, tabelarični podatki, kako te SQL seje delajo s temi podatki. - DBMS deluje v
FORCE LOGGING,ARCHIVELOGnačinah. Način flashback datoteke je izklopljen, na ravni DBMS-a. - Redo dnevniki: so locirani v ločenem datotečnem sistemu, na ločenem "disku";
Vsa ostala fizična komponenta baze podatkov: je v drugem ločenem FS, na ločenem "disku":
Podrobneje o strukturi fizične komponente laboratorijske baze podatkov.
SQL> select status||' '||name from v$controlfile;
 /db/u14/oradata/XE/control01.ctl
SQL> select GROUP#||' '||MEMBER from v$logfile;
1 /db/u02/oradata/XE/redo01_01.log
2 /db/u02/oradata/XE/redo02_01.log
SQL> select FILE_ID||' '||TABLESPACE_NAME||' '||round(BYTES/1024/1024,2)||' '||FILE_NAME as col from dba_data_files;
4 UNDOTBS1 2208 /db/u14/oradata/XE/undotbs1_01.dbf
2 SLOB 128 /db/u14/oradata/XE/slob01.dbf
7 USERS 5 /db/u14/oradata/XE/users01.dbf
1 SYSTEM 860 /db/u14/oradata/XE/system01.dbf
3 SYSAUX 550 /db/u14/oradata/XE/sysaux01.dbf
5 MONITOR 128 /db/u14/oradata/XE/monitor.dbf
SQL> !cat /proc/mounts | egrep "/db/u[0-2]"
/dev/vda1 /db/u14 ext4 rw,noatime,nodiratime,data=ordered 0 0
/dev/mapper/vgsys-ora_redo /db/u02 xfs rw,noatime,nodiratime,attr2,nobarrier,inode64,logbsize=256k,noquota 0 0
Sprva sem želel uporabiti transakcijske baze podatkov za te obremenitvene pogoje.
Ima čudovito lastnost, citiram avtorja:
V središču SLOB-a je 'SLOB metoda.' SLOB metoda si prizadeva testirati platforme
brez vsebinskih sporov aplikacij. Ne morete doseči maksimalne zmogljivosti strojne opreme
z aplikacijskim kodo, ki je, na primer, omejena z zaklepanjem aplikacij ali celo
deljenje Oracle Database blokov. Prav imate — pri deljenju podatkov
v podatkovnih blokih je prevelika obremenitev! Ampak SLOB — v svojem privzetem uvajanju — je imunski na takšne spore.
Ta izjava: drži, in tako je.
Enostavno je prilagoditi stopnjo paralelizma SQL sej, to je ključno -t za zagon orodja runit.sh iz SLOB-a
Ureja se odstotek DML ukazov, v tistem številu SQL-ov, ki jih pošilja v bazo podatkov, vsak SQL-seja, parameter UPDATE_PCT
Ločeno in zelo priročno: SLOB samo pred in po obremenitveni seji — pripravi statspak ali AWR posnetke (kar je določeno za pripravo).
Vendar pa se je pokazalo, da SLOB ne podpira dela SQL sej z dolžino manj kot 30 sekund.
Zato sem sprva napisal svoj delovni različico obremenitvenega orodja, nato pa je tako ostal v uporabi.
Dovolite mi, da razjasnim glede obremenitvenega orodja — kaj in kako deluje, za jasnost.
V bistvu obremenitveno orodje izgleda takole:
Koda delavca
function dotx()
{
local v_period="$2"
[ -z "v_period" ] && v_period="0"
source "/home/oracle/testingredotrace/config.conf"

$ORACLE_HOME/bin/sqlplus -S system/${v_system_pwd} << __EOF__
whenever sqlerror exit failure
set verify off
set echo off
set feedback off

define wnum="$1"
define period="$v_period"
set appinfo worker_&&wnum

declare
 v_upto number;
 v_key  number;
 v_tots number;
 v_cts  number;
begin
 select max(col1) into v_upto from system.testtab_&&wnum;
 SELECT (( SYSDATE - DATE '1970-01-01' ) * 86400 ) into v_cts FROM DUAL;
 v_tots := &&period + v_cts;
 while v_cts <= v_tots
 loop
  v_key:=abs(mod(dbms_random.random,v_upto));
  if v_key=0 then
   v_key:=1;
  end if;
  update system.testtab_&&wnum t
  set t.object_name=translate(dbms_random.string('a', 120), 'abcXYZ', '158249')
  where t.col1=v_key
  ;
  commit;
  SELECT (( SYSDATE - DATE '1970-01-01' ) * 86400 ) into v_cts FROM DUAL;
 end loop;
end;
/

exit
__EOF__
}
export -f dotx
Delavci se zaženejo na naslednji način:
Zagon delavcev
echo "начало теста, продолжительность: ${TEST_DURATION}" >> "$v_logfile"
for((i=1;i> "$v_logfile"
 dotx "$i" "${TEST_DURATION}" &
done
echo "ожидание..." >> "$v_logfile"
wait
А таблицы для воркеров готовятся так:
Создание таблиц
function createtable() {
source "/home/oracle/testingredotracе/config.conf"
$ORACLE_HOME/bin/sqlplus -S system/${v_system_pwd} << __EOF__
whenever sqlerror continue
set verify off
set echo off
set feedback off

define wnum="$1"
define ts_name="slob"

begin
 execute immediate 'drop table system.testtab_&&wnum';
exception when others then null;
end;
/

create table system.testtab_&&wnum tablespace &&ts_name as
select rownum as col1, t.*
from sys.dba_objects t
where rownum> "$v_logfile"
Т.е. под каждый воркер (практически: отдельная SCN-сессия в СУБД) создаётся отдельная таблица, с которой и работает воркер.
Этим достигается отсутствие транзакционных блокировок между SCN-сессиями воркеров.
Каждый воркер выполняет одно и то же с собственной таблицей; таблицы все идентичны.
Все воркеры выполняют работу в течение одного и того же количества времени.
Причём достаточно долгого времени, чтобы, например, произошёл лог-свичинг, и не один раз.
Соответственно, это приводит к связанным затратам и эффектам.
В моём случае продолжительность работы воркеров была установлена на 8 минут.
Часть статистического отчёта, описывающего работу СУБД под нагрузкой.
Baza podataka    DB ID    Instanca     Broj Inst    Vrijeme pokretanja   Verzija     RAC
~~~~~~~~ ----------- ------------ -------- --------------- ----------- ---
          2929910313 XE                  1 07-Sep-20 23:12 18.0.0.0.0  NE

Naziv hosta             Platforma                CPU-jevi Jezgre Utori   Memorija (G)
~~~~ ---------------- ---------------------- ----- ----- ------- ------------
     billing.izhevsk1 Linux x86 64-bit           2     2       1         15.6

Snapshot       Snap ID     Snap Vrijeme      Sesije Curs/Sess Komentar
~~~~~~~~    ---------- ------------------ -------- --------- ------------------
Početak Snap:       1630 07-Sep-20 23:12:27       55        .7
  Kraj Snap:       1631 07-Sep-20 23:20:29       62        .6
   Proteklo:       8.03 (min) Prosječna aktivna sesija:       8.4
   DB vrijeme:      67.31 (min)      DB CPU:      15.01 (min)

Cache veličine            Početak        Kraj
~~~~~~~~~~~       ---------- ----------
    Buffer Cache:     1,392M              Standardna veličina bloka:         8K
     Shared Pool:       288M                  Log Buffer:   103,424K

Profil opterećenja              Po Sekundi    Po Transakciji    Po Izvršenju    Po Pozivu
~~~~~~~~~~~~      ------------------  ----------------- ----------- -----------
      DB vrijeme(s):                8.4                0.0        0.00        0.20
       DB CPU(s):                1.9                0.0        0.00        0.04
       Redo veličina:        7,685,765.6              978.4
   Logička čitanja:           60,447.0                7.7
   Promjene bloka:           47,167.3                6.0
  Fizička čitanja:                8.3                0.0
 Fizička pisanja:              253.4                0.0
      Korisnički pozivi:               42.6                0.0
          Parsiranja:               23.2                0.0
     Teška parsiranja:                1.2                0.0
W/A MB obrađeno:                1.0                0.0
          Logovanja:                0.5                0.0
        Izvršenja:           15,756.5                2.0
       Poništavanja:                0.0                0.0
    Transakcije:            7,855.1
Vraćajući se na zadatak laboratorijskog rada.
Na slične uvjete, mijenjat ćemo vrijednosti sljedećih parametara laboratorijske DB:
- Veličina grupnih dnevnika DB. raspon vrijednosti: [32, 1024] MB;
- Broj grupnih dnevnika DB. raspon vrijednosti: [2,32];
log_archive_max_processesraspon vrijednosti: [1,8];commit_loggingdozvoljena su dva vrijednosti:batch|immediate;commit_waitdozvoljena su dva vrijednosti:wait|nowait;log_bufferraspon vrijednosti: [2,128] MB.log_checkpoint_timeoutraspon vrijednosti: [60,1200] sekundidb_writer_processesraspon vrijednosti: [1,4]undo_retentionraspon vrijednosti: [30;300] sekunditransactions_per_rollback_segmentraspon vrijednosti: [1,8]disk_asynch_iodozvoljena su dva vrijednosti:true|false;filesystemio_optionsdozvoljene su sljedeće vrijednosti:none|setall|directIO|asynch;db_block_checkingdozvoljene su sljedeće vrijednosti:OFF|LOW|MEDIUM|FULL;db_block_checksumdozvoljene su sljedeće vrijednosti:OFF|TYPICAL|FULL;
Osoba sa iskustvom u održavanju oracle baza podataka, sigurno već sada može reći — koje i koje vrijednosti treba postaviti od navedenih parametara i njihovih dopuštenih vrijednosti, kako bi se postigla veća produktivnost DB, za rad s podacima koji je označen, aplikativnim kodom, ovdje, gore.
Ali.
Namen laboratorijske naloge je pokazati, da optimizacijski algoritem deluje hitro in učinkovito.
Za nas: ostane le, da pogledamo v dokumentacijo nastavljivega sistema, natančno toliko, kolikor je potrebno, da ugotovimo, kateri parametri in v katerih razponih jih je treba spremeniti.
Prav tako je treba kodirati kodo, ki bo izvajala delovanje z nastavljivim sistemom izbranega optimizacijskega algoritma.
Torej zdaj k kodi.
Zgornje sem omenil o cran-r, tj.: vse manipulacije z nastavljivim sistemom se orkestrirajo v obliki R-skripte.
Uresničitev naloge, analiza, izbira glede na vrednost metrike, vektorjev stanja sistema: to je paket GA ()
Paket, v tem primeru, ni povsem ustrezen, ker pričakuje, da se vektorji (kromosomi, če uporabimo terminologijo paketa) predložijo kot zaporedje števil s decimalnimi mesti.
Moj vektor, iz vrednosti nastavljivih parametrov: to je 14 veličin — celoštevilčne in nizovne vrednosti.
Težava seveda enostavno preseže z dodelitvijo nizov določene številke.
Torej, na koncu, glavni del R-skripte izgleda takole:
Klic GA::ga
cat( "", file=v_logfile, sep="n", append=F)

pSize = 10
elitism_value=1
pmutation_coef=0.8
pcrossover_coef=0.1
iterations=50

gam=GA::ga(type="real-valued", fitness=evaluate,
lower=c(32,2, 1,1,1,2,60,1,30,1,0,0, 0,0), upper=c(1024,32, 8,10,10,128,800,4,300,8,10,40, 40,30),
popSize=pSize,
pcrossover = pcrossover_coef,
pmutation = pmutation_coef,
maxiter=iterations,
run=4,
keepBest=T)
cat( "GA-session is done" , file=v_logfile, sep="n", append=T)
gam@solution
Tukaj s pomočjo lower in upper atributov podprograma ga se določi, v bistvu, območje iskalnega prostora, v katerem bo potekalo iskanje takega vektorja (ali vektorjev), za katerega bo dosežena maksimalna vrednost funkcije fitnesa.
Podprogram ga izvaja iskanje, medtem ko maksimizira funkcijo fitnesa.
Torej, v tem primeru, je potrebno, da funkcija fitnesa, ki razume vektor kot niz vrednosti za določene parametre DBMS, pridobi metriko iz DBMS.
Tj.: koliko, pri danih nastavitvah DBMS in obremenitvi na DBMS: DBMS obdeluje transakcij na sekundo.
Torej, razdeljeno na dele, je potrebno, da znotraj funkcije fitnesa poteka takšna zapletena obdelava:
- Obdelava vhodnega vektorja števil — pretvorba le-tega v vrednosti za parametre DBMS.
- Poskus ustvarjanja določenega števila redo-skupin, določene velikosti. Pri čemer je poskus lahko neuspešen.
Obstoječe u subd novinske grupe, u nekom broju i neke veličine, za čistoću eksperimenta — treba da se izbrišu. - U slučaju uspeha prethodne tačke: postavljanje baze vrednosti konfiguracionih parametara (ponovo: može doći do kvara)
- U slučaju uspeha prethodne tačke: zaustavljanje subd, pokretanje subd kako bi ponovo postavljene vrednosti parametara – stupile na snagu. (ponovo: može doći do kvara)
- U slučaju uspeha prethodne tačke: izvršiti test opterećenja. dobiti metrik iz subd.
- Vratiti subd u prvobitno stanje, tj. obrisati dodatne novinske grupe, vratiti u rad prvobitnu konfiguraciju subd.
Kod fitnes funkcije
evaluate=function(p_par) {
v_module="evaluate"
v_metric=0
opn=NULL
opn$rg_size=round(p_par[1],digit=0)
opn$rg_count=round(p_par[2],digit=0)
opn$log_archive_max_processes=round(p_par[3],digit=0)
opn$commit_logging="BATCH"
if ( round(p_par[4],digit=0) > 5 ) {
 opn$commit_logging="IMMEDIATE"
}
opn$commit_logging=paste("'", opn$commit_logging, "'",sep="")

opn$commit_wait="WAIT"
if ( round(p_par[5],digit=0) > 5 ) {
 opn$commit_wait="NOWAIT"
}
opn$commit_wait=paste("'", opn$commit_wait, "'",sep="")

opn$log_buffer=paste(round(p_par[6],digit=0),"m",sep="")
opn$log_checkpoint_timeout=round(p_par[7],digit=0)
opn$db_writer_processes=round(p_par[8],digit=0)
opn$undo_retention=round(p_par[9],digit=0)
opn$transactions_per_rollback_segment=round(p_par[10],digit=0)
opn$disk_asynch_io="true"
if ( round(p_par[11],digit=0) > 5 ) {
 opn$disk_asynch_io="false"
}

opn$filesystemio_options="none"
if ( round(p_par[12],digit=0) > 10 && round(p_par[12],digit=0)  20 && round(p_par[12],digit=0)  30 ) {
 opn$filesystemio_options="asynch"
}

opn$db_block_checking="OFF"
if ( round(p_par[13],digit=0) > 10 && round(p_par[13],digit=0)  20 && round(p_par[13],digit=0)  30 ) {
 opn$db_block_checking="FULL"
}

opn$db_block_checksum="OFF"
if ( round(p_par[14],digit=0) > 10 && round(p_par[14],digit=0)  20 ) {
 opn$db_block_checksum="FULL"
}

v_vector=paste(round(p_par[1],digit=0),round(p_par[2],digit=0),round(p_par[3],digit=0),round(p_par[4],digit=0),round(p_par[5],digit=0),round(p_par[6],digit=0),round(p_par[7],digit=0),round(p_par[8],digit=0),round(p_par[9],digit=0),round(p_par[10],digit=0),round(p_par[11],digit=0),round(p_par[12],digit=0),round(p_par[13],digit=0),round(p_par[14],digit=0),sep=";")
cat( paste(v_module," try to evaluate vector: ", v_vector,sep="") , file=v_logfile, sep="n", append=T)

rc=make_additional_rgroups(opn)
if ( rc!=0 ) {
 cat( paste(v_module,"make_additional_rgroups failed",sep="") , file=v_logfile, sep="n", append=T)
 return (0)
}

v_rc=0
rc=set_db_parameter("log_archive_max_processes", opn$log_archive_max_processes)
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("commit_logging", opn$commit_logging )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("commit_wait", opn$commit_wait )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("log_buffer", opn$log_buffer )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("log_checkpoint_timeout", opn$log_checkpoint_timeout )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("db_writer_processes", opn$db_writer_processes )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("undo_retention", opn$undo_retention )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("transactions_per_rollback_segment", opn$transactions_per_rollback_segment )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("disk_asynch_io", opn$disk_asynch_io )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("filesystemio_options", opn$filesystemio_options )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("db_block_checking", opn$db_block_checking )
if ( rc != 0 ) {  v_rc=1 }
rc=set_db_parameter("db_block_checksum", opn$db_block_checksum )
if ( rc != 0 ) {  v_rc=1 }

if ( rc!=0 ) {
 cat( paste(v_module," can not startup db with that vector of settings",sep="") , file=v_logfile, sep="n", append=T)
 rc=stop_db("immediate")
 rc=create_spfile()
 rc=start_db("")
 rc=remove_additional_rgroups(opn)
 return (0)
}

rc=stop_db("immediate")
rc=start_db("")
if ( rc!=0 ) {
 cat( paste(v_module," can not startup db with that vector of settings",sep="") , file=v_logfile, sep="n", append=T)
 rc=stop_db("abort")
 rc=create_spfile()
 rc=start_db("")
 rc=remove_additional_rgroups(opn)
 return (0)
}

rc=run_test()
v_metric=getmetric()

rc=stop_db("immediate")
rc=create_spfile()
rc=start_db("")
rc=remove_additional_rgroups(opn)

cat( paste("result: ",v_metric," ",v_vector,sep="") , file=v_logfile, sep="n", append=T)
return (v_metric)
}
Torej, vse delo: poteka v funkciji fitnesa.
ga-podprogram, ki obdeluje vektorje, ali pa, pravilneje rečeno — kromosome.
Pri čemer je za nas najpomembnejša: selekcija kromosomov z genomi, pri katerih funkcija fitnesa daje visoke vrednosti.
To je v bistvu postopek iskanja optimalnega nabora kromosomov z vektorjem v N-dimenzionalnem iskalnem prostoru.
Zelo jasno, podrobno , s primeri R-kode, delovanja genetskega algoritma.
Posebej izpostavljam dva tehnična vidika.
Pomožni klici, iz funkcije evaluate, na primer ustavitev-zagon, nastavitev vrednosti parametra sbd, se izvajajo na podlagi cran-r funkcije system2
S pomočjo katere se kliče neka bash-skripta ali ukaz.
Na primer:
set_db_parameter
set_db_parameter=function(p1, p2) {
v_module="set_db_parameter"
v_cmd="/home/oracle/testingredotracе/set_db_parameter.sh"
v_args=paste(p1," ",p2,sep="")

x=system2(v_cmd, args=v_args, stdout=T, stderr=T, wait=T)
if ( length(attributes(x)) > 0 ) {
 cat(paste(v_module," failed with: ",attributes(x)$status," ",v_cmd," ",v_args,sep=""), file=v_logfile, sep="n", append=T)
 return (attributes(x)$status)
}
else {
 cat(paste(v_module," ok: ",v_cmd," ",v_args,sep=""), file=v_logfile, sep="n", append=T)
 return (0)
}
}
Drugi vidik — vrstica evaluate funkcije, s shranjevanjem konkretne vrednosti metrike in ji ustreznega nastavitevnega vektorja v log-datoteko:
cat( paste("result: ",v_metric," ",v_vector,sep="") , file=v_logfile, sep="n", append=T)To je pomembno, saj bo iz te podatkovne zbirke mogoče pridobiti dodatne informacije o tem, kateri izmed komponent nastavitevnega vektorja bolj ali manj vpliva na vrednost metrike.
Torej: mogoče bo izvesti analizo pomembnosti atributov.
Torej, kaj lahko dobimo.
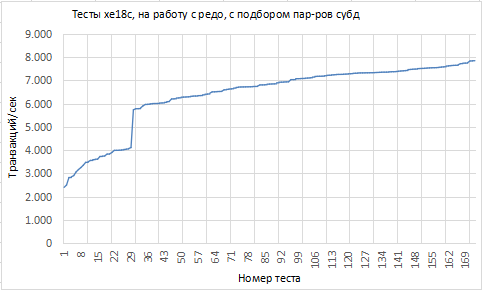
V obliki grafikona, če razporedimo teste po naraščanju metrike, je slika taka:
Nekateri podatki, ki ustrezajo ekstremnim vrednostim metrike:
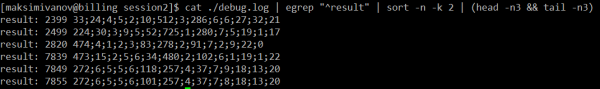
Tukaj, na zaslonu z rezultati, ponovno poudarjam: vrednosti nastavitevnega vektorja — so podane v izrazih kode funkcije fitnesa, ne v izrazih seznama parametrov/področja vrednosti parametrov, kot sem jih oblikoval zgoraj v besedilu.
No. Je to veliko ali malo, ~8 tps: vprašanje je ločeno.
V okviru laboratorijskega dela ta številka ni pomembna, pomembna je dinamika, kako se ta vrednost spreminja.
Dinamika je tu dobra.
Očitno je, da, kot najmanj en dejavnik, pomembno vpliva na vrednost metrike, da je ga-algoritm, ko preizkuša vektorje-kromosome: pokril.
Glede na dostojno dinamično sliko vrednosti krivulje - obstaja še najmanj en faktor, ki čeprav je bistveno manjši, vpliva.
Tukaj potrebujemo attribute-importance analizo, da razumemo, kateri atributi (v tem primeru - komponente nastavljalnega vektorja) in kako močno vplivajo na vrednost metrične.
In na podlagi teh informacij: razumeti - kateri faktorji so bili vključeni spremembami pomembnih atributov.
Izvedi attribute-importance lahko na različne načine.
Zame, za te namene, je algoritem randomForest istoimenskega R paketa ()
randomForest, kot razumem njegovo delovanje na splošno in njegov pristop k oceni pomembnosti atributov posebej, gradi neko modelno odvisnost odzivne spremenljivke od atributov.
V našem primeru je odzivna spremenljivka - to je metrika, pridobljena iz pod podatkovnih baz, v obremenitvenih testih: tps;
In atributi so - komponente nastavljalnega vektorja.
Torej randomForest ocenjuje pomembnost vsakega atributa modela z dvema številoma: %IncMSE - kako prisotnost/odsotnost tega atributa v modelu spreminja kakovost MSE tega modela (Mean Squared Error);
In IncNodePurity - to je številka, ki prikazuje, kako kakovostno, glede na vrednosti tega atributa, lahko razdelimo podatkovni sklop z opazovanji, tako da v eni delujejo podatki z enim vrednostjo razložene metrike, v drugi pa z drugo vrednostjo metrike.
No, torej: kako dober je ta klasifikacijski atribut (najbolj razumljivo pojasnilo o random forestu sem videl ).
Delavski R koda, za obdelavo podatkovnega sklopa z rezultati obremenitvenih testov:
x=NULL
v_data_file=paste('/tmp/data1.dat',sep="")
x=read.table(v_data_file, header = TRUE, sep = ";", dec=",", quote = "'", stringsAsFactors=FALSE)
colnames(x)=c('metric','rgsize','rgcount','lamp','cmtl','cmtw','lgbffr','lct','dbwrp','undo_retention','tprs','disk_async_io','filesystemio_options','db_block_checking','db_block_checksum')

idxTrain=sample(nrow(x),as.integer(nrow(x)*0.7))
idxNotTrain=which(! 1:nrow(x) %in% idxTrain )
TrainDS=x[idxTrain,]
ValidateDS=x[idxNotTrain,]

library(randomForest)
#mtry=as.integer( sqrt(dim(x)[2]-1) )
rf=randomForest(metric ~ ., data=TrainDS, ntree=40, mtry=3, replace=T, nodesize=2, importance=T, do.trace=10, localImp=F)
ValidateDS$predicted=predict(rf, newdata=ValidateDS[,colnames(ValidateDS)!="metric"], type="response")
sum((ValidateDS$metric-ValidateDS$predicted)^2)
rf$importance
Lahko ročno poiščemo hiperpogojne parametre algoritema in se, osredotočamo na kakovost modela, izberemo model, ki natančneje napoveduje na validacijskem podatkovnem sklopu.
Lahko napišemo neko funkcijo za to delo (mimogrede - spet na nekem optimizacijskem algoritmu).
Lahko uporabimo R paket caret, ni je važno.
Kao rezultat, u ovom slučaju, dolazi do ovakvog rezultata, za procjenu stepena važnosti atributa:
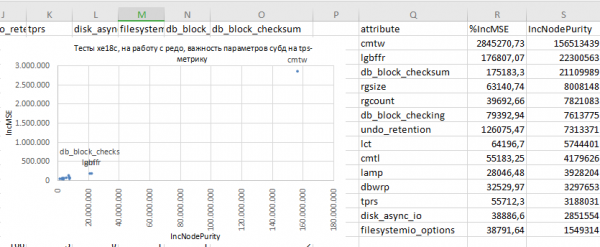
Dakle, možemo preći na globalna razmatranja:
- Ispostavlja se da je najznačajniji, u ovim testnim uslovima, parametar
commit_wait
Tehnički, on definiše režim izvršavanja IO operacija zapisivanja redo podataka, iz log-bufer subd, u trenutnu grupu dnevnika: sinkroni ili asinhroni.
Vrijednostnowaitpri kojoj se dobija praktično vertikalno, višestruko povećanje vrijednosti tps-metra: to je uključivanje asinkronog moda IO u redo grupe.
Posebno pitanje - treba li ili ne treba to raditi u produkcionoj bazi. Ovdje se ograničavam samo na konstataciju: to je značajan faktor. - Logično je da veličina log-bufer subd: ispostavlja se značajnim faktorom.
Što je manja veličina log-bufer, to je manja njegova sposobnost baferisanja, to se češće dešava njegovo prepunjenje i/ili nemogućnost da se u njemu oslobodi prostor za novu porciju redo podataka.
A to znači: kašnjenja povezana sa alociranjem prostora u log-buferu i/ili ispuštanjem redo podataka iz njega u redo grupe.
Ova kašnjenja, naravno, moraju uticati i utiču na propusnost subd po transakcijama. - Parametri
db_block_checksum: pa, opet, to je uglavnom jasno - obrada transakcija dovodi do formiranja dirty blokova u bafer kešu subd.
Koje, prilikom uključene provjere checksum-ova data blokova, baza mora obraditi - izračunati te checksum-ove od tijela data bloka, uporediti ih sa onim što je napisano u headeru data bloka: poklapa se/ ne poklapa se.
Takav rad, opet, ne može a da ne uspori obradu podataka, pa tako i parametar i mehanizam koji taj parametar definiše - ispostavljaju se značajnima.
Stoga, proizvođač predlaže, u dokumentaciji o ovom parametru, različite njegove (parametra) vrijednosti i napominje da - da, uticaj će biti, ali, eto, razne vrijednosti, sve do "isključeno" i različiti uticaj, možete izabrati.
I globalni zaključak.
Pristup, u suštini: ispostavlja se sasvim funkcionalnim.
Omogućava, na ranim fazama opterećujućeg testiranja neke servisne sistema, da se izabere optimalna konfiguracija tog (sistema) pod opterećenje, bez previše uranjanja u specifičnosti podešavanja sistema pod opterećenje.
Vendar to ne izključuje popolnoma — vsaj na ravni razumevanja: "regulacijskih ročic" in dovoljenih območij vrtenja teh ročic je treba sistem poznati.
Nato lahko pristop relativno hitro najde optimalno konfiguracijo sistema.
In na podlagi testiranja lahko pridobite informacije o naravi povezave med merilom kakovosti delovanja sistema in vrednostmi nastavitev sistema.
Kar seveda mora spodbujati to globoko razumevanje sistema, njegovega delovanja, vsaj pod določeno obremenitvijo.
Praktično to pomeni: razmerje stroškov za razumevanje nastavljivega sistema in stroškov za pripravo takega testiranja delovanja sistema.
Posebej bi rad izpostavil: pri tem pristopu je ključna stopnja ustreznosti testiranja sistema glede na pogoje njegovega delovanja, ki jih bo imel v produkcijski uporabi.
Hvala za vašo pozornost, čas.
Izvor: habr.com
