

Z bazo podatkov Apache Cassandra in potrebo po njeni uporabi v okviru infrastrukture na osnovi Kubernetes se redno srečujemo. V tem materialu bomo delili naše poglede na potrebne korake, kriterije in obstoječe rešitve (vključno z pregledom operatorjev) za migracijo Cassandre v K8s.
«Kdo lahko obvlada žensko, se bo spopadel tudi z državo»
Kdo je Cassandra? To je distribuiran sistem shranjevanja, namenjen upravljanju velikih količin podatkov, pri čemer zagotavlja visoko dostopnost brez enotne točke okvare. Projekt verjetno ne potrebuje dolge predstavitve, zato bom navedel le osnovne značilnosti Cassandre, ki bodo relevantne v kontekstu tega članka:
- Cassandra je napisana v Javi.
- Topologija Cassandre vključuje več ravni:
- Node — enkratna instance Cassandre;
- Rack — skupina instance Cassandre, povezana po kakšnem kriteriju, ki se nahaja v enem podatkovnem centru;
- Datacenter — zbirka vseh skupin instance Cassandre, ki se nahajajo v enem podatkovnem centru;
- Cluster — zbirka vseh podatkovnih centrov.
- Za identifikacijo vozlišča Cassandra uporablja IP naslov.
- Za hitrost zapisovanja in branja del podatkov Cassandra hrani v operativni pomnilnik.
Sedaj — k potencialnemu selitvi v Kubernetes.
Check-list za prenos
Ko govorimo o migraciji Cassandre v Kubernetes, upamo, da bo selitev olajšala upravljanje. Kaj bo za to potrebno, kaj bo pri tem pomagalo?
1. Shranjevanje za podatke
Kot je že omenjeno, del podatkov Cassandre hrani v operativni pomnilnik — v Memtable. Toda obstaja tudi druga del podatkov, ki se shranjuje na disk, — v obliki SSTable. Tem podatkom se doda entiteta Commit Log — zapisi o vseh transakcijah, ki se prav tako shranjujejo na disk.
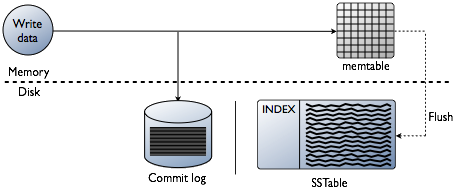
Shema transakcij zapisovanja v Cassandre
V Kubernetesu lahko za shranjevanje podatkov uporabimo PersistentVolume. Zaradi dobro razvitega mehanizma je delo s podatki v Kubernetesu vsako leto lažje.
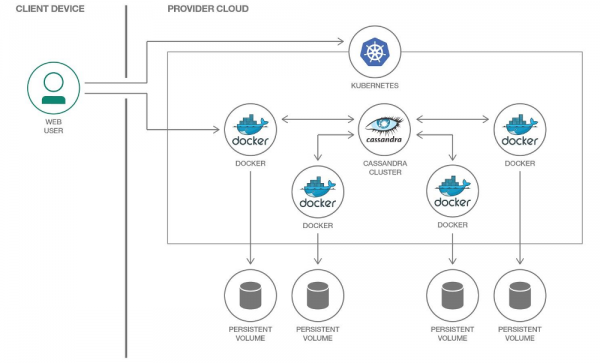
Vsakemu podu z Cassandro bomo dodelili svoj PersistentVolume
Pomembno je omeniti, da Cassandra sama po sebi omogoča replikacijo podatkov in ponuja vgrajene mehanizme za to. Zato, če gradite Cassandra kluster iz velikega števila vozlišč, ni potrebe po uporabi porazdeljenih sistemov za shranjevanje podatkov, kot sta Ceph ali GlusterFS. V tem primeru bi bilo smiselno shraniti podatke na lokalnem disku vozlišča z uporabo ali montaže hostPath.
Druga stvar je, če želite ustvariti ločeno okolje za razvijalce za vsako funkcijsko vejo. V tem primeru bi bil pravilen pristop zagnati eno vozlišče Cassandra in shraniti podatke v porazdeljeno shrambo, torej omenjeni Ceph in GlusterFS bi postali vaša izbira. Tako se bo razvijalec lahko prepričal, da ne bo izgubil testnih podatkov, tudi če izgubi eno od vozlišč Kubernetes klustra.
2. Monitoring
Praktično brezalternativna izbira za implementacijo monitoringa v Kubernetesu je Prometheus (podrobno smo o tem govorili v ). Kako je z eksporterji metrik za Prometheus? In, kar je še pomembneje, s primernimi nadzornimi ploščami za Grafano?
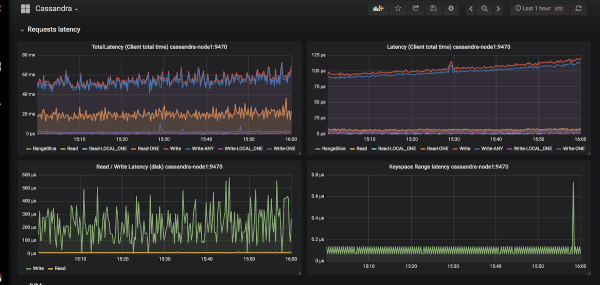
Primer zunanjega videza grafov v Grafani za Cassandre
Eksporterjev je le dva: in .
Izbrali smo prvega, ker:
- JMX Exporter raste in se razvija, medtem ko Cassandra Exporter ni dobila ustrezne podpore skupnosti. Cassandra Exporter še vedno ne podpira večine različic Cassandre.
- Lahko ga zaženete kot javaagent tako, da dodate zastavico
-javaagent:<plugin-dir-name>\/cassandra-exporter.jar=--listen=:9180. - Zanj je , ki ni združljiva s Cassandra Exporter.
3. Izbira Kubernetes primitivov
Glede na zgoraj opisano strukturo klustra Cassandra, poskusimo prevesti vse, kar je tam opisano, v terminologijo Kubernetes:
- Cassandra Node → Pod
- Cassandra Rack → StatefulSet
- Cassandra Datacenter → skupina StatefulSets
- Cassandra Cluster → ???
Izkaže se, da manjkajo nekatere dodatne entitete za upravljanje celotnega klustra Cassandra naenkrat. Toda če česar ni, lahko to ustvarimo! V Kubernetesu je za to namenjen mehanizem za opredelitev lastnih virov — .
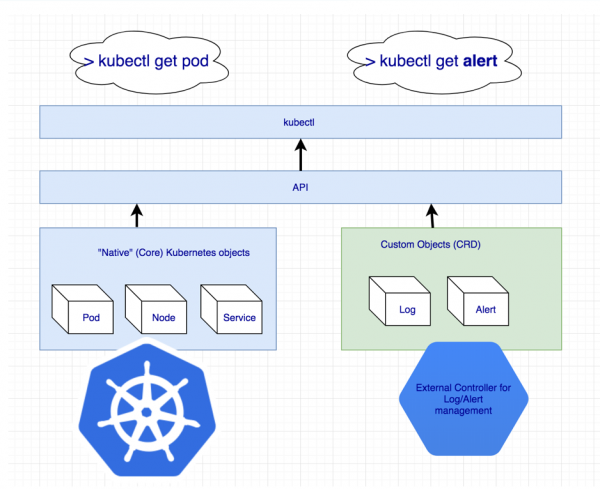
Razglasitev dodatnih virov za dnevniške zapise in obvestila
Toda sam Custom Resource še nič ne pomeni: saj potrebuje kontroler. Morda se bo potrebno zateči k pomoči …
4. Identifikacija podov
V zgornjem odstavku smo se strinjali, da bo ena vozlišče Cassandra enaka enemu podu v Kubernetesu. Vendar pa bodo IP-naslovi podov vsakič različni. Identifikacija vozlišča v Cassandri poteka prav na podlagi IP-naslova... Tako se izkaže, da bo po vsakem brisanju poda klaster Cassandra dodal novo vozlišče.
Izhod obstaja, in celo več kot en:
- Lahko vodimo evidenco po identifikacijskih številkah gostiteljev (UUID, ki nedvoumno identificirajo instance Cassandre) ali po IP-naslovih in vse to shranimo v nekaterih strukturah/tabelah. Ta metoda ima dva glavna pomanjkljivosti:
- Tveganje za nastanek stanja dirke, če padeta dve vozlišči hkrati. Po ponovni vzpostavitvi se bodo vozlišča Cassandra hkrati začela prijavljati za IP-naslov iz tabele in konkurenčno tekmovala za en in isti vir.
- Če je vozlišče Cassandra izgubilo svoje podatke, ga ne bomo mogli več identificirati.
- Druga rešitev se zdi majhen haker, a kljub temu: lahko ustvarimo storitev s ClusterIP za vsako vozlišče Cassandra. Težave pri tej implementaciji:
- Če je v klasterju Cassandra zelo veliko vozlišč, bomo morali ustvariti zelo veliko storitev.
- Možnost ClusterIP je izvedena preko iptables. To lahko postane težava, če je v klasterju Cassandra veliko (1000... ali celo 100?) vozlišč. Čeprav lahko reši to težavo.
- Tretja rešitev je uporaba omrežja vozlišč za vozlišča Cassandra namesto ločenega omrežja podov s pomočjo vključitve nastavitve
hostNetwork: true. Ta metoda nalaga določene omejitve:- Za zamenjavo vozlišč. Novemu vozlišču je treba dodeliti enak IP-naslov kot prejšnjemu (v oblakih kot AWS, GCP je to praktično nemogoče);
- Z uporabo omrežja vozlišč klasterja začnemo tekmovati za omrežne vire. Zato bo težko postaviti več kot en pod Cassandra na eno vozlišče klasterja.
5. Varnostne kopije
Želimo ohranjati polno različico podatkov enega vozlišča Cassandra po razporedu. Kubernetes nudi priročno možnost z uporabo , vendar nam pri tem Cassandra sama postavlja ovire.
Spomnim se, da del podatkov Cassandra hrani v pomnilniku. Da bi naredili popolno varnostno kopijo, moramo podatke iz pomnilnika (Memtables) prenesti na disk (SSTables). V tem trenutku vozlišče Cassandra preneha sprejemati povezave in se popolnoma izključi iz dela klasterja.
Po tem se ustvari varnostna kopija (snapshot) in shrani načrt (keyspace). Tu se razkriva, da preprosto varovanje podatkov ni dovolj: potrebna je shranitev identifikatorjev podatkov, za katere je odgovoren vozliščni sistem Cassandra — to so posebni tokensi.
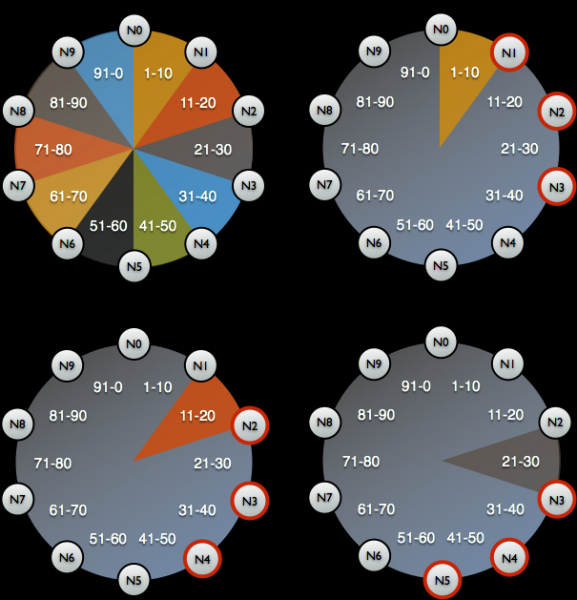
Porazdelitev tokenov za identifikacijo podatkov, za katere so odgovorna vozlišča Cassandra.
Primer skripta za varovanje podatkov iz Cassandre v Kubernetesu je na voljo na . Edina stvar, ki je skript ne upošteva, je ponastavitev podatkov na vozlišču pred ustvarjanjem posnetka. To pomeni, da se varovanje podatkov ne izvaja za trenutno stanje, temveč za stanje nekaj časa prej. Vendar to pomaga, da vozlišče ostane v obratovanju, kar je zelo logično.
set -eu

if [[ -z "$1" ]]; then
  info "Prosimo, navedite ključni prostor"
  exit 1
fi

KEYSPACE="$1"

result=$(nodetool snapshot "${KEYSPACE}")

if [[ $? -ne 0 ]]; then
  echo "Napaka pri ustvarjanju posnetka"
  exit 1
fi

timestamp=$(echo "$result" | awk ' /Snapshot directory: / { print $3 }')

mkdir -p /tmp/backup

for path in $(find "/var/lib/cassandra/data/${KEYSPACE}" -name $timestamp); do
  table=$(echo "${path}" | awk -F "[/-]" '{print $7}')
  mkdir /tmp/backup/$table
  mv $path /tmp/backup/$table
done


tar -zcf /tmp/backup.tar.gz -C /tmp/backup .

nodetool clearsnapshot "${KEYSPACE}"
Primer bash skripta za varovanje podatkov z enega vozlišča Cassandre.
Končne rešitve za Cassandro v Kubernetesu.
Kaj se trenutno uporablja za postavitev Cassandre v Kubernetesu in kaj od tega najbolj ustreza danim zahtevam?
1. Rešitve na osnovi StatefulSet ali Helm grafov.
Uporaba osnovnih funkcij StatefulSets za zagon klasterja Cassandre je dobra izbira. S pomočjo Helm grafa in Go predlog lahko uporabnikom zagotovite prilagodljiv vmesnik za postavitev Cassandre.
Običajno deluje dobro ... dokler ne pride do nenadnih zapletov — na primer, če vozlišče preneha delovati. Standardna orodja Kubernetes preprosto ne morejo obravnavati vseh zgoraj omenjenih lastnosti. Poleg tega je ta pristop zelo omejen glede možnosti širjenja za bolj zapleteno uporabo: zamenjavo vozlišč, varovanje podatkov, obnovo, spremljanje itd.
Predstavniki:
- ;
- .
Oba grafa sta enako dobra, a sta hkrati podvržena zgoraj opisanim težavam.
2. Rešitve na osnovi Kubernetes Operator.
Te možnosti so zanimivejše, ker ponujajo široke možnosti za upravljanje klasterja. Za zasnovo operaterja Cassandre, kot tudi katere koli druge podatkovne baze, je dober vzorec videti kot Sidecar Controller CRD:
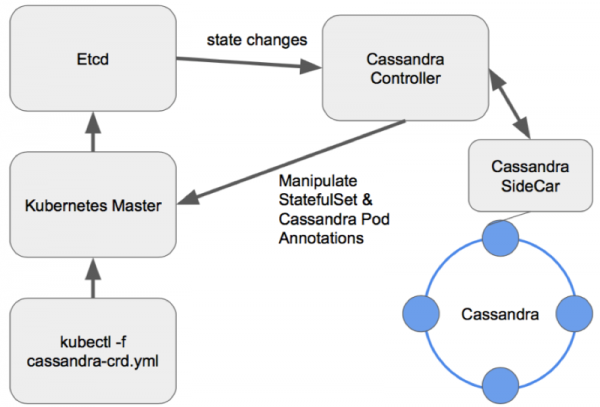
Shema upravljanja vozlišč v pravem operaterju Cassandre.
Poglejmo si obstoječe operaterje.
1. Cassandra-operator od instaclustr
- Pripravljenost: Alpha
- Licenca: Apache 2.0
- Realiziran na: Java
To je res obetaven in aktivno razvijajoč projekt podjetja, ki ponuja upravljane namestitve Cassandra. Kot je omenjeno zgoraj, uporablja sidecar kontejner, ki sprejema ukaze prek HTTP. Napisano je v Javi, zato mu včasih primanjkuje naprednejše funkcionalnosti knjižnice client-go. Operater tudi ne podpira različnih Racks za en datacenter.
Vendar pa operater ponuja prednosti, kot so podpora za spremljanje, nadzor nad upravljanjem klasterja s CRD in celo dokumentacijo za ustvarjanje varnostnih kopij.
2. Navigator od Jetstack
- Pripravljenost: Alpha
- Licenca: Apache 2.0
- Realiziran na: Golang
Operater, namenjen za namestitev DB-as-a-Service. Trenutno podpira dve bazi podatkov: Elasticsearch in Cassandra. Vsebuje zanimive rešitve, kot je nadzor dostopa do baze podatkov prek RBAC (zato se dvigne svoj ločen navigator-apiserver). Zanimiv projekt, ki bi si zaslužil pozornost, vendar je bil zadnji commit narejen pred poldrugim letom, kar jasno zmanjšuje njegov potencial.
3. Cassandra-operator od vgkowski
- Pripravljenost: Alpha
- Licenca: Apache 2.0
- Realiziran na: Golang
Nismo ga obravnavali «resno», saj je zadnji commit v repozitorij bil pred več kot letom dni. Razvoj operaterja je opuščen: zadnja različica Kubernetes, ki je bila navedena kot podprta, je 1.9.
4. Cassandra-operator od Rook
- Pripravljenost: Alpha
- Licenca: Apache 2.0
- Realiziran na: Golang
Operater, katerega razvoj ne poteka tako hitro, kot bi si želeli. Ima dobro zasnovano strukturo CRD za upravljanje klusterja, rešuje problem identifikacije vozlišč s pomočjo storitve s ClusterIP (tisti 'haker')... vendar je to trenutno vse. Še vedno ni podpore za spremljanje in varnostne kopije iz škatle (mimogrede, za spremljanje smo ). Zanimivo je, da s tem operaterjem lahko namestite tudi ScyllaDB.
NB: Ta operater smo z manjšimi prilagoditvami uporabili v enem naših projektov. Težav pri delovanju operaterja v vseh teh mesecih uporabe (~4 mesečnih del) nismo opazili.
5. CassKop od Orange
- Pripravljenost: Alpha
- Licenca: Apache 2.0
- Realiziran na: Golang
Najmlajši operater na seznamu: prvi commit je bil izveden 23. maja 2019. Že zdaj ima v svojem arzenalu veliko funkcij iz našega seznama, s katerimi se lahko bolj podrobno seznanite v repozitoriju projekta. Operater je zgrajen na priljubljenem operator-sdk. Podpira spremljanje "iz škatle". Glavna razlika od drugih operaterjev je uporaba , implementiranega v Pythonu in uporabljenega za komunikacijo med vozlišči Cassandra.
Zaključki
Število pristopov in možnih možnosti za prenos Cassandre v Kubernetes samo govori zase: tema je zelo iskana.
Na tej točki lahko karkoli od zgoraj navedenega poskusite na svoje tveganje: noben od razvijalcev ne jamči za 100-odstotno delovanje njihove rešitve v produkcijskem okolju. A že zdaj veliko produktov izgleda obetavno, da bi jih poskusili uporabiti v razvojnem okolju.
Mislim, da bo ta ženska na ladji v prihodnosti prišla prav!
P.S.
Preberite tudi na našem blogu:
- «»;
- «»;
- «»;
- «».
Izvor: habr.com
