

Pozdravljeni vsi! Sem razvijalec CV v KROK. Že tri leta izvajamo projekte na področju CV. V tem času smo počeli marsikaj, na primer: spremljali voznike, da med vožnjo ne bi pili, kadili, govorili po telefonu, gledali na cesto in ne v sanje ali oblake; opažali navdušence, ki vozijo po posebnih pasovih in zasedajo več parkirnih mest; pazili, da zaposleni nosijo čelade, rokavice itd.; identificirali zaposlenega, ki želi vstopiti na objekt; šteli vse, kar je mogoče.
Zakaj vse to govorim?
Med izvajanjem projektov smo naleteli na številne težave, mnoge od njih boste ali že poznali, ali se nanje srečali v prihodnosti.
Modeliramo situacijo
Predstavljajte si, da smo zaposleni v mladem podjetju “N”, katerih dejavnost je povezana z ML. Delamo na projektu ML (DL, CV), nato se iz kakršnega koli razloga preusmerimo na drugo delo, v bistvu si vzamemo premor, in se vrnemo k svoji ali tuji nevronski mreži.
- Nastopi trenutek resnice, treba se je nekako spomniti, kje smo ostali, katere hiperparametre smo preizkusili in, kar je najpomembneje, kakšni so bili rezultati. Obstaja lahko še veliko načinov, kako so ljudje hranili informacije o vseh zagonih: v glavi, v konfiguracijah, v zvezku, v delovnem okolju v oblaku. Videli smo primer, kjer so bili hiperparametri shranjeni kot zakomentirane vrstice v kodi, torej letanje domišljije. In zdaj si predstavljajte, da se niste vrnili k svojemu projektu, ampak k projektu osebe, ki je zapustila podjetje, in v dediščino so vam ostali koda in model z imenom model_1.pb. Za popolno sliko in prenašanje vseh bolečin si predstavljajte, da ste tudi začetni strokovnjak.
- Gremo naprej. Za zagon kode moramo mi in vsi, ki bodo delali z njo, ustvariti okolje. Pogosto se zgodi, da nam tega iz kakršnega koli razloga prav tako niso zapustili. To je lahko tudi zahtevna naloga. Na ta korak se ne želimo preveč obremenjevati, mar ne?
- Treniramo model (na primer, detektor avtomobilov). Prispemo do trenutka, ko postane precej dober — čas je, da shranimo rezultat. Poimenujmo ga car_detection_v1.pb. Nato treniramo še enega — car_detection_v2.pb. Čez čas naši kolegi ali mi sami usposabljamo še in še, z uporabo različnih arhitektur. Na koncu nastane kup artefaktov, katerih informacije je treba skrbno zbirati (a to bomo naredili kasneje, saj imamo trenutno pomembnejše naloge).
- In to je to! Imamo model! Lahko začnemo usposabljanje naslednjega modela, razvijamo arhitekturo za rešitev nove naloge ali pa gremo na čaj? Kdo bo izvedel deployment?
Identifikacija težav
Delo na projektu ali produktu je trud mnogih ljudi. Sčasoma ljudje odhajajo in prihajajo, projektov pa postaja vedno več, sami projekti pa postajajo kompleksnejši. Tako ali drugače se situacije iz zgoraj opisanega cikla (in ne samo) v različnih kombinacijah pojavljajo iz iteracije v iteracijo. Vse to vodi v izgubo časa, zmedo, živčnost, morda nezadovoljstvo naročnika in na koncu — v izgubljen denar. Čeprav se običajno spopadamo s starimi težavami, mislim, da si nihče ne želi znova in znova doživeti teh trenutkov.
Torej, prešli smo skozi en razvojni cikel in vidimo, da so težave, ki jih je treba rešiti. Za to potrebujemo:
- udobno shranjevanje rezultatov dela;
- poenostavitev postopka vključitve novih zaposlenih;
- poenostavitev procesa uvajanja razvojnega okolja;
- nastavitev postopka verzioniranja modelov;
- imeti enostaven način za validacijo modelov;
- najti orodje za upravljanje stanja modelov;
- najti način za dostavo modelov v produkcijo.
Očitno je potrebno izumiti delovni proces, ki bi omogočal enostavno in učinkovito upravljanje tega življenjskega cikla? Takšna praksa ima ime MLOps.
MLOps, ali DevOps za strojno učenje, omogoča ekipam strokovnjakov za obdelavo in analizo podatkov in IT-strokovnjakov sodelovanje ter povečuje hitrost razvoja in uvajanja modelov s pomočjo nadzora, preverjanja in sistema upravljanja za modele strojnega učenja.
Lahko , kaj o vsem tem menijo fantje iz Google. Iz članka je jasno, da je MLOps dokaj obsežen področje.
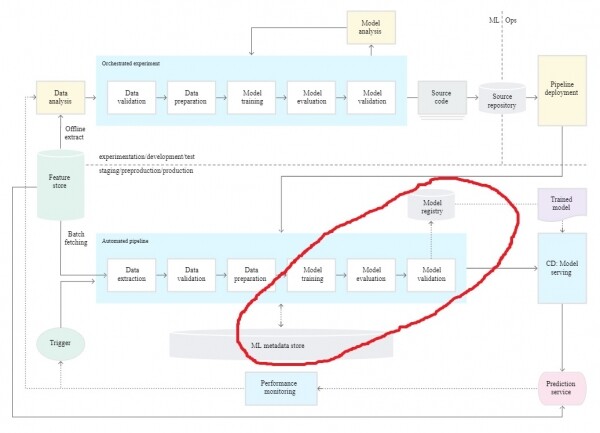
V nadaljevanju svojega članka bom opisal le del procesa. Za izvedbo bom uporabil orodje MLflow, saj gre za projekt z odprtim izvorom, za povezovanje pa je potrebnih le nekaj vrstic kode, poleg tega pa nudi integracijo s priljubljenimi ML okviri. Na spletu lahko poiščete tudi druga orodja, kot so Kubeflow, SageMaker, Trains itd., in morda najdete tisto, ki najbolje ustreza vašim potrebam.
"Gradimo" MLOps na primeru uporabe orodja MLFlow
MLFlow je platforma z odprtim izvorom za upravljanje življenjskega cikla ML modelov ().
MLflow vključuje štiri komponente:
- MLflow Tracking - pokriva vprašanja o beleženju rezultatov in parametrov, ki so pripeljali do teh rezultatov;
- MLflow Project - omogoča pakiranje kode in njeno ponavljanje na katerikoli platformi;
- MLflow Models - odgovarja za implementacijo modelov v produkcijo;
- MLflow Registry - omogoča shranjevanje modelov in upravljanje z njihovim stanjem v centralizirani shrambi.
MLflow upravlja z dvema entitetama:
- zagon - to je celoten cikel usposabljanja, parametri in metrike, ki jih želimo beležiti;
- eksperiment - to je "tema", s katero so povezani zagoni.
Vsi koraki primera so izvedeni na operacijskem sistemu Ubuntu 18.04.
1. Postavimo strežnik
Da bomo lahko enostavno upravljali s svojim projektom in pridobili vse potrebne informacije, bomo postavili strežnik. MLflow sledilni strežnik ima dve osnovni komponenti:
- backend store - odgovarja za shranjevanje informacij o registriranih modelih (podpira 4 DBMS: mysql, mssql, sqlite in postgresql);
- artifact store - odgovarja za shranjevanje artefaktov (podpira 7 možnosti shranjevanja: Amazon S3, Azure Blob Storage, Google Cloud Storage, FTP strežnik, SFTP strežnik, NFS, HDFS).
Kot artifact store za enostavnost vzamemo sftp strežnik.
- ustvarimo skupino
$ sudo groupadd sftpg - dodamo uporabnika in nastavimo geslo
$ sudo useradd -g sftpg mlflowsftp $ sudo passwd mlflowsftp - prilagodimo nekaj nastavitev dostopa
$ sudo mkdir -p /data/mlflowsftp/upload $ sudo chown -R root.sftpg /data/mlflowsftp $ sudo chown -R mlflowsftp.sftpg /data/mlflowsftp/upload - dodamo nekaj vrstic v /etc/ssh/sshd_config
Match Group sftpg ChrootDirectory /data/%u ForceCommand internal-sftp - ponovno zaženemo storitev
$ sudo systemctl restart sshd
Kot backend store vzeli bomo postgresql.
$ sudo apt update
$ sudo apt-get install -y postgresql postgresql-contrib postgresql-server-dev-all
$ sudo apt install gcc
$ pip install psycopg2
$ sudo -u postgres -i
# Создаем нового пользователя: mlflow_user
[postgres@user_name~]$ createuser --interactive -P
Введите имя роли, которую нужно добавить: mlflow_user
Введите пароль для новой роли: mlflow
Введите его снова: mlflow
Будет ли новая роль суперпользователем? (y/n) n
Будет ли новой роли разрешено создавать базы данных? (y/n) n
Будет ли новой роли разрешено создавать новые роли? (y/n) n
# Создаем базу данных mlflow_bd с владельцем mlflow_user
$ createdb -O mlflow_user mlflow_db
Для запуска сервера необходимо установить следующие пакеты Python (рекомендуется создать отдельное виртуальное окружение):
pip install mlflow
pip install pysftp
Запускаем наш сервер
$ mlflow server
                 --backend-store-uri postgresql://mlflow_user:mlflow@localhost/mlflow_db
                 --default-artifact-root sftp://mlflowsftp:mlflow@sftp_host/upload
                --host server_host
                --port server_port
2. Добавляем трекинг
Чтобы результаты наших тренировок не пропали, будущие поколения разработчиков могли понять, что вообще происходило, а старшие товарищи и вы могли спокойно анализировать процесс обучения, необходимо добавить трекинг. Под трекингом подразумевается сохранение параметров, метрик, артефактов и дополнительной информации о запуске обучения, в нашем случае, на сервере.
Для примера я создал небольшой на Keras по сегментации всего, что есть в . Для добавления трекинга я создал файл mlflow_training.py.
Вот строки, в которых происходит самое интересное:
def run(self, epochs, lr, experiment_name):
        # получение id эксперимента, создание эксперимента в его отсутствие
        remote_experiment_id = self.remote_server.get_experiment_id(name=experiment_name)
        # создание "запуска" и получение его id
        remote_run_id = self.remote_server.get_run_id(remote_experiment_id)

        # указываем, что хотим сохранить результаты на удаленном сервере
        mlflow.set_tracking_uri(self.tracking_uri)
        mlflow.set_experiment(experiment_name)

        with mlflow.start_run(run_id=remote_run_id, nested=False):
            mlflow.keras.autolog()
            self.train_pipeline.train(lr=lr, epochs=epochs)

        try:
            self.log_tags_and_params(remote_run_id)
        except mlflow.exceptions.RestException as e:
            print(e)
Tukaj self.remote_server predstavlja majhno ovijanje nad metodami mlflow.tracking. MlflowClient (s strani zamejnega udobja), s katerimi ustvarjam eksperiment in zagon na strežniku. Nato določim, kam naj se zabeleži rezultat zagona (mlflow.set_tracking_uri(self.tracking_uri)). Povežem samodejno beleženje mlflow.keras.autolog(). Do sedaj MLflow Tracking podpira samodejno beleženje za TensorFlow, Keras, Gluon XGBoost, LightGBM, Spark. Če svojega ogrodja ali knjižnice niste našli, lahko vedno beležite ročno. Začnemo z izobraževanjem. Zabeležimo oznake in vhodne parametre na oddaljenem strežniku.
Le nekaj vrstic in že imate dostop do informacij o vseh zagonih. Super, kajne?
3. Uredimo projekt
Sedaj bomo uredili, da bo zagon projekta enostaven. Zato bomo dodali datoteko MLproject in conda.yaml v koren projekta.
MLproject
name: flow_segmentation
conda_env: conda.yaml

entry_points:
  main:
    parameters:
        categories: {help: 'seznam kategorij iz coco podatkovnega sklada'}
        epochs: {type: int, help: 'število epoh pri učenju'}

        lr: {type: float, default: 0.001, help: 'učna stopnja'}
        batch_size: {type: int, default: 8}
        model_name: {type: str, default: 'Unet', help: 'Unet, PSPNet, Linknet, FPN'}
        backbone_name: {type: str, default: 'resnet18', help: 'primer resnet18, resnet50, mobilenetv2 ...'}

        tracking_uri: {type: str, help: 'naslov strežnika'}
        experiment_name: {type: str, default: 'My_experiment', help: 'ime eksperimenta na daljavo in lokalno'}
    command: "python mlflow_training.py
            --epochs={epochs}
            --categories={categories}
            --lr={lr}
            --tracking_uri={tracking_uri}
            --model_name={model_name}
            --backbone_name={backbone_name}
            --batch_size={batch_size}
            --experiment_name={experiment_name}"
MLflow Projekt ima več lastnosti:
- Name — ime vašega projekta;
- Environment — v mojem primeru conda_env označuje, da se za zagon uporablja Anaconda in opis odvisnosti se nahaja v datoteki conda.yaml;
- Entry Points — označuje, katere datoteke in s katerimi parametri lahko zagnemo (vsi parametri pri zagonu učenja se samodejno beležijo)
conda.yaml
name: flow_segmentation
channels:
  - defaults
  - anaconda
dependencies:
  - python==3.7
  - pip:
    - mlflow==1.8.0
    - pysftp==0.2.9
    - Cython==0.29.19
    - numpy==1.18.4
    - pycocotools==2.0.0
    - requests==2.23.0
    - matplotlib==3.2.1
    - segmentation-models==1.0.1
    - Keras==2.3.1
    - imgaug==0.4.0
    - tqdm==4.46.0
    - tensorflow-gpu==1.14.0
Kot okolje za izvajanje lahko uporabite docker, za bolj podrobne informacije se obrnite na .
4. Začnemo z izobraževanjem
Kloniramo projekt in preidemo v imenik projekta:
git clone https://github.com/simbakot/mlflow_example.git
cd mlflow_example/
Za zagon je potrebno namestiti knjižnice
pip install mlflow
pip install pysftp
Ker sem v tem primeru uporabil conda_env, mora biti na vašem računalniku nameščen Anaconda (to pa se lahko obide z namestitvijo vseh potrebnih paketov in igro s parametri za zagon).
Vsi pripravljalni koraki so zaključeni in lahko začnemo z zagonanjem usposabljanja. Iz korena projekta:
$ mlflow run -P epochs=10 -P categories=cat,dog -P tracking_uri=http://server_host:server_port .Po vnosu ukaza se bo samodejno ustvarilo conda okolje in začelo usposabljanje.
V zgornjem primeru sem navedel število epoch za usposabljanje, kategorije, na katere želimo segmentirati (celoten seznam si lahko ogledate ) in naslov našega oddaljenega strežnika.
Celoten seznam možnih parametrov si lahko ogledate v datoteki MLproject.
5. Ocenjujemo rezultate usposabljanja
Ko se usposabljanje konča, lahko v brskalniku obiščemo naslov našega strežnika
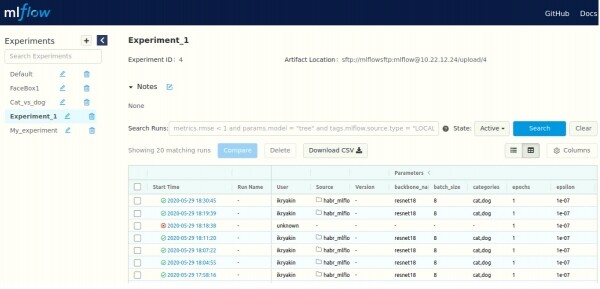
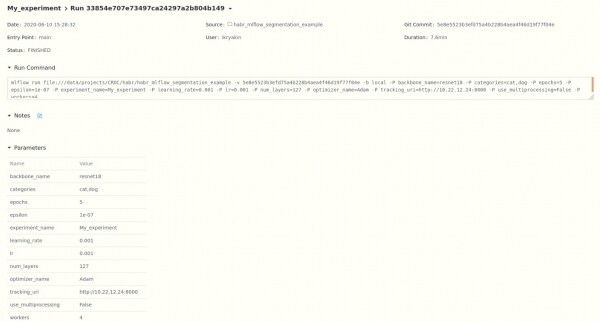
Tukaj vidimo seznam vseh eksperimentov (zgoraj levo), pa tudi informacije o zagonih (na sredini). Lahko si ogledamo podrobnejše informacije (parametre, metrike, artefakte in druge informacije) za vsak zagon.
Za vsak metric lahko spremljamo zgodovino sprememb.
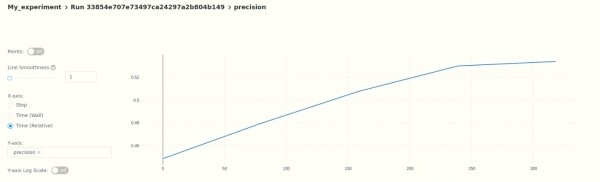
To pomeni, da trenutno lahko analiziramo rezultate v "ročnem" načinu, poleg tega pa lahko nastavite tudi samodejno validacijo z uporabo MLflow API.
6. Registriramo model
Ko smo analizirali naš model in se odločili, da je pripravljen za uporabo, se lotimo njegove registracije; za to izberemo ustrezen zagon (kot je prikazano v prejšnjem koraku) in gremo navzdol.
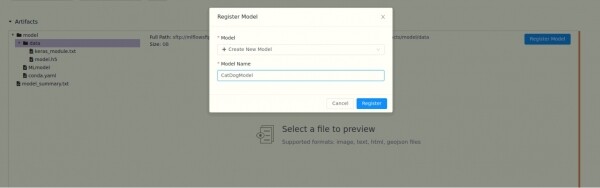
Ko smo našemu modelu dali ime, dobi različico. Ob shranjevanju drugega modela s tem istim imenom se bo različica samodejno povečala.
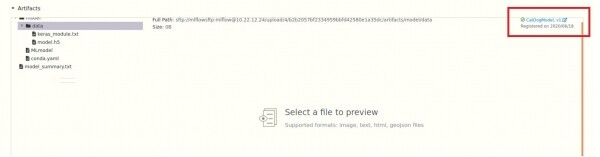
Za vsak model lahko dodamo opis in izberemo eno od treh stanj (Staging, Production, Archived), kasneje lahko z uporabo API-ja dostopamo do teh stanj, kar skupaj z različicami daje dodatno prilagodljivost.
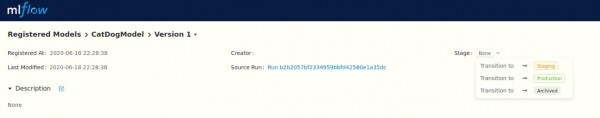
Imamo tudi priročen dostop do vseh modelov
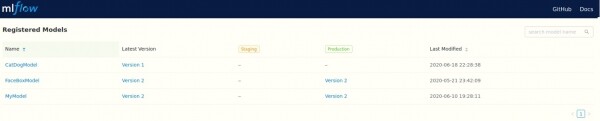
in njihovih različic.
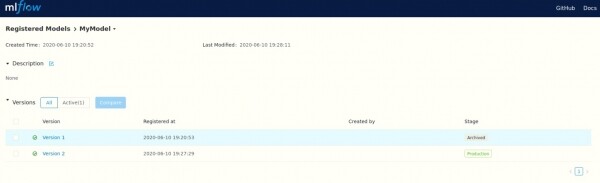
Kot v prejšnjem koraku lahko vse operacije izvedemo tudi z uporabo API.
7. Implementiramo model
V tej fazi že imamo usposobljen (keras) model. Tukaj je primer, kako ga lahko uporabimo:
class SegmentationModel:
    def __init__(self, tracking_uri, model_name):

        self.registry = RemoteRegistry(tracking_uri=tracking_uri)
        self.model_name = model_name
        self.model = self.build_model(model_name)

    def get_latest_model(self, model_name):
        registered_models = self.registry.get_registered_model(model_name)
        last_model = self.registry.get_last_model(registered_models)
        local_path = self.registry.download_artifact(last_model.run_id, 'model', './')
        return local_path

    def build_model(self, model_name):
        local_path = self.get_latest_model(model_name)

        return mlflow.keras.load_model(local_path)

    def predict(self, image):
        image = self.preprocess(image)
        result = self.model.predict(image)
        return self.postprocess(result)

    def preprocess(self, image):
        image = cv2.resize(image, (256, 256))
        image = image / 255.
        image = np.expand_dims(image, 0)
        return image

    def postprocess(self, result):
        return result
Tukaj je self.registry spet majhna ovira nad mlflow.tracking.MlflowClient zaradi udobnosti. Gre za to, da se obračam na oddani strežnik in iščem model z danim imenom, pri čemer najdem najnovejšo produkcijsko različico. Nato prenesem artefakt lokalno v mapo './model' in zgradim model iz te direktorije mlflow.keras.load_model(local_path). Sedaj lahko uporabimo naš model. Razvijalci CV (ML) se lahko brez skrbi ukvarjajo z izboljšanjem modela in objavljanjem novih različic.
Na záver
Predstavil sem sistem, ki omogoča:
- centralizirano shranjevanje informacij o ML modelih, poteku in rezultatih učenja;
- hitro postavljanje razvojnega okolja;
- slediti in analizirati napredovanje dela na modelih;
- enostavno verzioniranje in upravljanje stanja modelov;
- enostavno uvajanje pridobljenih modelov.
Ta primer je igrača in služi kot izhodišče za gradnjo vašega lastnega sistema, ki morda vključuje avtomatizacijo ocene rezultatov in registracijo modelov (točka 5 in točka 6) ali pa boste dodali verzioniranje podatkovnih nizov, ali morda še algo drugo? Poskušal sem poudariti, da potrebujete MLOps na splošno, MLflow je le sredstvo za dosego cilja.
Napišite, s katerimi težavami ste se srečevali, o katerih nisem govoril?
Kaj bi dodali v sistem, da bi pokrival vaše potrebe?
Katere orodja in pristopi uporabljate, da bi rešili vse ali del težav?
P.S. Pustil bom nekaj povezav:
github projekt —
MLflow —
Moja delovna e-pošta za vprašanja — ikryakin@croc.ru
V naši podjetju občasno organiziramo različne dogodke za IT strokovnjake, na primer: 8. julija ob 19:00 po MSK bo potekal online meetup o CV, če vas zanima, se lahko prijavite. .
Izvor: habr.com
