

Uvod
Nekaj časa nazaj sem bil postavljen pred nalogo, da razvijem odpornost klastera za , ki deluje v več podatkovnih centrih, povezanih s kabelskim sistemom v okviru enega mesta, in sposoben prenesti okvaro (na primer, izpad električne energije) enega podatkovnega centra. Kot programsko opremo, ki odgovarja za odpornost, sem izbral , ker gre za uradno rešitev podjetja RedHat za ustvarjanje odpornosti klasterjev. Odlikuje ga dobra podpora podjetja RedHat in to, da je rešitev univerzalna (modularna). S tem se lahko zagotovi odpornost ne samo PostgreSQL, temveč tudi drugih storitev, bodisi z uporabo standardnih modulov bodisi z ustvarjanjem le-teh za specifične potrebe.
Na to rešitev se je postavilo upravičeno vprašanje: kako odporen bo odpornosti klaster? Da bi to raziskal, sem razvil testno okolje, ki simulira različne okvare na vozliščih klasterja, pričakuje obnovitev funkcionalnosti, obnavlja okvarjeno vozlišče in nadaljuje testiranje v ciklu. Sprva se je ta projekt imenoval hapgsql, vendar me je sčasoma ime, ki ima le eno samoglasnik, začelo dolgočasiti. Zato sem odpornim podatkovnim bazam (in plavajočemu IP, ki jih označuje) začel reči krogan (značka iz računalniške igre, pri kateri so vsi pomembni organi podvojeni), vozlišča, klasterji in sam projekt pa tuchanka (planet, kjer živijo krogan).
Sedaj je vodstvo dovolilo . README bo kmalu preveden v angleščino (ker se pričakuje, da bodo glavni uporabniki razvijalci Pacemaker in PostgreSQL), prav tako pa sem stari ruski različico README odločil predstaviti (delno) v obliki tega članka.
Klasterji se postavljajo na virtualke . Skupaj bo postavljenih 12 virtualk (skupaj 36GiB), ki bodo oblikovale 4 odpornosti klastre (različne možnosti). Prva dva klasterja sta sestavljena iz dveh strežnikov PostgreSQL, ki sta nameščena v različnih podatkovnih centrih, ter skupnega strežnika witness c quorum device (nameščenega na poceni virtualki v tretjem podatkovnem centru), ki razrešuje negotovost 50%/50%, tako da da svoj glas eni od strani. Tretji klaster deluje v treh podatkovnih centrih: en glavni, dva pomočnika, brez quorum device. Četrti klaster se sastoji od četiri PostgreSQL servera, po dva u svakom data centru: jedan master, ostali replikas, i takođe koristi witness c quorum device. Četvrti podnosi otkazivanje dva servera ili jednog data centra. Ovo rešenje može biti, ako je potrebno, prošireno na veći broj replikas.
Servis tačnog vremena takođe je rekonfiguran za otpornost na otkazivanja, ali tamo se koristi metoda ntpd (orphan mode). Glavni server witness ima ulogu centralnog NTP servera, deljajući svoje vreme svim klasterima, na taj način sinhronizujući sve servere međusobno. Ako witness dođe do kvara ili bude izolovan, tada svoje vreme počinje deliti jedan od servera klastera (unutar klastera). Pomoćni keširajući HTTP proxy takođe je podignut na witness, uz njegovu pomoć ostale virtuelne mašine imaju pristup Yum repozitorijumima. U stvarnosti, takvi servisi kao što su tačno vreme i proxy, zasigurno će biti smešteni na dediciranim serverima, dok su u ovom testu smešteni na witness samo radi ekonomije broja virtuelnih mašina i prostora.
Različice
v0. Radi sa CentOS 7 i PostgreSQL 11 na VirtualBox 6.1.
Struktura klastera
Svi klasteri su namenjeni za smeštaj u više data centara, povezani su u jednu ravnu mrežu i moraju izdržati otkazivanje ili mrežnu izolaciju jednog data centra. Zato ni mogoče koristiti za zaštitu od split-brain standardnu tehnologiju Pacemaker, koja se naziva STONITH (Shoot The Other Node In The Head) ili fencing. Njena suština: ako čvorovi u klasteru počnu da sumnjaju da se s nekim čvorom dešava nešto sumnjivo, on ne odgovara ili se ponaša neispravno, tada ga prisilno isključuju preko „spoljnih“ uređaja, kao što su upravljačka kartica IPMI ili UPS. Ali to će funkcionisati samo u slučajevima kada pri jednostavnom otkazu servera IPMI ili UPS nastave da rade. Ovde se planira zaštita od mnogo katastrofalnijeg otkaza, kada otkazuje (na primer, nestaje struje) čitav data centar. A pri takvom otkazu svi stonith-uređaji (IPMI, UPS itd.) takođe neće raditi.
Umesto toga, na osnovu sistema je ideja kvoruma. Svi čvorovi imaju glas, i mogu raditi samo oni koji vide više od polovine svih čvorova. Ova količina „polovina+1“ naziva se kvorum. Ako se kvorum ne dostigne, čvor zaključuje da je u mrežnoj izolaciji i mora isključiti svoje resurse, tj. ovo je neka vrsta zaštite od split-brain. Če programska oprema, ki je odgovorna za takšno obnašanje, ne deluje, mora delovati watchdog, na primer na osnovi IPMI.
Če je število vozlišč sodo (klaster v dveh podatkovnih centrih), lahko nastane tako imenovana negotovost. 50%/50% (fifty-fifty), ko omrežna izolacija razdeli klaster natanko na pol. Zato se za sodo število vozlišč doda quorum device — nezahteven demon, ki ga je mogoče zagnati na najcenejši virtualki v tretjem podatkovnem centru. Dodeli svoj glas enemu od segmentov (ki ga vidi) in tako razreši negotovost 50%/50%. Strežnik, na katerem bo zagnana naprava quorum, sem poimenoval witness (terminologija iz repmgr, ki mi je bila všeč).
Viri se lahko premikajo sem in tja, na primer s pokvarjenih strežnikov na delujoče, ali na ukaz sistemskih administratorjev. Da bi stranke vedele, kje se nahajajo potrebni viri (kam se povezati?), se uporabljajo plavajoči IP (float IP). To so IP naslovi, ki jih Pacemaker lahko premika med vozlišči (vsa se nahajajo v ravni mreži). Vsak izmed njih simbolizira vir (storitev) in bo tam, kamor se je treba povezati, da dobimo dostop do te storitve (v našem primeru DB).
Tuchanka1 (shema z zgostitvijo)
Struktura
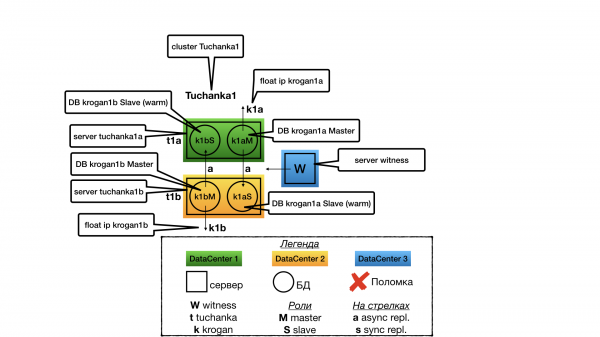
Ideja je bila, da imamo veliko majhnih podatkovnih baz z nizko obremenitvijo, za katere je nesmotrno vzdrževati namenski strežnik slave v načinu hot standby za transakcije samo za branje (ni potrebe po takem zapravljanju virov).
V vsakem podatkovnem centru je en strežnik. Na vsakem strežniku sta dva instanca PostgreSQL (v terminologiji PostgreSQL se imenujejo klasterji, vendar jih bom za boljšo razumljivost imenoval instanca, medtem ko bom klasterje imenoval le klasterji Pacemaker). Ena instanca deluje v načinu master in samo ta nudi storitve (le nanjo se navezuje float IP). Druga instanca deluje kot slave za drugi podatkovni center in bo nudila storitve le, če njen master odpove. Ker bo večino časa nudila storitve (izvajala poizvedbe) le ena instanca od dveh (master), bodo vsi viri strežnika optimizirani za master (dodeljena bo pomnilnik za predpomnilnik shared_buffers itd.), vendar tako, da bo tudi drugi instanci dovolj virov (čeprav za suboptimalno delovanje prek predpomnilnika datotečnega sistema) za primer odpovedi enega izmed podatkovnih centrov. Slave ne nudi storitev (ne izvaja read only poizvedb) med normalnim delovanjem klasterja, da ne bi prihajalo do konkurence za vire z masterjem na istem strežniku.
V primeru dveh vozlišč je odpornost na napake možna samo pri asinhroni replikaciji, saj bi pri sinhroni replikaciji odpoved slava povzročila ustavitev masterja.
Odpoved witness
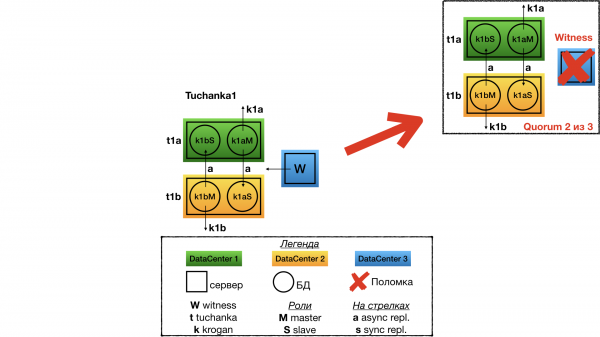
Odpoved witness (quorum device) bom obravnaval le za klaster Tuchanka1, ostali bodo imeli enako zgodbo. Pri odpovedi witness se v strukturi klasterja nič ne spremeni, vse bo še naprej delovalo tako, kot je delovalo. Vendar bo kvorum postal 2 od 3, zato bo vsaka nadaljnja odpoved usodna za klaster. Kljub temu ga bo treba nujno popraviti.
Odpoved Tuchanka1
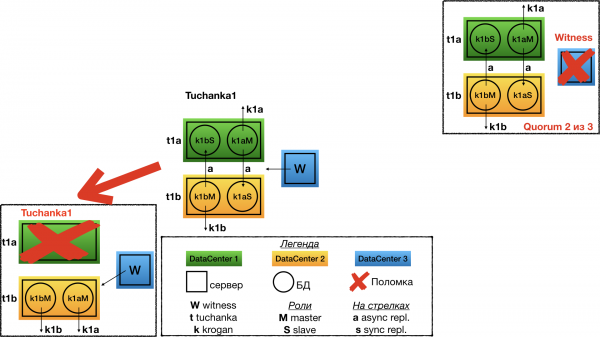
Odpoved enega izmed podatkovnih centrov za Tuchanka1. V tem primeru witness da svoj glas prenese drugemu vozlišču v drugem podatkovnem centru. Tam nekdanji slave postane master, tako da na enem strežniku delujeta oba masterja in nanju se usmerjata oba njihova float IP.
Tuchanka2 (klasična)
Struktura
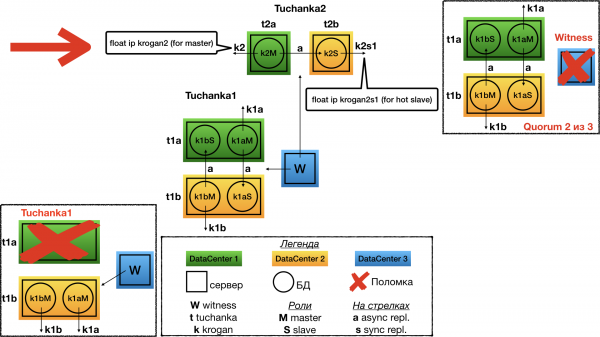
Klasična shema iz dveh vozlišč. Na enem deluje master, na drugem slave. Oba lahko izvajata poizvedbe (slave le read only), zato se oba usmerjata na float IP: krogan2 — na master, krogan2s1 — na slave. Odpornost na napake bo prisotna tako pri masterju kot pri slave.
V primeru dveh vozlišč je odpornost na napake možna le pri asinhroni replikaciji, ker bi pri sinhroni odpoved slava povzročila ustavitev masterja.
Odpoved Tuchanka2
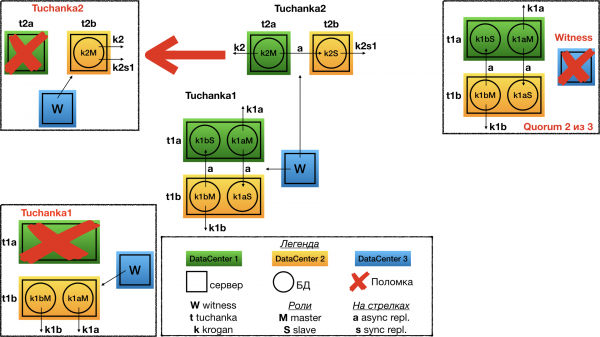
Pri odpovedi enega izmed podatkovnih centrov witness glasuje za drugo. Na jedinom funkcionalnom data centru biće podignut master, a na njega će ukazivati oba float IP: masterski i robovski. Naravno, instanca mora biti podešena na način da ima dovoljno resursa (limite za vezu itd.) da istovremeno prihvati sve konekcije i zahteve od masterskog i robovskog float IP. To jest, u normalnom radu, mora imati dovoljno slobodnog prostora po limitima.
Tuchanka4 (mnogo robova)
Struktura
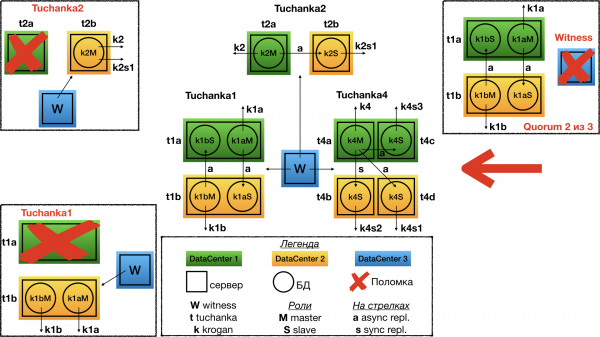
Već je druga krajnost. Postoje baze podataka na koje dolazi veoma mnogo read-only zahteva (tipičan slučaj visoko opterećene web stranice). Tuchanka4 je situacija u kojoj može biti tri ili više robova za obradu takvih zahteva, ali ne previše. U slučaju veoma velikog broja robova, biće potrebno osmisliti hijerarhijski sistem replikacije. U minimalnom slučaju (na slici), u svakom od dva data centra nalaze se po dva servera, na svakom od kojih se nalazi po instanca PostgreSQL.
Još jedna karakteristika ovog režima je ta što se ovde već može organizovati jedna sinhrona replikacija. Ona je podešena tako da replikacija ide, koliko je to moguće, u drugi data centar, a ne na replikaciju u istom data centru gde je i master. Na master i na svakog robovskog ukazuje float IP. Po dobrom, između robova bi trebalo da se uradi balansiranje zahteva nekim sql proxy, na primer, na strani klijenta. Različitim tipovima klijenata može biti potrebna različita vrsta sql proxy, i samo developeri klijenata znaju ko kojoj vrsti treba. Ova funkcionalnost može biti realizovana kao spoljašnji demon, tako i kao klijent biblioteka (connection pool), itd. Sve ovo izlazi iz okvira teme otpornog DB klastera (otpornost SQL proxy može se realizovati nezavisno, zajedno sa otpornosti klijenta).
Neuspeh Tuchanka4
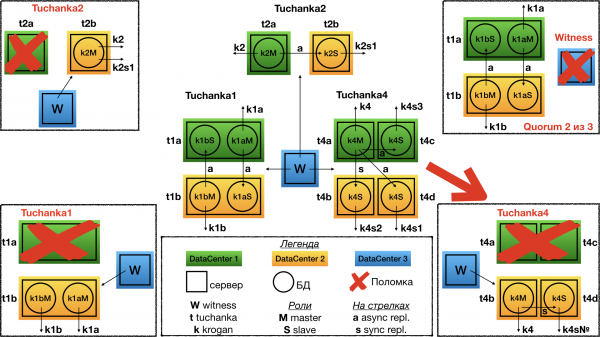
U slučaju neuspeha jednog data centra (tj. dva servera), witness glasuje za drugi. Kao rezultat, u drugom data centru rade dva servera: na jednom radi master, i na njega ukazuje masterski float IP (za primanje read-write zahteva); a na drugom serveru radi rob sa sinhronom replikacijom, i na njega ukazuje jedan od robovskih float IP (za read only zahteve).
Prvo što treba napomenuti: radni robovski float IP neće biti svi, već samo jedan. I za pravilno funkcionisanje sa njim, biće potrebno da sql proxy преносила все запросы на единственный оставшийся float IP; а если sql proxy нет, можно перечислить все float IP рабов через запятую в URL для подключения. В таком случае с libpq подключение будет к первому рабочему IP, так сделано в системе автоматического тестирования. Возможно, в других библиотеках, например, JDBC, это не сработает, и потребуется sql proxy. Это сделано потому, что у float IP для рабов установлен запрет на одновременное поднятие на одном сервере, чтобы они равномерно распределялись по рабским серверам, если их несколько.
Второе: даже в случае отказа дата-центра будет сохраняться синхронная репликация. И даже если произойдет повторный отказ, то есть в оставшемся дата-центре выйдет из строя один из двух серверов, кластер хоть и перестанет оказывать услуги, но всё же сохранит информацию обо всех закоммиченных транзакциях, на которые он дал подтверждение о коммите (не будет потери информации при повторном отказе).
Tuchanka3 (3 дата-центра)
Struktura
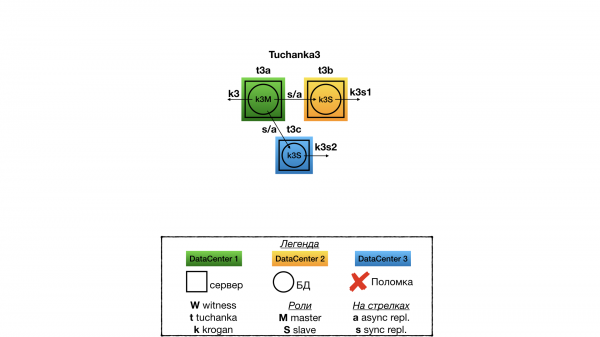
Это кластер для ситуации, когда есть три полноценно работающих дата-центра, в каждом из которых есть полноценно работающий сервер БД. В этом случае quorum device не нужен. В одном дата-центре работает мастер, в двух других — рабы. Репликация синхронная, типа ANY (slave1, slave2), то есть клиенту будет приходить подтверждение коммита, когда любой из рабов первым ответит, что он принял коммит. На ресурсы указывает один float IP для мастера и два для рабов. В отличие от Tuchanka4 все три float IP отказоустойчивы. Для балансировки read-only SQL-запросов можно использовать sql proxy (с отдельной отказоустойчивостью), либо половине клиентов назначить один рабский float IP, а другой половине — второй.
Отказ Tuchanka3
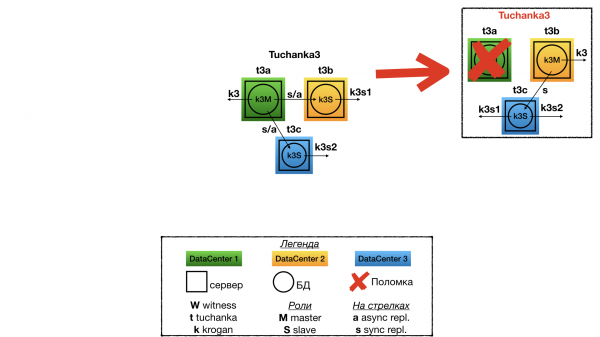
При отказе одного из дата-центров остаются два. В одном поднят мастер и float IP от мастера, во втором — раб и оба рабских float IP (на инстансе должен быть двукратный запас по ресурсам, чтобы принять все подключения с обоих рабских float IP). Между мастером и рабом синхронная репликация. Также кластер сохранит информацию о закоммиченных и подтвержденных транзакциях (не будет потери информации) в случае уничтожения двух дата-центров (если они уничтожены не одновременно).
Podrobni opis datotečne strukture in implementacije sem se odločil, da ne vključim. Kdor želi eksperimentirati, lahko vse to prebere v README. Navedel bom le opis avtomatiziranega testiranja.
Sistem avtomatiziranega testiranja
Za preverjanje odpornosti klasterjev z simulacijo različnih napak je bil izdelan sistem avtomatiziranega testiranja. Zažene se s skriptom test/failure. Skript lahko sprejme kot parametre številke klasterjev, ki jih želite testirati. Na primer, ta ukaz:
test/failure 2 3bo testiral samo drugi in tretji klaster. Če parametri niso navedeni, se bodo testirali vsi klasterji. Vsi klasterji se testirajo hkrati, rezultati pa se prikazujejo v nadzorni plošči tmux. Tmux uporablja namenski tmux strežnik, zato lahko skript zaženete iz privzetega tmux-a, kar bo povzročilo vgrajen tmux. Priporočam uporabo terminala v velikem oknu z majhnim pisavo. Pred začetkom testiranja se vse virtualke vrnejo na posnetek ob koncu skripta. setup.
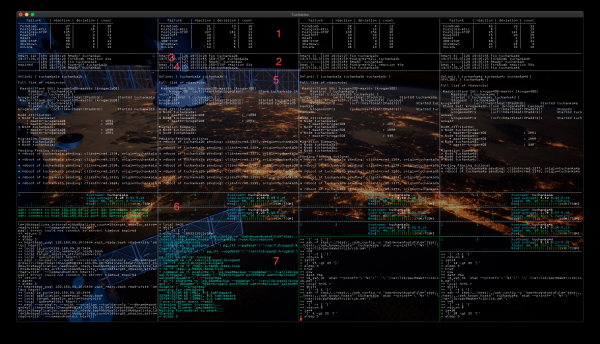
Terminal je razdeljen na stolpce glede na število testiranih klasterjev, privzeto (na posnetku zaslona) jih je štiri. Vsebino stolpcev bom razložil na primeru Tuchanka2. Plošče na posnetku zaslona so označene s številkami:
- Tukaj se prikazuje statistika testov. Stolpci:
- failure — ime testa (funkcije v skriptu), ki simulira napako.
- reaction — povprečje časa v sekundah, v katerem je klaster obnovil svoje delovanje. Meri se od začetka delovanja skripta, ki simulira napako, do trenutka, ko klaster obnovi svoje delovanje in lahko nadaljuje z zagotavljanjem storitev. Če je čas zelo kratek, na primer šest sekund (to se zgodi v klasterjih z več delavci (Tuchanka3 in Tuchanka4)), to pomeni, da je bila napaka na asinhronem delavcu in ni imela vpliva na delovanje, preklapljanja stanja klasterja ni bilo.
- deviation — prikazuje razpršenost (natančnost) vrednosti reaction z metodo „standardna deviacija“.
- count — koliko krat je bil ta test opravljen.
- Kratek dnevnik omogoča oceno, s čim se klaster trenutno ukvarja. Prikaže se številka iteracije (testa), časovna oznaka in ime operacije. Predolgo izvajanje (> 5 minut) kaže na morebitno težavo.
- heart (srce) — trenutni čas. Za vizualnu procenu funkcionalnosti majstor u njegovu tabelu se neprekidno upisuje trenutni čas koristeći float IP majstora. U slučaju uspeha, rezultat se prikazuje u ovoj панели.
- otkucaj (puls) — „trenutni čas“, koji je ranije zabeležen skriptom heart u majstoru, sada se čita iz rob putem njegovog float IP. Omogućava vizualnu procenu funkcionalnosti roba i replikacije. U Tuchanka1 nema roba s float IP (nema roba koji pružaju usluge), ali postoje dva instance (Baza podataka), pa će ovde biti prikazano ne otkucaj, a heart druga instanca.
- Monitoring stanja klastera pomoću alata
pcs mon. Prikazuje strukturu, raspodelu resursa po čvorovima i druge korisne informacije. - Ovde se prikazuje sistemsko praćenje svake virtuelne mašine klastera. Takvih panela može biti više — koliko virtuelnih mašina ima klaster. Dva grafikona CPU Opterećenje (u virtuelnim mašinama po dva procesora), ime virtuelne mašine, Sistemsko Opterećenje (nazvano kao Prosečno Opterećenje, jer je prosečeno za 5, 10 i 15 minuta), podaci o procesima i raspodela memorije.
- Praćenje skripta koje izvodi testiranja. U slučaju kvara — naglog prekida rada ili beskrajnog ciklusa čekanja — ovde se može videti uzrok takvog ponašanja.
Testiranje se sprovodi u dva koraka. Prvo, skript prolazi kroz sve vrste testova, nasumično birajući virtuelnu mašinu kojoj će se ovaj test primeniti. Zatim se sprovodi beskrajan ciklus testiranja, virtuelne mašine i kvarovi se svaki put biraju nasumično. Naglo završavanje skripta testiranja (donja tabla) ili beskrajan ciklus čekanja na nešto (> 5 minuta vreme izvršenja jedne operacije, to je vidljivo u praćenju) ukazuje na to da je neki od testova na ovom klasteru propao.
Svaki test se sastoji od sledećih operacija:
- Pokretanje funkcije koja emulira kvar.
- Spreman? — čekanje na obnavljanje funkcionalnosti klastera (kada postanu dostupne sve usluge).
- Prikazuje vreme čekanja na obnavljanje klastera (reaction).
- Popravi — klaster se „popravlja“. Nakon toga treba da se vrati u potpuno funkcionalno stanje i spremnosti za sledeći kvar.
Evo liste testova sa opisom šta rade:
- ForkBomb: stvara "Nema memorije" koristeći forka-bombu.
- Nema prostora: napolni diska. Vendar je test bolj simboličen, saj ob obremenitvi, ki se ustvari med testiranjem, ob preobremenitvi diska običajno ne pride do odpovedi PostgreSQL.
- Postgres-KILL: ubije PostgreSQL s komando
killall -KILL postgres. - Postgres-STOP: ukrivi PostgreSQL s komando
killall -STOP postgres. - PowerOff: 'izklopi' virtualni stroj s komando
VBoxManage controlvm "virtualni_stroj" poweroff. - Ponastavi: ponovno zažene virtualni stroj s komando
VBoxManage controlvm "virtualni_stroj" reset. - SBD-STOP: ukrivi SBD demon s komando
killall -STOP sbd. - ShutDown: pošlje komando virtualnemu stroju prek SSH
systemctl poweroff, sistem pravilno zaključi delo. - UnLink: omrežno izolacijo, komanda
VBoxManage controlvm "virtualni_stroj" setlinkstate1 off.
Končanje testiranja bodisi z uporabo standardne komande tmux "kill-window" Ctrl-b &, ali z komando "detach-client" Ctrl-b d: pri tem se testiranje zaključi, tmux se zapre, virtualni stroji se izklopijo.
Problemi ugotovljeni med testiranjem
Trenutno watchdog demon sbd obravnava ustavitev nadzorovanih demonov, vendar ne njihovega zastoja. In, kot posledica, nepravilno obravnava napake, ki povzročajo zastoj samo Corosync in Pacemaker, vendar ne povzročajo zastojev sbd. Za preverjanje Corosync već , sprejeto v veji master. Obljubili so (v PR#83), da bo tudi za Pacemaker nekaj podobnega, upam, da do RedHat 8 naredijo. Ampak takšne 'napake' so teoretične, jih je enostavno simulirati umetno z uporabo na primer
killall -STOP corosync, vendar se nikoli ne pojavijo v resničnem življenju.Pri Pacemaker v različici za CentOS 7 napačno nastavljen sync_timeout za quorum device, zato , kamor bi moral preiti glavni. Popravljeno je bilo z povečanjem sync_timeout za quorum device med uvajanjem (v skripti
setup/setup1). To popravilo ni bilo sprejeto s strani razvijalcev Pacemaker, namesto tega so obljubili, da bodo preoblikovali infrastrukturo na tak način (v nekem nedoločenem prihodnosti), da se bo ta časovni zamik izračunal samodejno.Če je pri konfiguriranju baze podatkov navedeno, da v
LC_MESSAGES(besedilna sporočila) lahko uporablja Unicode, na primer,ru_RU.UTF-8, potem pri zagonu postgres v okolju, kjer okolje ni UTF-8, na primer, v praznem okolju (tukaj pacemaker+pgsqlms(paf) zažene postgres), bo . Razvijalci PostgreSQL se nikoli niso dogovorili, kaj storiti v tem primeru. To se obide, potrebno je nastavitiLC_MESSAGES=en_US.UTF-8при конфигурировании (создании) инстанса БД.Если выставлен wal_receiver_timeout (по умолчанию он 60s), то при тесте PostgreSQL-STOP на мастере в кластерах tuchanka3 и tuchanka4 . Репликация там синхронная, поэтому останавливается не только раб, но и новый мастер. Обходится установкой wal_receiver_timeout=0 при настройке PostgreSQL.
Изредка наблюдалась задержка репликации у PostgreSQL в тесте ForkBomb (переполнение памяти). . Я встречал такое лишь в кластерах tuchanka3 и tuchanka4, где из-за того, что репликация синхронная, подвисал мастер. Проблема проходила сама, спустя какое-то длительное время (порядка двух часов). Требуется дополнительное исследование, чтобы это исправить. По симптомам похоже на предыдущий баг, который вызывается другой причиной, но с одинаковыми последствиями.
Картинка крогана взята с c разрешения автора:
Izvor: habr.com
