

O ustvarjanju sistema za spremljanje smo razmišljali že v fazi oblikovanja produktnih ekip. Postalo je jasno, da naše delo — izvajanje — nikakor ne vključuje teh ekip. Zakaj tako?
Dejstvo je, da so vse naše ekipe zgrajene okoli ločenih informacijskih sistemov, mikroservisov in vmesnikov, zato skupno zdravstveno stanje celotnega sistema ekipe ne zaznavajo. Na primer, morda ne vedo, kako neka majhna komponenta v globokem zadnjem delu vpliva na vmesni del. Njihovo zanimanje je omejeno na sisteme, s katerimi je njihov sistem integriran. Če pa ekipa in njen servis A skorajda nista povezana s servisom B, potem je ta servis za ekipo skorajda neviden.
Naša ekipa pa deluje z sistemi, ki so močno integrirani med seboj: med njimi je mnogo povezav, to je zelo velika infrastruktura. In od vseh teh sistemov (ki jih imamo, mimogrede, ogromno) je odvisno delovanje spletne trgovine.
Tako se zgodi, da naš oddelek ne pripada nobeni ekipi, ampak je nekoliko na obrobju. V vsem tem je naš cilj razumeti celotno delovanje informacijskih sistemov, njihovo funkcionalnost, integracije, programsko opremo, omrežje, strojno opremo in kako je vse to med seboj povezano.
Platforma, na kateri delujejo naše spletne trgovine, izgleda takole:
- sprednji del
- srednji del
- zadnji del
Kako zelo si želimo, da bi vse sisteme delovale gladko in brezhibno. Zadeva je ponovno v številu sistemov in integracij — pri takšnem, kot ga imamo, so nekateri incidenti neizbežni, kljub kakovosti testiranja. To velja tako za notranje delovanje neke posamezne sistema kot tudi za njihove integracije. Potrebno je spremljati stanje celotne platforme celovito in ne le nekaterih njenih delov.
Idealen način za spremljanje zdravstvenega stanja celotne platforme je avtomatizacija. Tako smo prišli do spremljanja kot nujnega dela tega procesa. Sprva je bil vzpostavljen le za sprednji del, pri čemer so lastni sistemi spremljanja po plastih obstajali in še obstajajo pri omrežarjih, skrbnikih programske opreme in strojne opreme. Vsi ti ljudje so spremljali monitoring le na svojem nivoju, celostnega razumevanja pa tudi noben ni imel.
Na primjer, ako virtualna mašina padne, u većini slučajeva to zna samo administrator odgovoran za hardver i virtualnu mašinu. Front-end timovi su u tim slučajevima vidjeli samo sam događaj pada aplikacije, ali nisu imali podatke o padu virtualne mašine. Administrator može znati ko je klijent i otprilike razumeti šta se trenutno događa na toj virtualnoj mašini, pod uslovom da je to neki veliki projekat. Za male projekte verovatno nije obavešten. U svakom slučaju, administrator mora otići do vlasnika, pitati šta se tačno nalazilo na ovoj mašini, šta treba obnoviti i šta promeniti. A ako se nešto ozbiljno slomilo, počela bi trka u krug — jer niko nije video sistem u celini.
Na kraju, ovakve raspršene priče utiču na celu front-end funkciju, na korisnike i našu osnovnu poslovnu funkciju — internet prodaju. Kako ne pripadamo timovima, već se bavimo operacijom svih ecommerce aplikacija unutar internet prodavnice, preuzeli smo zadatak kreiranja sveobuhvatnog sistema monitoringa ecommerce platforme.
Struktura sistema i tehnološki sklop
Počeli smo tako što smo izdvojili nekoliko slojeva monitoringa za naše sisteme, kroz koje ćemo sakupljati metrike. Sve to je trebalo objediniti, što smo i uradili u prvoj fazi. Sada radimo na maximiziranju kvaliteta sakupljanja metrika po svim našim slojevima, kako bismo uspostavili korelaciju i razumeli kako sistemi utiču jedni na druge.
Nedostatak sveobuhvatnog monitoringa u početnim fazama pokretanja aplikacija (budući da smo ga počeli graditi kada je velika većina sistema bila u eksploataciji) doveo je do značajnog tehničkog duga u podešavanju monitoringa cele platforme. Nismo mogli da se fokusiramo na podešavanje monitoringa samo jednog IS-a i detaljno radimo monitoring za njega, jer bi ostali sistemi ostali na neko vreme bez monitoringa. Da bismo rešili ovaj problem, odredili smo listu najvažnijih metrika za procenu stanja informacionog sistema po slojevima i započeli njenu implementaciju.
Zato smo odlučili da jedemo slona na delove.
Naš sistem se sastoji od:
- hardvera;
- operativnog sistema;
- softvera;
- UI deli v aplikaciji za spremljanje;
- poslovne metrike;
- integracijske aplikacije;
- informacijska varnost;
- omrežja;
- balancer prometa.
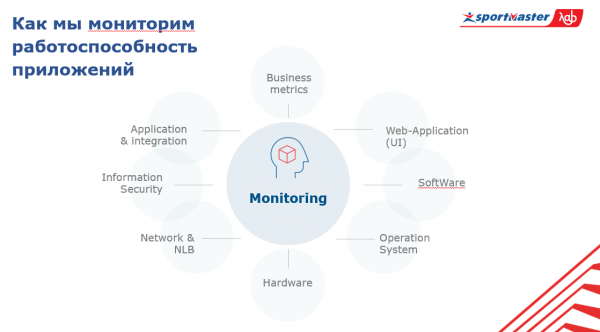
V središču tega sistema je samo spremljanje. Da bi splošno razumeli stanje celotnega sistema, moramo vedeti, kaj se dogaja z aplikacijami na vseh teh plasteh in skozi celoten nabor aplikacij.
Torej, o kupu.
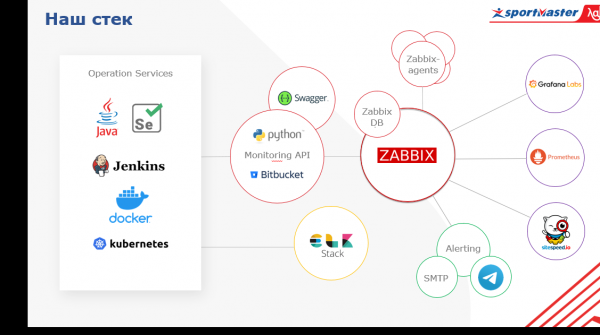
Uporabljamo programsko opremo z odprto kodo. V središču imamo Zabbix, ki ga uporabljamo predvsem kot sistem za opozarjanje. Vsem je znano, da je popoln za spremljanje infrastrukture. Kaj to pomeni? Gre za nizkoinvazivne metrike, ki jih ima vsako podjetje, ki ima svoj podatkovni center (Sportmaster ima svoje podatkovne centre) — temperatura strežnika, stanje pomnilnika, RAID-a, metrike omrežnih naprav.
Integrirali smo Zabbix z aplikacijama Telegram in Microsoft Teams, ki ju aktivno uporabljajo ekipe. Zabbix pokriva plast dejanskega omrežja, strojne opreme in delno programske opreme, vendar to ni panaceja. Te podatke dopolnjujemo iz nekaterih drugih storitev. Na primer, glede strojne opreme se neposredno prek API-ja povežemo v našem sistemu virtualizacije in pridobimo podatke.
Kaj še. Poleg Zabbixa uporabljamo Prometheus, ki omogoča spremljanje metrik v aplikaciji dinamičnega okolja. To pomeni, da lahko pridobivamo metrike aplikacije prek HTTP končne točke in se ne skrbimo glede tega, katere metrike naložiti vanjo, katere pa ne. Na podlagi teh podatkov lahko oblikujemo analitične poizvedbe.
Viri podatkov za ostale plasti, na primer poslovne metrike, se delijo na tri sestavine.
Prvič, to so zunanje poslovne sisteme, Google Analytics, zbiramo metrike iz dnevnikov. Iz njih pridobivamo podatke o aktivnih uporabnikih, konverzijah in vsem, kar je povezano z poslovanjem. Drugič, to je sistem spremljanja UI. O tem je treba podrobneje govoriti.
Nekoč smo začeli z ročnim testiranjem, ki je preraslo v avtomatske teste funkcionalnosti in integracij. Iz tega smo ustvarili spremljanje, obdržali smo le osnovno funkcionalnost in se povezali z markerji, ki so čim bolj stabilni in se ne spreminjajo pogosto.
Nova struktura ekip pomeni, da se vse dejavnosti aplikacij osredotočajo na produktne ekipe, zato se s čistem testiranjem več ne ukvarjamo. Namesto tega smo teste preoblikovali v UI-monitoring, napisan v Javi, Selenium in Jenkins (ki se uporablja kot sistem za zagon in generiranje poročil).
Imeli smo veliko testov, a na koncu smo se odločili za prehod na glavno pot, vrhnjo metriko. In če imamo veliko specifičnih testov, bo težko ohranjati ažurnost podatkov. Vsaka naslednja izdaja bo bistveno uničila celoten sistem, mi pa se bomo samo ukvarjali z njegovimi popravili. Zato se osredotočamo na temeljne stvari, ki se redko spreminjajo, in spremljamo samo te.
Nazadnje, kot tretje, je vir podatkov centraliziran sistem za beleženje. Za beleženje uporabljamo Elastic Stack, nato pa lahko te podatke vtiramo v naš sistem monitoringa po poslovnih metriki. Poleg vsega tega deluje naš lasten Monitoring API, napisan v Pythonu, ki po API-ju vpraša katere koli storitve in pridobiva podatke iz njih v Zabbix.
Še en nepogrešljiv atribut monitoringa je vizualizacija. Ta pri nas temelji na Grafani. Med drugimi sistemi vizualizacije se izpostavlja po tem, da lahko na nadzorni plošči vizualiziramo metrike iz različnih virov podatkov. Lahko zberemo vrhnje metrike spletne trgovine, na primer število naročil, prejetih v zadnji uri, iz DBMS, metrike zmogljivosti operacijskega sistema, na katerem teče ta spletna trgovina, iz Zabbixa, ter metrike instanc te aplikacije iz Prometheusa. In vse to bo na eni nadzorni plošči. Pregledno in dostopno.
Opažam glede varnosti — trenutno nadgrajujemo sistem, ki ga bomo kasneje integrirali z globalnim sistemom monitoringa. Po mojem mnenju so glavni problemi, s katerimi se srečuje e-commerce na področju informacijske varnosti, povezani z botom, parserji in brutalnim siljenjem. To je treba spremljati, saj vse to lahko kritično vpliva tako na delovanje naših aplikacij kot tudi na ugled z vidika poslovanja. Izbrana tehnologija uspešno pokriva te naloge.
Še en pomemben vidik je, da raven aplikacij zbira Prometheus. Tudi ta je pri nas povezan z Zabbixom. Imamo tudi sitespeed, storitev, ki nam omogoča spremljanje parametrov, kot so hitrost nalaganja naše strani, ozka grla, prikazovanje strani, nalaganje skript in drugo; ta je prav tako integrirana prek API-ja. Tako se naše metrike zbirajo v Zabbixu, zato tam tudi pošiljamo alerte. Vse alerte trenutno odhajajo na glavne načine pošiljanja (to sta za zdaj e-pošta in Telegram, nedavno smo dodali še MS Teams). Načrtujemo nadgraditi alerting na takšno raven, da bi pametni boti delovali kot storitev in zagotavljali informacije o monitoringu vsem željnim produktnim ekipam.
Za nas so pomembne metrike ne le posameznih informacijskih sistemov, temveč tudi skupne metrike celotne infrastrukture, ki jo uporabljajo aplikacije: grozdi fizičnih strežnikov, na katerih se izvajajo virtualni stroji, uravnavači prometa, Network Load Balancer-ji, sama mreža, izkoriščenost komunikacijskih kanalov. Poleg tega so metrični podatki tudi o naših lastnih podatkovnih centrih (imamo več in infrastruktura je precej obsežna).
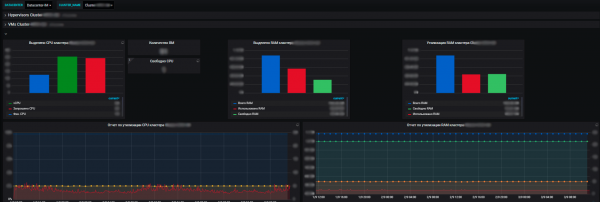
Prednosti našega sistema monitoringa so v tem, da z njegovo pomočjo vidimo stanje delovanja vseh sistemov, lahko ocenimo njihovo medsebojno vplivanje in vpliv na skupne vire. Na koncu nam omogoča načrtovanje virov, kar prav tako spada v našo odgovornost. Upravljamo s strežniškimi viri — bazenom znotraj e-trgovine, uvajamo in izločamo novo opremo, kupujemo novo, izvajamo revizijo izkoriščanja virov in drugo. Vsako leto ekipe načrtujejo nove projekte, razvijajo svoje sisteme in za nas je pomembno, da jim zagotovimo vire.
S pomočjo metrik vidimo trend porabe virov naših informacijskih sistemov. Na njihovi osnovi lahko že začnemo z načrtovanjem. Na ravni virtualizacije zbiramo podatke in vidimo informacije o razpoložljivem številu virov po podatkovnih centrih. Znotraj podatkovnega centra pa je vidna tako izkoriščenost kot dejanska porazdelitev in poraba virov. To velja tako za samostojne strežnike kot za virtualne stroje in gruče fizičnih strežnikov, na katerih se vsi ti virtualni stroji uspešno izvajajo.
Perspektive
Trenutno imamo osnova sistema u celini, ali još uvek ima dovoljno stvari na kojima treba raditi. Bar je to sloj informatičke sigurnosti, ali je važno i doći do mreže, razviti alërtanje i rešiti pitanja sa korelacijom. Imamo mnogo slojeva i sistema, a na svakom sloju još mnogo metrike. Ispada da je ovo matrjoška na kvadrat.
Naš cilj je na kraju stvoriti prave alerte. Na primer, ako se desi problem sa hardverom, opet, sa virtuelnom mašinom, a tamo je bila važna aplikacija, i servis nije bio nikako rezervisan. Saznaćemo da je virtuelna mašina 'umrla'. Zatim će se alertovati poslovne metrike: korisnici su se negde izgubili, konverzija nema, UI u interfejsu nije dostupan, softver i servisi su takođe 'umrli'.
U ovakvom scenariju dobićemo spam iz alerata, a to već ne odgovara formatu pravog sistema monitora. Postavlja se pitanje korelacije. Zato bi idealno naš sistem monitoringa trebao reći: 'Momci, vaša fizička mašina je umrla, zajedno sa ovom aplikacijom i takvim metrikama', uz pomoć jednog alerata, umesto da nas besno zasipa stotinama alerata. Trebao bi da izvesti o onome što je najvažnije — o uzroku, što doprinosi hitnosti rešenja problema putem njegove lokalizacije.
Naš sistem obaveštavanja i obrada alerata je izgrađen oko 24/7 službe za pomoć. Svi alerti koji se smatraju obaveznim i ulaze u kontrolnu listu se šalju tamo. Svaki alert mora obavezno imati opis: šta se dogodilo, šta to zapravo znači, na šta utiče. Takođe, link na dashboard i uputstvo šta se u tom slučaju treba raditi.
To su svi zahtevi za izgradnju alertanja. Dalje, situacija se može razvijati u dva pravca — ili problemi postoje i treba ih rešavati, ili je došlo do kvara u sistemu monitoringa. Ali u svakom slučaju, treba ići i istražiti.
U proseku, sada nam dnevno dolazi oko stotinu alerata, uzimajući u obzir da korelacija alerata još nije pravilno podešena. I ako je potrebno obaviti tehničke radove, i nešto prisilno isključimo, njihova brojka se višestruko povećava.
Poleg spremljanja sistemov, ki jih uporabljamo, in zbiranja metrik, ki jih naša stran šteje za pomembne, sistem za spremljanje omogoča zbiranje podatkov za produktne ekipe. Te lahko vplivajo na sestavo metrik v okviru informacijskih sistemov, ki jih spremljamo.
Naš kolega lahko pride in prosi, da dodamo katero koli metriko, ki bi bila uporabna tako za nas kot za ekipo. Ali pa, recimo, ekipi morda osnovne metrike, ki jih imamo, ne zadostujejo in potrebujejo specifične. V Grafani ustvarjamo prostor za vsako ekipo in jim dodelimo skrbniška pravica. Poleg tega, če ekipi potrebujemo nadzorne plošče, pa jih same ne morejo/ne vedo, kako to narediti, jim pomagamo.
Ker smo zunaj procesa ustvarjanja vrednosti ekipe, njihovih izdaj in načrtovanja, postopoma prihajamo do tega, da so izdaje vseh sistemov brezšivne in jih lahko objavljamo vsak dan, ne da bi se o tem usklajevali z nami. Nam je pomembno spremljati te izdaje, saj lahko potencialno vplivajo na delovanje aplikacije in lahko kaj pokvarijo, kar je kritično. Za upravljanje izdaj uporabljamo Bamboo, od koder prek API-ja pridobivamo podatke in lahko vidimo, katere izdaje v katerih informacijskih sistemih so izšle in njihov status. In najpomembneje — ob katerem času. Oznake o izdajah nalagamo na glavne kritične metrike, kar vizualno predstavlja precej dobri kazalec v primeru težav.
Tako lahko vidimo korelacijo med novimi izdajami in nastajajočimi težavami. Glavna ideja je razumeti, kako sistem deluje na vseh plasteh, hitro lokalizirati težavo in jo prav tako hitro odpraviti. Kajti pogosto se zgodi, da največ časa ne vzame reševanje težave, temveč iskanje vzroka.
Na tem področju se v prihodnosti želimo osredotočiti na proaktivnost. Ideja je, da bi o prihajajoči težavi izvedeli vnaprej, namesto šele po njenem nastanku, da bi se ukvarjali z njenim preprečevanjem in ne reševanjem. Občasno pride do lažnih alarmov sistema za spremljanje, tako zaradi človeške napake kot sprememb v aplikaciji. In na tem delamo, optimiziramo in se trudimo, da uporabnike, ki uporabljajo naš sistem za spremljanje, obveščamo o vseh manipulacijah, ali pa te aktivnosti izvajamo v teh. oknu.
Torej, sistem je bil zagonjen in uspešno deluje od pomladi... in prinaša precejšnje dobičke. Seveda to ni končna različica, vnesti želimo še vrsto koristnih funkcij. Toda prav v tem trenutku, ob tolikšnem številu integracij in aplikacij, brez avtomatizacije spremljanja res ni mogoče.
Če tudi vi spremljate velike projekte s številnimi integracijami — v komentarjih nam pišite, katero rešitev ste našli za to.
Izvor: habr.com
