

Pozdravljen! Moje ime je Nikolaj Golov. Pred tem sem delal pri Avitu in šest let vodil Data Platform, kar pomeni, da sem se ukvarjal z vsemi bazami: analitičnimi (Vertica, ClickHouse), tokovnimi in OLTP (Redis, Tarantool, VoltDB, MongoDB, PostgreSQL). V tem času sem spoznal veliko število baz podatkov - najrazličnejših in nenavadnih, s posebnimi primeri njihove uporabe.
Zdaj delam v ManyChat. V bistvu je to začetek podjetja - nov, ambiciozen in hitro rastoč. In ko sem prvič vstopil v podjetje, se je pojavil klasičen vprašaj: "Kaj naj zdaj vzame mlado startup podjetje iz trga DBMS in baz podatkov?".
V tem članku, temelječem na mojem predavanju na , bom odgovoril na to vprašanje. Video različica predavanja je na voljo na .
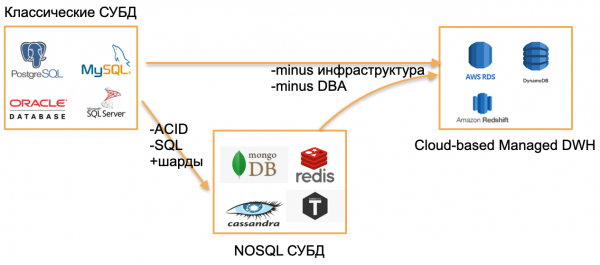
Dobro znane baze podatkov leta 2020
Leto je 2020, pogledal sem okoli in opazil tri tipe baz podatkov.
Prvi tip - klasične OLTP baze: PostgreSQL, SQL Server, Oracle, MySQL. Napisane so že davno, a so še vedno aktualne, ker so dobro znane skupnosti razvijalcev.
Drugi tip - baze iz "ničelnih". Poskušali so pobegniti od klasičnih predlog skozi opustitev SQL, tradicionalnih struktur in ACID, s pomočjo dodanega vgrajenega šardiranja in drugih privlačnih funkcij. Na primer, to so Cassandra, MongoDB, Redis ali Tarantool. Vse te rešitve so želele ponuditi trgu nekaj povsem novega in so našle svojo nišo, ker so se v določenih nalogah izkazale za zelo praktične. Te baze bom označil z obsežnim izrazom NOSQL.
"Ničelna" doba se je končala, na NOSQL baze smo se navadili in svet, po mojem mnenju, je naredil naslednji korak - k upravljanim bazam. Te baze imajo jedro, kot klasične OLTP baze ali nove NoSQL. A nimajo potrebe po DBA in DevOps ter delujejo na upravljani opremi v oblakih. Za razvijalca je to "preprosta baza", ki nekje deluje, kako je nameščena na strežniku, kdo je nastavil strežnik in kdo ga posodablja, nikogar ne zanima.
Primeri takih baz:
- AWS RDS - upravljana plast nad PostgreSQL/MySQL.
- DynamoDB - AWS-ov analog dokumentne baze, podoben Redis in MongoDB.
- Amazon Redshift - upravljana analitična baza.
Osnova so stare baze, a so postavljene v upravljano okolje, brez potrebe po delu z opremo.
Opomba. Primeri so vzeti za okolje AWS, vendar obstajajo tudi njihovi analogi v Microsoft Azure, Google Cloud ali Yandex.Cloud.
Kaj pa je novega? Leta 2020 ni nič novega.
Koncept Serverless
Resnično novost na trgu v letu 2020 so rešitve brez strežnika.
Poskusil bom razložiti, kaj to pomeni, na primeru običajne storitve ali back-end aplikacije.
Za postavitev običajne back-end aplikacije kupimo ali najamemo strežnik, prenesemo kodo nanj, objavimo javno endpoints in redno plačujemo za najem, elektriko in storitve podatkovnega centra. To je standardni postopek.
Ali to lahko storimo drugače? Z rešitvami brez strežnika lahko.
Kje je trick te metode: ni strežnika, niti najema virtualnega instance v oblaku. Za postavitev storitve prenesemo kodo (funkcije) v repozitorij in objavimo javno endpoint. Nato preprosto plačamo za vsak klic te funkcije, popolnoma ignoriramo strojno opremo, kjer se izvaja.
Poskusil bom ilustrirati ta pristop s slikami.
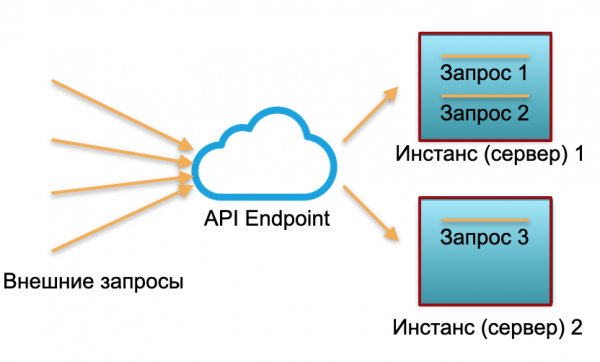
Klasično nameščanje. Imamo storitev z določeno obremenitvijo. Postavimo dva instance: fizične strežnike ali instance v AWS. Na te instance se usmerjajo zunanje zahteve, ki jih tam obdelajo.
Kot je razvidno na sliki, so strežniki izkoriščeni neenakomerno. Eden je izkoriščen 100%, tam sta dva zahtevka, drugi pa le 50% — delno miruje. Če pride ne tri zahteve, ampak 30, celoten sistem ne bo zdržal obremenitve in se bo začel upočasnjevati.
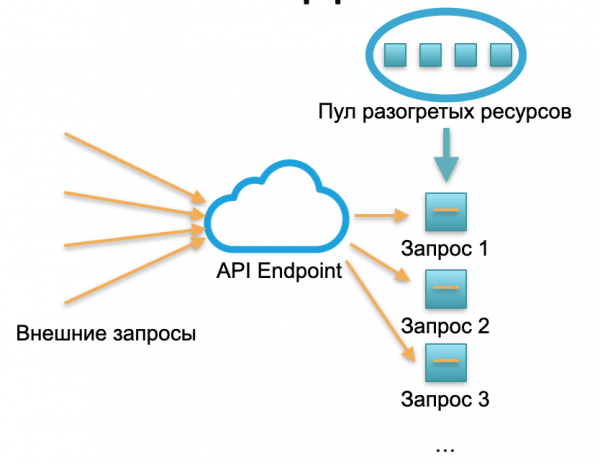
Brezstrežni deploy. V brezstrežnem okolju takšna storitev nima instance in strežnikov. Obstaja določen bazen ogretih virov - majhnih pripravljenih Docker kontejnerjev z razporejeno funkcijsko kodo. Sistem prejemanja zunanjih zahtev in za vsak od njih brezstrežni okvir postavi majhen kontejner s kodo: obdeluje točno to zahtevo in ubije kontejner.
En klic — en postavljen kontejner, 1000 klicev — 1000 kontejnerjev. In postavitev na fizičnih strežnikih je že delo oblačnega ponudnika. To je popolnoma skrito z brezstrežnim okvirom. V tej konceptu plačamo za vsak klic. Na primer, če pride en klic na dan — plačamo za en klic, če prihajajo milijon klicev na minuto — plačamo za milijon. Ali na sekundo, to se tudi zgodi.
Koncept objave serverless funkcije je primeren za stateless storitev. Če pa potrebujete statefull storitev, potem k storitvi dodamo bazo podatkov. V tem primeru, ko gre za delo s stanjem, vsaka statefull funkcija preprosto piše in bere iz baze podatkov. In to iz baze podatkov katerega koli od treh tipov, opisanih na začetku članka.
Kakšno splošno omejitev imajo vse te baze? To so stroški za stalno uporabljeni oblačni ali fizični strežnik (ali več strežnikov). Ni pomembno, ali uporabljamo klasično bazo ali upravljano, ali imamo devops in skrbnika ali ne, kljub temu 24 na 7 plačujemo za strojno opremo, elektriko in najem podatkovnega centra. Če imamo klasično bazo, plačujemo za master in slave. Če imamo visoko obremenjeno šardirano bazo — plačujemo za 10, 20 ali 30 strežnikov, in plačujemo nenehno.
Prisotnost stalno rezerviranih strežnikov v strukturi stroškov je bila prej dojemana kot neizbežno zlo. Klasične baze imajo tudi druge zaplete, kot so omejitve na število povezav, omejitve skaliranja, geo-porazdeljeni konsenz — te težave je mogoče nekako rešiti v nekaterih bazah, vendar ne vse hkrati in ne popolnoma.
Serverless baza podatkov — teorija
Vprašanje leta 2020: ali lahko tudi bazo podatkov naredimo serverless? Vsi smo slišali za serverless backend… zakaj ne bi poskusili narediti bazo podatkov serverless?
Zveni nenavadno, ker je baza podatkov statefull storitev, ki ni najbolj primerna za serverless infrastrukturo. Hkrati pa je stanje baze podatkov zelo veliko: gigabajti, terabajti, pri analitičnih bazah celo petabajti. Tako ne moremo kar enostavno upravljati v lahkih Docker kontejnerjih.
Po drugi strani pa skoraj vse sodobne baze vsebujejo ogromno logike in komponent: transakcije, usklajevanje celovitosti, postopki, relacijske odvisnosti in veliko logike. Dokaj velik del logike baze podatkov zahteva dokaj majhno stanje. Gigabajti in terabajti se neposredno uporabljajo le v majhnem delu logike baze podatkov, povezane z neposredno izvajanjem poizvedb.
Tako je ideja: če del logike dopušča stateless izvajanje, zakaj ne bi razdelili baze na Stateful in Stateless dele.
Serverless za OLAP rešitve
Poglejmo, kako bi lahko izgledala razdelitev baze podatkov na Stateful in Stateless dele na praktičnih primerih.
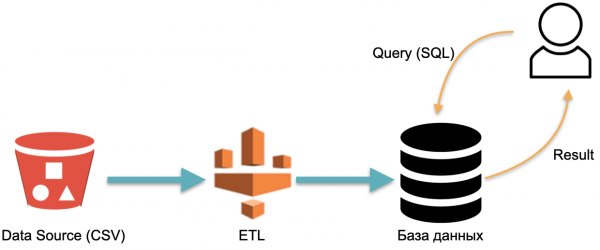
Na primer, imamo analitično bazo podatkov.: zunanje podatke (rdeč valj na levi), ETL postopek, ki nalaga podatke v bazo, ter analitik, ki pošilja SQL poizvedbe bazi. To je klasična shema delovanja skladišča podatkov.
V tej shemi se ETL izvaja pogojno enkrat. Naprej je treba stalno plačevati za strežnike, na katerih deluje baza s podatki, naloženimi z ETL, da imamo kam pošiljati poizvedbe.
Oglejmo si alternativen pristop, ki je realiziran v AWS Athena Serverless. Tukaj ni stalno dodeljene strojne opreme, na kateri so shranjeni naloženi podatki. Namesto tega:
- Uporabnik pošlje SQL poizvedbo Atheni. Optimizator Atheni analizira SQL poizvedbo in išče v shrambi metapodatkov (Metadata) konkretne podatke, potrebne za izvedbo poizvedbe.
- Optimizator na podlagi zbranih podatkov prenese potrebne podatke iz zunanjih virov v začasno shramba (začasno bazo podatkov).
- V začasni shrambi se izvrši SQL poizvedba uporabnika, rezultat pa se vrne uporabniku.
- Začasna shramba se očisti, viri se sprostijo.
V tej arhitekturi plačamo le za postopek izvršitve poizvedbe. Ni poizvedb – ni stroškov.
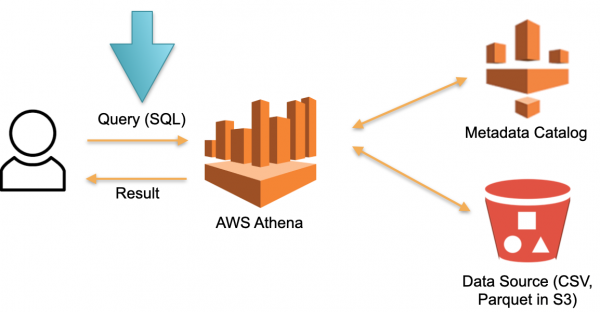
To je delujoč pristop in se realizira ne le v Athena Serverless, temveč tudi v Redshift Spectrum (v AWS).
Na primeru Athene je razvidno, da Serverless baza podatkov deluje na realnih poizvedbah z desetinami in stotinami terabajtov podatkov. Za stotine terabajtov potrebujemo stotine strežnikov, vendar za njih ne plačamo – plačamo za poizvedbe. Hitrost vsake poizvedbe je (zelo) nizka v primerjavi s specializiranimi analitičnimi bazami, kot je Vertica, vendar ne plačujemo obdobij zastoja.
Takšna baza podatkov je primerna za redke analitične ad-hoc poizvedbe. Na primer, ko se spontano odločimo preveriti hipotezo na nekem ogromnem volumnu podatkov. Za te primere je Athena popolna. Za redne poizvedbe je ta sistem drag. V tem primeru bazo podatkov shranite v nekem specializiranem rešenju.
Serverless za OLTP rešitve
V prejšnjem primeru smo obravnavali OLAP naloge (analitične). Zdaj bomo obravnavali OLTP naloge.
Predstavimo skalirni PostgreSQL ali MySQL. Dvignimo običajno upravljano instanco PostgreSQL ali MySQL z minimalnimi viri. Ko bo na instanco prišla večja obremenitev, bomo povezali dodatne replikate, na katere bomo razporedili del berljive obremenitve. Če ni poizvedb in obremenitve — izključimo replike. Prva instanca je master, ostale so replike.
Ta ideja je uresničena v bazi imenovani Aurora Serverless AWS. Načelo je preprosto: poizvedbe iz zunanjih aplikacij sprejema proxy flota. Ko zazna rast obremenitve, dodeli računalniške vire iz vnaprej segretih minimalnih instanc — povezava se izvede čim hitreje. Izklapljanje instanc poteka prav tako.
V okviru Aurora obstaja pojem Aurora Capacity Unit, ACU. To je (odvzetno) — instanca (strežnik). Vsak določen ACU je lahko master ali slave. Vsaka enota kapacitete ima svojo operativno pomnilnik, procesor in minimalno diskovno kapaciteto. Tako imamo enega master, ostale pa so le berljive replike.
Število teh delujočih Aurora Capacity Units je nastavljiv parameter. Minimalno število je lahko ena ali nič (v tem primeru baza ne deluje, če ni poizvedb).
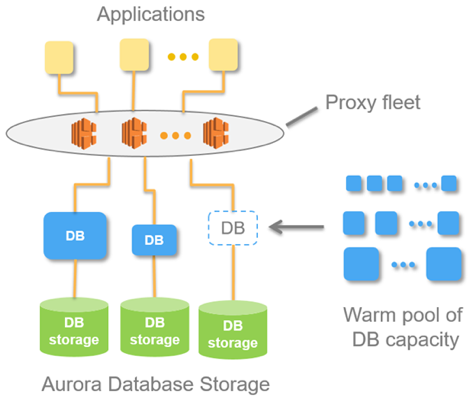
Ko baza prejme poizvedbe, proxy flota dvigne Aurora CapacityUnits in poveča proizvodne vire sistema. Možnost povečevanja in zmanjševanja virov omogoča sistemu, da 'žonglira' z viri: samodejno izklopi posamezne ACU (jih zamenja z novimi) in na izklopljene vire naloži vse aktualne posodobitve.
Baza Aurora Serverless lahko skalira berljivo obremenitev. Vendar pa v dokumentaciji o tem ni povedano neposredno. Lahko se pojavi občutek, da lahko dvignejo multi-master. Kakor koli, tu ni nobene čarovnije.
Ta baza je odlična za izbegavanje velikih troškova na sistemima sa nepredvidivim pristupom. Na primer, kada kreiramo MVP ili marketinške sajtove, obično ne očekujemo stabilno opterećenje. U skladu s tim, kada nema pristupa, ne plaćamo instance. Kada iznenada dođe do opterećenja, poput onog posle konferencije ili marketinške kampanje, mase ljudi posete sajt i opterećenje naglo raste, Aurora Serverless automatski prihvata to opterećenje i brzo dodaje potrebne resurse (ACU). Nakon konferencije, svi zaborave na prototip, serveri (ACU) se gase i troškovi opadaju na nulu — praktično.
Ovo rešenje nije pogodno za stabilno visoko opterećenje, jer ne može da skalira upisno opterećenje. Sva ta povezivanja i odspajanja resursa dešavaju se u trenutku poznatom kao „scale point“ — trenutku kada baza nije pod transakcijom, niti su zauzete privremene tabele. Na primer, tokom nedelje scale point možda neće nastati, a baza funkcioniše na istim resursima i jednostavno ne može ni da se poveća, ni da se smanji.
Nema magije — to je običan PostgreSQL. Ali proces dodavanja i isključivanja mašina je delimično automatizovan.
Serverless po dizajnu
Aurora Serverless je stara baza koja je prilagođena oblaku tako da koristi odvojene prednosti Serverless. A sada ću govoriti o bazi koja je prvobitno napisana za oblak, pod serverless pristupom — Serverless-by-design. Razvijana je bez pretpostavke da radi na fizičkim serverima.
Ova baza se zove Snowflake. Ima tri ključna bloka.
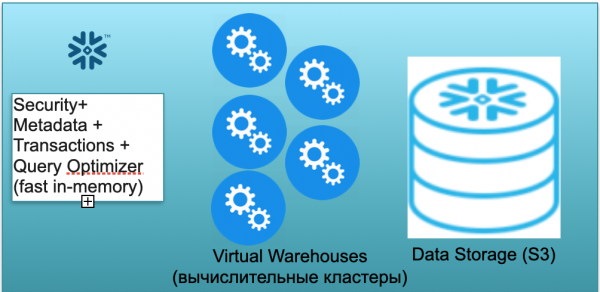
Prvi — blok metapodataka. To je brza in-memory usluga koja se bavi pitanjima bezbednosti, metapodataka, transakcija, optimizacije upita (na ilustraciji levo).
Drugi blok — to su brojni virtuelni računski klasteri za izračunavanja (na ilustraciji — set plavih krugova).
Treći blok — sistem skladištenja podataka zasnovan na S3. S3 je neograničeno objektno skladište u AWS-u, nešto kao neograničeni Dropbox za biznis.
Poglejmo, kako Snowflake deluje v scenariju hladnega zagona. To pomeni, da baza obstaja, podatki so naloženi v njo, vendar ni aktivnih poizvedb. Zato, če ni poizvedb, imamo zagnan hiter in-memory Metadata servis (prvi sklop). Imamo tudi S3 shrambo, kjer so podatki tabel razdeljeni na t.i. mikroparticije. Poenostavljeno: če tabela vsebuje posle, so mikroparticije dnevi poslov. Vsak dan je ločena mikroparticija, ločena datoteka. Ko baza deluje v tem načinu, plačujete samo za prostor, ki ga zasedajo podatki. Tarifa za prostor je zelo nizka (še posebej ob upoštevanju pomembne stiskanja). Metadata servis prav tako deluje neprekinjeno, vendar za optimizacijo poizvedb ne potrebuje veliko virov, zato ga lahko štejemo kot pogojno brezplačnega.
Zdaj si predstavljajte, da je uporabnik poslal SQL poizvedbo naši bazi. SQL poizvedba takoj pride v obdelavo v Metadata servis. Takoj ko prejme poizvedbo, ta servis analizira poizvedbo, dostopne podatke, pooblastila uporabnika in, če je vse v redu, pripravi načrt obdelave poizvedbe.
Nato servis sproži zagon izračunskega klastra. Izračunski klaster je skupina strežnikov, ki izvajajo izračune. To pomeni, da klaster lahko vsebuje 1, 2, 4, 8, 16, 32 strežnikov — kolikor želite. Pošljete poizvedbo in za njo se takoj začne zagon tega klasterja. To resnično traja sekunde.
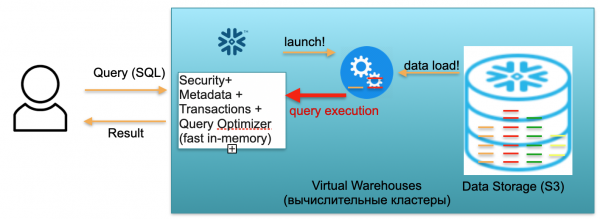
Nato, potem ko se je kluster zagnal, se v kluster iz S3 začnejo kopirati mikroparticije, potrebne za obdelavo vašega poizvedovanja. To pomeni, da si predstavljamo, da za izvajanje SQL poizvedbe potrebujemo dve particiji iz ene tabele in eno iz druge. V tem primeru se v kluster kopirajo samo tri potrebne particije, ne pa vse tabele v celoti. Prav zaradi tega, ker je vse v okviru enega podatkovnega centra in povezano z zelo hitrimi povezavami, poteka proces prenosa zelo hitro: v sekunh, redko — v minutah, če ne gre za kakšne monstruozne poizvedbe. Tako se mikroparticije kopirajo na računalniški kluster in po zaključku se na tem računalniškem klastru izvaja SQL poizvedba. Rezultat te poizvedbe je lahko ena vrstica, več vrstic ali tabela — te se pošljejo uporabniku, da jih prenese, prikaže v svojem BI orodju ali na kak način uporabi.
Vsaka SQL poizvedba lahko ne le prešteje agregate iz prej naloženih podatkov, temveč tudi naloži/formira nove podatke v bazi. To pomeni, da je to lahko poizvedba, ki, na primer, izvrši vstavljanje novih zapisov v drugo tabelo, kar vodi do pojavitve nove particije na računalniškem klastru, ki se nato samodejno shrani v enotno S3 shrambo.
Opisani scenarij, od prihoda uporabnika do zagon klasterja, nalaganje podatkov, izvajanje poizvedb, pridobivanje rezultatov, se obračunava po tarifi za minute uporabe zagnanega virtualnega računalniškega klasterja, virtualnega skladišča. Tarifa se razlikuje glede na območje AWS in velikost klasterja, a povprečno znaša nekaj dolarjev na uro. Klaster s štirimi stroji je dvakrat dražji od klasterja z dvema strojima, klaster z osmimi stroji pa je še dvakrat dražji. Na voljo so možnosti z 16, 32 stroji, odvisno od kompleksnosti poizvedb. Plačate pa le za tiste minute, ko klaster dejansko deluje, ker, ko ni poizvedb, vi praktično umaknete roke, in po 5-10 minutah čakanja (nastavljiv parameter) se sam ugasne, sprosti vire in postane brezplačen.
Skenarij je potpuno realan kada pošaljete zahtev, klaster se pojavljuje, da kažemo, za minut, još minut traje proračun, zatim pet minuta na gašenje, i na kraju plaćate za sedam minuta rada tog klastera, a ne za mesece i godine.
Prvi scenario opisuje korišćenje Snowflake u jednopostavljačkom režimu. Sada zamislite da ima mnogo korisnika, što već bliže stvarnom scenariju.
Pretpostavimo da imamo mnogo analitičara i Tableau izveštaja koji neprekidno bombarduju našu bazu velikim brojem jednostavnih analitičkih SQL zahteva.
Osim toga, pretpostavimo da imamo inventivne Data Scientists koji pokušavaju da rade užasne stvari sa podacima, upravljajući desetinama terabajta, analizirajući milijarde i trilione redova podataka.
Za navedena dva tipa opterećenja, Snowflake omogućava pokretanje više nezavisnih računarskih klastera različitih kapaciteta. Ovi računarski klasteri rade nezavisno, ali sa zajedničkim doslednim podacima.
Za veliki broj lakih zahteva, možete pokrenuti 2-3 mala klastera, veličine, recimo, po 2 mašine svaki. Ovo ponašanje je ostvarivo, između ostalog, putem automatskih podešavanja. Dakle, kažete: 'Snowflake, pokreni mali klaster. Ako opterećenje poraste iznad određenog parametra, pokreni sličan drugi, treći. Kada opterećenje počne da opada – ugasi suvišne.' Tako da, bez obzira na to koliko analitičara dođe i počne da pregleda izveštaje, svima će biti dovoljno resursa.
Pri tome, ako analitičari spavaju, i izveštaje niko ne gleda – klasteri se mogu potpuno ugasiti, i prestajete da plaćate za njih.
U međuvremenu, za teške zahteve (od Data Scientists), možete pokrenuti jedan veoma veliki klaster na, recimo, 32 mašine. Ovaj klaster će takođe biti naplaćen samo za one minute i sate kada vaš ogroman zahtev radi.
Ova opisano mogućnost omogućava deljenje klastera ne samo po 2, već po više vrsta opterećenja (ETL, monitoring, materijalizacija izveštaja,…).
Povzemimo Snowflake. Osnova združuje lepo idejo in delujočo implementacijo. V ManyChat uporabljamo Snowflake za analitiko vseh razpoložljivih podatkov. Klasterjev imamo ne tri, kot v primeru, ampak od 5 do 9, različnih velikosti. Imamo nekakšne 16-strojne, 2-strojne, pa tudi super-mahne 1-strojne naprave za nekatere naloge. Uspešno porazdelijo obremenitev in nam omogočajo veliko varčevanje.
Osnova uspešno skalira bralno in pisno obremenitev. To je ogromna razlika in velik preboj v primerjavi z 'Avro', ki je obvladovala le bralno obremenitev. Snowflake omogoča skaliranje s temi izračunskimi klasterji in pisno obremenitev. Tako kot sem omenil, imamo v ManyChatu več klasterjev, majhni in super-mahni klasterji se večinoma uporabljajo za ETL, za nalaganje podatkov. Analitiki pa delujejo na srednjih klasterjih, ki niso obremenjeni z ETL nalogami, zato delujejo zelo hitro.
Zato je osnova dobro primerna za OLAP naloge. Na žalost pa za OLTP obremenitve še ni primerna. Prvič, ta baza je kolonačna, s vsemi iz tega izhajajočimi posledicami. Drugič, sam pristop, ko ob vsakem povpraševanju po potrebi dvignete izračunski klaster in ga napolnite s podatki, je na žalost za OLTP obremenitve še vedno prepočasen. Sekunde čakanja za OLAP naloge so sprejemljive, za OLTP naloge pa nesprejemljive; raje bi imeli 100 ms, še bolje pa 10 ms.
Zaključek
Serverless podatkovna baza je mogoča zaradi razdelitve baze podatkov na Stateless in Stateful dele. Verjetno ste opazili, da v vseh navedenih primerih Stateful del — to je, recimo, shranjevanje mikroparticij v S3, medtem ko je Stateless — optimizator, delo z meta-podatki, obdelava vprašanj varnosti, ki jih je mogoče obravnavati kot neodvisne lahke Stateless storitve.
Izvajanje SQL poizvedb se lahko prav tako dojame kot storitve z lahkim stanjem, ki se lahko pojavijo v brezstrežnem načinu, kot so izračunski klasterji Snowflake, prenesejo samo potrebne podatke, izvedejo poizvedbo in 'ugodijo'.
Serverless baze produkcijske ravni so že na voljo za uporabo, delujejo. Te serverless baze so že pripravljene za obvladovanje OLAP nalog. Na žalost pa pri OLTP nalogah obstajajo… nekatere omejitve, zato se uporabljajo z dodatnimi previdnostmi. Po eni strani je to slabost. Po drugi strani pa je to priložnost. Morda bo kdo med bralci našel način, kako narediti OLTP bazo povsem serverless, brez omejitev Aurora.
Upam, da vam je bilo zanimivo. Serverless prihodnost 🙂
Izvor: habr.com
