

Pri prehodu iz monolitne aplikacije na mikroservisno arhitekturo se soočamo z novimi težavami.
V monolitni aplikaciji je ponavadi dovolj enostavno določiti, v katerem delu sistema je prišlo do napake. Verjetno je težava v samem kodeku monolita ali v podatkovni bazi. Toda ko začnemo iskati težave v mikroservisni arhitekturi, to ni več tako očitno. Treba je najti celotno pot, ki jo je zahtevek prešel od začetka do konca, jo ločiti od stotin mikroservisov. Še posebej, ker imajo številni od njih tudi lastne shrambe, kjer se lahko pojavijo tako logične napake kot tudi težave z zmogljivostjo in odpornostjo na napake.
Dolg časa sem iskal orodje, ki bi mi pomagalo obvladovati take težave (o tem sem pisal na Habr: , ), a na koncu sem ustvaril lastno odprtokodno rešitev. V članku opisujem prednosti pristopa service mesh in delim novo orodje za njegovo izvajanje.
Distribuirano sledenje je razširjena rešitev težave iskanja napak v distribuiranih sistemih. Ampak kaj, če v sistemu še ni uveden tak pristop zbiranja informacij o omrežnih interakcijah, ali, kar je še huje, del sistema ga že uspešno uporablja, v drugem delu pa ne, ker ni bil dodan starim storitvam? Za določitev natančnega koreninskega vzroka težave je nujno imeti celotno sliko tega, kar se dogaja v sistemu. Zelo pomembno je razumeti, kateri mikroservisi sodelujejo v glavnih poslovno kritičnih poteh.
Sem nam lahko pomaga pristop service mesh, ki se bo ukvarjal z vso mehaniko zbiranja omrežnih informacij na ravni, ki je nižja od dela samih storitev. Ta pristop nam omogoča zajemanje celotnega prometa in njegovo analizo v realnem času. In aplikacije o tem pravzaprav ne smejo ničesar vedeti.
Pristop service mesh
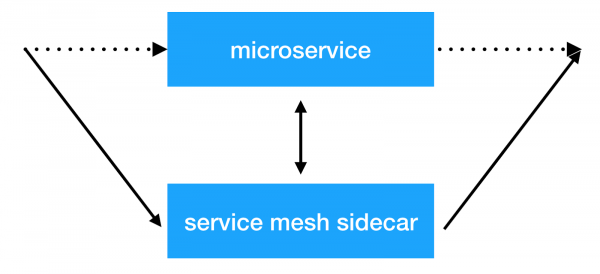
Glavna ideja pristopa service mesh je dodajanje še enega infrastrukturnega sloja nad omrežjem, ki nam omogoča izvajanje različnih nalog z medservisnim interakcijam. Večina implementacij deluje na naslednji način: vsakemu mikroservisu se doda dodaten sidecar kontejner s prosojnim proxyjem, preko katerega poteka ves vhodni in izhodni promet storitve. In tu je točno mesto, kjer lahko izvajamo klientsko uravnoteženje, uporabljamo varnostne politike, uvajamo omejitve glede števila poizvedb in zbiramo pomembne informacije o interakcijah storitev v produkciji.
Rešitve
Obstaja že več implementacij tega pristopa: in . Ponuja številne možnosti že iz škatle. A hkrati s tem pride tudi velika obremenitev virov. Bolj kot je klaster, v katerem deluje tak sistem, več virov bo potrebno za vzdrževanje nove infrastrukture. Na Avitu uporabljamo Kubernetes klastre, ki vsebujejo tisoče primerkov storitev (in njihovo število se še naprej hitro povečuje). V trenutni implementaciji Istio porabi ~300Mb delovne pomnilnika na vsak primer storitve. Zaradi velikega števila možnosti prosojno uravnoteženje vpliva tudi na skupni čas odziva storitev (do 10ms).
Na koncu smo se osredotočili na to, katere možnosti potrebujemo prav zdaj, in se odločili, da je glavni razlog, zaradi katerega smo začeli uvajati takšne rešitve, bila sposobnost prozornega zbiranja tracing informacij iz celotnega sistema. Prav tako smo želeli imeti nadzor nad interakcijami storitev in izvajati različne manipulacije z glavo, ki se prenašajo med storitvami.
Na koncu smo prišli do svoje rešitve: .
Netramesh
— to je lahka rešitev service mesh z možnostjo neskončnega skaliranja ne glede na število storitev v sistemu.
Glavni cilji nove rešitve so bili majhna obremenitev virov in visoka zmogljivost. Med glavnimi možnostmi smo že želeli imeti sposobnost prosojnega pošiljanja tracing span'ov v naš sistem Jaeger.
Danes večina oblačnih rešitev temelji na Golangu. In seveda so za to razlogi. Pisanje omrežnih aplikacij v Golangu, ki delujejo asinhrono z vhodom-izhodom in se po potrebi razširjajo na jedra, je priročno in dovolj preprosto. In kar je prav tako zelo pomembno, je, da je zmogljivost zadostna za reševanje te naloge. Zato smo tudi mi izbrali Golang.
Performansa
Osredotočili smo svoje napore na dosego največje zmogljivosti. Za rešitev, ki se namešča poleg vsake instance storitve, sta potrebna majhna poraba pomnilnika in procesorskega časa. In seveda, zakasnitev pri odgovoru mora biti prav tako majhna.
Poglejmo, kakšni so rezultati.
RAM
Netramesh porabi ~10Mb brez prometa in 50Mb maksimalno pod obremenitvijo do 10000 RPS na eno instanco.
Istio envoy proxy vedno porabi ~300Mb v naših grozdi z več tisoč instancami. To onemogoča njegovo širitev na celoten grozd.
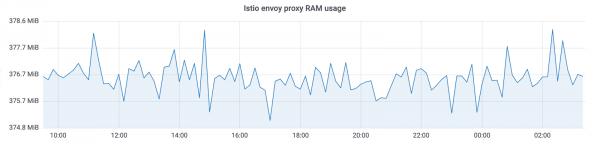
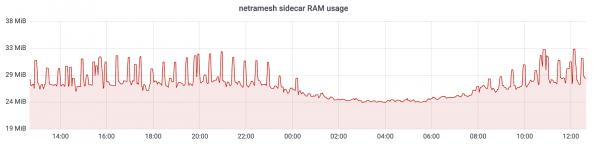
S Netramesh smo dosegli zmanjšanje porabe pomnilnika za ~10-krat.
CPU
Uporaba CPU je relativno enaka pod obremenitvijo. Odvisna je od števila zahtevkov na enoto časa do sidecar. Vrednosti pri 3000 zahtevkih na sekundo v vrhuncu:
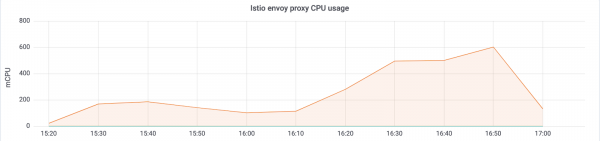
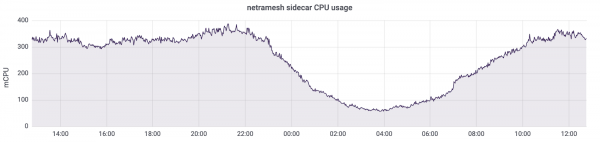
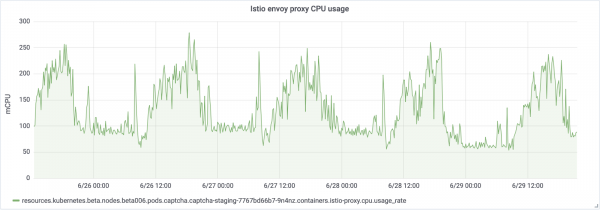
Obstaja še en pomemben vidik: Netramesh je rešitev brez kontrolne plošče in brez obremenitve ne porabi procesorskega časa. Pri Istio sidecarji vedno osvežujejo končne točke storitev. Na koncu vidimo takšno sliko brez obremenitve:
Uporabljamo HTTP/1 za interakcijo med storitvami. Povečanje časa odgovora pri Istio med posredovanjem preko envoy je bilo do 5-10ms, kar je precej veliko za storitve, ki so pripravljene odgovoriti v milisekundi. S Netramesh se je ta čas zmanjšal na 0.5-2ms.
Širljivost
Majhna količina virov, ki jih porabi vsak proxy, omogoča njegovo postavitev poleg vsake storitve. Netramesh je bil namenoma ustvarjen brez komponenta kontrolne plošče za enostavno vzdrževanje lahkotnosti vsakega sidecarja. Pogosto pri rešitvah service mesh kontrolna plošča širi informacije o odkrivanju storitev v vsak sidecar. Skupaj z njimi prihajajo tudi informacije o časovnih omejitvah in nastavitvah uravnoteženja. Vse to omogoča veliko koristnih stvari, a žal povečuje velikost sidecarjev.
Service discovery

Netramesh ne dodaja nobenih dodatnih mehanizmov za odkrivanje storitev. Vsi tokovi se prosto proxyujejo preko netra sidecar.
Netramesh podpira HTTP/1 aplikacijski protokol. Za njegovo določitev se uporablja konfigurabilni seznam vrat. Običajno ima sistem več vrat, preko katerih poteka interakcija po HTTP. Na primer, za interakcijo storitev in zunanjih poizvedb uporabljamo 80, 8890, 8080. V tem primeru jih lahko določimo s pomočjo okoljske spremenljivke. NETRA_HTTP_PORTS.
Če uporabljate Kubernetes kot orkestrator in njegov mehanizem Service za notranje delovanje med storitvami, ostaja mehanizem takšen kot prej. Najprej mikroservis pridobi service IP naslov preko kube-dns in odpre novo povezavo nanj. Ta povezava se najprej vzpostavi z lokalnim netra-sidecarjem in vsi TCP paketi sprva priletijo prav v netra. Potem netra-sidecar vzpostavi povezavo z izvorno destinacijo. NAT na pod IP na nodu ostaja prav tak kot brez netra.
Porazdeljeno sledenje in prenos konteksta
Netramesh zagotavlja funkcionalnost, potrebno za pošiljanje tracing spanov o HTTP interakciji. Netra-sidecar obdeluje HTTP protokol, meri zakasnitve poizvedb, pridobi potrebne informacije iz HTTP glave. Na koncu dobimo vse trace v enotni sistem Jaeger. Za fino konfiguracijo lahko uporabite tudi okoljske spremenljivke, ki jih ponuja uradna knjižnica. .
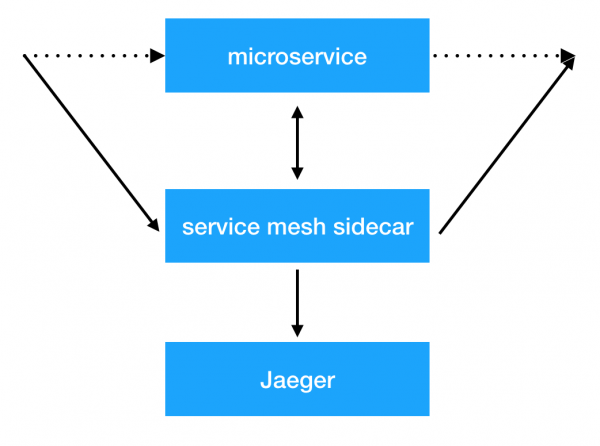
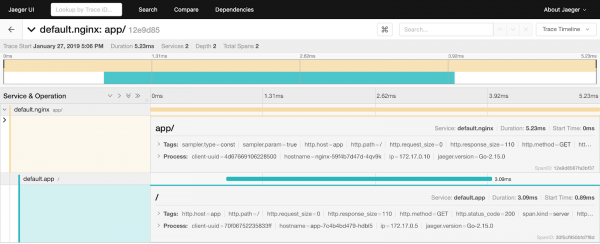
Ampak obstaja težava. Dokler storitve ne bodo generirale in prenašale posebne uber glave, ne bomo videli povezanih tracing spanov v sistemu. In to je tisto, kar potrebujemo za hitro iskanje vzrokov težav. Tukaj ima Netramesh spet rešitev. Proxyji berejo HTTP glave in, če v njih ni uber trace id, ga generirajo. Netramesh prav tako shranjuje informacije o prihajajočih in odhajajočih poizvedbah v sidecarju in jih povezuje z obogatitvijo z potrebnimi glavami odhajajočih poizvedb. Vse, kar morajo storitve storiti, je prenašati eno samo glavo. X-Request-Id, ki jo lahko konfigurirate s pomočjo okoljske spremenljivke. NETRA_HTTP_REQUEST_ID_HEADER_NAME. Za nadzor velikosti konteksta v Netramesh lahko določite naslednje okoljske spremenljivke: NETRA_TRACING_CONTEXT_EXPIRATION_MILLISECONDS (čas, v katerem bo kontekst shranjen) in NETRA_TRACING_CONTEXT_CLEANUP_INTERVAL (periodičnost čiščenja konteksta).
Možno je kombinovať viacero ciest vo vašom systéme označením špeciálnym sedením. Netra umožňuje nastaviť HTTP_HEADER_TAG_MAP na transformáciu HTTP hlavičiek na príslušné tracing span tagy. To môže byť obzvlášť užitočné pri testovaní. Po úspešnom funkčnom teste, je možné skontrolovať, ktorá časť systému bola ovplyvnená, filtrovaním podľa príslušného session kľúča.
Určenie zdroja požiadavky
Na určenie toho, odkiaľ požiadavka pochádza, je možné využiť funkciu automatického pridávania hlavičky so zdrojom. Pomocou premennej prostredia NETRA_HTTP_X_SOURCE_HEADER_NAME je možné nastaviť názov hlavičky, ktorý bude automaticky pridávaný. Pomocou NETRA_HTTP_X_SOURCE_VALUE je možné nastaviť hodnotu, ktorou sa X-Source hlavička nastaví na všetky odchádzajúce požiadavky.
To umožňuje jednotné šírenie tejto užitočnej hlavičky v celej sieti. Ďalej ju je možné využívať v službách a pridávať do logov, metrik.
Routing traffic and internals of Netramesh
Netramesh pozostáva z dvoch hlavných komponentov. Prvý, netra-init, nastavuje sieťové pravidlá na zachytenie prevádzky. Využíva na zachytenie celej alebo časti prevádzky na sidecar, ktorý je druhým hlavným komponentom Netramesh. Je možné nastaviť, ktoré porty treba zachytávať pre prichádzajúce a odchádzajúce TCP relácie: INBOUND_INTERCEPT_PORTS, OUTBOUND_INTERCEPT_PORTS.
Nástroj tiež ponúka zaujímavú funkciu — pravdepodobnostné smerovanie. Ak sa používa Netramesh výhradne na zbieranie tracing span'ov, v produkčnom prostredí je možné ušetriť prostriedky a zapnúť pravdepodobnostné smerovanie pomocou premenných NETRA_INBOUND_PROBABILITY in NETRA_OUTBOUND_PROBABILITY (od 0 do 1). Predvolená hodnota je 1 (zachytáva sa celá prevádzka).
Po úspešnom zachytení netra sidecar nadobúda nové pripojenie a využíva SO_ORIGINAL_DST možnosť socketu na získanie pôvodného cieľa. Potom Netra otvára nové pripojenie k pôvodnej IP adrese a nastavuje obojsmernú TCP komunikáciu medzi stranami, sledujúc celú prechádzajúcu premávku. Ak je port definovaný ako HTTP, Netra sa pokúša o parsovanie a traceovanie. Ak sa parsovanie HTTP nezadarí, Netra prechádza na TCP a transparentne proxyuje bajty.
Izgradnja grafa zavisnosti
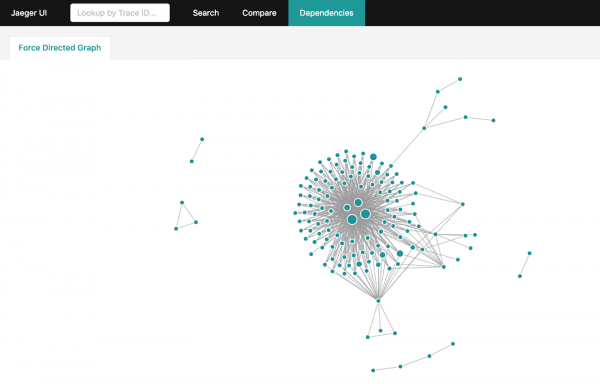
Nakon što dobijete veliku količinu tracing informacija u Jaeger-u, želite dobiti potpuni graf interakcija u sistemu. Međutim, ako je vaš sistem dovoljno opterećen i tokom dana se akumuliraju milijarde tracing span-ova, njihova agregacija postaje prilično složena stvar. Postoji zvanični način za to: . Ipak, to će trajati sate da se izgradi potpuni graf i zahtevaće preuzimanje celog dataset-a iz Jaeger-a za prethodnih 24 sata.
Ako koristite Elasticsearch za skladištenje tracing span-ova, možete se poslužiti , koja će izgraditi sličan graf za par minuta, koristeći posebnosti i mogućnosti Elasticsearch-a.
Kako koristiti Netramesh
Netra se može jednostavno dodati bilo kojoj usluzi koja radi pod upravljanjem bilo kojeg orkestratora. Možete pogledati primer .
Trenutno Netra nema mogućnost automatskog uvođenja sidecar-a u usluge, ali postoje planovi za implementaciju.
Budućnost Netramesh-a
Glavni cilj je postizanje minimalnih troškova resursa i visoke performanse, pružajući osnovne mogućnosti za observability i kontrolu međuservisne interakcije.
U budućnosti Netramesh će dobiti podršku za druge protokole aplikacionog nivoa osim HTTP-a. U skoroj budućnosti biće dostupna mogućnost L7 rutiranja.
Koristite Netramesh ako se suočavate sa sličnim problemima i pišite nam pitanja i predloge.
Izvor: habr.com
