

Takojšnja razlaga naslova članka. Sprva je bilo načrtovano, da bi dali dober, zanesljiv nasvet za pospeševanje uporabe refleksije na preprostem, a realističnem primeru, a med benchmarkiranjem se je izkazalo, da refleksija deluje hitreje, kot sem si mislil, LINQ pa slabše, kot so se mi sanjale. Na koncu se je izkazalo, da sem tudi naredil napako pri merjenju... Podrobnosti te življenjske zgodbe so pod mazalom in v komentarjih. Ker je bil primer dovolj običajen in v bistvu izveden tako, kot se običajno dela v podjetjih, je bila rezultat precej zanimiva, kot se mi zdi, demonstracija življenja: vpliv na hitrost delovanja glavnega predmeta članka ni bil opažen zaradi zunanje logike: Moq, Autofac, EF Core in druge "obroče".
Z delom sem začel pod vtisom tega članka:
Kot je razvidno, avtor predlaga uporabo kompajliranih delegatov namesto neposrednih klicev metod tipov refleksije, kar je odličen način za močno pospešitev delovanja aplikacije. Tam je seveda še IL emisija, vendar bi se ji rad izognil, saj je to najdelovno intenzivnejši način izvajanja naloge, ki je poln napak.
Glede na to, da sem vedno imel podobno mnenje o hitrosti refleksije, nisem nameraval dvomiti v avtorjeve zaključke.
Redno se srečujem z naivno uporabo refleksije v podjetjih. Vzame se tip. Vzame se informacija o lastnosti. Kliče se metoda SetValue, in vsi so veseli. Vrednost je prišla v ciljano polje, vsi so zadovoljni. Ljudje so dokaj pametni — seniorji in vodje ekip — pišejo svoje razširitve na objekt, temelječe na taki naivni implementaciji "univerzalnih" mapperjev enega tipa v drugega. Običajno je zadeva takšna: vzamemo vsa polja, vzamemo vse lastnosti, iteriramo po njih: ob ujemanju imen članov tipa izvedemo SetValue. Občasno naletimo na izjeme na napakah, kjer nismo našli neke lastnosti pri enem izmed tipov, vendar je tudi tukaj izhod, ki izboljšuje zmogljivost. Try/catch.
Vidim, da ljudje izumljajo parserje in mapperje, ne da bi imeli popolne informacije o tem, kako delujejo prej izumljeni kolesi. Vidim, da ljudje skrivajo svoje naivne implementacije za strategijami, za vmesniki, za injekcijami, kot da bi to opravičilo kasnejšo kaos. Od takih implementacij se mi je gnusilo. V resnici, pravega uhajanja zmogljivosti nisem meril, in kadar je bilo mogoče, sem preprosto zamenjal implementacijo z bolj 'optimizirano', če sem imel čas. Zato so me prvi meritvi, o katerih bom govoril spodaj, resno zmedli.
Mislim, da se mnogi od vas, ko berejo Richterja ali druge ideologe, srečujejo s čisto upravičenim trditvijo, da refleksija v kodi zelo negativno vpliva na zmogljivost aplikacije.
Klic refleksije prisili CLR, da prehaja skozi zbirke v iskanju potrebnega, nalaga njihove meta podatke, analizira jih itd. Poleg tega refleksija med prehajanjem zaporedij povzroča alokacijo velike količine pomnilnika. Poraba pomnilnika pomeni, da CLR odpre GC in posledično pride do zatikanja. To bi moralo biti zelo počasno, verjemite. Velike količine pomnilnika sodobnih produkcijskih strežnikov ali oblačnih strojev ne rešujejo visokih zakasnitvah pri obdelavi. Dejstvo je, da več pomnilnika pomeni večje možnosti, da opazite, kako deluje GC. Refleksija je, po ideji, odvečni rdeči krpe zanj.
Kljub temu vsi uporabljamo tako IoC kontejnerje kot tudi podatkovne mapperje, katerih delovanje temelji prav tako na refleksiji, vendar vprašanj glede njihove zmogljivosti običajno ni. Ne, ne zato, ker je uvajanje odvisnosti in abstrakcija od modelov zunanji omejeni kontekst tako nujno, da moramo pri zmogljivosti žrtvovati. Vse je preprostejše – na zmogljivost resnično ne vplivajo tako močno.
Gre za to, da najbolj razširjeni okviri, ki temeljijo na tehnologiji refleksije, uporabljajo vse možne zvijače za optimalnejše delovanje z njo. Običajno gre za predpomnilnik. Običajno – to so Expressions in iz drevesa izrazov skompilirani delegati. Tudi avtomapper ima pod seboj konkurenčni slovar, ki povezuje tipe s funkcijami, ki lahko enega v drugega pretvorijo že brez klica refleksije.
Kako se to postiže? U suštini, ovo se ne razlikuje od logike koju sama platforma koristi za generisanje JIT koda. Prvi put kada se pozove metoda, ona se kompajlira (i, da, ovaj proces nije brz), dok se kod sledećih poziva kontrola prenosi već kompajliranoj metodi, i tu neće biti značajnog pada performansi.
U našem slučaju takođe možemo iskoristiti JIT kompajlaciju i zatim koristiti kompajlirano ponašanje s istim performansama kao i AOT analogi. U tom slučaju pomoći će nam izrazi.
Princip o kojem se radi može se ukratko formulisati na sledeći način:
Treba keširati konačan rezultat rada refleksije u obliku delegata koji sadrži kompajliranu funkciju. Takođe, sve potrebne informacije o tipovima ima smisla keširati u poljima vašeg tipa - radnika, koja se čuvaju van objekata.
U ovoj logici ima nečega. Zdrav razum nam govori da ako nešto može da se kompajlira i kešira, to bi trebalo učiniti.
Imajući u vidu, treba reći da keširanje u radu sa refleksijom ima svoje prednosti, čak i ako se ne koristi predložena metoda kompajlacije izraza. U suštini, ovde ću ponoviti teze autora članka na koji se pozivam gore.
Sada o kodu. Hajde da razmotrimo primer koji je zasnovan na mojoj nedavnoj boli, s kojom sam se suočio u ozbiljnom produkcijskom sistemu ozbiljne kreditne institucije. Sve entitete su izmišljeni, kako niko ne bi pogodio.
Postoji neka entitet. Neka to bude Kontakt. Postoje pisma sa standardizovanim sadržajem, iz kojih parser i hidratator kreiraju te kontakte. Pismo je stiglo, pročitali smo ga, razložili na parove ključ-vrednost, kreirali kontakt i sačuvali u bazi podataka.
To je elementarno. Recimo da kontakt ima svojstva Ime i Prezime, Godine i kontakt telefon. Ovi podaci se prenose u pismu. Takođe, biznis želi da podrška može brzo dodavati nove ključeve za mapiranje svojstava entiteta na parove u telu pisma. Za slučaj da neko napravio grešku u šablonu ili ako je potrebno hitno pokrenuti mapiranje od novog partnera pre puštanja u rad, prilagodivši se novom formatu. Tada novu korelaciju mapiranja možemo dodati kao jeftin data fix. Drugim rečima, primer iz stvarnog života.
Izvaja, ustvarja teste. Deluje.
Kode ne bom prenašal: izvorov je zelo veliko, dostopni pa so na GitHubu preko povezave na koncu članka. Lahko jih prenesete, mučite do neprepoznave in izmerite, kako bi to vplivalo na vaš primer. Prikazal bom le kodo dveh predlog metod, po katerih se razlikujeta hitri hidratator in hidrant, ki bi moral biti počasen.
Logika je naslednja: predlog metoda pridobi pare, oblikovane z osnovno logiko parserja. Raven LINQ je parser in osnovna logika hidratatorja, ki poizveduje v kontekstu baze podatkov in usklajuje ključe s pari iz parserja (za te funkcije je na voljo koda brez LINQ za primerjavo). Nato se pari prenesejo v glavno metodo hidratacije in vrednosti parov nastavijo v ustrezne lastnosti entitete.
»Hiter« (predpona Fast v benchmarkih):
 protected override Contact GetContact(PropertyToValueCorrelation[] correlations)
        {
            var contact = new Contact();
            foreach (var setterMapItem in _proprtySettersMap)
            {
                var correlation = correlations.FirstOrDefault(x => x.PropertyName == setterMapItem.Key);
                setterMapItem.Value(contact, correlation?.Value);
            }
            return contact;
        }
Kot vidimo, se uporablja statična zbirka s setterji lastnosti – skompilirane lambda funkcije, ki kličo setter entitete. Ustvarjene so z naslednjo kodo:
        static FastContactHydrator()
        {
            var type = typeof(Contact);
            foreach (var property in type.GetProperties())
            {
                _proprtySettersMap[property.Name] = GetSetterAction(property);
            }
        }

        private static Action GetSetterAction(PropertyInfo property)
        {
            var setterInfo = property.GetSetMethod();
            var paramValueOriginal = Expression.Parameter(property.PropertyType, "value");
            var paramEntity = Expression.Parameter(typeof(Contact), "entity");
            var setterExp = Expression.Call(paramEntity, setterInfo, paramValueOriginal).Reduce();

            var lambda = (Expression<Action>)Expression.Lambda(setterExp, paramEntity, paramValueOriginal);

            return lambda.Compile();
        }
Na splošno razumljivo. Obhodimo lastnosti, ustvarimo delegate, ki kličejo settere, in jih shranimo. Potem jih pokličemo, ko je treba.
»Počasen« (predpona Slow v benchmarkih):
        protected override Contact GetContact(PropertyToValueCorrelation[] correlations)
        {
            var contact = new Contact();
            foreach (var property in _properties)
            {
                var correlation = correlations.FirstOrDefault(x => x.PropertyName == property.Name);
                if (correlation?.Value == null)
                    continue;

                property.SetValue(contact, correlation.Value);
            }
            return contact;
        }
Tukaj takoj obhodimo lastnosti in neposredno kličemo SetValue.
Za vizualizaciju i kao etalon implementirao sam naivnu metodu koja direktno zapisuje vrednosti njihovih parova korelacije u polja entiteta. Prefiks – Manual.
Sada uzimamo BenchmarkDotNet i istražujemo performanse. I iznenada… (spoiler — to nije tačan rezultat, detalji — u nastavku)
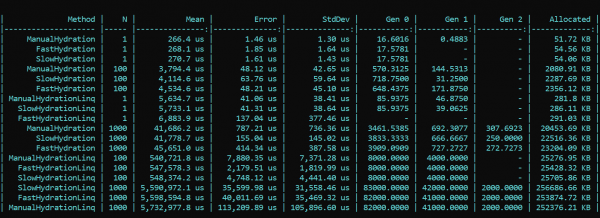
Šta ovde vidimo? Metode koje ponosno nose prefiks Fast, u gotovo svim prolazima, ispostavlja se da su sporije od metoda sa prefiksom Slow. To važi i za alokaciju i za brzinu rada. S druge strane, lepa i elegantna implementacija mapiranja koja koristi svuda gde je moguće, predviđene za to LINQ metode, suprotno tome, značajno smanjuje performanse. Razlika je reda veličine. Tendencija se ne menja s različitim brojem prolaza. Razlika je samo u razmerama. Sa LINQ je 4 — 200 puta sporije, a smeća više otprilike u sličnim razmerama.
AŽURIRANO
Nisam mogao da verujem svojim očima, ali što je važnije, ni mojim očima, ni mom kodu nije verovao naš kolega — . Ponovno proverivši moje rešenje, sjajno je otkrio i ukazao na grešku koju sam zbog niza promena u realizaciji od početne do krajnje propustio. Nakon ispravke pronađenog buga u podešavanjima Moq, svi rezultati su se ispravili. Na osnovu rezultata ponovnog testa osnovna tendencija se ne menja — LINQ i dalje snažnije utiče na performanse nego refleksija. Međutim, drago je da rad sa kompilacijom Expression-a nije uzaludan i da su rezultati vidljivi i po alokaciji i po vremenu izvršenja. Prvo pokretanje, kada se inicijalizuju statička polja, logično je sporije za "brzu" metodu, ali dalje se situacija menja.
Evo rezultata ponovnog testa:
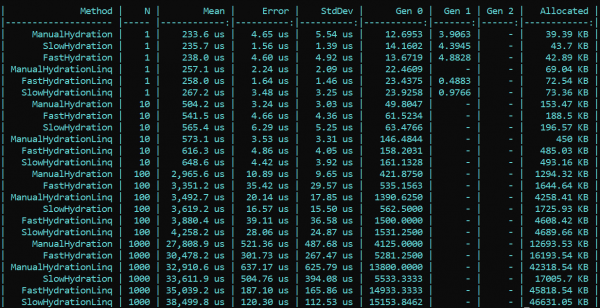
Zaključak: pri korišćenju refleksije u preduzećima, posebna prevara ne mora biti potrebna — LINQ će značajnije smanjiti performanse. Ipak, u metodama sa visokim opterećenjem, koje zahtevaju optimizaciju, možete zadržati refleksiju u obliku inicijalizatora i kompajlera delegata, koji će kasnije omogućiti "brzu" logiku. Tako možete zadržati i fleksibilnost refleksije, i brzinu rada aplikacije.
Kod sa benchmarkom dostupan je ovde. Svi željni mogu ponovo proveriti moje reči:
PS: Koda v testih uporablja IoC, v benchmarkih pa eksplicitno konstrukcijo. Gre za to, da sem v končni izvedbi odstranil vse dejavnike, ki bi lahko vplivali na zmogljivost in zameglili rezultat.
PPS: Hvala uporabniku za odkritje moje napake pri nastavitev Moq, ki je vplivala na prve meritve. Če ima kdo od bralcev dovolj karme, ga prosim, označite s podobnostjo. Oseba se je ustavila, oseba je prebrala, oseba je ponovno preverila in opozorila na napako. Mislim, da si to zasluži spoštovanje in simpatije.
PPPS: hvala tistemu natančnemu bralcu, ki je izpostavil stil in oblikovanje. Prizadevam si za doslednost in udobje. Diplomatičnost predstavitve pušča veliko želja, vendar sem upošteval kritiko. Prosim, gremo naprej.
Izvor: habr.com
