

Do nedavnega je bilo v Odnoklassnikah shranjenih približno 50 TB podatkov, ki so se obdelovali v realnem času, v SQL Serverju. Za tako obsežno količino je skoraj nemogoče zagotoviti hitro, zanesljivo in odpornosti na napake podatkovno središče, ki uporablja SQL DBMS. Običajno v takih primerih uporabijo eno od NoSQL shranjevanj, vendar vsega ni mogoče prenesti v NoSQL: nekateri entiteti zahtevajo zagotovila ACID transakcij.
To nas je pripeljalo do uporabe NewSQL shranjevanja, torej DBMS, ki zagotavlja odpornost na napake, skalabilnost in hitro delovanje NoSQL sistemov, hkrati pa ohranja običajna ACID zagotovila klasičnih sistemov. Delujočih industrijskih sistemov tega novega razreda je malo, zato smo tak sistem razvili sami in ga uvedli v industrijsko uporabo.
Kako to deluje in kaj smo dosegli — preberite spodaj.
Danes mesečna javnost Odnoklassnikov obsega več kot 70 milijonov unikatnih obiskovalcev. Mi največjimi družbenimi omrežji na svetu in v dvajseterici spletnih strani, na katerih uporabniki preživijo največ časa. Infrastruktura 'OK' obdeluje zelo visoke obremenitve: več kot milijon HTTP zahtevkov na sekundo na fronte. Deli strežniškega parka, ki šteje več kot 8000 enot, so nameščeni blizu skupaj — v štirih moskovskih podatkovnih centrih, kar omogoča zagotavljanje omrežne zamude manj kot 1 ms med njimi.
Uporabljamo Cassandro od leta 2010, od različice 0.6. Danes deluje več deset klasterjev. Najhitrejši klaster obdeluje več kot 4 milijone operacij na sekundo, največji pa shranjuje 260 TB.
Vendar so to običajni NoSQL klasterji, ki se uporabljajo za shranjevanje podatkov. Želeli smo zamenjati glavno usklajeno shranjevanje, Microsoft SQL Server, ki se je uporabljal od ustanovitve 'Odnoklassnikov'. Shranjevanje je bilo sestavljeno iz več kot 300 sistemov SQL Server Standard Edition, ki so vsebovali 50 TB podatkov — poslovnih entitet. Ti podatki se spreminjajo v okviru ACID transakcij in zahtevajo .
Za razdelitev podatkov po vozliščih SQL Serverja smo uporabljali tako vertikalno kot horizontalno (sharding). Zgodovina nas je naučila preproste sheme sharding podatkov: vsaki entiteti je bil dodeljen žeton — funkcija ID entitete. Entitete z enakim žetonom so bile nameščene na enem SQL strežniku. Razmerje tipa master-detail je bilo izvedeno tako, da sta bili žetona glavne in podrejene zveze vedno enaki in se nahajali na istem strežniku. V družbenih omrežjih skoraj vse zapise ustvarja uporabnik — to pomeni, da so vsi podatki uporabnika v okviru enega funkcionalnega podsistema shranjeni na enem strežniku. V poslovni transakciji so skoraj vedno sodelovale tabele istega SQL strežnika, kar je omogočalo zagotovitev usklajenosti podatkov s pomočjo lokalnih ACID transakcij, brez potrebe po uporabi porazdeljenih ACID transakcij.
Zaradi sharding in za pospešitev delovanja SQL:
- Ne uporabljamo tujih ključnih omejitev, ker se ob sharding ID entitete lahko nahaja na drugem strežniku.
- Ne uporabljamo shranjenih postopkov in sprožilcev zaradi dodatne obremenitve procesorja DBMS.
- Ne uporabljamo JOIN-ov zaradi vsega zgoraj navedenega in številnih naključnih branj z diska.
- Izven transakcij za zmanjšanje medsebojnega blokiranja uporabljamo raven izolacije Read Uncommitted.
- Izvajamo samo kratke transakcije (v povprečju krajše od 100 ms).
- Ne uporabljamo večvrstnih UPDATE in DELETE zaradi velikega števila medsebojnih blokad - posodabljamo samo eno vrstico.
- Zahteve vedno izvajamo samo po indeksih - zahteva s platenjem za popolno pregledovanje tabele za nas pomeni preobremenitev baze podatkov in njen neuspeh.
Ti koraki so omogočili, da smo iz SQL strežnikov iztisnili skoraj maksimum zmogljivosti. Vendar pa se je težav pojavljalo vse več. Oglejmo si jih.
Težave s SQL
- Ker smo uporabljali lastni sharding, so novi shardi dodajali skrbniki ročno. Vso to čas so razširljive replike podatkov obravnavale zahteve.
- Z rastjo števila zapisov v tabeli se zmanjšuje hitrost vstavljanja in modificiranja, pri dodajanju indeksov obstoječi tabeli se hitrost večkrat zmanjša, ustvarjanje in ponovno ustvarjanje indeksov pa poteka s časom izpada.
- Obstoj majhnega števila Windows za SQL Server v produkciji otežuje upravljanje infrastrukture
Toda največja težava je —
Odporna zasnova
Klasični SQL poslužitelj ima lošu otpornost na kvarove. Pretpostavimo da imate samo jedan server baze podataka, i on otkaže svake tri godine. U tom periodu web stranica ne radi 20 minuta, što je prihvatljivo. Ako imate 64 servera, web stranica ne radi svake tri sedmice. A ako imate 200 servera, web stranica ne radi svake sedmice. To je problem.
Šta se može učiniti za poboljšanje otpornosti na kvarove SQL poslužitelja? Wikipedia nam predlaže da izgradimo : gdje u slučaju otkaza bilo kojeg od komponenti postoji duplikat.
To zahtijeva skup skupog hardvera: brojne duplikate, optička vlakna, skladišta koja se dijele, a i uključivanje rezervi radi nepouzdanosti: oko 10% uključivanja završava otkazom rezervnog čvora koji praća glavni čvor.
No, glavni nedostatak takvog visoko dostupnog klastera je nulta dostupnost u slučaju otkaza data centra u kojem se nalazi. 'Odnoklassniki' imaju četiri data centa, i neophodno je osigurati rad u slučaju potpunog kvara u jednom od njih.
Za to bismo mogli primijeniti replikaciju, ugrađenu u SQL Server. Ovo rješenje je znatno skuplje zbog troškova softvera i pati od dobro poznatih problema s replikacijom — nepredvidivih kašnjenja transakcija pri sinkronoj replikaciji i kašnjenja u primjeni replikacija (i, kao posljedica, izgubljenih modifikacija) pri asinkronoj. Pretpostavljajući čini ovu opciju potpuno neprihvatljivom za nas.
Svi ovi problemi zahtijevali su radikalno rješenje i započeli smo s detaljnom analizom. Ovdje se trebamo upoznati s onim što SQL Server u suštini radi — transakcijama.
Jednostavna transakcija
Razmotrićemo najjednostavniju, s aspekta aplikacijskog SQL programera, transakciju: dodavanje fotografije u album. Albumi i fotografije se čuvaju u različitim tabelama. Album ima brojač javnih fotografija. Tada se ta transakcija razlaže na sljedeće korake:
- Zaključavamo album po ključu.
- Kreiramo zapis u tabeli fotografija.
- Ako fotografija ima javni status, povećavamo brojač javnih fotografija u albumu, ažuriramo zapis i potvrđujemo transakciju.
Ili u obliku pseudokoda:
TX.start("Albums", id);
Album album = albums.lock(id);
Photo photo = photos.create(…);

if (photo.status == PUBLIC) {
    album.incPublicPhotosCount();
}
album.update();

TX.commit();
Vidimo, da je najpogostejši scenarij poslovne transakcije — branje podatkov iz baze podatkov v pomnilnik strežnika aplikacij, nekaj spremeniti in shraniti nove vrednosti nazaj v bazo podatkov. Običajno v taki transakciji posodobimo več entitet, več tabel.
Med izvajanjem transakcije lahko pride do konkurenčne modifikacije istih podatkov iz drugega sistema. Na primer, Antispam lahko ugotovi, da je uporabnik nekako sumljiv in zato vse fotografije uporabnika ne bi smele biti več javne, treba bi jih bilo poslati na moderacijo, kar pomeni, da je treba spremeniti photo.status na nek drug vrednost in ustrezno posodobiti števce. Očitno je, da če bo ta operacija potekala brez garancij atomarnosti in izolacije konkurirajočih modifikacij, kot v , bo rezultat vsekakor neustrezal — ali bo števec fotografij prikazoval napačno vrednost, ali pa ne bodo vse fotografije poslane na moderacijo.
Takšnega kodeksa, ki manipulira z različnimi poslovnimi entitetami v okviru ene transakcije, je bilo v vsem obdobju obstoja Odnoklassnikov napisanega zelo veliko. Po izkušnjah migracij na NoSQL z vemo, da največje težave (in časovne obremenitve) povzroča potreba po razvijanju kode, usmerjene v vzdrževanje skladnosti podatkov. Zato smo glavne zahteve za novo skladišče šteli za zagotavljanje pravih ACID transakcij za aplikacijsko logiko.
Druge, prav tako pomembne, zahteve so bile:
- Ob odpovedi podatkovnega centra morata biti dostopna tako branje kot pisanje v novo skladišče.
- Ohranitev trenutne hitrosti razvoja. To pomeni, da bi moralo biti pri delu z novim skladiščem količina kode približno enaka, ne bi smelo biti potrebe po dodajanju nečesa v skladišče, razvijanju algoritmov za reševanje konfliktov, vzdrževanju sekundarnih indeksov itd.
- Hitrost delovanja novega skladišča mora biti dovolj visoka, tako pri branju podatkov kot pri obdelavi transakcij, kar učinkovito pomeni neprimernost akademsko strogih, univerzalnih, a počasnih rešitev, kot so na primer .
- Samodejno prilagajanje v realnem času.
- Uporaba običajnih poceni strežnikov, brez potrebe po nakupu eksotične opreme.
- Možnost razvoja shrambe z viri podjetja. Z drugimi besedami, prednostso se lahko dajo lastnim ali odprtokodnim rešitvam, najbolje na Java.
Rešitve, rešitve
Analizirajoč možne rešitve, smo prišli do dveh možnih arhitektur:
Prva je, da vzamemo katerikoli SQL strežnik in realiziramo potrebno odpornost na napake, mehanizem prilagajanja, odpornost na napake grozd, reševanje konfliktov in distribuirane, zanesljive in hitre ACID transakcije. To možnost smo ocenili kot precej nenavadno in delovno zahtevno.
Druga možnost je, da vzamemo pripravljeno NoSQL shrambo z realiziranim prilagajanjem, odpornim grozdom na napake, reševanjem konfliktov in sami realiziramo transakcije in SQL. Na prvi pogled se zdi naloga realizacije SQL, čeprav ne omenjamo ACID transakcij, naloga, ki traja leta. A nato smo spoznali, da je skupek možnosti SQL, ki jih dejansko uporabljamo, daleč od ANSI SQL, prav tako daleč kot daleč od ANSI SQL. Ko smo se še bolj pozorno ozrli na CQL, smo spoznali, da je dovolj blizu temu, kar potrebujemo.
Cassandra in CQL
Torej, kaj je zanimivega pri Cassandri, kakšne možnosti ponuja?
Prvič, tukaj lahko ustvarjate tabele s podporo za različne tipe podatkov, lahko izvajate SELECT ali UPDATE po primarnem ključi.
CREATE TABLE photos (id bigint KEY, owner bigint,…);
SELECT * FROM photos WHERE id=?;
UPDATE photos SET … WHERE id=?;
Za zagotavljanje skladnosti podatkov replik, Cassandra uporablja V najpreprostejšem primeru to pomeni, da se pri postavitvi treh replik iste vrstice na različnih vozlih grozda, zapis šteje za uspešen, če večina vozlov (t.j. dva od treh) potrdi uspešnost te operacije zapisa. Podatki vrstice se štejejo za usklajene, če so ob branju večina vozlov bila anketirana in so potrdila. Tako se pri treh replikah zagotavlja popolna in takojšnja usklajenost podatkov v primeru odpovedi enega vozla. Ta pristop nam je omogočil, da smo implementirali še bolj zanesljivo shemo: vedno pošiljamo zahteve na vse tri replike, pri čemer čakamo na odgovor dveh najhitrejših. Pozno odgovorjena tretja replika se v tem primeru zavrže. Vozlo, ki je pozno odgovorilo, lahko ima resne težave — zastoji, zbiranje smeti v JVM, zajemanje neposredne pomnilniške enote v jedru linuxa, okvara strojne opreme, odklop od omrežja. Vendar na operacijo stranke in na podatke to ne vpliva na noben način.
Pristop, ko se obračamo na tri vozle, a prejmemo odgovor od dveh, se imenuje : zahteva za odvečne replike se pošlje preden ‘odstopi’.
Še ena od prednosti Cassandre je Batchlog — mehanizem, ki jamči bodisi popolno izvajanje bodisi popolno neizvajanje paketa vaših sprememb. To nam omogoča reševanje A v ACID — atomarnost iz škatle.
Najbližje transakcijam v Cassandri so tako imenovane«. Vendar so od ‘pravi’ ACID-transakcij daleč: v resnici je to možnost izvesti na podatkih samo enega zapisa, s soglasjem po težkem protokolu Paxos. Zaradi tega je hitrost takih transakcij majhna.
Česar nam je primanjkovalo v Cassandri
Torej, morali smo v Cassandri implementirati prave ACID-transakcije. S katerimi bi zlahka uresničili dve drugi uporabni funkciji klasičnih DBMS: dosledne hitre indekse, kar bi nam omogočilo iskanje podatkov ne le po primarnem ključu in običajni generator monotone samodejno povečanih ID-jev.
C*One
Tako je nastala nova SODB C*One, ki je sestavljena iz treh tipov strežniških vozlov:
- Shranjevanja — (skoraj) standardni strežniki Cassandre, odgovorni za shranjevanje podatkov na lokalnih diskih. Z naraščanjem obremenitve in obsega podatkov je njihovo število mogoče enostavno razširiti na desettisoče in stotine.
- Koordinatori transakcija - osiguravaju izvršenje transakcija.
- Klijenti - serveri aplikacija koji realizuju poslovne operacije i iniciraju transakcije. Takvih klijenata može biti na hiljade.
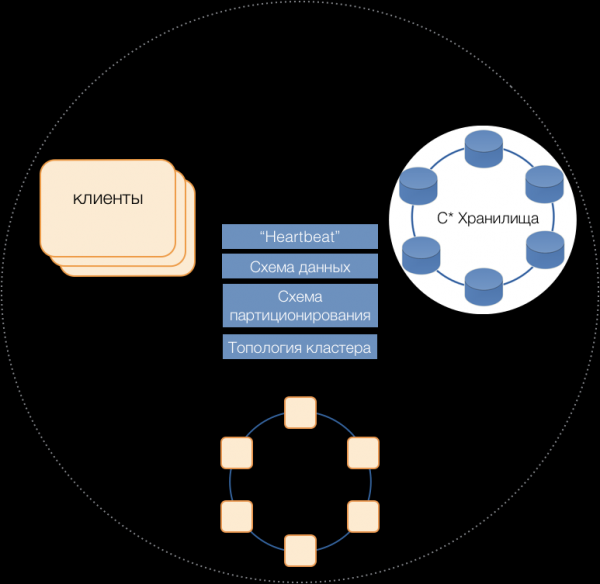
Serveri svih tipova su deo zajedničkog klastera, koriste unutrašnji protokol poruka Cassandra za međusobnu komunikaciju i za razmenu klasterskih informacija. Pomoću Heartbeat-a serveri saznaju o međusobnim kvarovima, održavaju jedinstvenu šemu podataka - tabele, njihovu strukturu i replikaciju; šemu particionisanja, topologiju klastera itd.
Klijenti
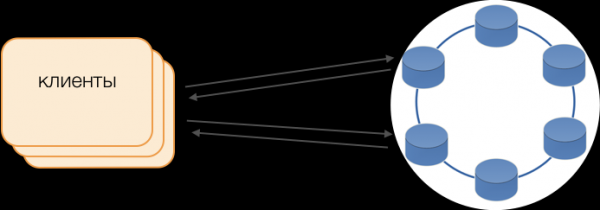
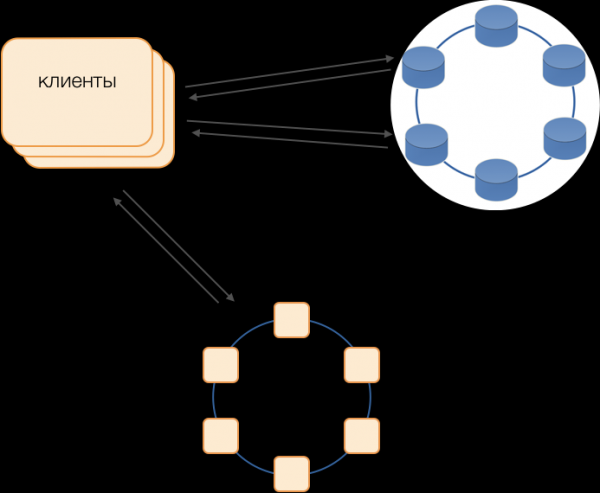
Umesto standardnih drajvera koristi se režim Fat Client. Ova nod ne čuva podatke, ali može da deluje kao koordinator izvršenja zahteva, što znači da klijent sam obavlja funkciju koordinatora svojih zahteva: ispituje replikate skladišta i rešava sukobe. Ovo je ne samo pouzdanije i brže od standardnog drajvera, koji zahteva komunikaciju sa udaljenim koordinatorom, već i omogućava upravljanje prenosom zahteva. Van otvorene transakcije na klijentu, zahtevi se šalju u skladišta. Ukoliko klijent otvori transakciju, svi zahtevi u okviru transakcije se šalju koordinatoru transakcija.
Koordinator transakcija C*One
Koordinator je ono što smo realizovali za C*One od nule. On je odgovoran za upravljanje transakcijama, zaključavanjima i redosledom primene transakcija.
Za svaku obrađenu transakciju koordinator generiše vremensku oznaku: svaka naredna je veća od prethodne transakcije. Pošto je u Cassandri sistem rešavanja sukoba zasnovan na vremenskim oznakama (od dve sukobljene evidencije, aktuelna se smatra onom sa kasnijom vremenskom oznakom), sukob će uvek biti rešen u korist naredne transakcije. Tako smo realizovali — jeftin način rešavanja sukoba u distribuiranom sistemu.
Zaključavanja
Za obezbeđivanje izolacije odlučili smo se za najjednostavniji pristup - pesimistička zaključavanja po primarnom ključu evidencije. Drugim rečima, u transakciji, evidenciju je potrebno prvo zaključati, pa tek onda pročitati, modifikovati i sačuvati. Samo nakon uspešnog komita evidencija može biti otključana, kako bi konkurentske transakcije mogle da je koriste.
Implementacija takve blokade je jednostavna u nerazdeljenom okruženju. U distribuiranom sistemu postoje dva glavna pristupa: ili realizovati distribuiranu blokadu u klasteru, ili raspodeliti transakcije tako da se transakcije koje uključuju jedan zapis uvek obrađuju od istog koordinatora.
Pošto su u našem slučaju podaci već raspodeljeni po grupama lokalnih transakcija u SQL-u, odlučeno je da se koordinatorima dodele grupe lokalnih transakcija: jedan koordinator izvršava sve transakcije sa tokenom od 0 do 9, drugi - sa tokenom od 10 do 19, i tako dalje. Kao rezultat, svaki od instanci koordinatora postaje glavni za grupu transakcija.
Tada se blokade mogu realizovati u obliku običnog HashMap-a u memoriji koordinatora.
Greške koordinatora
Pošto jedan koordinator isključivo obrađuje grupu transakcija, veoma je važno brzo utvrditi njegovu grešku kako bi ponovno pokušavanje izvršenja transakcije stalo u vremenski okvir. Da bi to bilo brzo i pouzdano, primenili smo protokol potpunog povezanog kvorumskog heartbeat-a:
U svakom data centru se nalazi najmanje dve čvora koordinatora. Periodično, svaki koordinator šalje heartbeat poruku ostalim koordinatorima i izveštava ih o svom funkcionisanju, kao i o tome koje heartbeat poruke od kojih koordinatora u klasteru je primio poslednji put.
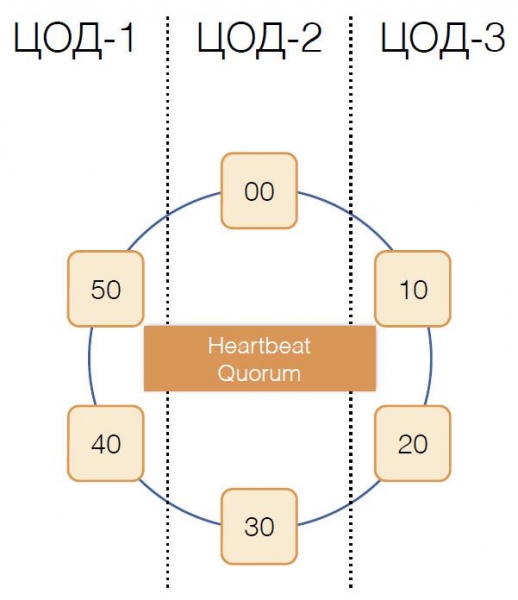
Primajući slične informacije od ostalih u sastavu svojih heartbeat poruka, svaki koordinator odlučuje za sebe koje čvorove klastera funkcionišu, a koje ne, oslanjajući se na princip kvoruma: ako je čvor X primio od većine čvorova u klasteru informaciju o normalnom prijemu poruka sa čvora Y, to znači da Y radi. I obrnuto, čim većina izvesti o gubitku poruka sa čvora Y, to znači da je Y otkazao. Zanimljivo je da ako kvorum obavesti čvor X da ne prima više poruka od njega, sam čvor X će smatrati da je otkazao.
Heartbeat sporočila se pošiljajo z veliko frekvenco, približno 20-krat na sekundo, s časovnim intervalom 50 ms. V Javi je težko zagotoviti odzivnost aplikacije v 50 ms zaradi primerljive dolžine zamud, ki jih povzroča zbiralnik odpadkov. Uspešno smo dosegli to odpoved z uporabo zbiralnika odpadkov G1, ki omogoča določitev cilja glede dolžine zamud GC. Vendar pa včasih, zelo redko, zamude zbiralnika presegajo 50 ms, kar lahko privede do napačne zaznave okvare. Da bi to preprečili, koordinator ne poroča o okvari oddaljene vozlišča po izgubi prvega heartbeat sporočila od njega, temveč le, če jih je več zaporednih. Tako smo uspeli doseči zaznavanje okvare vozlišča koordinatorja v 200 ms.
Toda hitro razumeti, katero vozlišče je prenehalo delovati, ni dovolj. Potrebno je nekaj storiti glede tega.
Rezervacija
Klasična shema predvideva, da se v primeru okvare vodje izvedejo volitve novega z enim od algoritmov. Vendar pa imajo podobni algoritmi dobro znane težave s konvergenco v času in dolžino samega procesa volitev. Dodatnih zamud smo se uspeli izogniti s shemo zamenjave koordinatorjev v popolnoma povezani mreži:
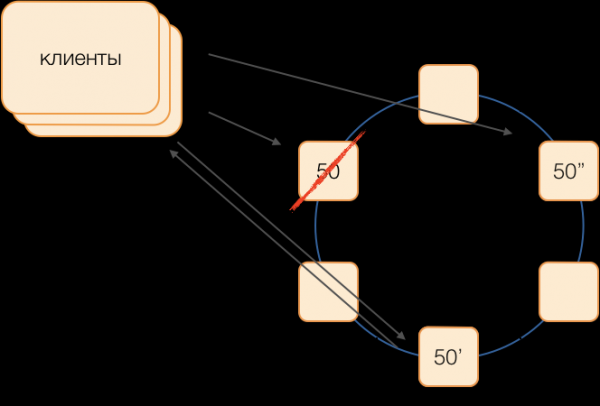
Recimo, da želimo izvesti transakcijo v skupini 50. Vnaprej določimo shemo zamenjave, tj. katera vozlišča bodo izvajala transakcije skupine 50 v primeru okvare glavnega koordinatorja. Naš cilj je ohraniti delovanje sistema v primeru okvare podatkovnega centra. Določimo, da bo prva rezerva vozlišče iz drugega podatkovnega centra, druga rezerva pa vozlišče iz tretjega. Ta shema se določi enkrat in ne spremeni, dokler se topologija klasterja ne spremeni, t.j. dokler v njem ne pridejo nova vozlišča (kar se zgodi zelo redko). Postopek izbire novega aktivnega vodje ob okvari starega bo vedno tak: aktivni vodja postane prva rezerva, če pa ta preneha delovati, postane druga rezerva.
Takšna shema je zanesljivejša od univerzalnega algoritma, saj je za aktivacijo novega vodje dovolj ugotoviti dejstvo okvare starega.
Kako će klijenti znati koji majstor trenutno radi? U 50 ms nije moguće poslati informacije hiljadama klijenata. Moguće je da klijent pošalje zahtev za otvaranje transakcije, a da ne zna da taj majstor već ne funkcioniše, i zahtev će se zadržati na vremenskom isteku. Da se to ne bi desilo, klijenti spekulativno šalju zahtev za otvaranje transakcije direktno majstoru grupe i oba njegova rezervna majstora, ali na taj zahtev će odgovoriti samo onaj koji je trenutno aktivan. Svaku dalju komunikaciju u okviru transakcije klijent će voditi samo sa aktivnim majstorom.
Rezervni majstori primljene zahteve za ne svoje transakcije smeštaju u red nerotnih transakcija, gde se čuvaju neko vreme. Ako aktivni majstor umre, novi majstor obrađuje zahteve za otvaranje transakcija iz svog reda i odgovara klijentu. Ako je klijent već uspeo da otvori transakciju sa starim majstorom, tada se drugi odgovor ignoriše (i, očigledno, takva transakcija se neće završiti i biće ponovljena od strane klijenta).
Kako funkcioniše transakcija
Pretpostavimo da je klijent poslao koordinatoru zahtev za otvaranje transakcije za određeni entitet sa određenim primarnih ključem. Koordinator blokira tu entitet i smešta je u tabelu blokada u memoriji. Ako je potrebno, koordinator čita tu entitet iz skladišta i čuva dobijene podatke u stanje transakcije u memoriji koordinatora.
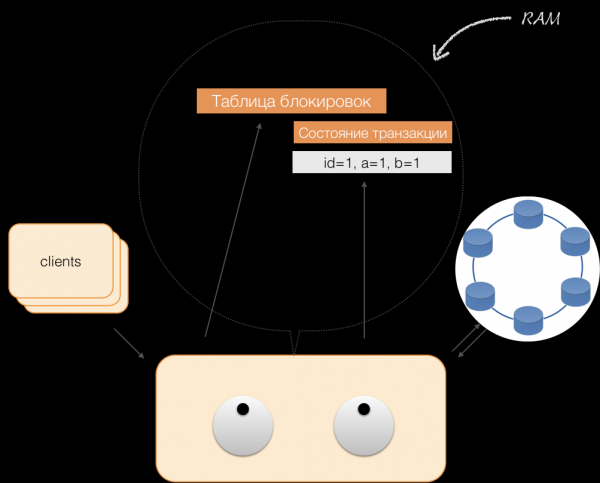
Kada klijent želi da izmeni podatke u transakciji, šalje koordinatoru zahtev za modifikaciju entiteta, a on smešta nove podatke u tabelu stanja transakcija u memoriji. Na tome je zapis završen — zapis u skladištu se ne vrši.
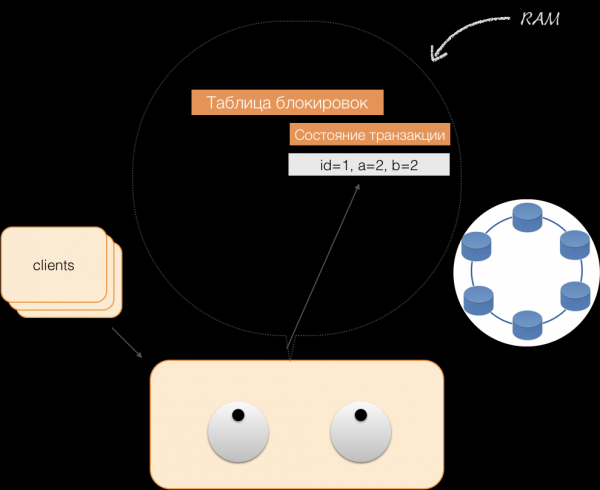
Kada klijent traži u okviru aktivne transakcije svoje izmenjene podatke, koordinator postupa ovako:
- ako ID već postoji u transakciji, podaci se uzimaju iz memorije;
- ako ID nije u memoriji, nedostajući podaci se čitaju iz nodova skladišta, kombinuju sa onima koji su već u memoriji, i rezultat se vraća klijentu.
Tako klijent može pročitati svoje promene, a drugi klijenti te promene ne vide, jer se čuvaju samo u memoriji koordinatora, a u nodovima Cassandre ih još nema.
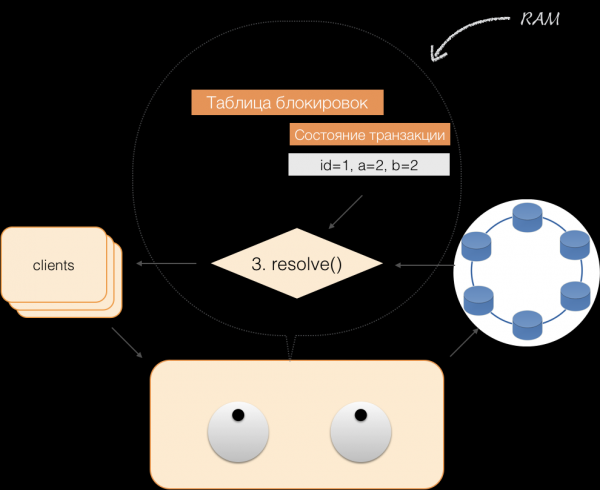
Ko klient pošlje commit, stanje, ki je bilo v pomnilniku storitve, shrani koordinator v logged batch, ki se nato pošlje v skladišča Cassandra. Skladišča opravijo vse potrebno, da se ta paket atomarno (popolno) uporabi in vrnejo odgovor koordinatorju, ki nato sprosti zaklepe in potrdi uspešnost transakcije klientu.
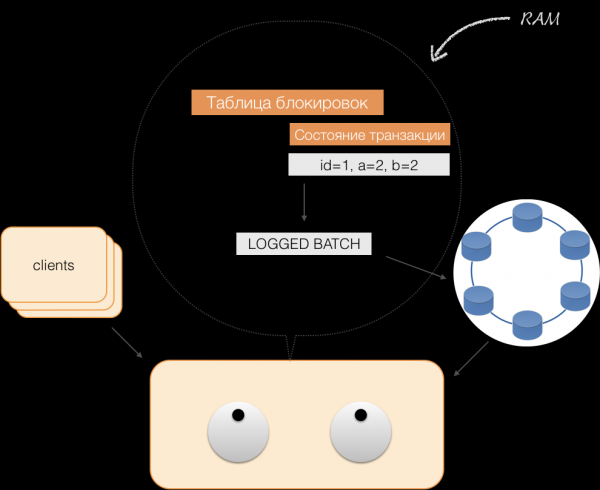
Za povrat je koordinatorju dovolj, da sprosti pomnilnik, zaseden s stanjem transakcije.
Kot rezultat zgoraj opisanih izboljšav smo implementirali načela ACID:
- Atomarnost. To je zagotovilo, da nobena transakcija ne bo delno zabeležena v sistemu; izvedene bodo bodisi vse njene podoperacije bodisi nobena. Ta princip pri nas upoštevamo z logged batch v Cassandri.
- Konsistenca. Vsaka uspešna transakcija po definiciji zabeleži le dovoljene rezultate. Če po odprtju transakcije in izvedbi dela operacij ugotovimo, da je rezultat nedovoljen, se izvede povrat.
- Izolacija. Pri izvajanju transakcije paralelne transakcije ne smejo vplivati na njen rezultat. Konkurenčne transakcije so izolirane z uporabo pesimističnih zaklepov na koordinatorju. Za branja zunaj transakcije se upošteva načelo izolacije na ravni Read Committed.
- Trdnost. Ne glede na težave na spodnjih ravneh — izpad napajanja, okvara opreme — spremembe, ki jih je uspešno zaključila transakcija, morajo ostati shranjene po ponovnem zagonu delovanja.
Branje po indeksih
Vzemimo preprosto tabelo:
CREATE TABLE photos (
id bigint primary key,
owner bigint,
modified timestamp,
…)
Ima ID (prvi ključ), lastnika in datum spremembe. Treba je izvesti zelo preprost poizvedbo — izbrati podatke po lastniku s datumom spremembe "v zadnjih 24 urah".
SELECT *
WHERE owner=?
AND modified>?
Da se tako poizvedba hitro izvede, je v klasičnem SQL DBMS potrebno zgraditi indeks po stolpcih (owner, modified). To lahko storimo dovolj enostavno, saj imamo zdaj jamstva ACID!
Indeksi v C*One
Imamo izvirno tabelo s fotografijami, kjer je ID zapisa primarni ključ.
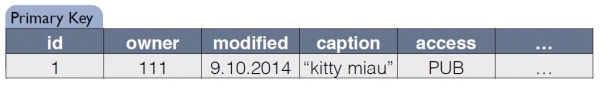
Za indeks C*One se stvara nova tabela koja je kopija izvorne. Ključ se poklapa sa indeksnim izrazom, pri čemu uključuje i primarni ključ zapisa iz izvorne tabele:
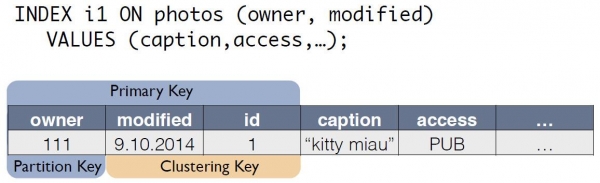
Sada se upit po 'vlasniku za poslednjih 24 sata' može prepraviti kao select iz druge tabele:
SELECT * FROM i1_test
WHERE owner=?
AND modified>?
Konzistentnost podataka izvorne tabele photos i indeksne i1 automatski održava koordinator. Na osnovu samo šeme podataka prilikom primanja promene, koordinator generiše i pamti promenu ne samo glavne tabele, već i promene kopija. Nema dodatnih radnji sa tabelom indeksa, logovi se ne čitaju, zaključavanja se ne koriste. To znači da dodavanje indeksa gotovo ne troši resurse i praktično ne utiče na brzinu primene modifikacija.
Pomoću ACID-a uspeli smo da implementiramo indekse 'kao u SQL-u'. Oni imaju konzistenciju, mogu se skalirati, brzo rade, mogu biti složeni i ugrađeni su u CQL jezik upita. Za podršku indeksima nije potrebno menjati aplikativni kod. Sve je jednostavno, kao u SQL-u. I što je najvažnije, indeksi ne utiču na brzinu izvršavanja modifikacija izvorne tabele transakcija.
Šta je postignuto
Razvili smo C*One pre tri godine i pokrenuli ga u proizvodnoj upotrebi.
Šta smo dobili na kraju? Procijenimo to na primeru podsistema za obradu i skladištenje fotografija, jednog od najvažnijih tipova podataka u društvenoj mreži. Radi se ne o samim telima fotografija, već o raznim metainformacijama. Trenutno u 'Odnoklassnikima' ima oko 20 milijardi takvih zapisa, sistem obrađuje 80 hiljada upita za čitanje u sekundi, do 8 hiljada ACID transakcija u sekundi, povezanih sa modifikacijom podataka.
Kada smo koristili SQL sa replication factor = 1 (ali u RAID 10), metainformacije o fotografijama su se čuvale na visoko dostupnom klasteru od 32 mašine sa Microsoft SQL Server (plus 11 rezervnih). Takođe je bilo dodeljeno 10 servera za čuvanje rezervnih kopija. Ukupno 50 skupih mašina. Pri tome je sistem radio pod nominalnim opterećenjem, bez rezerve.
Po migraciji na novi sistem dobili smo faktor replikacije = 3 — po jedna kopija u svakom data centru. Sistem se sastoji od 63 nodova za skladištenje Cassandre i 6 mašina koordinatora, ukupno 69 servera. Međutim, ove mašine su znatno jeftinije, a ukupni trošak iznosi oko 30 % troška SQL sistema. U međuvremenu, opterećenje se održava na nivou od 30 %.
Uvođenjem C*One smanjene su i latencije: u SQL-u operacija upisa je trajala oko 4,5 ms. U C*One — oko 1,6 ms. Trajanje transakcije u proseku je manje od 40 ms, komit se izvršava za 2 ms, a trajanje čitanja i upisa — u proseku 2 ms. 99. percentile su svega 3-3,1 ms, a broj vremenskih prekida smanjen je 100 puta — sve zahvaljujući širokoj primeni spekulacija.
Trenutno je veća partija nodova SQL Servera izbačena iz eksploatacije, nove proizvode razvijamo samo uz korišćenje C*One. Prilagodili smo C*One za rad u našem oblaku. , što je omogućilo brže postavljanje novih klastera, pojednostavilo konfiguraciju i automatizovalo eksploataciju. Bez izvorne šifre, to bi bilo znatno složenije i klimavije.
Trenutno radimo na prebacivanju drugih naših skladišta u oblak — ali to je već sasvim druga priča.
Izvor: habr.com
