

To je članek prevod moje objave na medium — , ki je bila precej priljubljena, verjetno zaradi svoje preprostosti. Zato sem se odločil, da jo napišem tudi v slovenščini in nekoliko dopolnim, da bi preprosti osebi, ki ni strokovnjak za podatke, postalo jasno, kaj je skladišče podatkov (DW), kaj pa podatkovno jezero (Data Lake) in kako skupaj sobivata.
Zakaj sem hotel napisati o podatkovnem jezeru? Z podatki in analitiko delam že več kot 10 let, trenutno pa delam s skupnimi podatki pri Amazon Alexa AI v Cambridgeu, ki je blizu Bostonu, čeprav živim v Victorii na otoku Vancouver in pogosto sem tudi v Bostonu, Seattlu ter Vancouverju, včasih celo v Moskvi, kjer nastopam na konferencah. Tudi občasno pišem, a večinoma v angleščini, in že sem napisal , poleg tega imam potrebo, da delim trende analitike iz Severne Amerike, zato občasno pišem tudi v .
Vedno sem delal s skladišči podatkov, od leta 2015 pa intenzivno sodelujem z Amazon Web Services, sploh sem se preusmeril na oblačno analitiko (AWS, Azure, GCP). Spremljal sem evolucijo rešitev za analitiko od leta 2007 in sam sem celo delal pri ponudniku skladišč podatkov Teradata ter jo implementiral v Sberbanki, takrat se je pojavila Big Data z Hadoopom. Vsi so govorili, da je era skladišč minila in da zdaj vsi delajo na Hadoopu, nato so začeli govoriti o podatkovnih jezerih, spet so trdili, da je zdaj za skladišče podatkov končno konec. A na srečo (morda za nekatere pa nesrečo, ki so zaslužili veliko denarja s postavitvijo Hadoopa) skladišče podatkov ni izginilo.
V tem članku bomo preučili, kaj je podatkovno jezero. Članek je namenjen ljudem, ki imajo malo ali nič izkušenj s skladišči podatkov.
Na sliki je Bledsko jezero, to je eno mojih najljubših jezer, čeprav sem bil tam le enkrat, vendar sem si ga zapomnil za vse življenje. A govorili bomo o drugem tipu jezera — podatkovnem jezeru. Mnogi med vami so že slišali ta izraz, toda še ena definicija ne bo škodila.
Prvič, tukaj so najbolj priljubljene definicije podatkovnega jezera:
"datotečno skladišče vseh tipov surovih podatkov, ki so na voljo za analizo komur koli v organizaciji" — Martin Fowler.
„Če menite, da je podatkovna vitrina steklenica vode — filtrirane, zapakirane in razdeljene za udobno uporabo, pa je jezero podatkov ogromna rezervoar vode v njeni naravni obliki. Uporabniki lahko nabirajo vodo zase, potapljajo se v globine in raziskujejo“ — James Dickinson.
Zdaj natančno vemo, da je jezero podatkov o analitiki, omogoča nam shranjevanje velikih količin podatkov v njihovem izvirnem stanju in imamo potreben in priročen dostop do podatkov.
Radi imam, da poenostavim stvari; če lahko zapleten termin razložim s preprostimi besedami, potem sem sam razumel, kako deluje in zakaj je to pomembno. Tako sem nekoč raziskoval svoj iPhone v fotogaleriji in spoznal, da je to pravo jezero podatkov, celo naredil sem diapozitiv za konference:
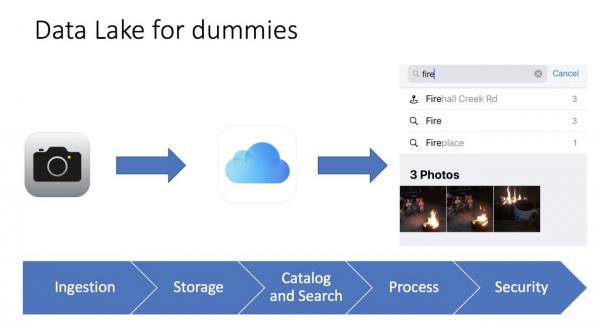
Vse je zelo preprosto. Fotografiramo s telefonom, slika se shrani na telefon in lahko se shrani v iCloud (oblačno shranjevanje). Telefon tudi zbira metapodatke fotografije: kaj je na sliki, geolokacija in čas. Kot rezultat lahko uporabimo priročen vmesnik iPhona, da najdemo našo sliko in pri tem vidimo kazalnike; na primer, ko iščem slike s besedo ogenj (fire), najdem 3 slike z ognjem. Zame je to kot orodje Business Intelligence, ki deluje zelo hitro in natančno.
In seveda ne smemo pozabiti na varnost (avtorizacijo in autentifikacijo), sicer lahko naši podatki enostavno pridejo v javni dostop. Veliko novic je o velikih korporacijah in startupih, katerih podatki so prišli v javni dostop zaradi malomarnosti razvijalcev in nespoštovanja preprostih pravil.
Tudi taka preprosta slika nam pomaga ponazoriti, kaj je jezero podatkov, njegove razlike od tradicionalnega skladišča podatkov in njegove glavne elemente:
- Načítání dat (Ingestion) — ključna komponenta jezera podatkov. Podatki v skladišče lahko pridejo na dva načina — batch (naložitev z intervali) in streaming (podatkovni tok).
- Oblačno shranjevanje (Storage) — glavna komponenta jezera podatkov. Potrebno je, da je skladišče enostavno razširljivo, izjemno zanesljivo in ima nizke stroške. Na primer, v AWS je to S3.
- Katalog in Iskanje (Katalog i Iskanje) — da se izognemo Zaplati Podatkov (kar pomeni, da vse podatke zmešamo v eno kup, kar onemogoča delo z njimi), moramo ustvariti sloj meta-podatkov za klasifikacijo podatkov, da uporabniki enostavno najdejo podatke, ki jih potrebujejo za analizo. Dodatno lahko uporabimo dodatne rešitve za iskanje, kot je ElasticSearch. Iskanje uporabnikom olajša iskanje potrebnih podatkov prek enostavnih vmesnikov.
- Obdelava (Postopek) — ta korak je odgovoren za obdelavo in transformacijo podatkov. Lahko transformiramo podatke, spreminjamo njihove strukture, jih očistimo in še veliko več.
- Sigurnost (Varnost) — pomembno je, da namenimo čas za oblikovanje varnosti rešitve. Na primer, šifriranje podatkov med shranjevanjem, obdelavo in prenosom. Uporabiti je treba metode avtentikacije in avtorizacije. Na koncu potrebujemo orodje za revizijo.
Z praktičnega vidika lahko podatkovno jezero opišemo s tremi atributi:
- Zberite in shranite karkoli — podatkovno jezero vsebuje vse podatke, tako nepredelane surove podatke za katerokoli časovno obdobje, kot tudi obdelane/čiste podatke.
- Globoka analiza — podatkovno jezero uporabnikom omogoča raziskovanje in analizo podatkov.
- Fleksibilen dostop — podatkovno jezero zagotavlja fleksibilen dostop do različnih podatkov in različnih scenarijev.
Zdaj se lahko pogovorimo o razliki med skladiščem podatkov in podatkovnim jezerom. Ljudje običajno sprašujejo:
- Kaj pa skladišče podatkov?
- Nadomeščamo skladišče podatkov s podatkovnim jezerom ali ga razširjamo?
- Ali lahko resnično obvladamo brez podatkovnega jezera?
Na kratko, ni jasnega odgovora. Vse je odvisno od konkretne situacije, spretnosti v ekipi in proračuna. Na primer, migracija skladišča podatkov iz Oracle v AWS in ustvarjanje podatkovnega jezera s hčerinsko družbo Amazona — Woot — .
Po drugi strani pa vendor Snowflake trdi, da se vam ni več treba ukvarjati s podatkovnim jezerom, saj njihova podatkovna platforma (do leta 2020 je bilo skladišče podatkov) omogoča združitev podatkovnega jezera in skladišča podatkov. Malo sem delal s Snowflake in to je resnično edinstven izdelek, ki to lahko stori. Cena je drugo vprašanje.
Na koncu, moja osebna ocena je, da še vedno potrebujemo shrambo podatkov kot glavni vir podatkov za naše poročanje, vse, kar ne zmestim, pa hranimo v jezeru podatkov. Vloga analitike je zagotoviti enostaven dostop podjetju za sprejemanje odločitev. Kakorkoli obrneš, poslovni uporabniki delajo učinkoviteje s shrambo podatkov kot z jezerom podatkov, na primer v Amazonu — obstaja Redshift (analitična shramba podatkov) in Redshift Spectrum/Athena (SQL vmesnik za jezero podatkov v S3, zgrajen na osnovi Hive/Presto). Enako velja za druga moderna analitična skladišča podatkov.
Poglejmo tipično arhitekturo shrambe podatkov:
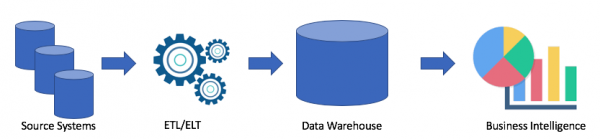
To je klasična rešitev. Imamo sisteme virov, s pomočjo ETL/ELT kopiramo podatke v analitično shrambi podatkov in povezujemo z rešitvijo Business Intelligence (moja najljubša je Tableau, kaj pa vaša?).
Takšna rešitev ima naslednje pomanjkljivosti:
- ETL/ELT operacije zahtevajo čas in vire.
- Na splošno je pomnilnik za shranjevanje podatkov v analitični shrambi podatkov drag (na primer Redshift, BigQuery, Teradata), saj moramo kupiti celoten klaster.
- Poslovni uporabniki imajo dostop do očiščenih in pogosto agregiranih podatkov ter nimajo možnosti pridobiti surovih podatkov.
Seveda, vse je odvisno od vaše situacije. Če nimate težav s svojo shrambo podatkov, potem je jezero podatkov popolnoma nepotrebno. Vendar pa se, ko se pojavijo težave s pomanjkanjem prostora, moči ali je cena ključnega pomena, lahko razmisli o rešitvi z jezerom podatkov. Prav zato je jezero podatkov zelo priljubljeno. Tukaj je primer arhitekture jezera podatkov:
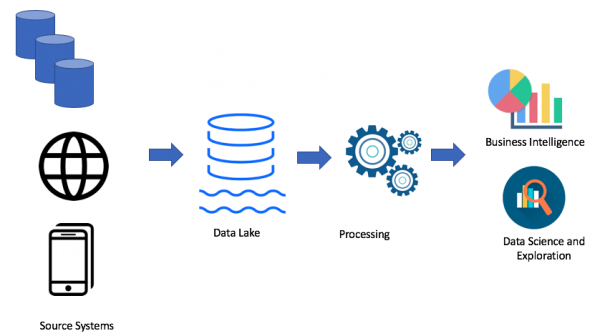
Z uporabo pristopa jezera podatkov nalagamo surove podatke v naše jezero podatkov (batch ali streaming), nato pa obdelujemo podatke po potrebi. Jezero podatkov omogoča poslovnim uporabnikom, da ustvarijo svoje lastne transformacije podatkov (ETL/ELT) ali analizirajo podatke v rešitvah Business Intelligence (če je na voljo ustrezni gonilnik).
Cilj vsake analitične rešitve je služiti poslovnim uporabnikom. Zato moramo vedno delati na podlagi zahtev podjetja. (V Amazonu je to en od principov — delanje nazaj).
Z delom tako s shrambo podatkov kot z jezerom podatkov lahko primerjamo obe rešitvi:
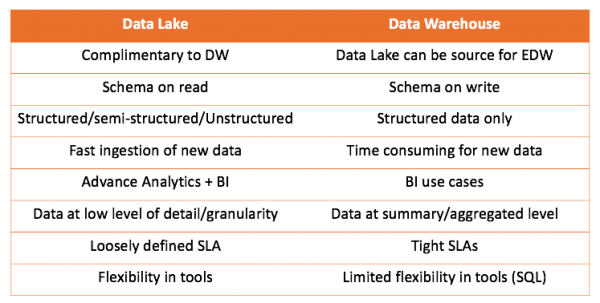
Glavna zaključka koju možemo izvući je da skladište podataka ne konkurira jezeru podataka, već ga više dopunjuje. Međutim, na vama je da odlučite što je najbolje za vašu situaciju. Uvijek je zanimljivo isprobati sam i donijeti prave zaključke.
Također bih želio ispričati jedan slučaj kada sam počeo koristiti pristup jezera podataka. Sve je to prilično banalno, pokušao sam koristiti alat ELT (imali smo Matillion ETL) i Amazon Redshift, moje rješenje je funkcioniralo, ali nije ispunjavalo zahtjeve.
Trebalo mi je uzeti web logove, transformirati ih i agregirati, kako bih osigurao podatke za dva slučaja:
- Marketing tim je želio analizirati aktivnost botova za SEO
- IT je želio pratiti metrike rada web stranica
Vrlo jednostavno, vrlo jednostavni logovi. Evo primjera:
https 2018-07-02T22:23:00.186641Z app/my-loadbalancer/50dc6c495c0c9188
192.168.131.39:2817 10.0.0.1:80 0.086 0.048 0.037 200 200 0 57
"GET https://www.example.com:443/ HTTP/1.1" "curl/7.46.0" ECDHE-RSA-AES128-GCM-SHA256 TLSv1.2
arn:aws:elasticloadbalancing:us-east-2:123456789012:targetgroup/my-targets/73e2d6bc24d8a067
"Root=1-58337281-1d84f3d73c47ec4e58577259" "www.example.com" "arn:aws:acm:us-east-2:123456789012:certificate/12345678-1234-1234-1234-123456789012"
1 2018-07-02T22:22:48.364000Z "authenticate,forward" "-" "-"
Jedna datoteka je težila 1-4 megabajta.
Međutim, postojala je jedna poteškoća. Imali smo 7 domena širom svijeta, i u jednom danu je stvoreno 7000 datoteka. To nije neki veliki volumen, ukupno 50 gigabajta. No, veličina našeg Redshift clustra također je bila mala (4 nodova). Tradicionalno učitavanje jedne datoteke trajalo je oko minute. Dakle, zadatak se nije mogao riješiti ravno. I to je bio onaj slučaj kada sam odlučio koristiti pristup jezera podataka. Rješenje je izgledalo otprilike ovako:
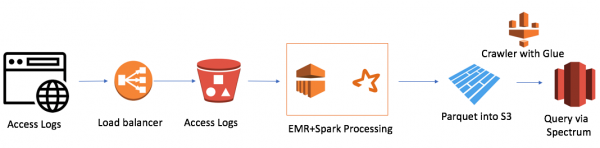
To je dovoljno jednostavno (želim napomenuti da je prednost rada u oblaku jednostavnost). Koristio sam:
- AWS Elastic Map Reduce (Hadoop) kao obrtnu snagu
- AWS S3 kao skladište datoteka s mogućnošću šifriranja podataka i razgraničenja pristupa
- Spark kao InMemory obrtnu snagu i PySpark za logiku i transformaciju podataka
- Parquet kao rezultat rada Sparka
- AWS Glue Crawler kao skupljač metapodataka o novim podacima i particijama
- Redshift Spectrum kao SQL sučelje za jezero podataka za postojeće korisnike Redshift
Najmanji EMR+Spark klaster obradio je sve serije datoteka za 30 minuta. Postoje i drugi slučajevi za AWS, posebno mnogi vezani za Alexu, gdje ima puno podataka.
Pred kratkim sem odkril eno od pomanjkljivosti podatkovnega jezera — to je GDPR. Problematika se pojavi, ko stranka zahteva odstranitev podatkov, a so ti v eni izmed datotek; v tem primeru ne moremo uporabljati jezika za manipulacijo podatkov in operacije DELETE, kot to storimo v bazi podatkov.
Upam, da je članek pojasnil razliko med podatkovnim skladiščem in podatkovnim jezerom. Če vas je zanimalo, lahko prevedem tudi svoje druge članke ali članke strokovnjakov, ki jih berem. Prav tako lahko spregovorim o rešitvah, s katerimi delam, in njihovi arhitekturi.
Izvor: habr.com
